
Last chance! 50% off DataCamp Premium
Sale ends in
Gewogen gemiddelden kom je overal tegen in data-analyse, van het berekenen van je GPA tot het bepalen van portefeuillerendementen. In tegenstelling tot eenvoudige gemiddelden die alle datapunten gelijk behandelen, erkennen gewogen gemiddelden dat sommige waarden meer invloed verdienen dan andere. Dat maakt ze ontzettend nuttig wanneer je te maken hebt met data met uiteenlopende belangrijkheid of frequentie.
Een gewogen gemiddelde kent verschillende niveaus van belangrijkheid toe aan individuele datapunten op basis van vooraf bepaalde gewichten. Waar een eenvoudig gemiddelde alle waarden gelijk behandelt, vermenigvuldigt een gewogen gemiddelde elke waarde met het bijbehorende gewicht voordat het eindresultaat wordt berekend.
De kerninzicht is dit: gewichten bepalen direct hoeveel elk datapunt het uiteindelijke gemiddelde beïnvloedt. Een datapunt met een hoger gewicht trekt het resultaat meer naar zijn waarde toe, terwijl punten met een lager gewicht minder impact hebben. Dit geeft je veel meer controle over je berekeningen en levert vaak betekenisvollere resultaten op.
Gewogen gemiddelden verschillen van eenvoudige gemiddelden op één belangrijk punt: ze houden rekening met de relatieve betekenis van elk datapunt in plaats van te veronderstellen dat alle punten even belangrijk zijn.
Nu we hebben vastgesteld wat gewogen gemiddelden zijn en waarom ze ertoe doen, duiken we in de wiskundige basis die ze laat werken.
De formule voor het gewogen gemiddelde combineert elk datapunt met het bijbehorende gewicht:
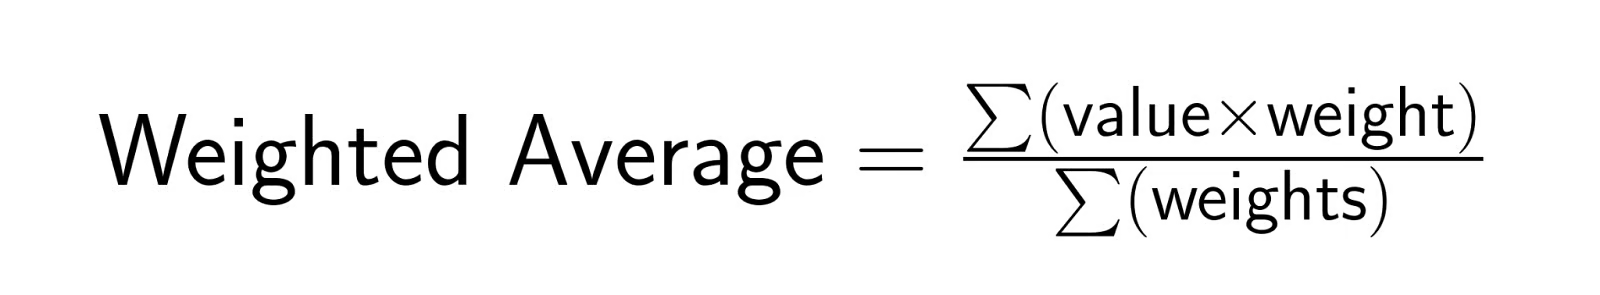
Waar Σ de som van alle termen voorstelt. Elke waarde wordt vermenigvuldigd met zijn gewicht, daarna tel je al deze producten op en deel je door het totaal van alle gewichten.
In de meeste praktische contexten (kansen, frequenties en aandelen) zijn gewichten niet-negatief en vaak genormaliseerd zodat ze optellen tot 1 (of tot het totale aantal). In gespecialiseerde methoden kunnen negatieve gewichten voorkomen, maar die kunnen contra-intuïtieve resultaten opleveren en moeten voorzichtig worden gebruikt. Zorg er altijd voor dat de som van de gewichten groter is dan nul om deling door nul te voorkomen.
Deze formule zorgt ervoor dat waarden met een hoger gewicht naar verhouding meer invloed hebben op het eindresultaat. Als een datapunt bijvoorbeeld een gewicht van 10 heeft en een ander een gewicht van 1, draagt het eerste punt tien keer zoveel bij aan het uiteindelijke gemiddelde.
Normalisatie betekent dat je gewichten schaalt zodat ze optellen tot 1, waardoor elk gewicht direct te interpreteren is als een procentuele bijdrage. Wanneer $(sum_i w_i = 1)$, vereenvoudigt het gewogen gemiddelde tot $(sum_i w_i x_i)$. In probabilistische contexten zijn deze gewichten kansen en is het gewogen gemiddelde de verwachtingswaarde.
Deze genormaliseerde benadering is vooral handig in probabiliteitscontexten, waar gewichten kansen voorstellen die moeten optellen tot 1. In die gevallen wordt het gewogen gemiddelde de verwachtingswaarde van de verdeling.
Met de wiskundige basis op zak vraag je je misschien af wanneer gewogen gemiddelden de betere keuze zijn dan eenvoudige gemiddelden. Het antwoord ligt in het herkennen wanneer je data van nature verschillende niveaus van betekenis heeft.
Gewogen gemiddelden zijn essentieel wanneer je datapunten van nature verschillende niveaus van belangrijkheid of frequentie hebben. Ze werken beter dan eenvoudige gemiddelden wanneer datapunten verschillende steekproefgroottes, tijdsperioden of betrouwbaarheidsniveaus vertegenwoordigen. Als je bijvoorbeeld gemiddelde toetsscores over verschillende klassen berekent, zouden grotere klassen de totale gemiddelde score meer moeten beïnvloeden dan kleinere.
Gewogen gemiddelden zijn vooral waardevol in financiële berekeningen (portefeuillerendementen), academische beoordeling (verschillende wegingen per opdracht), enquêtes (demografische correcties) en voorraadbeheer (kostprijsgemiddelde over verschillende inkoophoeveelheden).
Hoewel gewogen gemiddelden krachtige tools zijn, brengen ze ook valkuilen met zich mee waar je zorgvuldig mee om moet gaan.
De belangrijkste uitdaging ligt in het kiezen van geschikte gewichten, wat domeinkennis vereist en zorgvuldige overweging van wat elk datapunt vertegenwoordigt. Slechte gewichtskeuze kan resultaten sterk vertekenen en tot misleidende conclusies leiden.
Als je bijvoorbeeld klanttevredenheidsscores berekent en per ongeluk hogere gewichten toekent aan minder betrouwbare databronnen, zal je uiteindelijke gemiddelde het werkelijke klantgevoel niet nauwkeurig weerspiegelen. Zorg er altijd voor dat je gewichten de werkelijke belangrijkheid of betrouwbaarheid van elk datapunt weerspiegelen.
Naast gewichtskeuze zijn veelvoorkomende rekenfouten: gewichten van nul gebruiken (waardoor datapunten wegvallen), negatieve gewichten (die contra-intuïtieve resultaten kunnen opleveren) en vergeten te normaliseren wanneer dat nodig is. Deling door nul treedt op wanneer alle gewichten nul zijn.
Controleer je gewichtsindeling altijd dubbel en zorg voor correcte normalisatie, vooral wanneer je werkt met percentage-gewichten die moeten optellen tot 100%.
Nu we de theorie en mogelijke uitdagingen hebben behandeld, kijken we naar de praktijk en hoe je gewogen gemiddelden implementeert met populaire tools die je waarschijnlijk al kent.
Excel maakt berekeningen van gewogen gemiddelden eenvoudig met de functies SUMPRODUCT() en SUM(). De formulestructuur is:
=SUMPRODUCT(values, weights)/SUM(weights) Als de waarden bijvoorbeeld in A2:A6 staan en de gewichten in B2:B6: =SUMPRODUCT(A2:A6, B2:B6) / SUM(B2:B6)
Tip: Houd de eenheden van je gewichten consistent. Als gewichten percentages zijn, sla ze dan op als decimalen (bijv. 0,6) of als hele getallen (bijv. 60), maar gebruik dezelfde eenheden in zowel teller als noemer.
Voor wie in Python werkt, biedt de numpy-bibliotheek een elegante oplossing, al kun je gewogen gemiddelden ook handmatig berekenen:
import numpy as np # Define values and weights values = [85, 92, 78, 95] weights = [0.2, 0.3, 0.25, 0.25] # Calculate weighted average weighted_avg = np.average(values, weights=weights) print(f"Weighted average: {weighted_avg:.2f}") # Alternative manual calculation manual_calc = sum(v * w for v, w in zip(values, weights)) / sum(weights) print(f"Manual calculation: {manual_calc:.2f}") Nu je weet hoe je gewogen gemiddelden berekent, bekijken we hoe ze echte problemen oplossen in verschillende vakgebieden. Deze voorbeelden helpen je situaties te herkennen waarin gewogen gemiddelden je eigen analyse kunnen verbeteren.
Academische beoordelingssystemen gebruiken vaak gewogen gemiddelden om verschillende soorten toetsen in balans te brengen. Een standaardcursus kan bijvoorbeeld examens voor 60% mee laten tellen, huiswerk voor 25% en deelname voor 15%.
Als een student 88 scoort voor examens, 95 voor huiswerk en 92 voor deelname, dan is het eindcijfer: (88×0,6) + (95×0,25) + (92×0,15) = 90,35. Deze aanpak zorgt ervoor dat belangrijkere toetsen zwaarder meetellen in het eindcijfer.
In zakelijke toepassingen gebruiken bedrijven vaak de methode van de gewogen gemiddelde kostprijs (WAC) om voorraden te waarderen wanneer goederen in een periode tegen verschillende prijzen worden ingekocht. In tegenstelling tot een eenvoudige rekenkundig gemiddelde neemt WAC de inkoophoeveelheden mee, wat prijsschommelingen afvlakt en een consistente kostengrondslag biedt voor financiële rapportage.
Koopt een bedrijf bijvoorbeeld 100 stuks voor $10 en 300 stuks voor $12, dan is de gewogen gemiddelde kostprijs $11,50, niet $11,00 zoals een eenvoudig gemiddelde zou suggereren.
In de financiële wereld reiken gewogen gemiddelden veel verder dan voorraden. Portefeuillebeheer gebruikt ze om verwachte rendementen en risico's te berekenen, waarbij het gewicht van elk activum is gebaseerd op het aandeel in de totale portfoliowaarde. Zo hebben grotere posities meer invloed dan kleinere.
Op vergelijkbare wijze past de gewogen gemiddelde kapitaalkosten (WACC) hetzelfde principe toe: het vertegenwoordigt de gemiddelde financieringskosten van een bedrijf door de kosten van vreemd en eigen vermogen te wegen naar hun aandeel in de kapitaalstructuur. WACC is een belangrijke input in waarderingsmodellen en investeringsbeslissingen, omdat het dient als de drempelrente voor het genereren van rendement.
In de onderzoekswereld gebruikt men bij enquête-analyse gewogen gemiddelden om demografische scheeftrekkingen te corrigeren en representatieve resultaten te waarborgen. Als je enquête bepaalde leeftijdsgroepen onderbelicht, kun je antwoorden wegen om overeen te komen met de werkelijke bevolkingssamenstelling.
Deze correctie helpt steekproefbias te elimineren en levert nauwkeurigere inzichten op over de bredere populatie die je bestudeert.
Terug naar praktische zakelijke toepassingen: de methode van het voortschrijdend gemiddelde in de voorraadadministratie gebruikt gewogen gemiddelden om de kostprijs van verkochte goederen te bepalen. Elke nieuwe inkoop werkt de gemiddelde kostprijs per eenheid bij op basis van de resterende voorraad en nieuwe toevoegingen.
Deze aanpak vlakt prijsvolatiliteit af en biedt stabiele kostenschattingen voor financiële rapportage, waardoor het makkelijker wordt om winstgevendheidstrends in de tijd te volgen.
Naast deze gangbare toepassingen gebruiken technische toepassingen vaak oppervlakte-gewogen gemiddelden voor energiecalculaties van gebouwen, waarbij verschillende zones bijdragen aan de algehele gebouwprestatie op basis van hun grootte.
Vergelijkbare concepten komen voor in geografische informatiesystemen (GIS) voor ruimtelijke analyse en in de maakindustrie voor kwaliteitscontrole over verschillende productiezones.
Met al deze toepassingen in gedachten vraag je je misschien af hoe je kiest tussen gewogen gemiddelden en andere gemiddelde-methoden. Door deze verschillen te begrijpen, kies je de juiste aanpak voor jouw situatie.
Rekenkundige gemiddelden veronderstellen dat alle datapunten even belangrijk en representatief zijn. Gewogen gemiddelden houden expliciet rekening met verschillen in belangrijkheid, betrouwbaarheid of frequentie tussen datapunten.
Kies voor gewogen gemiddelden wanneer je data van nature verschillende niveaus van betekenis heeft of wanneer je moet corrigeren voor scheeftrekkingen in de steekproef. Gebruik eenvoudige rekenkundige gemiddelden wanneer alle datapunten werkelijk gelijke aandacht verdienen.
Meetkundige gemiddelden werken het best voor multiplicatieve data zoals groeipercentages of verhoudingen, waarbij je de gemiddelde groeisnelheid over tijd wilt vinden. Meetkundige gemiddelden accommoderen echter niet vanzelf weging.
Je kunt wel gewogen meetkundige gemiddelden maken met logaritmen, maar die aanpak is wiskundig complex en minder intuïtief dan gewogen rekenkundige gemiddelden voor de meeste toepassingen.
Voordat we de meer geavanceerde onderwerpen induiken, is het de moeite waard om stil te staan bij de bredere afwegingen bij het gebruik van gewogen gemiddelden.
Gewogen gemiddelden leveren superieure nauwkeurigheid wanneer datapunten van nature verschillen in belangrijkheid of betrouwbaarheid. Ze bieden de flexibiliteit om berekeningen aan te passen op basis van domeinkennis en kunnen realistische scenario's beter weergeven waarin niet alle observaties gelijk zijn.
Deze aanpak blinkt uit in situaties die demografische correcties vereisen, portefeuilleanalyse, of elke context waarin steekproefgroottes of meetzekerheid per datapunt varieert.
De belangrijkste beperking is de subjectiviteit in gewichtskeuze, wat bias kan introduceren als het slecht gebeurt. Gewogen gemiddelden zijn ook gevoeliger voor uitschieters met hoge gewichten en foutgevoelig als gewichten verkeerd worden toegekend.
Daarnaast vergen ze meer rekenwerk en domeinkennis dan eenvoudige gemiddelden, waardoor ze onnodig complex zijn in situaties waar gelijke weging passend is.
Voor lezers die verder willen gaan dan basis-toepassingen strekken gewogen gemiddelden zich uit tot meer geavanceerd wiskundig terrein dat extra analytische mogelijkheden opent.
Gewogen gemiddelden kunnen worden uitgebreid naar continue functies met integraalrekening. In plaats van discrete gewichten en waarden integreer je over continue gewicht- en waardefuncties:
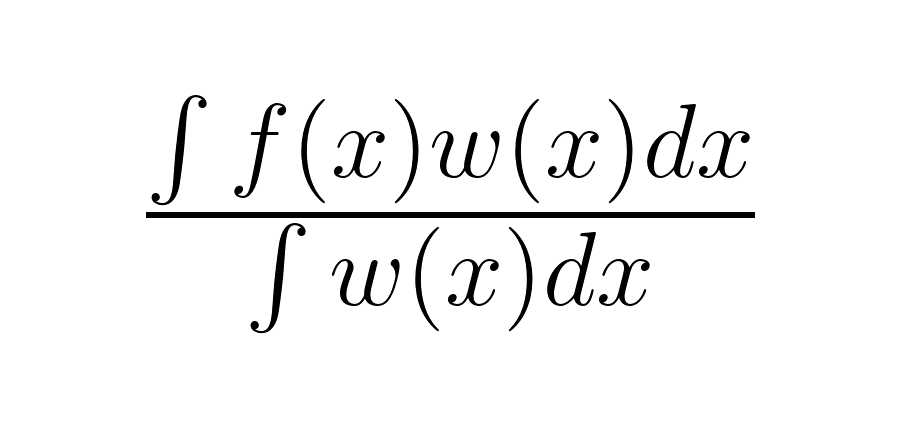
Deze aanpak komt voor in de natuurkunde bij het berekenen van massamiddelpunt en in de kansrekening voor continue verdelingen.
Voortbouwend op deze wiskundige basis stelt de kansrekening dat de verwachtingswaarde het gewogen gemiddelde is van alle mogelijke uitkomsten, waarbij de gewichten de kansen zijn dat elke uitkomst optreedt.
Verwachtingswaarden helpen langetermijnuitkomsten te voorspellen in onzekere situaties, van casinospellen tot beleggingsrendementen, en zijn daarmee essentiële hulpmiddelen voor risico-inschatting en besluitvorming.
Gewogen gemiddelden bieden een genuanceerdere en nauwkeurigere aanpak van data-analyse wanneer je observaties van nature variëren in belangrijkheid, frequentie of betrouwbaarheid. In deze gids hebben we gezien hoe ze besluitvorming verbeteren in uiteenlopende domeinen. Van academische beoordeling tot portefeuillebeheer, door correct rekening te houden met de relatieve betekenis van verschillende datapunten.
Als je gewogen gemiddelden gaat toepassen in je eigen analyses, onthoud dan dat de kracht van deze techniek zit in het weerspiegelen van de complexiteit van de echte wereld, waar niet alle data gelijke aandacht verdient. Of je nu cijfers berekent, portefeuilles analyseert of enquêtedata verwerkt: gewogen gemiddelden helpen je betere beslissingen te nemen door passende invloed te geven aan de informatie die het meest telt.
Overweeg onze cursus Advanced Excel Functions te volgen om je spreadsheetvaardigheden te verdiepen, of bekijk onze Descriptive Statistics Cheat Sheet voor een snelle referentie van dit soort statistische concepten.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min


