Si eres científico o analista de datos y ya conoces bases de datos relacionales y no relacionales como SQL y MongoDB, prepárate para adentrarte en un nuevo y emocionante mundo de gestión de datos. En este tutorial aprenderás qué es un tipo de almacén de datos llamado bases de datos vectoriales, un tipo de base de datos especializado para procesar y gestionar datos vectoriales de forma eficiente. En este tutorial de Pinecone, veremos en concreto la plataforma de base de datos vectorial Pinecone.
Para saber más sobre Pinecone, no te pierdas nuestro curso Vector Databases for Embeddings with Pinecone.
¿Qué es una base de datos vectorial?
En las bases de datos tradicionales, los datos suelen almacenarse en filas y columnas, algo idóneo para datos estructurados. Sin embargo, a medida que los conjuntos de datos se vuelven más complejos y de alta dimensión, surge la necesidad de soluciones más especializadas. Aquí es donde brillan las bases de datos vectoriales. En lugar de trabajar con estructuras de datos tradicionales, estas bases están optimizadas para manejar vectores: representaciones matemáticas de puntos de datos en espacios multidimensionales.
Los datos vectoriales se usan ampliamente en campos como el aprendizaje automático, la ciencia de datos, la biología computacional y el PLN. Pueden representar características numéricas, coordenadas, embeddings, texto, imágenes y mucho más. Con el auge de las aplicaciones basadas en IA, la demanda de gestionar eficazmente conjuntos de datos vectorizados se ha disparado, y las bases de datos vectoriales se han convertido en una herramienta clave.
¿Qué es Pinecone?
Pinecone es una plataforma gestionada de bases de datos vectoriales creada específicamente para abordar los retos únicos de los datos de alta dimensión. Con capacidades de indexación y búsqueda de última generación, Pinecone permite a ingenieros y científicos de datos construir e implementar aplicaciones de aprendizaje automático a gran escala que procesen y analicen datos de alta dimensión con eficacia.
Funciones clave de Pinecone
Veamos qué hace de Pinecone una herramienta tan útil:
Servicio totalmente gestionado
Al ser una plataforma totalmente gestionada, Pinecone se encarga de toda la infraestructura y el mantenimiento. Así, los desarrolladores pueden centrarse en crear y desplegar sus aplicaciones de aprendizaje automático sin preocuparse por la operativa.
Escalabilidad
Pinecone ofrece una escalabilidad excepcional, gestionando sin esfuerzo miles de millones de vectores de alta dimensión y admitiendo escalado horizontal. Es ideal para las cargas de trabajo más exigentes de machine learning.
Ingesta de datos en tiempo real
Pinecone admite la ingesta de datos en tiempo real sin interrupciones, lo que permite almacenar e indexar nuevos datos en cuanto están disponibles, sin tiempos de inactividad.
Búsqueda de baja latencia
Gracias a algoritmos de indexación sofisticados, Pinecone logra resultados de baja latencia para consultas de vecinos más cercanos y búsquedas por similitud. Así garantiza respuestas rápidas y precisas para aplicaciones sensibles al tiempo.
Integración sencilla
La API de Pinecone está diseñada para ser simple e intuitiva, lo que facilita su integración con flujos de trabajo de machine learning y canalizaciones de datos existentes.
Comprender los datos no estructurados y los embeddings vectoriales
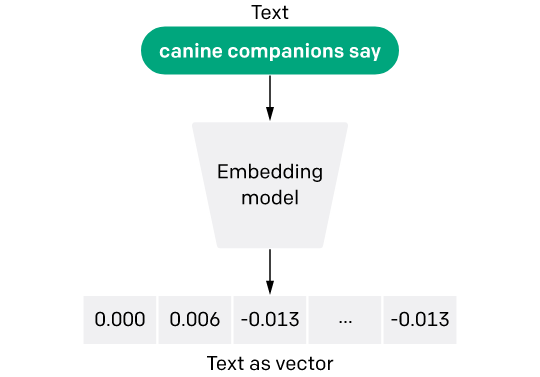
Modelo de embedding de texto - Fuente de la imagen
Los datos no estructurados son aquellos que no tienen un formato predefinido u organizado, lo que dificulta su almacenamiento y procesamiento eficiente en bases de datos tradicionales. Ejemplos de datos no estructurados son el texto, las imágenes, el audio y los vídeos.
Al carecer de una estructura rígida, resulta difícil analizarlos directamente con métodos tradicionales. Para poder usar datos no estructurados en aplicaciones de machine learning e IA, se transforman y almacenan en representaciones numéricas multidimensionales mediante embeddings vectoriales.
Los embeddings desempeñan un papel clave en la inteligencia artificial: son una técnica potente para transformar datos de alta dimensión (palabras, imágenes o preferencias de usuario) en representaciones numéricas compactas. Estas representaciones permiten a los modelos de IA procesar y comprender información compleja con eficiencia.
Entender los embeddings es más fácil si piensas en ellos como un diccionario especializado para una tarea concreta. Por ejemplo, en proyectos de minería de texto, los embeddings nos ayudan a captar el significado semántico de las palabras analizando sus relaciones con otras. Este proceso genera una lista de embeddings que funciona como un diccionario específico de la tarea, ofreciendo representaciones vectoriales numéricas que reflejan el significado de las palabras. La similitud y la relación entre términos se miden por la distancia entre sus embeddings, lo que permite a los modelos de IA entender el contexto y la relevancia.
La importancia de los embeddings radica en su capacidad para reducir la dimensionalidad, facilitando que los modelos manejen entradas grandes como vectores dispersos que representan palabras o ítems. Con embeddings evitamos las limitaciones del one-hot encoding, donde cada categoría se convierte en una variable ficticia independiente y puede generar matrices de entrada excesivamente grandes.
Si quieres profundizar en cómo funcionan los word embeddings, echa un vistazo a nuestro tutorial LDA2vec: Word Embeddings in Topic Models.
Resumen:
- Una base de datos vectorial es un tipo de base de datos especializada para gestionar y procesar datos vectoriales de forma eficiente
- Pinecone es un servicio de base de datos vectorial totalmente gestionado
- Datos no estructurados son datos sin un formato predefinido u organizado, como imágenes, texto, audio o vídeo
- Embeddings es una técnica potente para transformar datos de alta dimensión en representaciones numéricas compactas
¿Cómo funciona una base de datos vectorial?
Seguro que conoces cómo funcionan las bases de datos tradicionales: almacenan datos escalares como cadenas y números en filas y columnas. Las bases de datos vectoriales operan de forma diferente: trabajan con vectores y emplean métodos de optimización y consulta distintos.
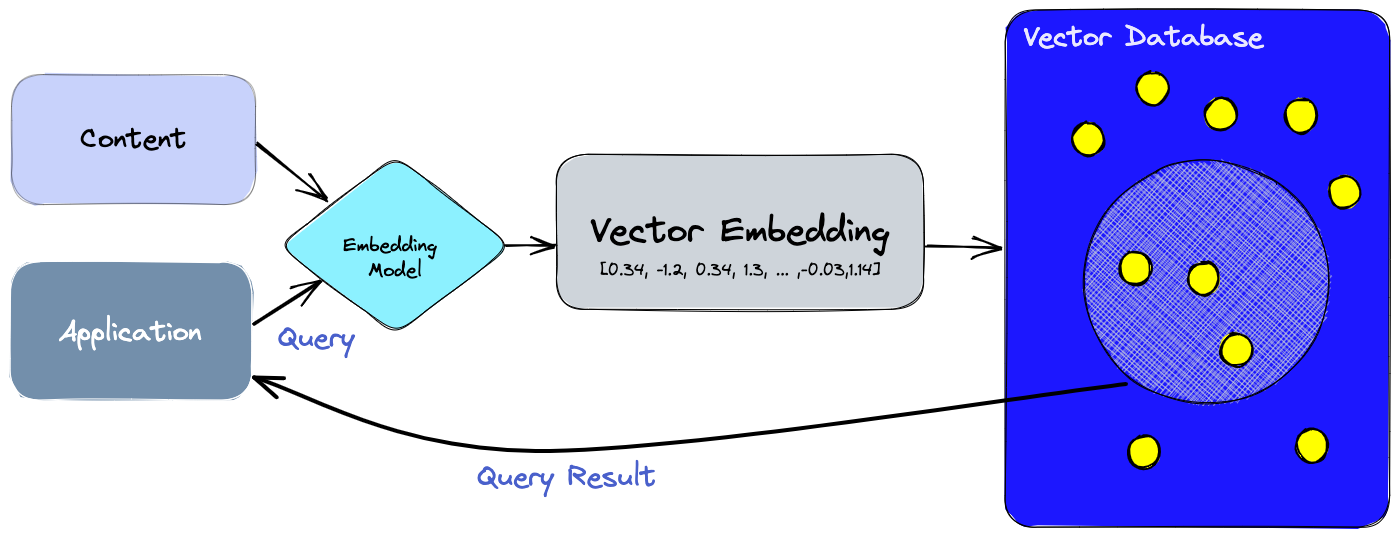
En las bases de datos tradicionales, las consultas suelen buscar coincidencias exactas. En cambio, las bases de datos vectoriales usan una métrica de similitud para encontrar el vector que mejor se corresponde con nuestra consulta.
Para ello emplean un conjunto de algoritmos conocidos como búsqueda de vecinos más cercanos aproximados (ANN, por sus siglas en inglés). Estos algoritmos optimizan la búsqueda mediante técnicas como hashing, cuantización o búsqueda basada en grafos.
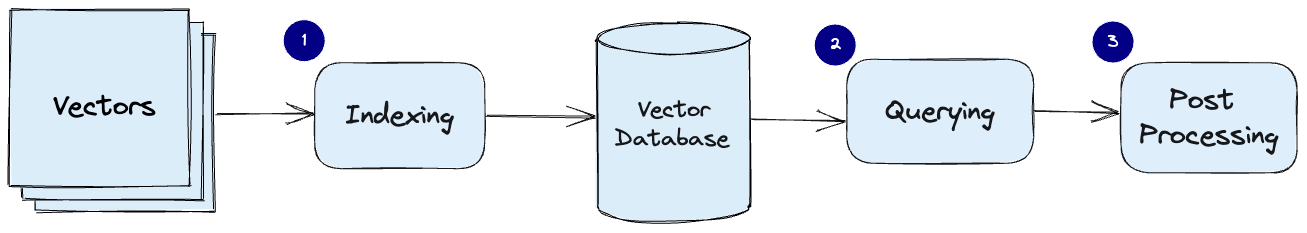
Flujo común para una base de datos vectorial (fuente de la imagen)
¿Quieres aprender a usar la API de OpenAI para crear embeddings de texto y guardarlos después en una base vectorial como Pinecone? Descubre sus aplicaciones en clasificación de texto, recuperación de información y detección de similitud semántica en el blog Introduction to Text Embeddings with the OpenAI API de DataCamp.
Primeros pasos con Pinecone
Para empezar, ve a pinecone.io y crea una cuenta gratuita.
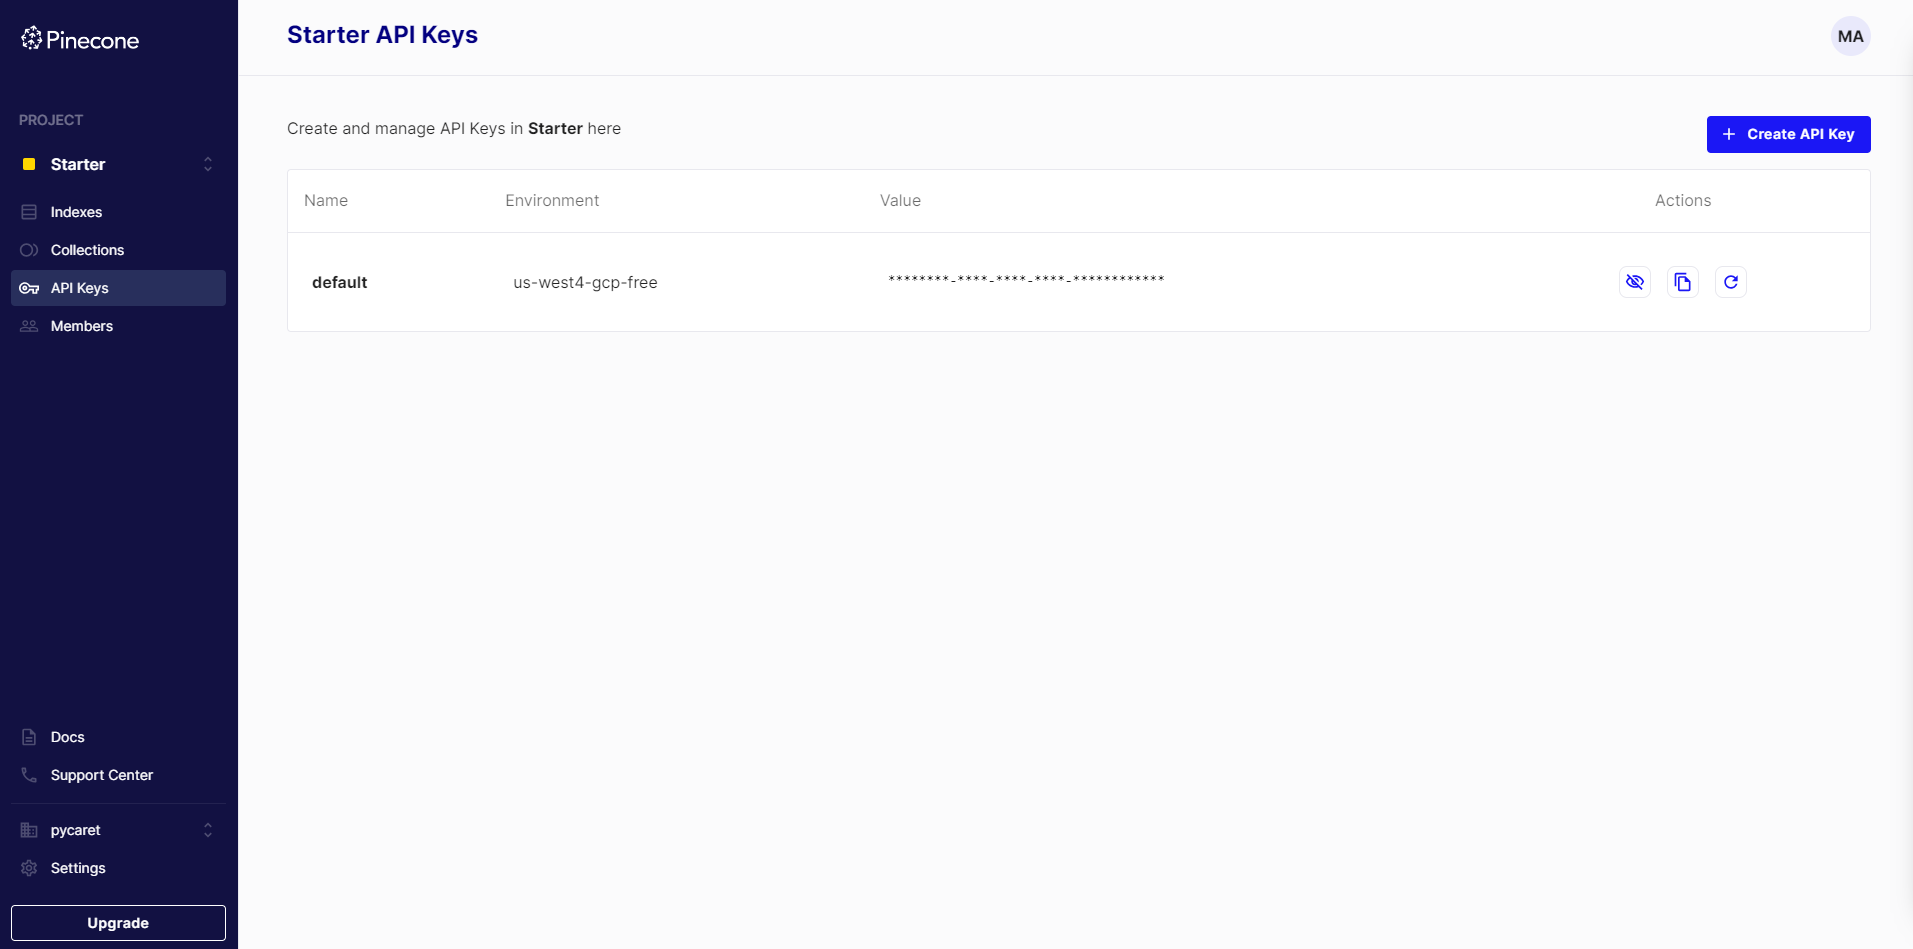
Una vez te registres, haz clic en API Keys en el menú y copia tu entorno y tu clave de API. Los usarás cuando trabajes con el cliente de Python de Pinecone.
También puedes instalar el cliente de Python de Pinecone con pip.
pip install pinecone-clientConceptos clave en Pinecone
Antes de entrar en más detalle, repasemos algunos términos y conceptos que necesitas conocer:
Índice de Pinecone
En Pinecone, un índice representa la estructura organizativa de mayor nivel para los datos vectoriales. Se encarga de recibir y almacenar vectores, gestionar consultas sobre los vectores almacenados y realizar diversas operaciones vectoriales en sus datos. Cada índice funciona sobre uno o varios pods para garantizar un rendimiento eficiente.
Pods
Los pods son unidades de hardware preconfiguradas que alojan los servicios de Pinecone. Cada índice en Pinecone opera sobre uno o varios pods; añadir más pods suele traducirse en mayor capacidad de almacenamiento, menor latencia y mejor rendimiento. Además, puedes crear pods de distintos tamaños según tus necesidades.
Métricas de distancia
Las métricas de distancia son técnicas matemáticas que se utilizan para evaluar la similitud entre dos vectores dentro de un espacio vectorial. En las bases de datos vectoriales, estas medidas son esenciales para comparar los vectores almacenados con un vector de consulta y encontrar los más parecidos.
Puedes elegir distintas métricas al crear un índice vectorial:
- Similitud del coseno. Evalúa el coseno del ángulo entre dos vectores en el espacio vectorial. Su escala va de -1 a 1: 1 indica vectores idénticos, 0 vectores ortogonales y -1 vectores opuestos.
- Distancia euclídea. Calcula la distancia en línea recta entre dos vectores en el espacio vectorial. Va de 0 a infinito: 0 denota vectores idénticos y los valores mayores indican vectores cada vez más diferentes.
- Producto punto. Calcula el producto de las magnitudes de dos vectores y el coseno del ángulo entre ellos. Su escala va de -∞ a ∞: valores positivos indican que apuntan en la misma dirección, 0 que son ortogonales y valores negativos que apuntan en direcciones opuestas.
Cómo verificar la clave de API de Pinecone
Para utilizar Pinecone desde Python necesitas una clave de API. Puedes encontrarla en la consola de Pinecone, en la sección "API Keys". En esa misma vista también verás el entorno asociado a tu proyecto.
import pinecone
pinecone.init(api_key="API_KEY", environment = 'ENVIRONMENT')
Cómo crear un índice en Pinecone
Para crear un índice en Pinecone, ejecuta:
pinecone.create_index("myfirstindex", dimension=8, metric="euclidean")En cuanto ejecutes este comando, verás en tu consola que se está inicializando un índice de Pinecone:
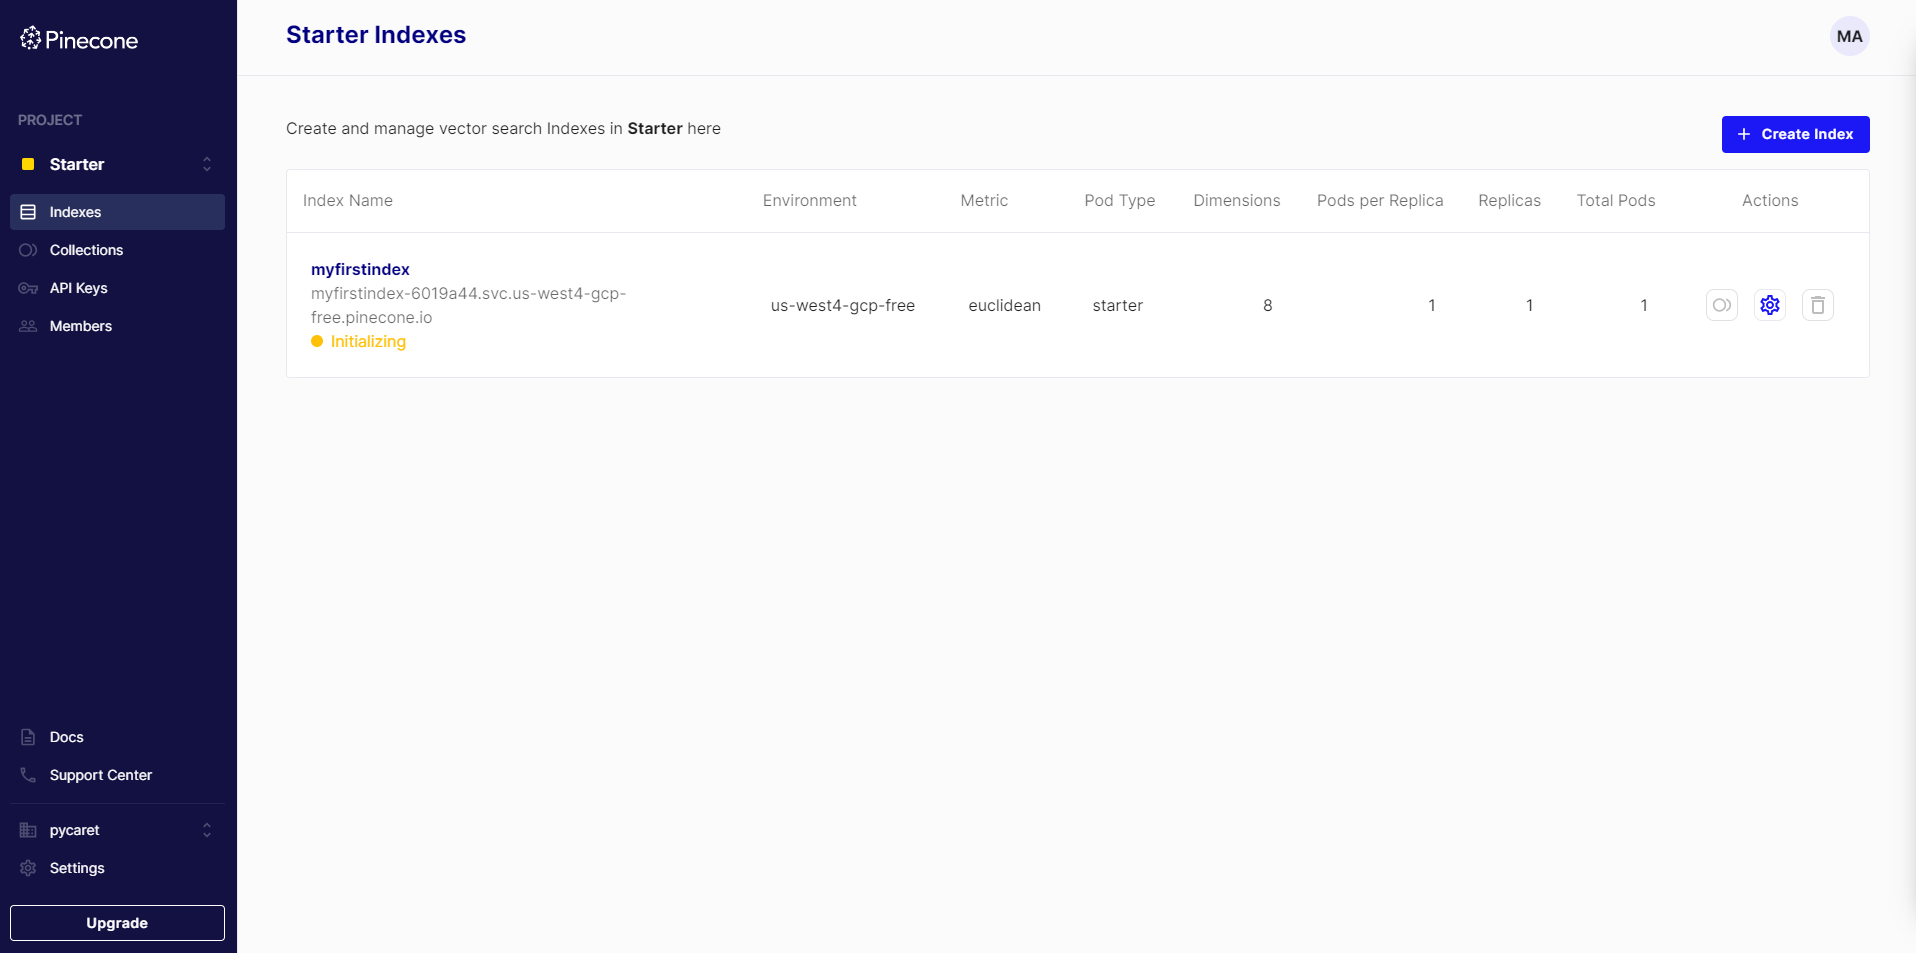
Inserción y consulta de datos en Pinecone
Para añadir vectores al índice, puedes usar la operación upsert. Esta operación añade un nuevo vector o actualiza uno existente si ya hay un vector con el mismo ID. Con los siguientes comandos, insertarás cinco vectores de 8 dimensiones en tu índice.
index = pinecone.Index("myfirstindex")

index.upsert([
    ("A", [0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1, 0.1]),
    ("B", [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]),
    ("C", [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]),
    ("D", [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]),
    ("E", [0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5, 0.5])
])
Si vuelves a la consola, verás los cinco vectores que acabamos de añadir.
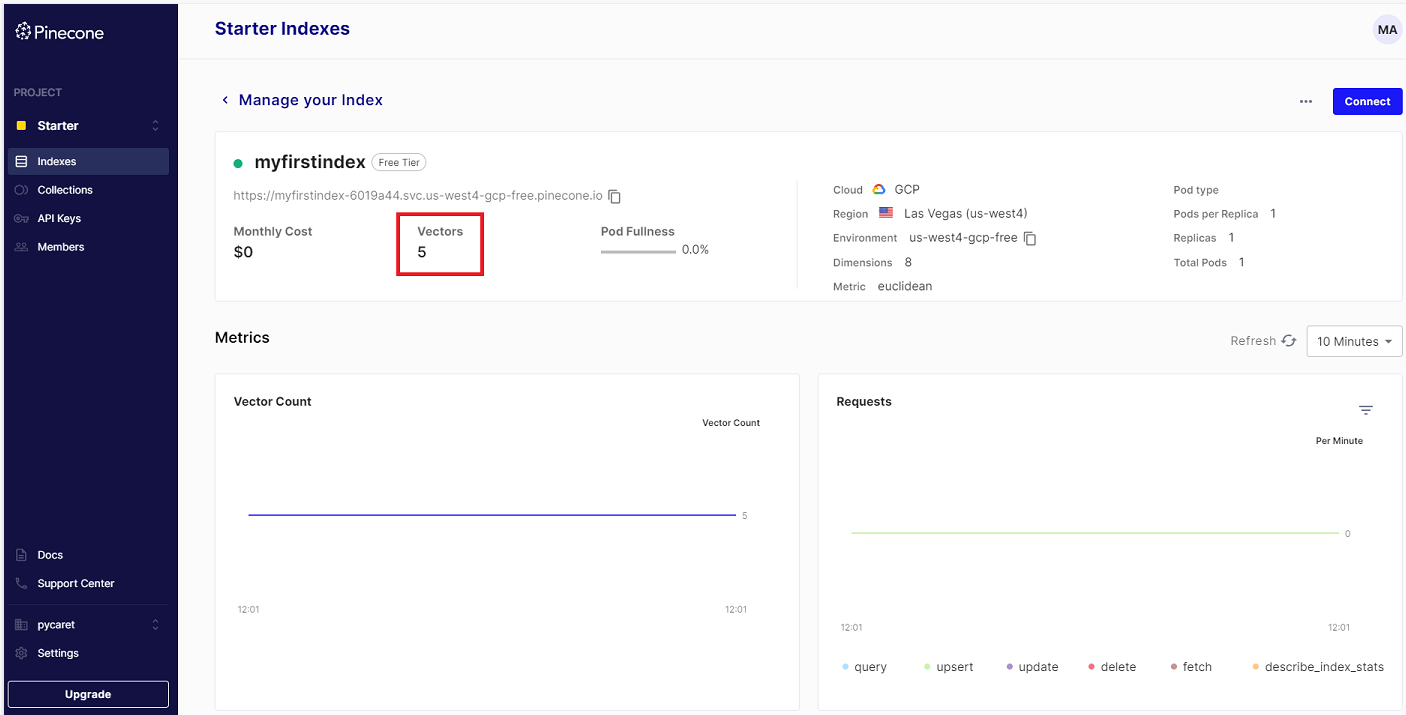
Para comprobar la dimensión del vector, puedes ejecutar:
index.describe_index_stats()
>>> {'dimension': 8,
>>>  'index_fullness': 0.0,
>>>  'namespaces': {'': {'vector_count': 5}},
>>>  'total_vector_count': 5}
Cómo consultar el índice y obtener vectores similares en Pinecone
En el siguiente ejemplo, se consulta el índice para recuperar los tres (3) vectores más similares a un vector de muestra de 8 dimensiones. La consulta utiliza la métrica de distancia euclídea, tal y como se especificó al crear el índice.
index.query(
  vector=[0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3],
  top_k=3,
  include_values=True
)
>>> {'matches': [{'id': 'C',
>>> 'score': 0.0,
>>> 'values': [0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3, 0.3]},
>>> {'id': 'D',
>>> 'score': 0.0799999237,
>>> 'values': [0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4, 0.4]},
>>> {'id': 'B',
>>> 'score': 0.0800000429,
>>> 'values': [0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2, 0.2]}],
>>> 'namespace': ''}
Eliminar índices en Pinecone
Cuando ya no necesites el índice, puedes usar la operación delete_index para eliminarlo.
pinecone.delete_index("myfirstindex")Conclusión
Este tutorial te ha introducido en el mundo de las bases de datos vectoriales y Pinecone. Las bases de datos vectoriales ofrecen una solución especializada para gestionar datos de alta dimensión de forma eficiente, algo cada vez más esencial en machine learning, ciencia de datos y aplicaciones impulsadas por IA.
Pinecone, como plataforma gestionada de bases de datos vectoriales, destaca como una herramienta potente para ingenieros y científicos de datos gracias a su escalabilidad, búsqueda de baja latencia e ingesta en tiempo real. Con su integración sencilla y una API fácil de usar, Pinecone agiliza la creación y el despliegue de aplicaciones de machine learning a gran escala.
También hemos visto el concepto de datos no estructurados y cómo los embeddings vectoriales son fundamentales para transformarlos en representaciones numéricas compactas para su análisis.
Si te interesa el mundo de las bases de datos vectoriales y crees que tienes un caso de uso, echa un vistazo a nuestro curso práctico Vector Databases for Embeddings with Pinecone. También puedes probar Weaviate, una base de datos vectorial de código abierto en Python. Si quieres saber más, no te pierdas el webinar Vector Databases for Data Science with Weaviate in Python en DataCamp.