Stable Diffusion Web UI (SDUI) es una interfaz en el navegador, fácil de usar, para el potente modelo de IA generativa llamado Stable Diffusion. Es un modelo avanzado capaz de generar imágenes a partir de descripciones en texto o de modificar imágenes existentes con indicaciones textuales. La interfaz web desarrollada por AUTOMATIC1111 ofrece una forma amena de interactuar con los modelos de Stable Diffusion sin necesidad de contar con conocimientos técnicos ni de programación avanzados.
Puedes usar la Web UI en local en un portátil o PC con soporte tanto para CPU como para GPU. Además, tienes la opción de desplegar tu propio modelo en un servidor para que otras personas puedan explorar y experimentar. Es compatible con prácticamente todos los sistemas operativos y GPUs, incluidas Nvidia, AMD e Intel. Esta herramienta revolucionaria ha cambiado la forma en que artistas crean obras de alta calidad en sus ordenadores personales, haciendo posible una creatividad con IA privada y al alcance de cualquiera.
En este tutorial aprenderás a descargar e instalar SDUI en un portátil con Windows 11 y GPU Nvidia. Una vez hecho el setup, exploraremos las distintas funciones disponibles en la Web UI, incluidas las extensiones y los modelos personalizados de stable diffusion. Esta guía es apta para todo el mundo, incluso si no tienes perfil técnico o eres adolescente.
Descargar e instalar CUDA para GPUs Nvidia
Puedes usar Stable Diffusion Web UI sin GPU ni instalar CUDA. La Web UI puede ejecutarse en CPU y ofrecer resultados rápidos. Aun así, para obtener resultados mucho más veloces, te recomendamos encarecidamente usar aceleración por GPU si te es posible.
Esta guía se centra únicamente en usuarios con GPU Nvidia y Windows como sistema operativo.
Primero, descarga e instala la última versión del CUDA Toolkit 12.3. Selecciona las opciones correctas según tu sistema operativo y descarga el instalador Base.
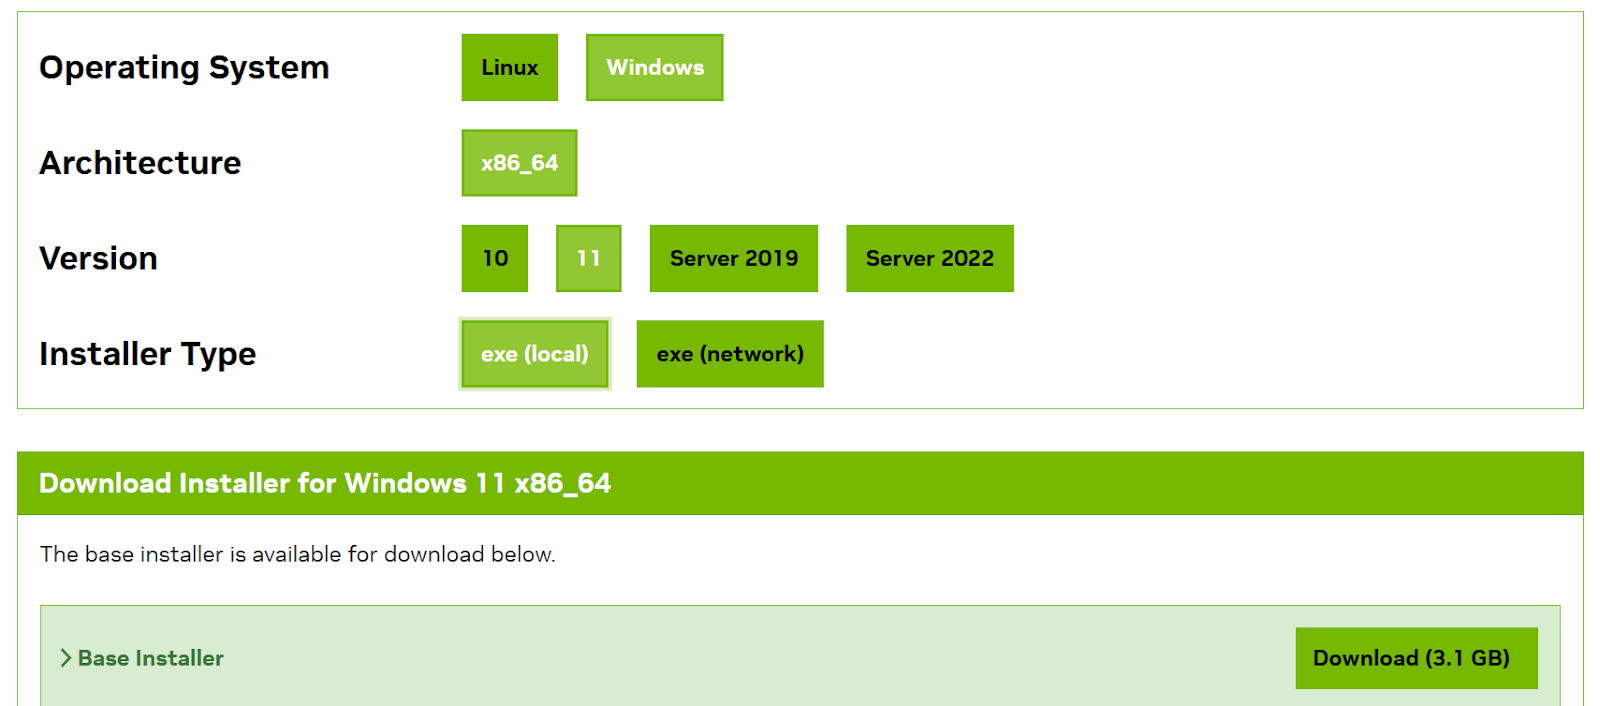
Después, instala la versión más reciente de cuDNN. Puedes descargar el archivo zip desde Nvidia cuDNN. Asegúrate de que coincide con la versión del CUDA Toolkit.
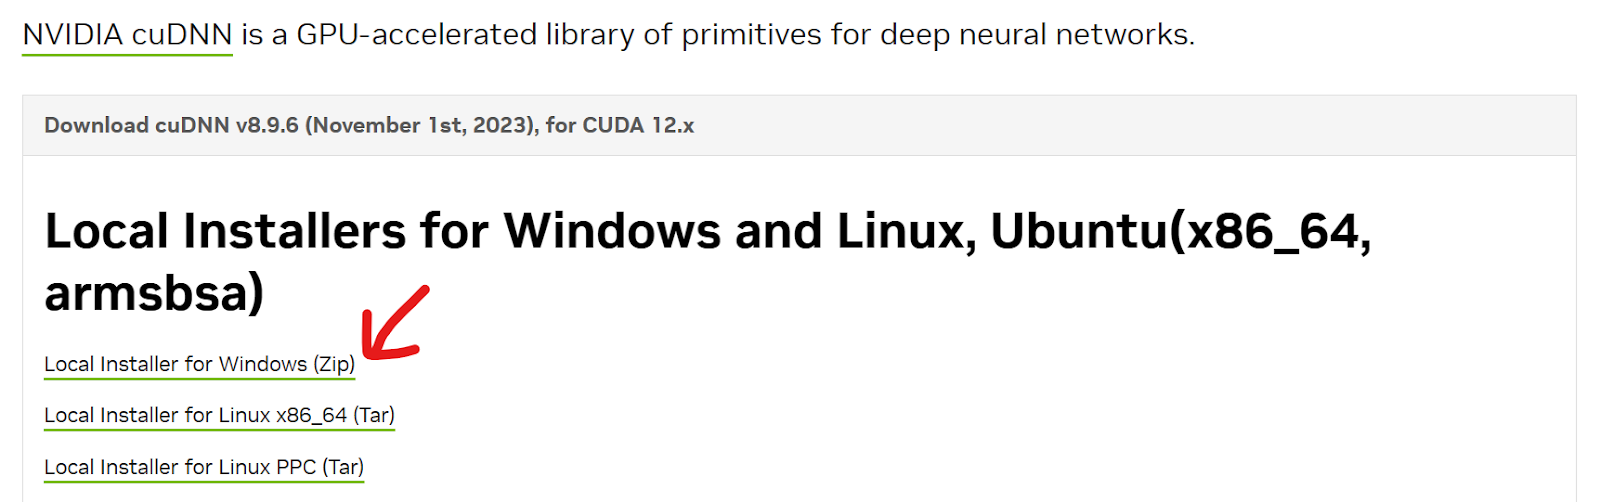
Extrae todas las carpetas del zip, ábrelo y mueve el contenido a la carpeta del toolkit de CUDA. En este caso, el directorio es C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v12.3; en tu equipo puede variar. Si aparece un aviso sobre archivos duplicados, elige "Replace All".
Nota: asegúrate siempre de tener instalados los controladores más recientes de Nvidia en tu ordenador para un rendimiento óptimo.
Descargar e instalar Stable Diffusion Web UI
En esta sección, veremos la forma más fácil y automatizada de instalar SDUI. Lo instalaremos con una distribución binaria para quienes no puedan instalar Python y Git.
- Descarga el archivo
sd.Web UI.zipdesde Release v1.0.0-pre. Aunque es una versión antigua, durante la instalación se actualizará automáticamente a la última. - Extrae el contenido del zip en la ubicación que prefieras. Por ejemplo, puedes extraerlo en
C:\Desktop\Web UI. - Para actualizar Stable Diffusion Web UI, simplemente haz doble clic en el archivo
update.bat. - A continuación, haz doble clic en
run.batpara iniciar la Web UI. La primera vez tardará cerca de una hora en descargar los archivos necesarios y el modelo. - Cuando haya descargado e instalado todos los paquetes de Python y el modelo de Stable Diffusion, se abrirá el navegador con la URL local "http://127.0.0.1:7860". Si no se abre automáticamente, haz clic en el enlace que aparece en la terminal.
Nota: El repositorio de Stable Diffusion Web UI incluye instrucciones de instalación para otros sistemas operativos.
Guía de la pestaña Txt2img
En tu navegador predeterminado verás la interfaz con múltiples opciones. Vamos a probar cada una para generar imágenes de alta calidad.
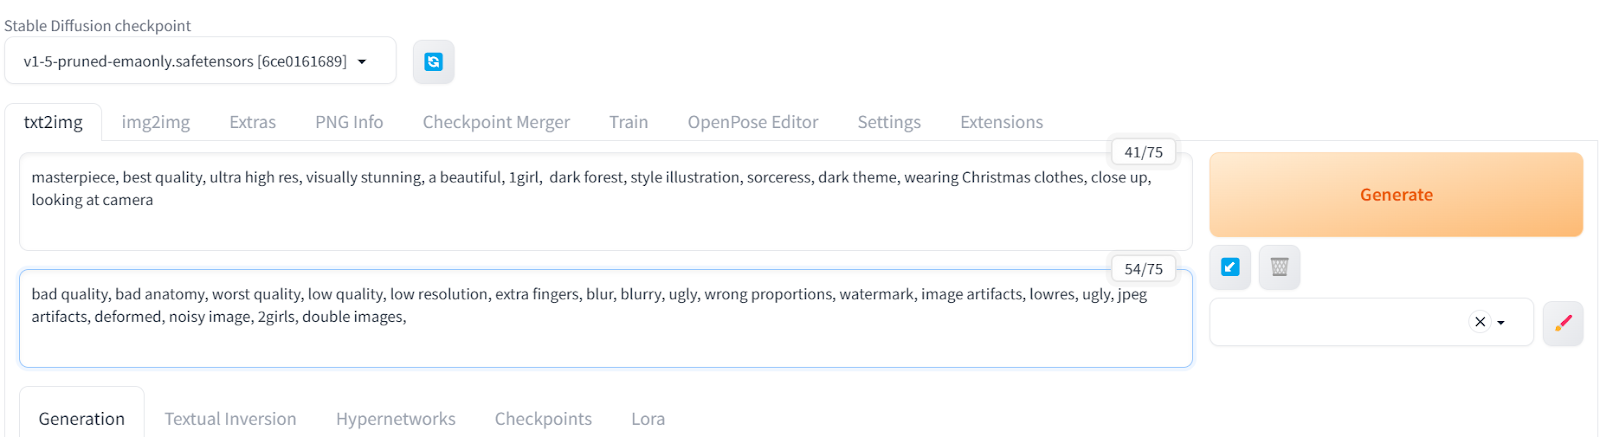
Primero, haremos clic en la pestaña txt2img y escribiremos prompts positivos y negativos para generar la imagen de una chica en un bosque oscuro con ropa de Navidad. Añadimos palabras clave adicionales para mejorar la calidad y el estilo.
Empezaremos con un prompt negativo limitado y añadiremos más palabras clave para eliminar deformidades recurrentes en la imagen.
Prompt positivo: “masterpiece, best quality, ultra high res, visually stunning, a beautiful, 1girl, dark forest, style illustration, sorceress, dark theme, wearing Christmas clothes, close up, looking at camera”
Prompt negativo: “bad quality, bad anatomy, worst quality, low quality, low resolution, extra fingers, blur, blurry, ugly, wrong proportions, watermark, image artifacts, lowres, ugly, jpeg artifacts, deformed, noisy image, 2girls, double images,”
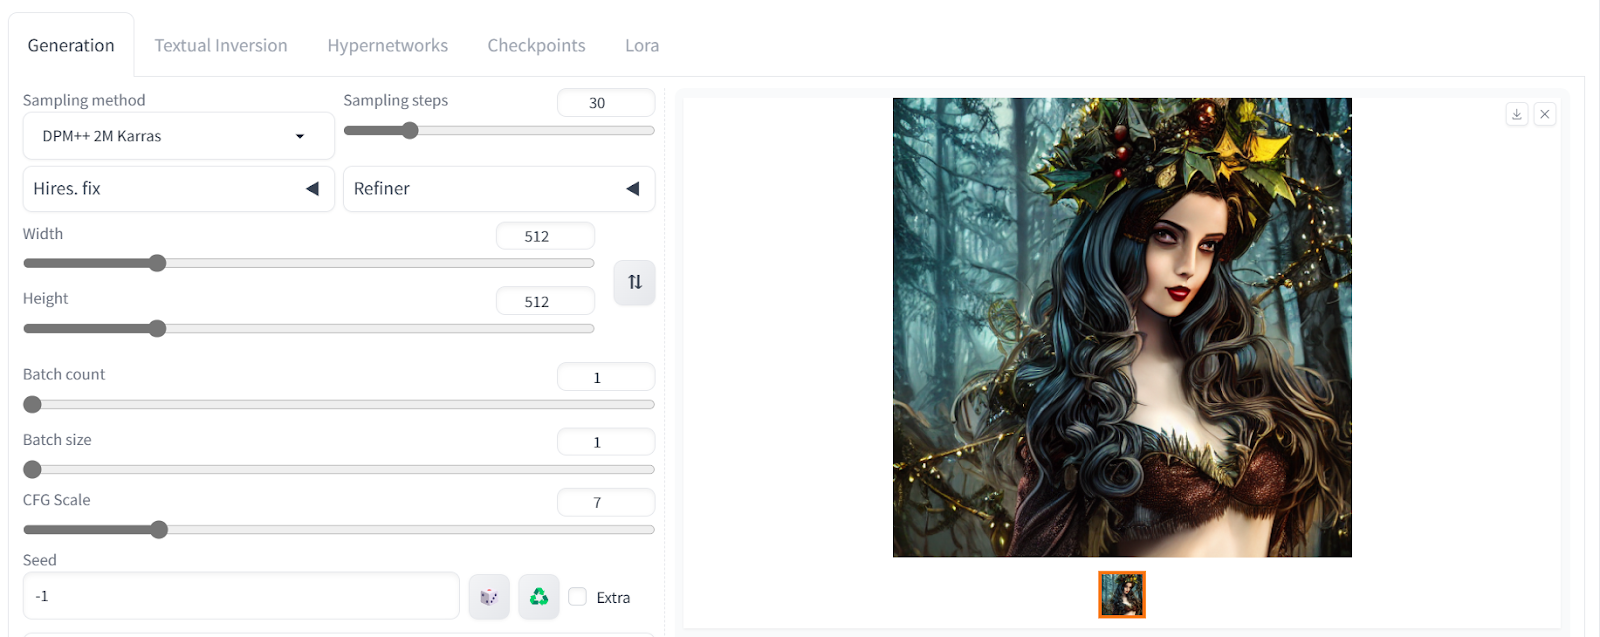
La obra generada muestra a una mujer en un ambiente navideño oscuro con una calidad excepcional.
Ahora vamos a ajustar la configuración avanzada. Podemos cambiar el tamaño de la imagen y aumentar los pasos de muestreo para añadir más detalle.
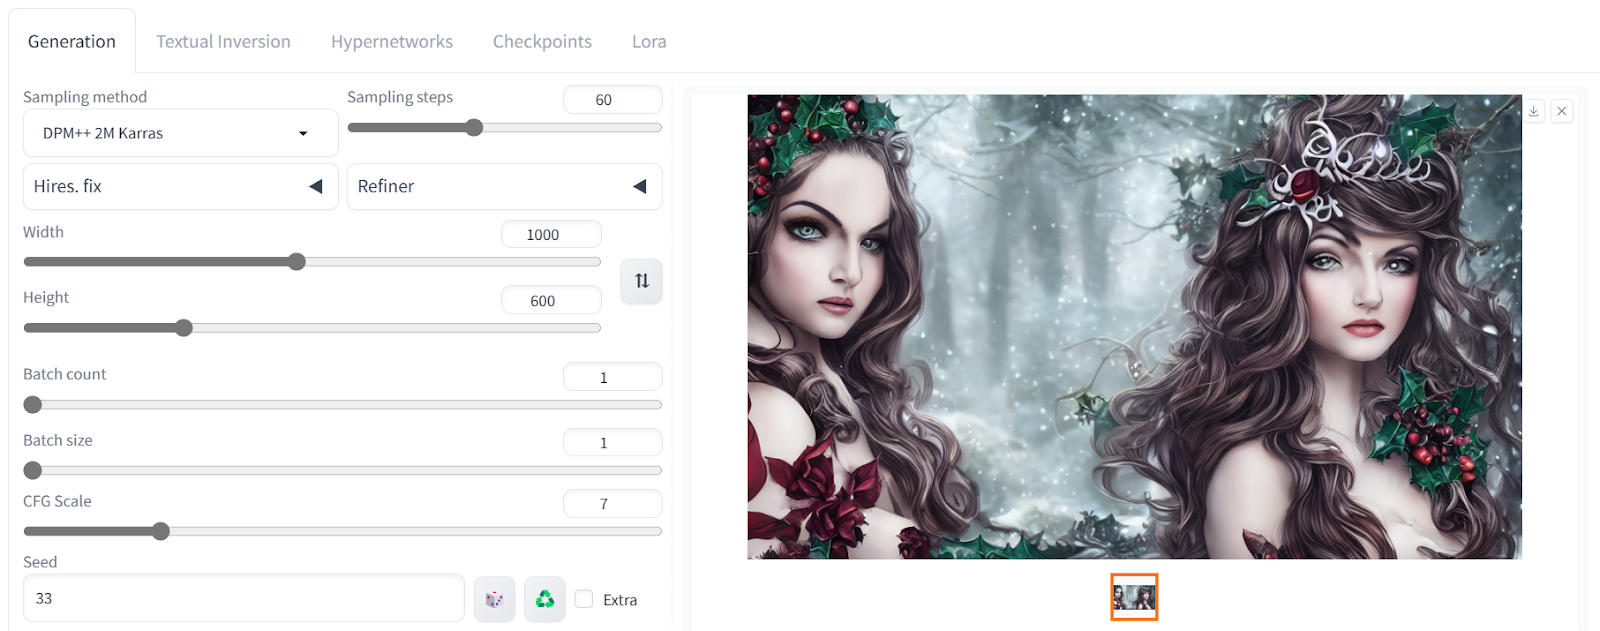
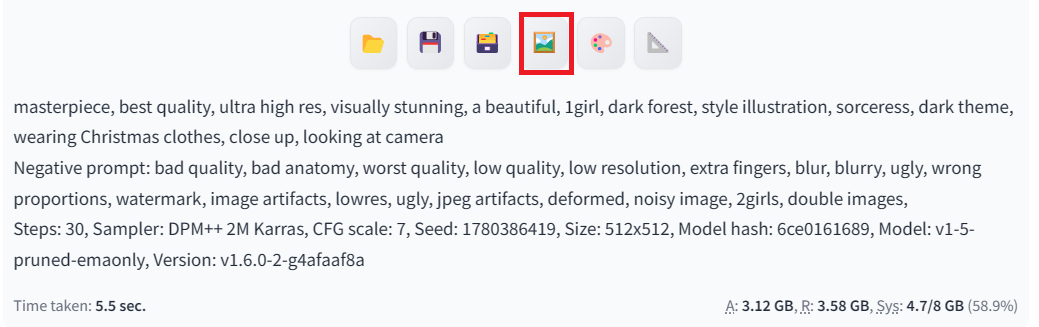
Todas las imágenes generadas incluyen metadatos con los prompts positivos y negativos, además de los ajustes avanzados. Puedes usarlos para reproducir el mismo resultado.
Ahora enviaremos la imagen a la pestaña "img2img" haciendo clic en el botón con el emoji de foto bajo la imagen, como se muestra arriba.
Si quieres crear tu propio modelo de IA generativa desde cero, sigue esta guía: Building a Diffuser Model From Scratch with PyTorch.
Guía de la pestaña Img2img
La pestaña img2img te permite subir una imagen de referencia para generar otra similar usando distintos prompts para diferentes estilos. Hemos incluido un nuevo prompt positivo y mantenido el negativo para generar cuatro imágenes con estilos diferentes. Si quieres generar múltiples imágenes con un único prompt, puedes hacerlo ajustando el Batch count en la configuración de generación.
Prompt positivo: “masterpiece, best quality, ultra high res, visually stunning, a beautiful, 1barbie, pink theme, wearing Christmas clothes, close up, looking at camera, 3d, “
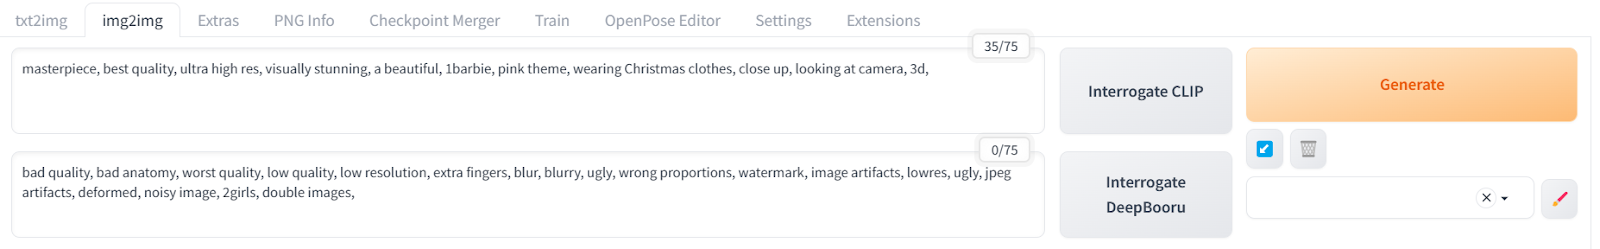
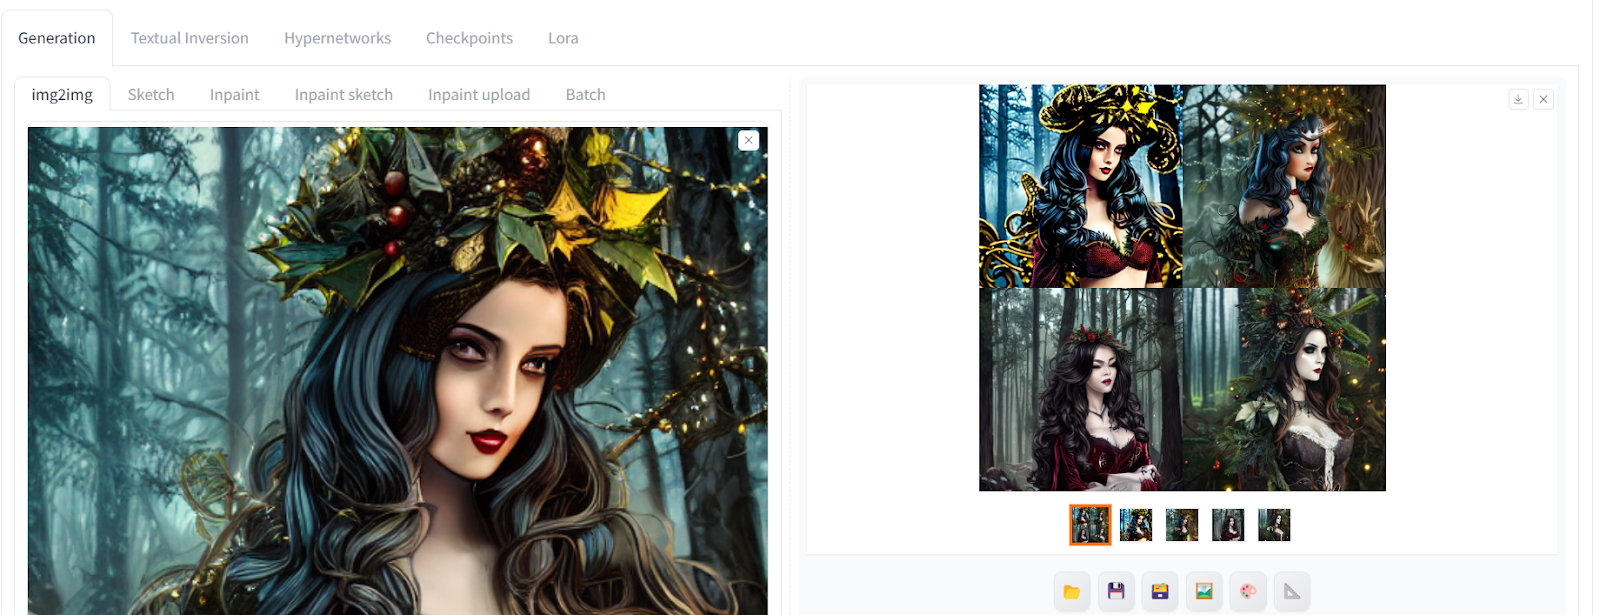
El resultado es espectacular, con estilos y accesorios diferentes. Algunas imágenes no tienen corona y otras son más coloridas.
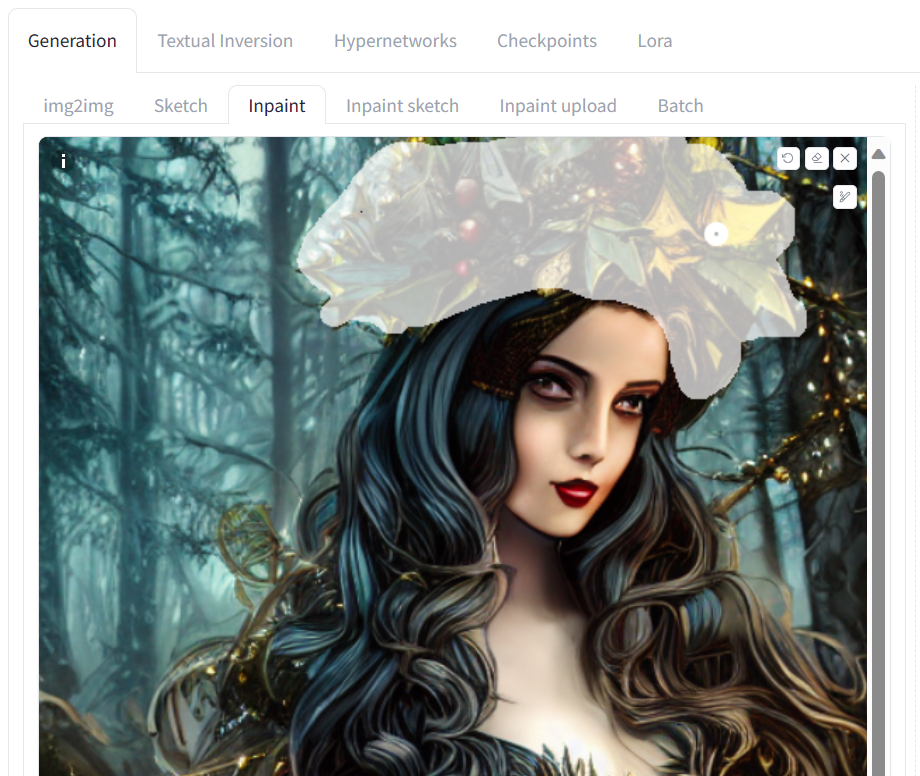
Vamos a la pestaña "Inpaint" para intentar cambiar la corona de madera de la foto. Con la herramienta de inpainting podemos seleccionar solo la parte superior de la cabeza de la chica y convertirla en una corona dorada. El inpainting permite modificar únicamente la parte seleccionada de la imagen.
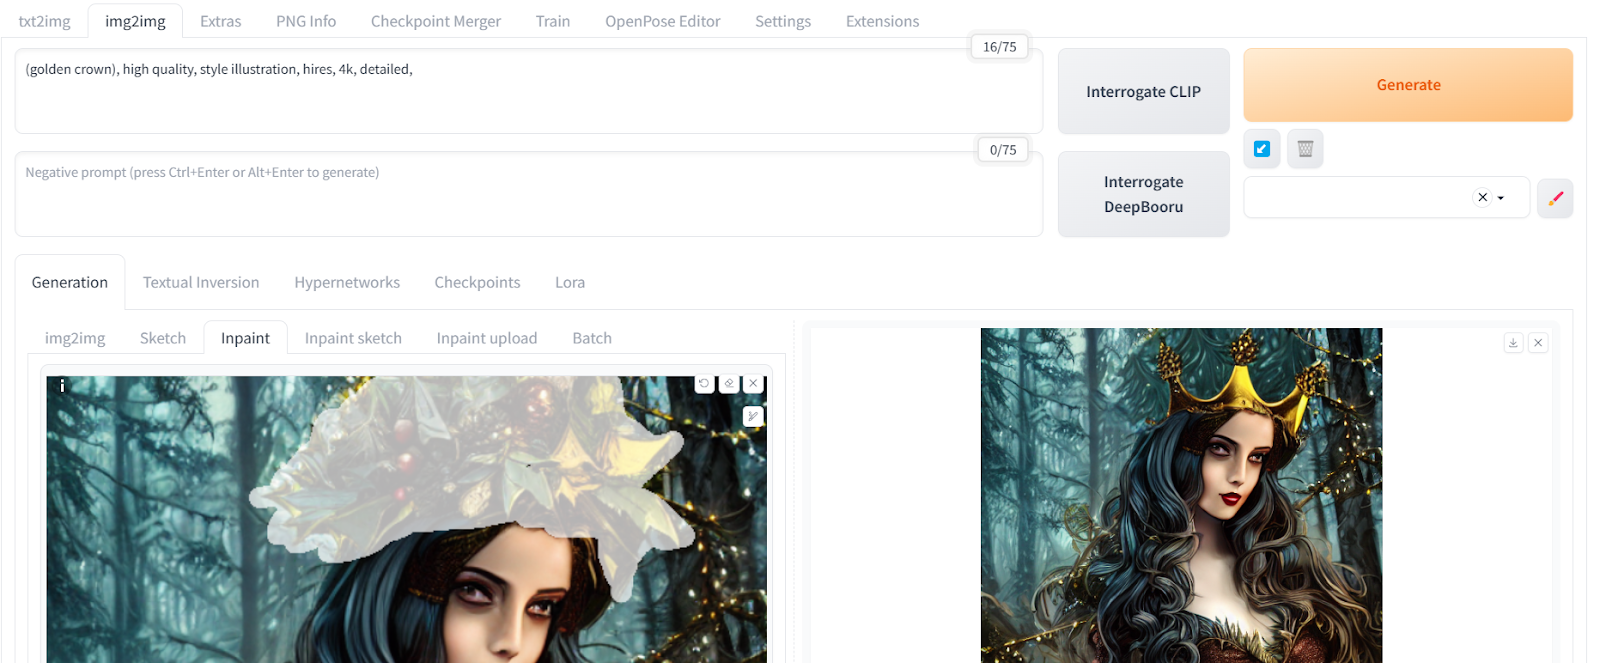
La nueva corona dorada se integra perfectamente en la imagen sin necesidad de Photoshop. Con una herramienta de selección y un prompt sencillo, hemos podido modificar una parte de la imagen.
Uso del reescalado (Upscaler)
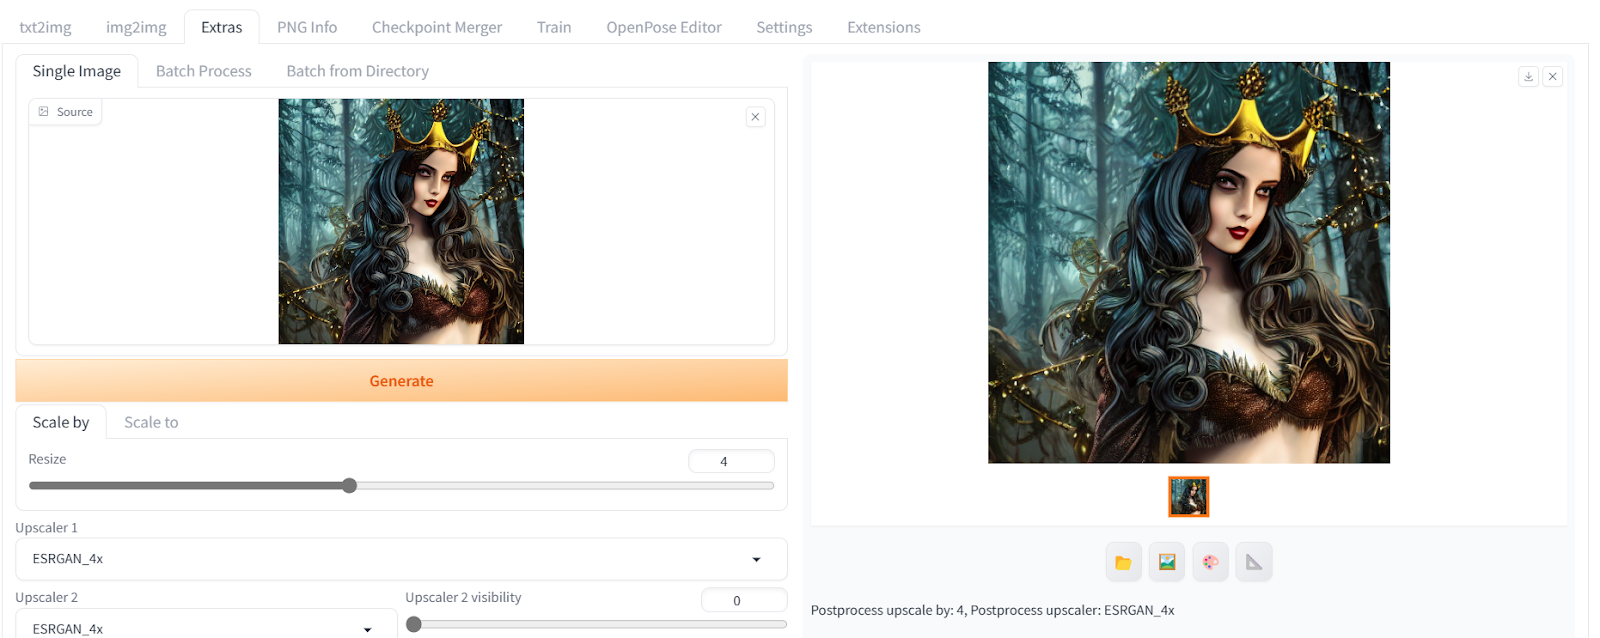
Para aumentar la resolución de la imagen generada, la enviaremos a la pestaña Extras. Escalaremos la imagen por cuatro y dejaremos el resto igual.
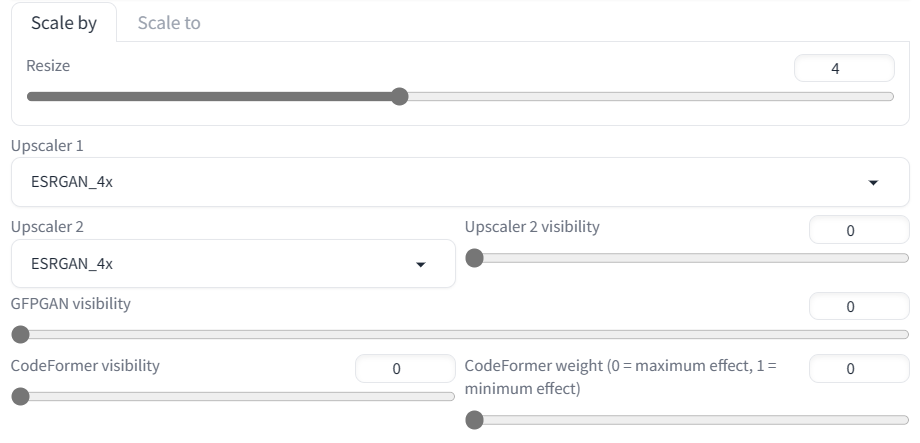
Después haremos clic en el botón Generate para convertir “512X512” en “2048X2048” en unos segundos y sin pérdida de calidad.
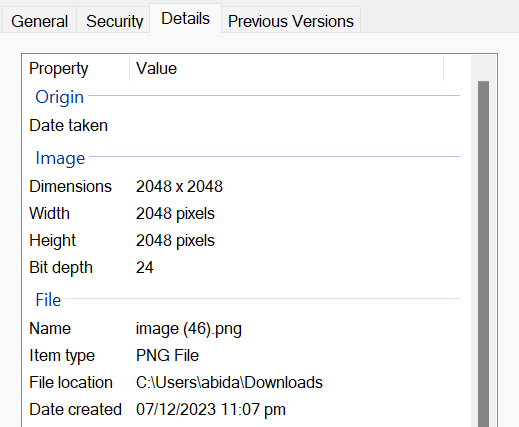
Puedes comprobar el tamaño de una imagen descargándola en tu ordenador y consultando sus propiedades.
Información PNG
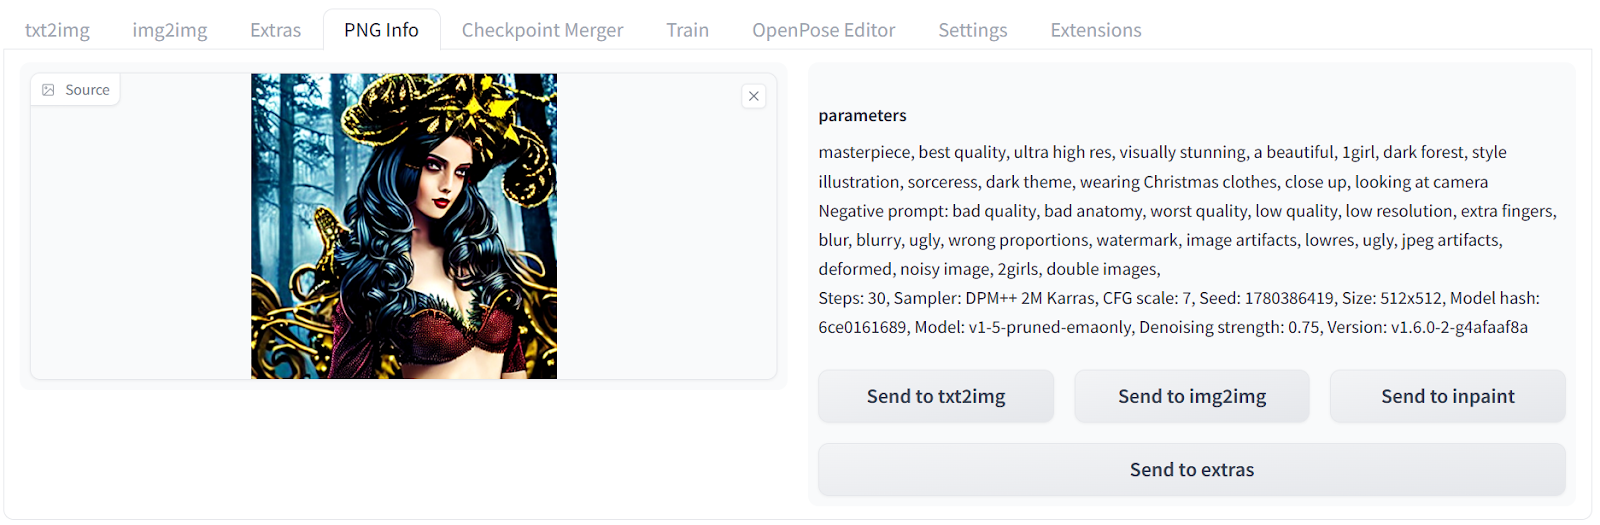
Como ya hemos visto, cada imagen contiene metadatos que indican cómo se generó. Si quieres ver la información de una imagen generada anteriormente, puedes subirla a la pestaña "PNG Info". Ahí podrás consultar los prompts positivos y negativos, así como los ajustes avanzados.
Instalar extensiones
Para instalar extensiones en la Web UI, cambia a la pestaña Extensions y haz clic en install from URL. Después, añade la URL del repositorio de la extensión. En nuestro caso, instalamos la extensión ControNet usando https://github.com/Mikubill/sd-Web UI-controlnet. ControNet es una arquitectura de red neuronal que permite controlar modelos de difusión proporcionando condiciones extra.
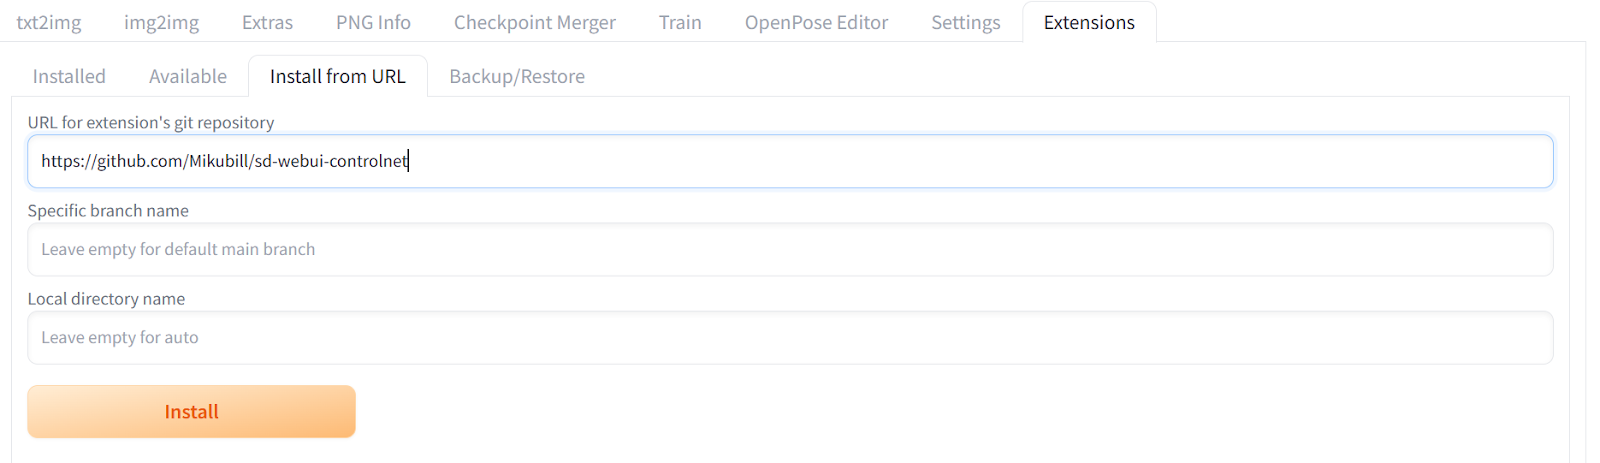
- Luego instalaremos la extensión OpenPose Editor con la URL de GitHub:
https://github.com/fkunn1326/openpose-editory pulsa Install. - Descarga el modelo de OpenPose desde el repositorio de Hugging Face:
hf.co/lllyasviel/ControlNet-v1-1/tree/main. Asegúrate de descargar el archivo “control_v11p_sd15_openpose.pth”. - Mueve el archivo del modelo al directorio de modelos de Stable Diffusion Web UI:
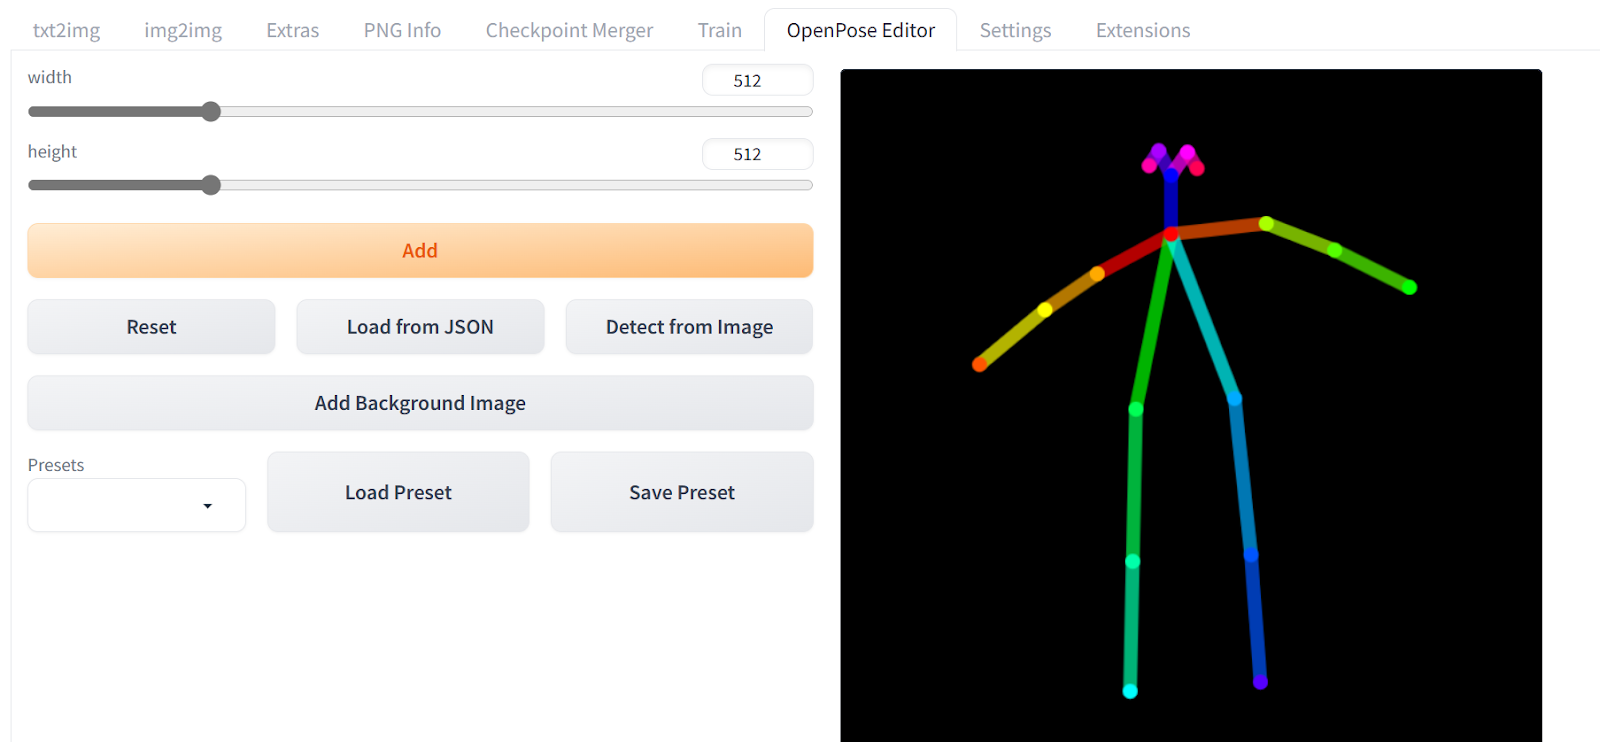
stable-diffusion-Web UI\extensions\sd-Web UI-controlnet\models - Tras instalar correctamente la extensión, tendrás acceso a
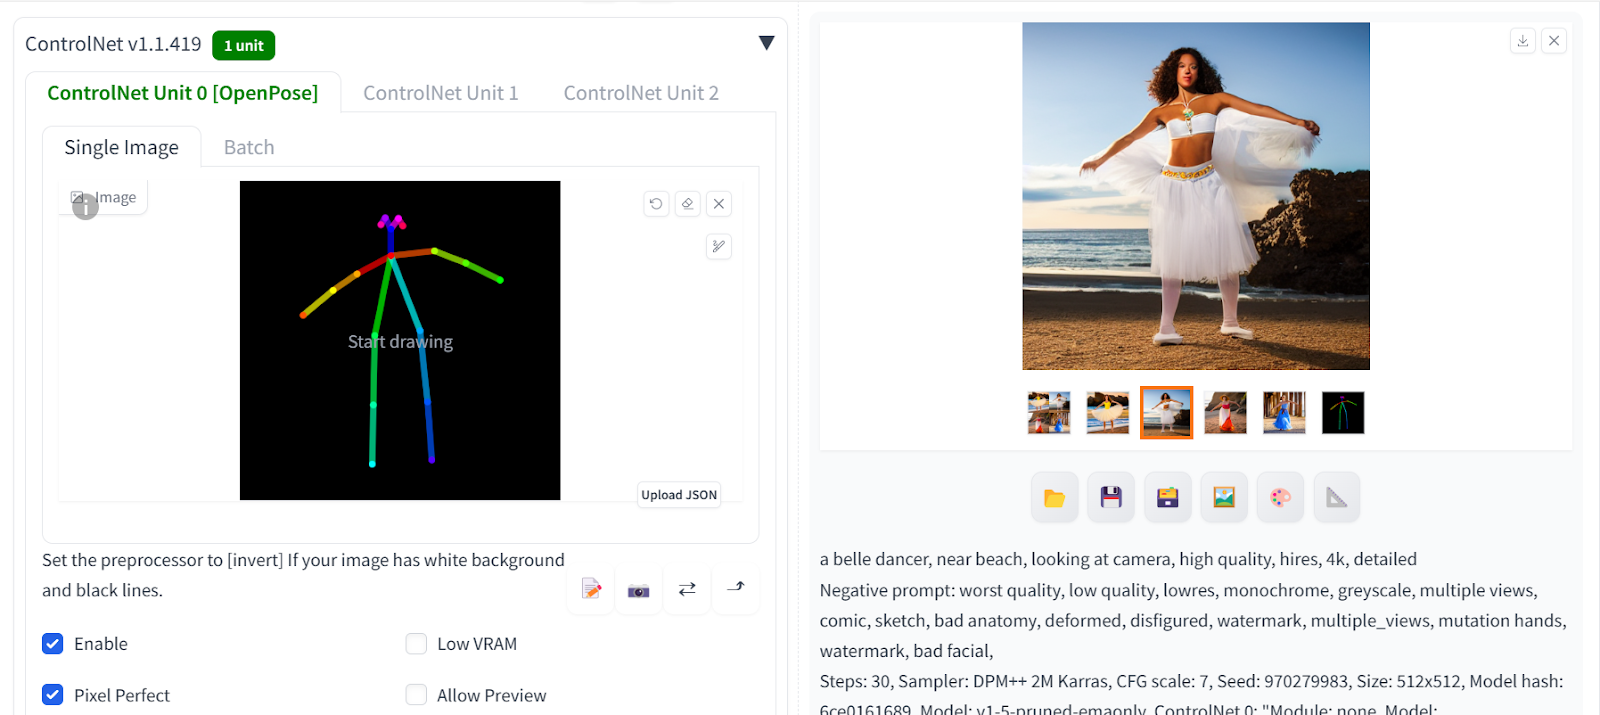
OpenPose Editor. - Cambia la pose del muñeco con el ratón y, cuando termines, haz clic en “Send to txt2img”.
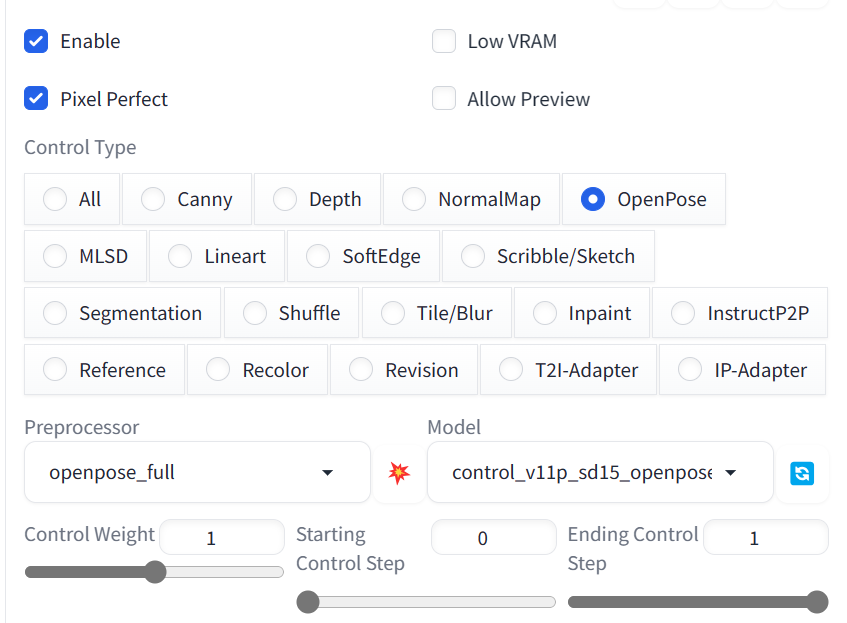
Desplázate hacia abajo y abre el panel de ControlNet. Selecciona Enable, Pixel Perfect y la opción OpenPose.
Después, vuelve arriba y escribe un prompt positivo y otro negativo para generar cuatro imágenes con poses similares.
Prompt positivo: “a belle dancer, near beach, looking at camera, high quality, hires, 4k, detailed “
Prompt negativo: “worst quality, low quality, lowres, monochrome, greyscale, multiple views, comic, sketch, bad anatomy, deformed, disfigured, watermark, multiple_views, mutation hands, watermark, bad facial,”
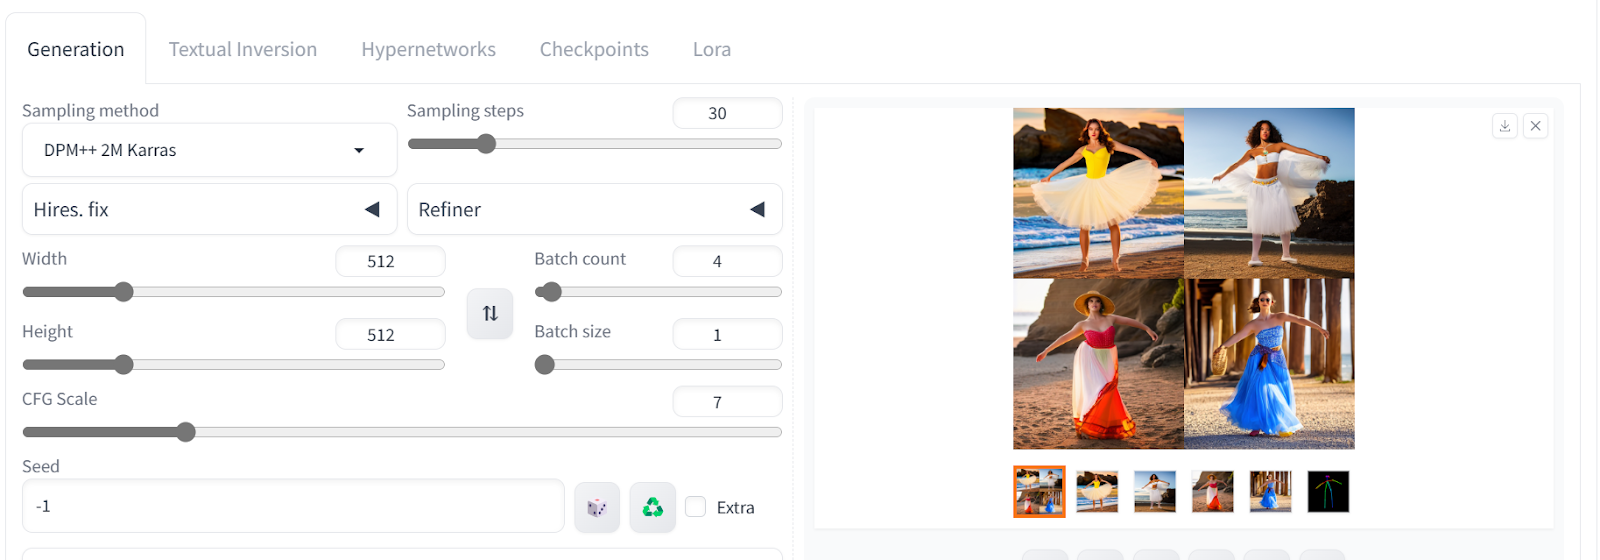
Ahora tenemos cuatro imágenes de mujeres en la misma pose. Haz clic en cualquiera para verlas como una sola imagen.
Uso de modelos personalizados
En esta sección descargaremos y cargaremos un modelo personalizado ajustado con retratos de alta calidad para generar imágenes muy realistas. CivitAI es una plataforma con múltiples modelos abiertos de generación de imágenes. Puedes buscar fácilmente un modelo concreto y descargarlo sin siquiera crear una cuenta.
Puedes afinar el modelo de Stable Diffusion siguiendo la guía Fine-tuning Stable Diffusion XL with DreamBooth and LoRA. La guía ofrece pasos sencillos para ajustar el modelo en Kaggle con acceso gratuito a GPU.
En nuestro caso, descargaremos el modelo RealVisXL V2.0 buscándolo en la web y haciendo clic en el botón de descarga del panel derecho.
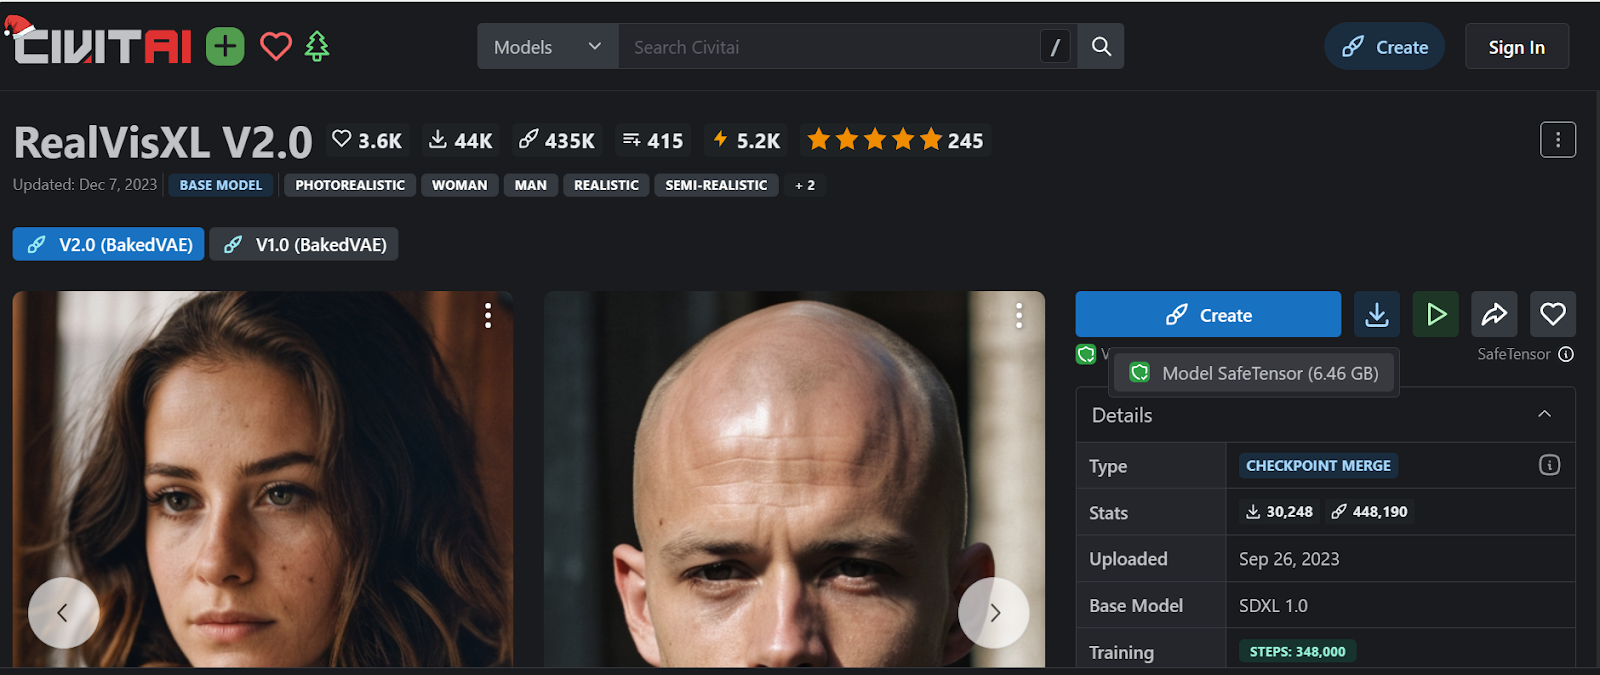
Tras la descarga, muévelo al directorio de modelos de Stable Diffusion Web UI ubicado en C:\Desktop\Web UI\Web UI\models\Stable-diffusion.
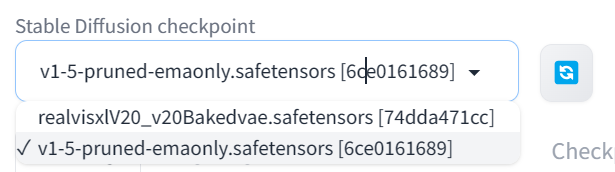
Haz clic en el botón de refrescar arriba a la izquierda y, después, selecciona el modelo RealVisXL más reciente en el desplegable para activarlo.
Nota: si usas una máquina acelerada por CPU, generar una sola imagen puede tardar hasta 5 minutos. Por eso, asegúrate de ejecutar la Web UI en una máquina con GPU.
Para acceder a prompts positivos y negativos optimizados para el modelo ReallVisXL, solo tienes que desplazarte por la página del modelo y hacer clic en la imagen que te interese. Esas imágenes incluyen metadatos que se pueden usar para generar resultados realistas. Por ejemplo, si queremos generar una imagen de Spiderwoman mirando hacia arriba y a cámara, podemos usar los metadatos correspondientes.
Prompt positivo: “An image from a marvel spiderwoman, focused, decisive, surreal, dynamic pose, ultra highres, sharpness texture, High detail RAW Photo, detailed face, shallow depth of field, sharp eyes, (realistic skin texture:1.2), (freckles, moles:0.6), dslr, film grain”
Prompt negativo: “(worst quality, low quality, illustration, 3d, 2d, painting, cartoons, sketch), open mouth”
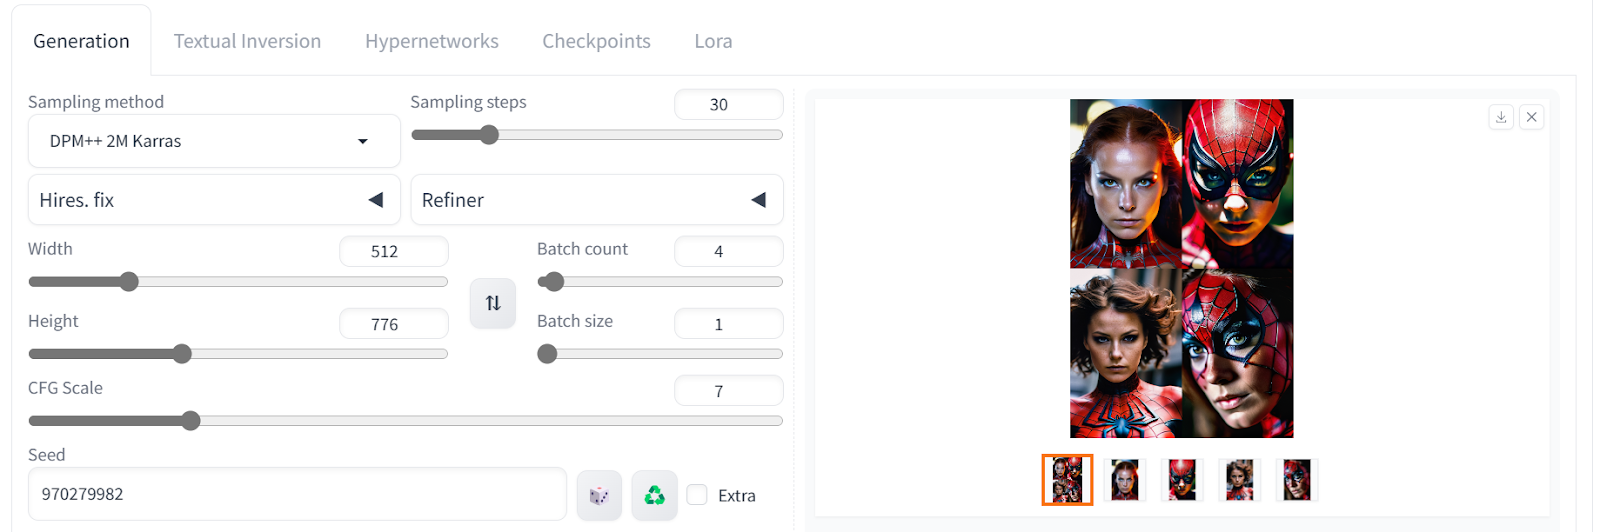
Los resultados son espectaculares: iluminación, color, textura de la piel, pelo y rasgos faciales impecables.
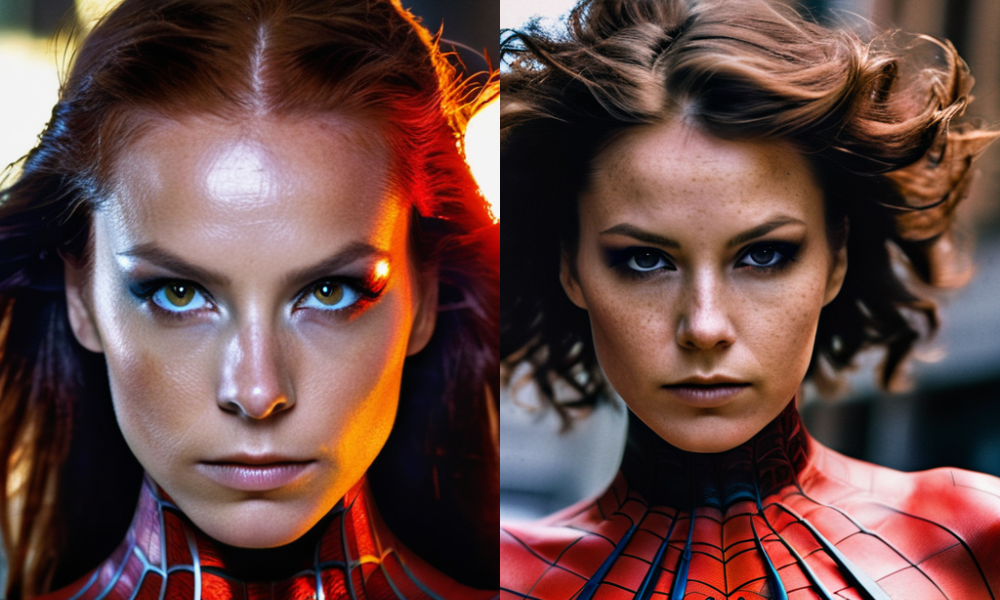
Estas son las dos imágenes con mejor aspecto. Si se las enseñas a tus compañeros, ni siquiera creerán que han sido generadas.
Actualmente, el modelo con mejor rendimiento es DALLE-3; puedes conocerlo leyendo el artículo An Introduction to Using DALL-E 3: Tips, Examples, and Features.
Conclusión
Stable Diffusion Web UI ofrece una forma accesible para que cualquiera aproveche la generación de imágenes con IA. Esta interfaz intuitiva facilita la interacción con modelos de difusión de vanguardia como Stable Diffusion, incluso para personas sin perfil técnico.
En este tutorial hemos visto cómo descargar, instalar y actualizar la Web UI en Windows con una GPU Nvidia. Con SDUI en marcha, exploramos funciones clave como la generación de texto a imagen, la edición de imagen a imagen, el aumento de resolución y más. También instalamos extensiones para ampliar sus capacidades, usando ControNet y generando imágenes con el modelo OpenPose.
Para terminar, usamos un modelo ajustado finamente para generar rostros humanos sorprendentemente realistas. Este repaso deja claro que la Web UI libera un potencial creativo que antes estaba fuera de alcance sin conocimientos avanzados de IA y programación.
En tu próximo proyecto, prueba a usar diffusers en Python para generar imágenes fotorrealistas con IA. Te ayudará a crear tu propia interfaz y a generar imágenes con facilidad.

Serie Code Along: Conviértete en desarrollador de IA
¡Construye sistemas de IA y desarrolla aplicaciones de IA utilizando OpenAI, LangChain, Pinecone y Hugging Face!