Kursus
Menulis Kode Python yang Efisien
4 jam
156K
Bagi data scientist atau software engineer mana pun, kemampuan untuk memetakan hubungan antar titik data secara efisien adalah keterampilan yang tidak bisa ditawar. Jika Anda mem-parsing respons JSON kompleks dari sebuah API, mengagregasi statistik dari dataset masif, atau sekadar mengonfigurasi pengaturan aplikasi, maka dictionary bisa dibilang adalah alat terkuat Python. Dictionary mendorong manipulasi data yang bersih, mudah dibaca, dan sangat teroptimasi.
Siapa pun bisa mencari nilai di dictionary, tetapi keahlian sejati terlihat ketika Anda tahu cara menerapkan metodenya pada alur kerja data dan membuka pola-pola tingkat lanjut.
Dalam artikel ini, kita akan membahas hash table yang membuat dictionary begitu cepat, metode dictionary yang esensial, strategi penanganan error, dan teknik optimisasi kinerja.
Jika Anda baru mengenal dictionary, saya sarankan membaca tutorial dasar kami tentang Python Dictionary sebagai titik awal yang baik.
Dictionary Python adalah struktur data bawaan yang dirancang untuk pencarian yang cepat dan fleksibel. Struktur ini memungkinkan Anda menyimpan dan mengambil nilai menggunakan key yang bermakna alih-alih posisi numerik, menjadikannya ideal untuk merepresentasikan data terstruktur di dunia nyata. Mari kita lihat struktur dan propertinya yang inti.
Sebelum masuk ke detail metode dictionary Python, ada baiknya memahami bagaimana dictionary dibangun di atas hash table. Banyak error yang akan Anda temui, seperti TypeError: unhashable type, berasal langsung dari cara kerja struktur ini.
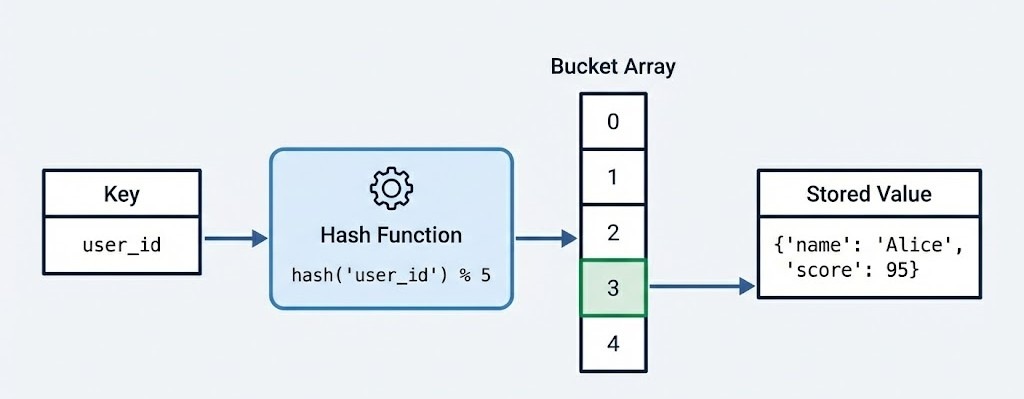
Secara struktural, dictionary Python mengimplementasikan hash table. Pilihan arsitektur ini yang memberi kecepatan dan fleksibilitas pada dictionary. Saat Anda mendefinisikan dictionary, Anda pada dasarnya membuat array jarang, yang sering disebut bucket array.
Saat Anda menyisipkan pasangan key-value, Python meneruskan key melalui fungsi hash. Fungsi ini menghitung bilangan bulat unik (hash) yang menentukan indeks spesifik di bucket array tempat nilai akan disimpan.
Karena desain ini:
Key harus hashable, yang biasanya berarti harus bertipe immutable (mis., str, int, tuple)
Nilai boleh mutable, termasuk list, dictionary lain, atau objek kustom
Pencarian, penyisipan, dan penghapusan berjalan dalam waktu O(1) amortisasi rata-rata
Contoh berikut menunjukkan beberapa key yang valid, tetapi juga menunjukkan bahwa list tidak diterima sebagai key dictionary:
# Valid dictionary - immutable keys, any values
user_data = {
    "name": "Alice",           # string key, string value
    42: [1, 2, 3],             # integer key, list value
    (10, 20): {"nested": True} # tuple key, dict value
}
print(type(user_data), "valid dict")

# Invalid - will raise TypeError
try:
    invalid_dict = {[1, 2]: "value"}  # lists are not hashable
except TypeError as e:
    print(f"Error: {e}")
<class 'dict'> valid dict
Error: unhashable type: 'list'Struktur ini penting untuk kinerja. Sementara pencarian item di list mengharuskan iterasi elemen satu per satu, operasi O(n), pengambilan nilai dari dictionary rata-rata adalah operasi O(1).
Ini berarti mencari user ID dalam dataset berisi satu juta pengguna memakan waktu kira-kira sama dengan dalam dataset berisi sepuluh pengguna. Memahami perbedaan tipe data di Python adalah kunci untuk memilih struktur yang tepat untuk kasus penggunaan Anda.
Salah satu perubahan paling signifikan dalam sejarah Python terjadi pada versi 3.7. Sebelumnya, dictionary dianggap sebagai koleksi tanpa urutan, dan iterasi atasnya bisa menghasilkan key dalam urutan yang tampak acak. Jika Anda mencetak dictionary, item mungkin muncul dalam urutan berbeda dari saat Anda menyisipkannya, bergantung pada nilai hash dan riwayat array internal.
Namun, mulai Python 3.6, dictionary mulai mempertahankan urutan penyisipan sebagai detail implementasi di CPython. Lalu, mulai Python 3.7 (dan dijamin secara resmi dalam spesifikasi bahasa), dictionary mempertahankan urutan penyisipan.
Peralihan dari mapping tanpa urutan ke berurutan ini memiliki beberapa implikasi penting untuk pengembangan Python modern. Misalnya, serialisasi JSON kini menghasilkan output yang dapat diprediksi, sehingga mempermudah debug dan memastikan reprodusibilitas data antar-run.
Jika Anda bekerja dengan pipeline data di mana urutan penting, seperti memproses event deret waktu atau mempertahankan hierarki konfigurasi, jaminan ini menghilangkan satu kelas bug halus. Selanjutnya, mari lihat cara membuat dictionary.
Membuat dictionary tampak sederhana, tetapi metode yang Anda pilih dapat memengaruhi keterbacaan dan kinerja kode. Python menyediakan berbagai cara inisialisasi, mulai dari literal sederhana hingga teknik pembangkitan terprogram tingkat lanjut untuk alur kerja data science. Mari lihat cara-cara terpentingnya.
Cara paling umum dan disukai untuk membuat dictionary adalah menggunakan sintaks kurung kurawal {}. Notasi literal ini tidak hanya lebih mudah dibaca tetapi juga lebih cepat daripada metode alternatif. Python dapat mengoptimalkan konstruksi bytecode secara langsung tanpa overhead pemanggilan fungsi. Di bawah ini adalah kode yang menunjukkan dictionary:
# Preferred: Literal syntax
user_profile = {
    "name": "Alice",
    "role": "Data Scientist",
    "active": True
}
user_profile
{'name': 'Alice', 'role': 'Data Scientist', 'active': True}Namun, konstruktor dict() tak tergantikan dalam beberapa skenario. Ia bertindak sebagai pengonversi tipe, memungkinkan Anda membangun dictionary dari deret tuple atau argumen keyword. Ini sangat berguna dalam kasus-kasus berikut:
# Using keyword arguments (cleaner for string keys)
config = dict(host="localhost", port=8080, debug=True)
print(config)

# Converting a list of tuples (common in data processing)
pairs = [("a", 1), ("b", 2), ("c", 3)]
lookup_table = dict(pairs)
print(lookup_table)
{'host': 'localhost', 'port': 8080, 'debug': True}
{'a': 1, 'b': 2, 'c': 3}Untuk skenario pembuatan dictionary yang lebih kompleks, dictionary comprehension menawarkan cara ringkas dan efisien untuk memfilter, mentransformasi, atau menghasilkan pasangan key-value secara terprogram. Ini adalah teknik esensial bagi praktisi data yang perlu memproses dan membentuk ulang data secara dinamis.
Comprehension penting untuk tugas seperti:
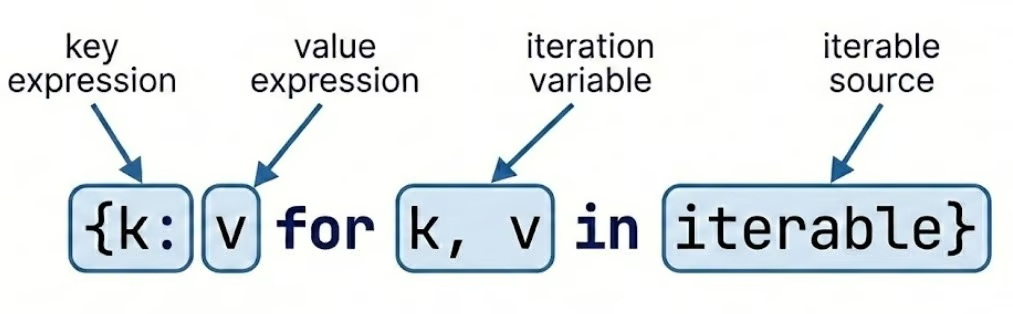
Mari kita lihat cara membuat dictionary comprehension di bawah ini:
# Classic use case: Creating a squares map
squares = {x: x**2 for x in range(5)}
print(squares)

# Filtering data during creation
raw_data = {"a": 10, "b": None, "c": 5}
clean_data = {k: v for k, v in raw_data.items() if v is not None}
print(clean_data)
{0: 0, 1: 1, 2: 4, 3: 9, 4: 16}
{'a': 10, 'c': 5}Jika Anda ingin mendalami lebih jauh, saya sarankan mempelajari tutorial Python Dictionary Comprehension kami.
Metode dictionary Python lain yang berguna untuk inisialisasi adalah dict.fromkeys(). Metode ini membuat dictionary baru dengan key yang ditentukan dan satu nilai yang sama. Ini sering digunakan untuk menginisialisasi pencacah atau flag status.
# Initialize multiple keys with the same default value
categories = ["electronics", "clothing", "food", "books"]
inventory = dict.fromkeys(categories, 0)
print(inventory)

# Initialize with None for optional fields
user_fields = ["email", "phone", "address", "company"]
user_profile = dict.fromkeys(user_fields)
print(user_profile)
{'electronics': 0, 'clothing': 0, 'food': 0, 'books': 0}
{'email': None, 'phone': None, 'address': None, 'company': None}Saat menggunakan .fromkeys() dengan objek mutable seperti list atau dictionary, semua key akan mereferensikan objek yang sama di memori. Ini menciptakan jebakan “shared reference” yang dapat menimbulkan perilaku tak terduga. Mari lihat contohnya:
# DANGEROUS - all keys share the same list!
categories = ["A", "B", "C"]
wrong_way = dict.fromkeys(categories, [])
wrong_way["A"].append(1)
print(wrong_way)

# CORRECT - use dictionary comprehension for independent lists
right_way = {cat: [] for cat in categories}
right_way["A"].append(1)
print(right_way)
{'A': [1], 'B': [1], 'C': [1]}
{'A': [1], 'B': [], 'C': []}Kita bisa melihat nilai yang sama dibagikan oleh semua key pada kasus pertama. Untuk menghindarinya, kita perlu menggunakan dictionary comprehension untuk list yang independen.
Setelah dictionary dibuat, berinteraksi dengan data di dalamnya adalah salah satu tugas pemrograman harian yang paling umum. Mari lihat beberapa caranya.
Ada beberapa cara berbeda untuk mengakses nilai.
Cara paling langsung untuk mengambil nilai dari dictionary adalah melalui notasi bracket d[key], yang mengembalikan nilai terkait jika key ada. Pendekatan ini ideal saat Anda yakin key ada di dictionary. Berikut kodenya:
product = {
    "name": "Laptop",
    "price": 1299.99,
    "stock": 45,
    "category": "Electronics"
}

# Direct access with brackets
print(product["name"])
print(product["price"])

# Attempting to access a non-existent key raises KeyError
try:
    print(product["manufacturer"])
except KeyError as e:
    print(f"Key not found: {e}")
Laptop
1299.99
Key not found: 'manufacturer'Untuk pengambilan yang lebih aman ketika keberadaan key tidak pasti, metode .get() memberikan solusi elegan. Metode ini mengembalikan None (atau nilai default yang ditentukan) alih-alih melempar pengecualian jika key tidak ada.
# Safe retrieval with .get()
manufacturer = product.get("manufacturer")
print(manufacturer)  # None

# Provide a custom default value
warranty = product.get("warranty", "No warranty information")
print(warranty)

# .get() is especially useful in data pipelines
customer_data = {"name": "John Doe", "email": "john@example.com"}

phone = customer_data.get("phone", "Not provided")
print(phone)

address = customer_data.get("address", "Not provided")
print(address)
None
No warranty information
Not provided
Not providedMetode .setdefault() menggabungkan pengambilan dan penyisipan dalam satu operasi. Ia mengambil nilai jika key ada, atau menyisipkan nilai default dan mengembalikannya jika key tidak ada—sempurna untuk pola akumulasi.
# Using .setdefault() for initialization and retrieval
page_visits = {}

# First visit to 'home' - inserts 0 and returns it
count = page_visits.setdefault("home", 0)
print(count)
page_visits["home"] += 1

# Subsequent call returns existing value
count = page_visits.setdefault("home", 0)
print(count)

# Practical example: grouping items
inventory = [
    ("apple", "fruit"),
    ("carrot", "vegetable"),
    ("banana", "fruit"),
    ("broccoli", "vegetable")
]

grouped = {}
for item, category in inventory:
    grouped.setdefault(category, []).append(item)

print(grouped)
0
1
{'fruit': ['apple', 'banana'], 'vegetable': ['carrot', 'broccoli']}Dictionary bersifat dinamis; Anda sering perlu menambah atau menghapus data seiring program berjalan.
Menambahkan satu pasangan semudah assignment (d['new'] = 1), tetapi untuk operasi massal, metode .update() lebih baik. Metode ini menerima dictionary lain atau iterable pasangan key-value, dan menggabungkannya ke objek yang ada.
Mari lihat cara menggunakan metode .update():
# Simple assignment for single key-value pairs
user = {"username": "alice_2024", "role": "analyst"}
user["email"] = "alice@company.com"  # Add new key
user["role"] = "senior_analyst"      # Update existing key

# Bulk update with .update()
user.update({"department": "Analytics", "level": 3})
print(user)

# Update from sequence of tuples
additional_info = [("projects", 12), ("rating", 4.8)]
user.update(additional_info)
print(user)

# Update with keyword arguments
user.update(active=True, certified=True)
print(user)
{'username': 'alice_2024', 'role': 'senior_analyst', 'email': 'alice@company.com', 'department': 'Analytics', 'level': 3}
{'username': 'alice_2024', 'role': 'senior_analyst', 'email': 'alice@company.com', 'department': 'Analytics', 'level': 3, 'projects': 12, 'rating': 4.8}
{'username': 'alice_2024', 'role': 'senior_analyst', 'email': 'alice@company.com', 'department': 'Analytics', 'level': 3, 'projects': 12, 'rating': 4.8, 'active': True, 'certified': True}Untuk panduan terperinci tentang menambahkan item, saya sarankan membaca panduan Python Dictionary Append ini.
Python menawarkan tiga metode berbeda untuk menghapus entri dictionary, masing-masing dengan perilaku dan kasus penggunaan berbeda:
.pop(key): Menghapus key dan mengembalikan nilainya. Berguna saat Anda perlu menggunakan data tersebut untuk terakhir kalinya sebelum menghapusnya.
.popitem(): Menghapus dan mengembalikan pasangan key-value terakhir yang disisipkan (LIFO). Ini adalah manfaat langsung dari sifat terurut dictionary modern.
del d[key]: murni menghapus key. Tidak mengembalikan nilai dan sedikit lebih cepat jika nilai kembalian tidak diperlukan.
Mari lihat contoh metode-metode ini:
Metode .pop():
scores = {"Alice": 95, "Bob": 87, "Carol": 92, "David": 78}

# .pop() - removes key and returns its value
alice_score = scores.pop("Alice")
print(alice_score)
print(scores)
95
{'Bob': 87, 'Carol': 92, 'David': 78}Metode .popitem():
# .popitem() - removes and returns last inserted pair (LIFO in Python 3.7+)
scores = {"Alice": 95, "Bob": 87, "Carol": 92, "David": 78}
last_item = scores.popitem()
print(last_item)
print(scores)
('David', 78)
{'Alice': 95, 'Bob': 87, 'Carol': 92}del:
# del statement - removes key without returning value
scores = {"Alice": 95, "Bob": 87, "Carol": 92, "David": 78}
del scores["Bob"]
print(scores)
{'Alice': 95, 'Carol': 92, 'David': 78}Metode .clear() mengosongkan seluruh dictionary, menyisakan objek {} kosong. Ini berbeda dari menghapus variabel itu sendiri. Objek tetap ada di memori, hanya saja kosong. Mari lihat cara kerjanya:
# .clear() - removes all items but keeps the dictionary object
scores = {"Alice": 95, "Bob": 87, "Carol": 92, "David": 78}
scores.clear()
print(scores)
print(type(scores))
{}
<class 'dict'>Perbedaan di antara metode-metode ini penting. Gunakan .pop() saat Anda memerlukan nilai yang dihapus, .popitem() untuk perilaku seperti stack, del untuk penghapusan sederhana, dan .clear() untuk mereset dictionary sambil mempertahankan identitasnya.
Pada versi lama Python 2, metode seperti .keys() mengembalikan list statis. Di Python versi kini (3.x), metode ini mengembalikan objek view. View adalah jendela dinamis ke dictionary. Jika dictionary berubah, view mencerminkan perubahan itu seketika tanpa perlu dipanggil ulang.
Anda dapat beriterasi melalui key (.keys()), nilai (.values()), atau keduanya sekaligus menggunakan .items(). Mari lihat metode-metode ini dengan contoh:
experiment = {
    "model": "RandomForest",
    "accuracy": 0.94,
    "precision": 0.91,
    "recall": 0.89
}

# .keys() returns a view of all keys
print(experiment.keys())

# .values() returns a view of all values
print(experiment.values())

# .items() returns (key, value) tuples - most commonly used
for metric, value in experiment.items():
    if isinstance(value, float):
        print(f"{metric}: {value:.2%}")
dict_keys(['model', 'accuracy', 'precision', 'recall'])
dict_values(['RandomForest', 0.94, 0.91, 0.89])
accuracy: 94.00%
precision: 91.00%
recall: 89.00%Sifat dinamis objek view berarti ia secara otomatis mencerminkan perubahan yang dibuat pada dictionary setelah view dibuat. Mari lihat contohnya:
metrics = {"MAE": 0.23, "RMSE": 0.45}
keys_view = metrics.keys()
print(keys_view)

# Add new metric
metrics["R2"] = 0.87
print(keys_view)
dict_keys(['MAE', 'RMSE'])
dict_keys(['MAE', 'RMSE', 'R2'])Fitur kuat dari objek view adalah mendukung operasi himpunan. Anda dapat melakukannya langsung pada key view untuk membandingkan dua dictionary secara efisien menggunakan operator berikut:
Intersection: &
Union: |
Difference: -
Symmetric difference/XOR: ^
Mari lihat contohnya:
dict1 = {"a": 1, "b": 2, "c": 3}
dict2 = {"b": 20, "c": 30, "d": 4}

# Find common keys (intersection)
common_keys = dict1.keys() & dict2.keys()
print(common_keys)

# Find all unique keys (union)
all_keys = dict1.keys() | dict2.keys()
print(all_keys)

# Find keys in dict1 but not in dict2 (difference)
unique_to_dict1 = dict1.keys() - dict2.keys()
print(unique_to_dict1)

# Symmetric difference - keys in either but not both
exclusive_keys = dict1.keys() ^ dict2.keys()
print(exclusive_keys)
{'b', 'c'}
{'b', 'c', 'd', 'a'}
{'a'}
{'d', 'a'}Operasi himpunan berbasis view ini jauh lebih hemat memori daripada mengonversi dictionary ke set secara eksplisit, terutama saat bekerja dengan dataset besar.
Karena dictionary sering digunakan sebagai antarmuka utama untuk data eksternal, seperti payload JSON dari API atau file konfigurasi, dictionary merupakan sumber umum error runtime. Menulis kode yang tangguh membutuhkan lebih dari sekadar mengetahui cara mengakses data. Ini juga butuh pengetahuan cara menangani ketiadaannya.
Error dictionary paling umum adalah KeyError, yang terjadi saat mencoba mengakses key yang tidak ada. Python menawarkan dua pendekatan filosofis untuk menanganinya:
Pola EAFP dianggap lebih Pythonic dan sering berkinerja lebih baik saat key biasanya ada, karena menghindari pengecekan berulang. Pola ini menggunakan blok try-except untuk menangani error setelah terjadi, dengan asumsi operasi biasanya akan berhasil. Mari lihat cara kerjanya:
# EAFP approach - try first, handle exceptions
user_data = {"username": "data_analyst", "email": "analyst@company.com"}

try:
    phone = user_data["phone"]
    print(f"Phone: {phone}")
except KeyError:
    print("Phone number not available")
    phone = None

# More sophisticated error handling with specific actions
config = {"host": "localhost", "port": 5432}

try:
    database = config["database"]
except KeyError:
    print("Warning: Database not specified, using default")
    database = "default_db"
    config["database"] = database  # Add missing configuration
Phone number not available
Warning: Database not specified, using defaultNamun, ada skenario di mana gagal secara jelas, membiarkan KeyError menyebar, justru lebih disukai daripada kegagalan senyap. Dalam pendekatan LBYL, Anda secara eksplisit memeriksa keberadaan key sebelum mengaksesnya. Mari lihat contohnya:
# Critical configuration - fail loudly if missing
required_config = {"api_key": "secret123", "endpoint": "api.example.com"}

def initialize_api(config):
    # Don't catch KeyError - we WANT the program to crash if required keys are missing
    api_key = config["api_key"]
    endpoint = config["endpoint"]
    timeout = config.get("timeout", 30)  # Optional with default

    return {"key": api_key, "endpoint": endpoint, "timeout": timeout}
Memanggil fungsi ini akan memunculkan KeyError jika ada key yang hilang di dictionary, dan itu adalah perilaku yang benar karena lebih baik gagal saat inisialisasi daripada diam-diam gagal saat produksi.
Saat memproses data dari sumber eksternal seperti API atau input pengguna, penanganan error eksplisit menjadi penting. Mari lihat contohnya:
# Processing API response with defensive error handling
def extract_user_info(api_response):
    """Extract user information with comprehensive error handling."""
    user_info = {}

    try:
        user_info["id"] = api_response["user"]["id"]
        user_info["name"] = api_response["user"]["profile"]["name"]
    except KeyError as e:
        print(f"Missing required field in API response: {e}")
        return None

    # Optional fields - use .get() with defaults
    user_info["email"] = api_response.get("user", {}).get("contact", {}).get("email", "N/A")
    user_info["verified"] = api_response.get("user", {}).get("verified", False)

    return user_info

# Example usage
response = {
    "user": {
        "id": 12345,
        "profile": {"name": "Jane Smith"},
        "verified": True
    }
}

user = extract_user_info(response)
print(user)
{'id': 12345, 'name': 'Jane Smith', 'email': 'N/A', 'verified': True}Memahami kapan menggunakan .get() versus notasi bracket versus try-except itu penting.
Pendekatan LBYL menggunakan pernyataan kondisional dengan operator in dan not in untuk memeriksa keberadaan key sebelum mencoba mengaksesnya. Pola ini lebih jelas saat berurusan dengan logika kondisional atau ketika Anda perlu mengambil tindakan berbeda berdasarkan keberadaan key. Mari lihat contohnya:
# Proactive checking with 'in' operator
student_grades = {
    "Alice": 95,
    "Bob": 87,
    "Carol": 92
}

# Check before access
student_name = "David"
if student_name in student_grades:
    print(f"{student_name}'s grade: {student_grades[student_name]}")
else:
    print(f"No grade recorded for {student_name}")

# Conditional update based on existence
if "David" not in student_grades:
    student_grades["David"] = 0  # Initialize new student
    print("New student added to grading system")

# Multiple key checks for validation
required_fields = ["name", "email", "department"]
employee_record = {"name": "John Doe", "email": "john@company.com"}

missing_fields = [field for field in required_fields if field not in employee_record]
if missing_fields:
    print(f"Error: Missing required fields: {missing_fields}")
else:
    print("All required fields present")
No grade recorded for David
New student added to grading system
Error: Missing required fields: ['department']Saat memvalidasi dictionary yang berasal dari sumber eksternal seperti JSON dari API, file CSV, atau input pengguna, pengujian keanggotaan secara proaktif memberikan logika validasi yang jelas dan mudah dibaca. Mari lihat contohnya:
# Validating API response structure
def validate_product_data(product):
    """Validate product dictionary has all required fields."""
    required = ["id", "name", "price", "category"]
    optional = ["description", "stock", "manufacturer"]

    # Check all required fields exist
    for field in required:
        if field not in product:
            raise ValueError(f"Missing required field: {field}")

    # Validate data types for existing fields
    if "price" in product and not isinstance(product["price"], (int, float)):
        raise TypeError("Price must be a number")

    if "stock" in product and product["stock"] < 0:
        raise ValueError("Stock cannot be negative")

    return True

# Example usage with proper error handling
product_from_api = {
    "id": 101,
    "name": "Wireless Mouse",
    "price": 29.99,
    "category": "Electronics",
    "stock": 150
}

try:
    if validate_product_data(product_from_api):
        print("Product data validated successfully")
        # Proceed with processing
except (ValueError, TypeError) as e:
    print(f"Validation failed: {e}")
Product data validated successfullyPilihan antara EAFP dan LBYL sering bergantung pada kasus penggunaan Anda. Gunakan EAFP saat operasi biasanya berhasil dan pengecualian jarang terjadi. Gunakan LBYL saat Anda memerlukan logika percabangan eksplisit atau saat memvalidasi input sebelum operasi mahal.
Sebelum melakukan iterasi atas dictionary yang berasal dari sumber eksternal, praktik terbaik adalah:
Dengan mengikuti praktik ini, Anda dapat membuat kode jauh lebih tangguh saat menangani data yang tidak terduga atau tidak lengkap dari API, input pengguna, atau file konfigurasi.
Untuk tinjauan lebih mendalam tentang penulisan kode Python yang tangguh, saya sarankan mengikuti kursus Writing Efficient Python Code.
Seiring proyek data science Anda bertambah kompleks, Anda sering perlu menggabungkan, menyalin, dan mentransformasi dictionary. Mempelajari operasi lanjutan ini memungkinkan Anda memanipulasi struktur data secara efisien sambil menghindari bug halus yang dapat menggagalkan pipeline. Mari lihat beberapa metodenya.
Python 3.9 memperkenalkan operator union yang elegan untuk menggabungkan dictionary:
| (merge operator): Membuat dictionary gabungan baru.
|= (update operator): Memperbarui dictionary yang ada secara in-place.
Operator ini menyediakan sintaks yang bersih dan mudah dibaca untuk menggabungkan data dari banyak sumber. Mari lihat contohnya:
# Union operator | creates a new merged dictionary
defaults = {"theme": "light", "language": "en", "notifications": True}
user_prefs = {"theme": "dark", "font_size": 14}

final_config = defaults | user_prefs
print(final_config)

# Update operator |= modifies in place
settings = {"auto_save": True, "theme": "light"}
settings |= {"theme": "dark", "font_size": 12}
print(settings)
{'theme': 'dark', 'language': 'en', 'notifications': True, 'font_size': 14}
{'auto_save': True, 'theme': 'dark', 'font_size': 12}Untuk Python versi sebelum 3.9, metode unpacking double-star (**) memberikan fungsi serupa:
# Double-star unpacking
base_config = {"host": "localhost", "port": 5432, "ssl": False}
override_config = {"port": 5433, "ssl": True, "timeout": 30}

# Merge using unpacking
merged = {**base_config, **override_config}
print(merged)

# Multiple dictionary merge
db_config = {"database": "analytics"}
auth_config = {"username": "admin", "password": "secret"}
pool_config = {"pool_size": 10, "max_overflow": 20}

complete_config = {**db_config, **auth_config, **pool_config}
print(complete_config)
{'host': 'localhost', 'port': 5433, 'ssl': True, 'timeout': 30}
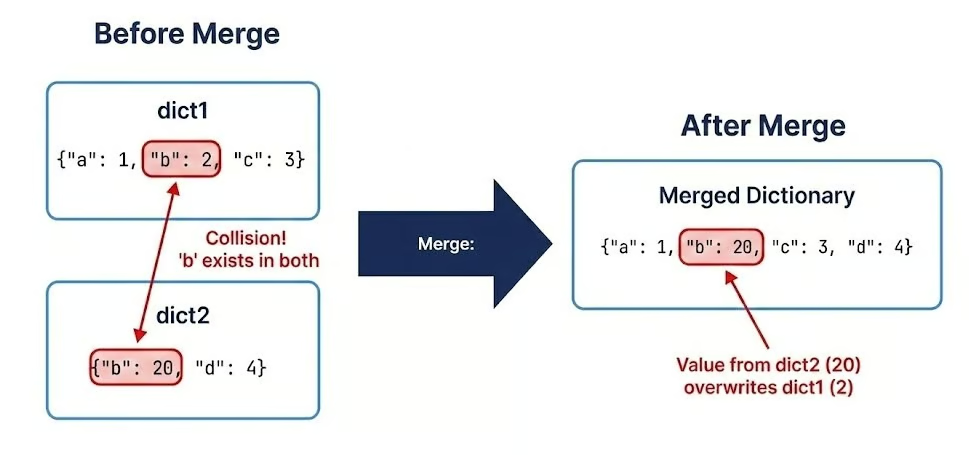
{'database': 'analytics', 'username': 'admin', 'password': 'secret', 'pool_size': 10, 'max_overflow': 20}Di semua teknik penggabungan, aturannya sederhana: yang terakhir menang. Nilai dari dictionary sisi kanan menimpa yang kiri jika key bertabrakan:
dict1 = {"a": 1, "b": 2, "c": 3}
dict2 = {"b": 20, "c": 30, "d": 4}
dict3 = {"c": 300, "e": 5}

result = dict1 | dict2 | dict3
print(result)

result2 = {**dict1, **dict2, **dict3}
print(result2)

# Order matters - reversing changes the result
result3 = dict3 | dict2 | dict1
print(result3)
{'a': 1, 'b': 20, 'c': 300, 'd': 4, 'e': 5}
{'a': 1, 'b': 20, 'c': 300, 'd': 4, 'e': 5}
{'c': 3, 'e': 5, 'b': 2, 'd': 4, 'a': 1}Perilaku ini konsisten apakah Anda menggunakan |, |=, unpacking, atau metode .update(). Urutan itu penting, menjadikannya sangat berguna untuk manajemen konfigurasi berlapis (mis., default sistem < konfigurasi lingkungan < override pengguna).
Salah satu jebakan paling berbahaya adalah kesalahpahaman tentang cara Python menangani assignment variabel.
dict_a = dict_b tidak membuat salinan. Itu membuat referensi (alias). Memodifikasi yang satu akan memodifikasi yang lain. Contoh berikut mengilustrasikan konsepnya:
# Reference assignment - creates an alias, not a copy
original = {"name": "Dataset_v1", "records": 1000}
alias = original

# Modifying through the alias changes the original
alias["records"] = 2000
print(original)
print(alias is original)
{'name': 'Dataset_v1', 'records': 2000}
TrueSeperti terlihat, hanya ada satu dictionary dan baik original maupun alias mereferensikannya. Karenanya, saat nilai untuk key records disetel menjadi 2000, perubahan hanya berlaku pada satu dictionary ini.
Shallow copy (.copy() atau dict()) membuat objek dictionary baru, tetapi objek mutable bertingkat tetap berbagi referensi.
# Shallow copy - creates a new dict but shares nested objects
original = {
    "name": "Experiment_A",
    "parameters": {"learning_rate": 0.01, "epochs": 100},
    "results": [0.85, 0.89, 0.92]
}

shallow = original.copy()

# Modifying top-level keys works as expected
shallow["name"] = "Experiment_B"
print(original["name"])
print(shallow["name"])

# But modifying nested objects affects both
shallow["parameters"]["learning_rate"] = 0.001
print(original["parameters"]["learning_rate"])

shallow["results"].append(0.94)
print(original["results"])
Experiment_A
Experiment_B
0.001
[0.85, 0.89, 0.92, 0.94]Seperti terlihat, key level-atas dimodifikasi sebagaimana mestinya, namun jika Anda memodifikasi objek mutable bertingkat, itu memengaruhi baik original maupun shallow copy.
Karena itu, shallow copy sering menyebabkan bug halus pada pipeline machine learning dan manajemen konfigurasi.
Oleh karena itu, Anda memerlukan deep copy menggunakan copy.deepcopy() dari pustaka standar untuk dictionary yang berisi objek mutable bertingkat. Ini menyalin semua objek bertingkat secara rekursif, menciptakan struktur yang sepenuhnya independen. Contoh berikut menunjukkan hal ini:
import copy

# Deep copy - creates completely independent nested structures
original = {
    "model": "RandomForest",
    "hyperparameters": {
        "n_estimators": 100,
        "max_depth": 10,
        "min_samples_split": 2
    },
    "feature_importance": [0.3, 0.25, 0.2, 0.15, 0.1]
}

deep = copy.deepcopy(original)

# Modify nested structures
deep["hyperparameters"]["n_estimators"] = 200
deep["feature_importance"].append(0.05)

# Original remains completely unchanged
print(original["hyperparameters"]["n_estimators"])
print(len(original["feature_importance"]))
print(len(deep["feature_importance"]))
100
5
6Dengan menerapkan teknik-teknik berikut, Anda akan memastikan integritas data dan keterpeliharaan di pipeline yang kompleks.
Gunakan | dan |= untuk penggabungan dictionary yang bersih.
Ingat bahwa yang terakhir dilihat akan menang saat terjadi benturan.
Bedakan antara assignment referensi, shallow copy, dan deep copy untuk menghindari bug halus.
Selalu utamakan copy.deepcopy() saat bekerja dengan struktur bertingkat yang mutable dalam kode produksi.
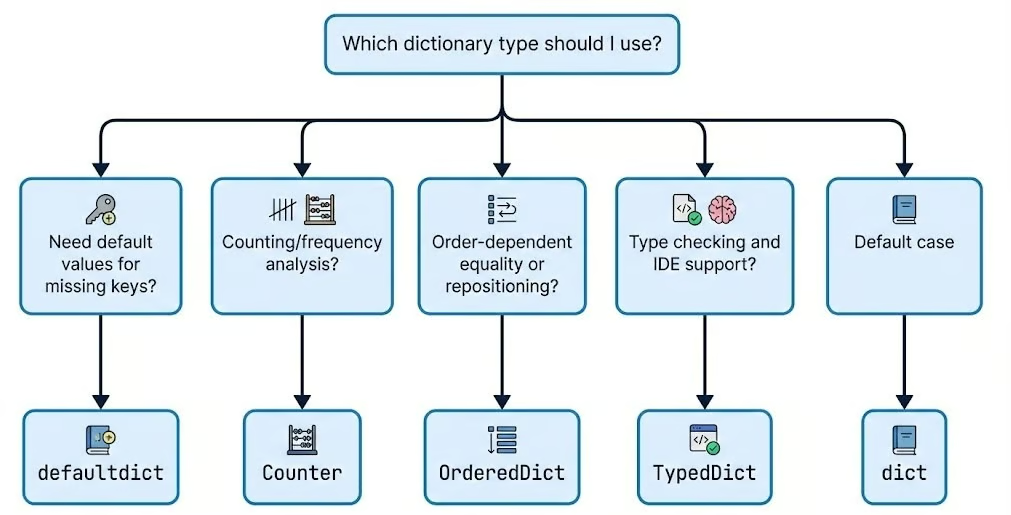
Walau dict standar serbaguna, pustaka standar Python menawarkan mapping terspesialisasi yang dioptimalkan untuk tugas tertentu seperti penghitungan, pengelompokan, atau penegakan struktur data. Memilih tipe terspesialisasi yang tepat dapat sangat menyederhanakan kode Anda dan mencegah satu kelas bug secara keseluruhan.
Modul collections menawarkan beberapa tipe dictionary terspesialisasi yang berguna.
defaultdict dari modul collections menghilangkan pengecekan keberadaan key yang berulang dengan otomatis menginisialisasi key yang hilang dengan nilai default. Ini sangat berguna untuk tugas akumulasi seperti menghitung, mengelompokkan, atau membangun struktur bertingkat:
from collections import defaultdict

# Standard dict requires manual key checking
word_count = {}
text = "the quick brown fox jumps over the lazy dog".split()

for word in text:
    if word not in word_count:
        word_count[word] = 0
    word_count[word] += 1

# defaultdict eliminates the check
word_count_auto = defaultdict(int)  # int() returns 0
for word in text:
    word_count_auto[word] += 1  # No checking needed!

print(dict(word_count_auto))

# Grouping with defaultdict(list)
transactions = [
    ("2024-01-15", "groceries", 45.50),
    ("2024-01-15", "gas", 60.00),
    ("2024-01-16", "groceries", 32.75),
    ("2024-01-16", "entertainment", 25.00),
    ("2024-01-17", "gas", 55.00)
]

by_date = defaultdict(list)
for date, category, amount in transactions:
    by_date[date].append((category, amount))

for date, items in by_date.items():
    print(f"{date}: {items}")

# Nested defaultdict for complex structures
nested = defaultdict(lambda: defaultdict(int))
events = [
    ("2024-01", "login", 150),
    ("2024-01", "purchase", 45),
    ("2024-02", "login", 200),
    ("2024-02", "purchase", 60)
]

for month, event_type, count in events:
    nested[month][event_type] += count

print(dict(nested))
{'the': 2, 'quick': 1, 'brown': 1, 'fox': 1, 'jumps': 1, 'over': 1, 'lazy': 1, 'dog': 1}
2024-01-15: [('groceries', 45.5), ('gas', 60.0)]
2024-01-16: [('groceries', 32.75), ('entertainment', 25.0)]
2024-01-17: [('gas', 55.0)]
{'2024-01': defaultdict(<class 'int'>, {'login': 150, 'purchase': 45}), '2024-02': defaultdict(<class 'int'>, {'login': 200, 'purchase': 60})}Kelas Counter adalah subclass dictionary terspesialisasi yang dirancang untuk menghitung objek hashable dan melakukan operasi multiset. Ini sangat kuat untuk analisis statistik dan distribusi frekuensi. Mari lihat contoh cara kerjanya:
from collections import Counter

# Count occurrences in a sequence
tags = ["python", "data", "python", "ml", "data", "python", "statistics", "ml"]
tag_counts = Counter(tags)
print(tag_counts)

# Most common elements
print(tag_counts.most_common(2))

# Counter arithmetic - multiset operations
skills_alice = Counter(["Python", "SQL", "Tableau", "Python"])
skills_bob = Counter(["Python", "R", "SQL"])

# Union (maximum of counts)
combined_skills = skills_alice | skills_bob
print(combined_skills)

# Intersection (minimum of counts)
shared_skills = skills_alice & skills_bob
print(shared_skills)

# Addition (sum of counts)
total_mentions = skills_alice + skills_bob
print(total_mentions)

# Practical example: Analyzing survey responses
responses = ["satisfied", "neutral", "satisfied", "satisfied",
             "dissatisfied", "neutral", "satisfied", "very_satisfied"]
sentiment_analysis = Counter(responses)

# Calculate percentage distribution
total = sum(sentiment_analysis.values())
for sentiment, count in sentiment_analysis.most_common():
    percentage = (count / total) * 100
    print(f"{sentiment}: {count} ({percentage:.1f}%)")
Counter({'python': 3, 'data': 2, 'ml': 2, 'statistics': 1})
[('python', 3), ('data', 2)]
Counter({'Python': 2, 'SQL': 1, 'Tableau': 1, 'R': 1})
Counter({'Python': 1, 'SQL': 1})
Counter({'Python': 3, 'SQL': 2, 'Tableau': 1, 'R': 1})
satisfied: 4 (50.0%)
neutral: 2 (25.0%)
dissatisfied: 1 (12.5%)
very_satisfied: 1 (12.5%)Sebelum Python 3.7, OrderedDict penting untuk mempertahankan urutan penyisipan. Meski kini dictionary standar mempertahankan urutan, OrderedDict masih memiliki kasus penggunaan tertentu, khususnya untuk pemeriksaan kesetaraan yang mempertimbangkan urutan dan untuk memindahkan item ke salah satu ujung:
from collections import OrderedDict

# OrderedDict equality considers order
dict1 = {"a": 1, "b": 2}
dict2 = {"b": 2, "a": 1}
print(dict1 == dict2)

ordered1 = OrderedDict([("a", 1), ("b", 2)])
ordered2 = OrderedDict([("b", 2), ("a", 1)])
print(ordered1 == ordered2)

# Move items to beginning or end
task_queue = OrderedDict([
    ("task1", "pending"),
    ("task2", "in_progress"),
    ("task3", "pending")
])

# Move task3 to the beginning (highest priority)
task_queue.move_to_end("task3", last=False)
print(list(task_queue.keys()))

# Move task2 to the end (lowest priority)
task_queue.move_to_end("task2")
print(list(task_queue.keys()))
True
False
['task3', 'task1', 'task2']
['task3', 'task1', 'task2']Grafik berikut mengilustrasikan kapan memilih tipe dictionary yang mana.
Seiring adopsi Python tumbuh di lingkungan produksi skala besar, keamanan tipe menjadi isu penting. Modul typing dan types memperkenalkan cara untuk menegakkan struktur pada dictionary Anda. Memahamiing Python dunder methods juga dapat membantu Anda membangun objek mirip dictionary kustom dengan perilaku khusus.
Modul typing Python menyediakan TypedDict untuk mendefinisikan struktur dictionary dengan key wajib tertentu dan anotasi tipe. Ini meningkatkan dokumentasi kode, mengaktifkan autocomplete di IDE, dan menangkap error tipe selama analisis statis. Mari lihat cara kerjanya:
from typing import TypedDict

# Define strict structure for user data
class UserProfile(TypedDict):
    user_id: int
    username: str
    email: str
    is_active: bool
    role: str

# Create properly typed dictionary
user: UserProfile = {
    "user_id": 12345,
    "username": "data_scientist",
    "email": "scientist@company.com",
    "is_active": True,
    "role": "analyst"
}

# IDE will autocomplete and type-check
def process_user(user: UserProfile) -> str:
    # IDE knows these keys exist and their types
    return f"User {user['username']} (ID: {user['user_id']}) - {user['role']}"

# Optional keys with total=False
class PartialConfig(TypedDict, total=False):
    host: str
    port: int
    database: str  # All keys are optional

config: PartialConfig = {"host": "localhost"} # Valid - partial configUntuk skenario ketika Anda perlu mengekspos dictionary tetapi mencegah modifikasi, MappingProxyType membuat view read-only yang immutable dari dictionary standar. Ini sangat baik untuk melindungi konstanta konfigurasi global dari perubahan yang tidak disengaja. Mari lihat praktiknya:
from types import MappingProxyType

# Create read-only view of configuration
_INTERNAL_CONFIG = {
    "API_VERSION": "v2",
    "MAX_RETRIES": 3,
    "TIMEOUT": 30,
    "ENDPOINTS": {
        "users": "/api/v2/users",
        "data": "/api/v2/data"
    }
}

# Expose as immutable proxy
CONFIG = MappingProxyType(_INTERNAL_CONFIG)

# Reading works normally
print(CONFIG["API_VERSION"])
print(CONFIG["TIMEOUT"])

# Modifications raise TypeError
try:
    CONFIG["TIMEOUT"] = 60
except TypeError as e:
    print(f"Cannot modify: {e}")

# Caution: nested modifications succeed
try:
    CONFIG["ENDPOINTS"]["users"] = "/new/endpoint"
except TypeError as e:
    print(f"Cannot modify nested: {e}")

# Practical use case: Class constants
class DataPipeline:
    _default_config = {
        "batch_size": 1000,
        "parallel_workers": 4,
        "retry_failed": True
    }

    # Expose as read-only to prevent accidental changes
    DEFAULT_CONFIG = MappingProxyType(_default_config)

    def __init__(self, custom_config=None):
        # Merge with custom config while keeping defaults safe
        self.config = {**self.DEFAULT_CONFIG, **(custom_config or {})}
v2
30
Cannot modify: 'mappingproxy' object does not support item assignmentJadi, seperti yang terlihat, MappingProxyType membuat dictionary itu sendiri hanya-baca (tidak bisa menambah, menghapus, atau mengikat ulang key), tetapi tidak membekukan nilai mutable yang disimpan di dalamnya. Untuk mencegah perubahan pada struktur bertingkat, Anda juga harus membuat objek bertingkat tersebut immutable atau membungkusnya dalam view hanya-baca masing-masing.
Untuk tanda tangan fungsi dan type hint, gunakan Dict dan Mapping dari modul typing untuk mendokumentasikan struktur dictionary yang diharapkan. Kita bisa melakukannya seperti di bawah ini:
from typing import Dict, List, Mapping, Any

# Dict for mutable dictionaries
def process_scores(scores: Dict[str, float]) -> Dict[str, str]:
    """Convert numeric scores to letter grades."""
    grades = {}
    for student, score in scores.items():
        if score >= 90:
            grades[student] = "A"
        elif score >= 80:
            grades[student] = "B"
        elif score >= 70:
            grades[student] = "C"
        else:
            grades[student] = "F"
    return grades

# Mapping for read-only or general mapping types
def display_config(config: Mapping[str, Any]) -> None:
    """Display configuration - accepts any mapping type."""
    for key, value in config.items():
        print(f"{key}: {value}")

# Works with dict, MappingProxyType, OrderedDict, etc.
display_config({"host": "localhost", "port": 5432})
display_config(CONFIG)  # MappingProxyType from earlier
host: localhost
port: 5432
API_VERSION: v2
MAX_RETRIES: 3
TIMEOUT: 30
ENDPOINTS: {'users': '/new/endpoint', 'data': '/api/v2/data'}Saat dataset Anda tumbuh dari ribuan menjadi jutaan rekaman, efisiensi kode menjadi penting. Karena itu, perlu memahami karakteristik kinerja dictionary. Jadi, mari lihat kompleksitas komputasi, implikasi memori, dan strategi optimisasi untuk operasi dictionary.
Operasi dictionary mencapai kecepatannya melalui implementasi hash table, memberikan kompleksitas waktu O(1) rata-rata untuk tiga operasi paling umum:
get)set)delete)Performa waktu konstan ini berarti operasi-operasi tersebut memakan waktu kira-kira pada orde yang sama secara rata-rata, apakah dictionary Anda berisi 10 item atau 10 juta. Mari lihat dengan contoh kode:
import time
import statistics


def benchmark_lookup(size, repeats=50_000):
    """
    Measure the median time for a single dictionary lookup in a dictionary of given size.

    Parameters:
        size (int): Number of elements in the dictionary to create
        repeats (int): How many times to repeat the lookup (for more stable median)

    Returns:
        float: Median lookup time in microseconds (μs)
    """
    # Create a large dictionary with string keys and integer values
    large_dict = {f"key_{i}": i for i in range(size)}

    # The key we will look up repeatedly (last element)
    target_key = f"key_{size - 1}"

    # Store individual measurement times (in nanoseconds)
    times = []

    # Perform many lookups to reduce measurement noise
    for _ in range(repeats):
        # Use high-resolution timer (nanoseconds)
        start = time.perf_counter_ns()
        _ = large_dict[target_key]          # The actual dictionary lookup
        end = time.perf_counter_ns()
        times.append(end - start)

    # Calculate median time to minimize impact of outliers
    median_ns = statistics.median(times)

    # Convert nanoseconds to microseconds
    return median_ns / 1000


# Sizes to test (from 100k to 10 million elements)
sizes = [100_000, 1_000_000, 10_000_000]

print("Dictionary lookup benchmark (median time over many repeats)\n")
print(f"{'Size':>12} | {'Median Lookup Time':>18} | Notes")
print("-" * 50)

for size in sizes:
    lookup_time_us = benchmark_lookup(size)
    print(f"{size:>12,} | {lookup_time_us:>15.2f} μs   | "
          f"{'→ still ~constant' if size == sizes[-1] else ''}")
Dictionary lookup benchmark (median time over many repeats)
Size | Median Lookup Time | Notes
--------------------------------------------------
100,000 | 0.14 μs |
1,000,000 | 0.14 μs |
10,000,000 | 0.14 μs | → still ~constantWaktu lookup median di atas dapat berbeda bagi Anda bergantung pada sumber daya komputasi. Poin kuncinya adalah apa pun nilainya, mereka hampir tetap sama dengan sedikit variabilitas sehingga perbedaannya dapat diabaikan, membuktikan properti O(1).
Namun, dalam skenario terburuk, kompleksitas dapat menurun menjadi O(n) ketika terjadi tabrakan hash berlebih. Tabrakan hash terjadi ketika key berbeda menghasilkan nilai hash yang sama, memaksa Python mencari melalui beberapa entri yang disimpan pada bucket hash yang sama. Mari lihat contohnya:
# Pathological case: forcing hash collisions
class BadHash:
    """Object with intentionally poor hash function."""
    def __init__(self, value):
        self.value = value

    def __hash__(self):
        return 1  # All instances hash to same value - worst case!

    def __eq__(self, other):
        return isinstance(other, BadHash) and self.value == other.value

# This will have O(n) performance due to collisions
bad_dict = {BadHash(i): i for i in range(1000)}

# Compare with well-distributed hashes
good_dict = {f"key_{i}": i for i in range(1000)}

# Benchmark the difference
start = time.perf_counter()
_ = bad_dict[BadHash(999)]
bad_time = time.perf_counter() - start

start = time.perf_counter()
_ = good_dict["key_999"]
good_time = time.perf_counter() - start

print(f"Bad hash lookup: {bad_time * 1_000_000:.2f} μs")
print(f"Good hash lookup: {good_time * 1_000_000:.2f} μs")
print(f"Performance degradation: {bad_time / good_time:.1f}x slower")
Bad hash lookup: 582.48 μs
Good hash lookup: 93.99 μs
Performance degradation: 6.2x slowerSekali lagi, hasil pasti dan degradasi kinerja akan bervariasi tergantung daya komputasi Anda. Tetapi kecenderungannya sama: lookup dengan hash buruk akan memakan waktu jauh lebih lama daripada yang mencapai kompleksitas waktu O(1).
Biaya tersembunyi lain adalah pengubahan ukuran. Saat dictionary tumbuh, Python secara otomatis mengubah ukuran hash table internal untuk mempertahankan kinerja. Operasi pengubahan ukuran ini memiliki biaya komputasi, karena memerlukan rehash semua key yang ada dan mendistribusikannya kembali ke array yang lebih besar.
Python menggunakan strategi faktor pertumbuhan, biasanya setidaknya menggandakan ukuran saat ambang tertentu tercapai. Memahami pola pengubahan ukuran ini membantu saat menginisialisasi dictionary besar. Jika Anda tahu perkiraan ukuran akhir, Anda dapat melakukan pra-alokasi ruang untuk menghindari beberapa operasi pengubahan ukuran.
Kecepatan sering datang dengan biaya memori. Dictionary memiliki overhead memori signifikan dibanding tuple atau list karena harus menyimpan struktur hash table (indeks, hash, key, dan nilai). Mari pahami dengan contoh kode:
import sys

# Compare memory footprint of different data structures
data_list = [("name", "Alice"), ("age", 30), ("city", "NYC")]
data_tuple = (("name", "Alice"), ("age", 30), ("city", "NYC"))
data_dict = {"name": "Alice", "age": 30, "city": "NYC"}

print(f"List of tuples: {sys.getsizeof(data_list)} bytes")
print(f"Tuple of tuples: {sys.getsizeof(data_tuple)} bytes")
print(f"Dictionary: {sys.getsizeof(data_dict)} bytes")
List of tuples: 88 bytes
Tuple of tuples: 64 bytes
Dictionary: 184 bytesPada contoh di atas, Anda dapat melihat dictionary menggunakan ~2x-3x lebih banyak memori untuk data yang sama. Untuk kelas yang membuat banyak instance, menggunakan __slots__ alih-alih __dict__ instance dapat sangat mengurangi konsumsi memori.
Secara default, Python menyimpan atribut instance dalam dictionary yang dapat diakses melalui __dict__, tetapi __slots__ menggunakan struktur berbasis array yang lebih ringkas. Mari lihat contohnya:
import sys

# Regular class - uses __dict__ for attributes
class RegularUser:
    def __init__(self, user_id, name, email):
        self.user_id = user_id
        self.name = name
        self.email = email

# Optimized class - uses __slots__
class OptimizedUser:
    __slots__ = ['user_id', 'name', 'email']

    def __init__(self, user_id, name, email):
        self.user_id = user_id
        self.name = name
        self.email = email

# Create instances
regular = RegularUser(12345, "Alice", "alice@example.com")
optimized = OptimizedUser(12345, "Alice", "alice@example.com")

# Compare memory usage
print(f"Regular instance: {sys.getsizeof(regular.__dict__)} bytes (__dict__)")
print(f"Optimized instance: {sys.getsizeof(optimized)} bytes (__slots__)")

# For massive instance counts, the savings multiply
regular_users = [RegularUser(i, f"User{i}", f"user{i}@example.com") for i in range(1000)]
optimized_users = [OptimizedUser(i, f"User{i}", f"user{i}@example.com") for i in range(1000)]

regular_total = sum(sys.getsizeof(u.__dict__) for u in regular_users)
optimized_total = sum(sys.getsizeof(u) for u in optimized_users)

print(f"\n1000 regular instances: {regular_total:,} bytes")
print(f"1000 optimized instances: {optimized_total:,} bytes")
print(f"Memory savings: {((regular_total - optimized_total) / regular_total * 100):.1f}%")
Regular instance: 296 bytes (__dict__)
Optimized instance: 56 bytes (__slots__)
1000 regular instances: 96,000 bytes
1000 optimized instances: 56,000 bytes
Memory savings: 41.7%Terakhir, meski dictionary sangat baik untuk akses acak, struktur ini tidak dioptimalkan untuk pemrosesan data kolumnar. Jika Anda menangani data tabular skala besar (mis., jutaan baris), bermigrasi ke pandas DataFrame adalah pilihan bijak, karena dioptimalkan untuk efisiensi memori dan kecepatan ter-vektorisasi.
import pandas as pd
import time
import sys

n = 10_000

# Dict
dict_data = {i: {"user_id": i, "score": i * 1.5, "category": f"cat_{i % 10}"} for i in range(n)}

# Optimized DF: use category dtype for strings, int32 for ids
df_data = pd.DataFrame({
    "user_id": pd.Series(range(n), dtype="int32"),
    "score": [i * 1.5 for i in range(n)],
    "category": pd.Series([f"cat_{i % 10}" for i in range(n)], dtype="category")
})

dict_memory = sys.getsizeof(dict_data)
df_memory = df_data.memory_usage(deep=True).sum()

print(f"Dictionary: {dict_memory:,} bytes")
print(f"Optimized DataFrame: {df_memory:,} bytes")

# Bulk operation: mean score per category
start = time.perf_counter()
df_mean = df_data.groupby("category")["score"].mean()
df_time = (time.perf_counter() - start) * 1_000_000

# Equivalent in dict (manual loop)
start = time.perf_counter()
from collections import defaultdict
means = defaultdict(lambda: [0, 0])
for row in dict_data.values():
    cat = row["category"]
    means[cat][0] += row["score"]
    means[cat][1] += 1
dict_mean = {k: s/c for k, (s, c) in means.items()}
dict_time = (time.perf_counter() - start) * 1_000_000

print(f"\nDF groupby mean: {df_time:.2f} μs")
print(f"Dict manual mean: {dict_time:.2f} μs")
Dictionary: 294,992 bytes
Optimized DataFrame: 130,972 bytes
DF groupby mean: 1630.24 μs
Dict manual mean: 3931.47 μsAnda dapat dengan jelas melihat bahwa DataFrame mengungguli dictionary pada contoh kita. Untuk alur kerja data science yang membutuhkan pencarian cepat sekaligus operasi analitis, pertimbangkan pendekatan hibrida seperti menggunakan dictionary untuk pengindeksan dan akses cepat, lalu konversi ke DataFrame untuk analisis massal.
Kunci optimisasi adalah mencocokkan struktur data dengan pola akses Anda. Jika Anda sering melakukan pencarian berbasis key, dictionary adalah yang optimal. Untuk operasi kolumnar, pemfilteran, dan agregasi pada dataset besar, DataFrame memberikan kinerja yang baik.
Dictionary lebih dari sekadar wadah penyimpanan sederhana. Struktur ini adalah perekat yang menyatukan aplikasi data science yang kompleks. Jika Anda membangun tabel lookup cepat untuk skrip atau merancang pipeline data ber-throughput tinggi, maka dictionary kemungkinan merupakan alat paling berharga Anda.
Namun, bergantung pada perilaku default tanpa penanganan error yang tangguh adalah resep kegagalan runtime. Pola penanganan error yang kuat, seperti menggunakan pendekatan EAFP versus LBYL dan validasi proaktif, sangat mungkin mencegah kegagalan runtime saat memproses data eksternal.
Koleksi terspesialisasi seperti defaultdict, Counter, dan TypedDict membuat kode Anda naik kelas dari fungsional menjadi siap produksi. Selalu perhatikan kompleksitas waktu dan manajemen memori untuk memastikan kode Anda berjalan efisien. Juga, ingat bahwa optimisasi adalah proses iteratif.
Untuk terus membangun keterampilan Python Anda, saya sarankan mengikuti Intermediate Python untuk materi lebih lanjut tentang struktur data, atau jalur karier Python Developer untuk lintasan belajar yang komprehensif.
Kursus Python
Kursus
Kursus
Program
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



