Panduan Notasi Big O dan Kompleksitas Waktu: Intuisi dan Matematika
Kompleksitas waktu mengukur bagaimana waktu jalan suatu algoritme meningkat terhadap ukuran input, sering dinyatakan dengan notasi Big-O, yang memberikan batas atas pada skenario terburuk.
Analisis kompleksitas waktu memberikan cara untuk menganalisis dan memprediksi efisiensi algoritme dengan cara yang independen dari bahasa pemrograman yang kita gunakan dan perangkat keras tempat algoritme dijalankan.
Tujuan analisis kompleksitas waktu bukanlah untuk memprediksi waktu jalan persis suatu algoritme, melainkan agar dapat menjawab pertanyaan-pertanyaan ini:
Diberikan dua algoritme yang menyelesaikan masalah yang sama, mana yang diperkirakan berjalan lebih cepat jika jumlah data yang sama diberikan ke keduanya?
Jika kita menggandakan data yang diberikan ke algoritme, bagaimana waktu eksekusi akan terpengaruh? Apakah skalanya linier dan ikut menjadi dua kali lipat? Apakah tetap sama? Atau sesuatu yang lain sama sekali?
Di akhir artikel ini, Anda akan tahu cara menganalisis kompleksitas waktu suatu algoritme dan menjawab pertanyaan-pertanyaan tersebut.
Apakah Kompleksitas Waktu Masih Penting pada 2024?
Komputer semakin cepat sehingga mungkin muncul pertanyaan apakah kita masih perlu memikirkan kompleksitas waktu. Bukankah saat ini superkomputer bisa menangani masalah apa pun terlepas dari algoritme yang kita gunakan untuk menyelesaikannya?
Tidak juga. Ledakan AI banyak didorong oleh kemajuan besar dalam kinerja perangkat keras dalam beberapa tahun terakhir. Namun, bahkan pada perangkat keras paling canggih, masalah sederhana dapat menyebabkan kinerja yang buruk jika algoritme yang lambat digunakan.
Sebagai contoh, bayangkan menggunakan algoritme naif untuk mengurutkan tabel basis data dengan sepuluh juta entri. Bahkan pada komputer modern, operasi sederhana ini akan memakan waktu beberapa hari untuk diselesaikan, membuat basis data tidak dapat digunakan untuk aplikasi praktis apa pun. Sebaliknya, dengan menggunakan algoritme yang efisien, kita dapat mengharapkan waktunya kurang dari sepersepuluh detik.
Operasi Dasar dan Instruksi Dasar
Kita menganalisis algoritme menggunakan model Random Access Machine (RAM atau RA-machine). Model ini mengasumsikan operasi berikut memakan tepat satu langkah waktu:
Operasi aritmetika
Operasi logika (<, >, ==, dll.)
Pernyataan seperti ifatau return
Mengakses lokasi memori, seperti menulis atau membaca nilai variabel
Operasi-operasi ini disebut operasi dasar. Baris kode yang mengeksekusi jumlah operasi dasar yang konstan disebut instruksi dasar.
Karena jumlah operasi dalam instruksi dasar adalah konstan, jumlah tersebut tidak bergantung pada banyaknya data. Karena kita peduli pada bagaimana waktu eksekusi bertambah seiring bertambahnya data, kita dapat fokus pada menghitung jumlah instruksi dasar yang dilakukan algoritme.
Pemanggilan fungsi dan perulangan seperti for dan while dievaluasi dengan menjumlahkan jumlah instruksi dasar di dalamnya. Pertimbangkan kode berikut yang menjumlahkan elemen-elemen dari sebuah daftar.
defsum_list(lst):
total =0# 1 instructionfor value in lst:
total += value # executed len(lst) timesreturn total # 1 instructionDidukung oleh
Kita menambahkan komentar pada setiap baris untuk membantu memvisualisasikan jumlah instruksi dasar. Jika N adalah panjang lst, maka total jumlah instruksi dasar adalah 1 + N + 1 = N + 2.
Notasi Big-O
Bayangkan kita memiliki dua algoritme pengurutan. Kita menghitung jumlah instruksi dasar untuk masing-masing dan memperoleh ekspresi berikut:
Algoritme pertama
Algoritme kedua
4N2 + 2N + 7
3N2 + 5N + 13
Sekilas, tidak jelas mana yang skalanya lebih baik. Notasi Big-O memberi cara untuk menyederhanakan ekspresi-ekspresi ini lebih lanjut dengan menerapkan penyederhanaan berikut:
Hilangkan suku dengan pangkat lebih rendah
Hapus konstanta pengali
Jika kita menerapkan proses ini pada kedua ekspresi, kita memperoleh N2 pada kedua kasus:
Ekspresi yang kita peroleh setelah menyederhanakan adalah kompleksitas waktu algoritme, yang kita tulis dengan O(). Dalam kasus ini, kita dapat menulis bahwa 4N2 + 2N + 7 = O(N2) dan 3N2 + 5N + 13 = O(N2). Ini berarti kedua algoritme memiliki kompleksitas waktu yang sama, yaitu sebanding dengan kuadrat jumlah elemen daftar.
Di atas, kita menghitung bahwa algoritme sum_list melakukan N + 2 operasi, di mana N adalah panjang daftar. Menerapkan penyederhanaan yang sama, kita memperoleh N, sehingga kompleksitas waktu sum_list adalah O(N).
Ini berarti waktu eksekusi sebanding dengan ukuran daftar. Ini sesuai harapan karena saat menghitung jumlah, menggandakan jumlah elemen dalam daftar seharusnya memerlukan jumlah kerja dua kali lipat—tidak kurang, tidak lebih.
Notasi Big-O: penjelasan intuitif
Kita dapat mengabaikan suku-suku yang lebih rendah karena, saat N membesar, dampaknya terhadap jumlah total menjadi tidak signifikan dibandingkan suku tertinggi. Plot berikut menunjukkan kontribusi masing-masing dari tiga suku 4N2, 2N, dan 7 terhadap jumlah total.
Suku kuadratik 4N2 sangat cepat menyumbang hampir 100% dari total jumlah operasi bahkan untuk nilai N yang kecil. Karena itu, saat berurusan dengan jumlah data besar, waktu yang terkait dengan suku berorde lebih rendah akan dapat diabaikan dibandingkan suku berorde lebih tinggi.
Kita menghapus konstanta pengali karena nilainya independen dari banyaknya data.
Notasi Big-O: definisi matematis
Langkah-langkah di atas sudah cukup untuk sebagian besar tujuan praktis guna menurunkan kompleksitas waktu suatu algoritme secara akurat. Kita dapat menghitung jumlah instruksi dasar yang dilakukan algoritme dan memperoleh suatu ekspresi f(N). Setelah menerapkan dua langkah penyederhanaan, kita memperoleh ekspresi sederhana g(N). Lalu, kita dapat menulis bahwa f(N) = O(g(N)). Kita membacanya sebagai “f adalah big O dari g.”
Namun, ini bukan definisi matematis formal, dan dalam beberapa kasus, ini tidak cukup.
Definisi matematisnya adalah fungsi positif f(N) = O(g(N)) jika kita dapat menemukan konstanta C sedemikian rupa sehingga untuk nilai N yang besar, berlaku:
f(N) ≤ C × g(N)
Kita dapat menggunakan definisi tersebut untuk menunjukkan bahwa f(N) = 4N2 + 2N + 7 = O(N2). Dalam hal ini, kita dapat memilih C = 5 dan melihat bahwa untuk setiap N > 4, f(N) ≤ 5 × N2:
Dalam praktik, kita akan menggunakan aturan penyederhanaan di atas.
Jenis-Jenis Kompleksitas Waktu
Sekarang setelah kita memahami dasar-dasar notasi Big-O, mari jelajahi kompleksitas waktu yang umum dan implikasinya, dimulai dari yang paling efisien: waktu konstan.
Waktu konstan: O(1)
Sesuai namanya, algoritme waktu konstan memiliki kompleksitas waktu konstan, artinya kinerjanya tidak bergantung pada jumlah data. Algoritme ini biasanya melibatkan perhitungan dengan jumlah masukan tetap, seperti menghitung jarak antara dua titik.
Jarak antara dua titik dihitung dengan mengambil akar kuadrat dari perbedaan koordinat x dan y dari kedua titik.
Fungsi dist di bawah ini menghitung jarak antara dua titik. Fungsi ini terdiri dari tiga instruksi dasar, yang merupakan konstanta. Dalam kasus ini, kita menulis bahwa kompleksitas waktunya adalah O(1).
defdist(p, q):
dx =(p[0]- q[0])**2# 1 instruction
dy =(p[1]- q[1])**2# 1 instructionreturn(dx + dy)**0.5# 1 instructionDidukung oleh
Menariknya, sebuah fungsi bisa saja memiliki kompleksitas waktu konstan, bahkan saat memproses dataset besar. Misalnya, menghitung panjang daftar menggunakan fungsi len. Operasi ini O(1) karena implementasinya secara internal menyimpan ukuran daftar, sehingga tidak perlu menghitung elemen setiap kali panjangnya diminta.
Waktu linier: O(N)
Sebelumnya kita membahas sum_list sebagai contoh fungsi waktu linier. Secara umum, algoritme waktu linier mengeksekusi tugas yang perlu memeriksa setiap titik data satu per satu. Menghitung nilai minimum, maksimum, atau rata-rata adalah operasi tipikal dalam kategori ini.
Mari berlatih dengan menganalisis fungsi berikut untuk menghitung nilai minimum dari sebuah daftar:
Jika daftar memiliki N elemen, kompleksitasnya adalah 1 + (N - 1) + 1 = N + 1 = O(N).
Waktu eksekusi algoritme waktu linier berbanding lurus dengan jumlah data. Jadi, jika jumlah data digandakan, waktu yang dibutuhkan algoritme untuk memproses data juga akan menjadi dua kali lipat.
Waktu logaritmik: O(log(N))
Permainan tebak angka melibatkan upaya menebak angka tersembunyi antara 1 dan N, dengan tujuan mengidentifikasi angka ini dengan jumlah tebakan sesedikit mungkin. Setelah setiap tebakan, kita menerima umpan balik apakah angka tersembunyi lebih tinggi, lebih rendah, atau sama dengan tebakan. Jika tebakan benar, kita menang; jika tidak, kita lanjut menebak.
Salah satu strategi efektif untuk permainan ini adalah selalu menebak titik tengah. Misalkan N = 15. Dalam hal ini, tebakan pertama kita adalah 8. Jika angka rahasia lebih kecil dari 8, kita tahu angka tersebut harus berada antara 1 dan 7. Jika lebih besar, maka berada antara 9 dan 15. Kita terus menebak titik tengah dari rentang yang tersisa hingga menemukan jawaban yang benar. Diagram di bawah menggambarkan jalur potensial yang dapat diikuti strategi ini.
Mari kita lihat kompleksitas waktu pendekatan ini. Tidak seperti contoh sebelumnya, jumlah langkah yang diambil algoritme ini tidak hanya bergantung pada ukuran input N, karena ada kemungkinan menebak benar pada percobaan pertama.
Saat menganalisis algoritme seperti ini, kita berfokus pada skenario terburuk. Misalnya, dengan N = 15, dalam kasus terburuk, kita perlu membuat 4 tebakan. Setiap tebakan, yang merupakan titik tengah, mengeliminasi setengah dari kemungkinan yang tersisa. Dalam skenario terburuk, kita terus menebak hingga hanya tersisa satu kemungkinan. Maka, pertanyaan yang perlu kita jawab adalah:
Berapa kali kita harus membagi N dengan 2 untuk mendapatkan 1?
Jawabannya adalah logaritma basis-2 dari N, ditulis log2(N). Algoritme yang digunakan untuk menemukan angka yang benar ini dikenal sebagai pencarian biner. Karena jumlah tebakan maksimum adalah log2(N), kita dapat mengekspresikan kompleksitasnya sebagai O(log2(N)) atau cukup O(log(N)) karena konstanta tidak signifikan dalam notasi kompleksitas waktu.
Karena laju pertumbuhannya sangat lambat, kompleksitas waktu logaritmik sangat diinginkan dalam praktik, berperilaku hampir seperti waktu konstan. Bahkan untuk nilai N yang besar, jumlah operasi tetap sangat rendah. Misalnya, meskipun N satu miliar, jumlah operasi yang diperlukan hanya sekitar 30.
Pencarian biner adalah algoritme fundamental dalam ilmu komputer dengan banyak aplikasi. Misalnya, dalam pemrosesan bahasa alami, pemeriksa ejaan dan sistem koreksi otomatis dapat memanfaatkan variasi pencarian biner untuk mengidentifikasi kandidat kata secara efisien.
Waktu kuadratik: O(N2)
Mengurutkan data adalah tugas mendasar yang sering perlu dilakukan komputer. Salah satu cara untuk mengurutkan daftar N angka adalah dengan berulang kali mengidentifikasi elemen minimum dari daftar.
defselection_sort(lst):
sorted_lst =[]# 1 instructionfor _ inrange(len(lst)):
minimum =min(lst)# executed len(lst) times
lst.remove(minimum)# executed len(lst) times
sorted_lst.append(minimum)# executed len(lst) timesreturn sorted_lst # 1 instructionDidukung oleh
Untuk menganalisis kompleksitas sebuah perulangan for, kita mengevaluasi kompleksitas instruksi di dalamnya dan kemudian mengalikan hasil tersebut dengan jumlah iterasi perulangan dieksekusi.
Menghitung minimum dari daftar dan menghapus sebuah elemen dari daftar keduanya adalah operasi O(N). Menambah (append) dilakukan dalam waktu konstan, O(1). Oleh karena itu, setiap iterasi perulangan for memiliki kompleksitas O(N + N + 1) = O(2N + 1), yang menyederhana menjadi O(N). Karena ada N iterasi, kompleksitasnya adalah N × O(N) = O(N2). Sisanya dari fungsi selection_sort() terdiri dari tiga instruksi sederhana, sehingga kompleksitas keseluruhan adalah O(N2 + 3) = O(N2).
Analisis kita terhadap perulangan for melibatkan penyederhanaan berlebih. Pada setiap iterasi, kita menghapus satu elemen dari daftar, artinya tidak semua iterasi mengeksekusi jumlah instruksi yang sama. Iterasi pertama mengeksekusi N instruksi, kedua mengeksekusi N - 1, ketiga N - 2, dan seterusnya hingga iterasi terakhir, yang hanya mengeksekusi 1 instruksi.
Ini menyiratkan bahwa kompleksitas sebenarnya dari perulangan for adalah:
N + (N - 1) + (N - 2) + … + 1
Jumlah ini dapat ditunjukkan sama dengan (N2 + N) / 2. Namun,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
Meskipun kita menghitung berlebih, kompleksitas keseluruhannya tetap kuadratik. Fungsi selection_sort() mencontohkan algoritme pengurutan yang lebih lambat karena kompleksitasnya yang kuadratik, O(N2).
Fungsi dengan kompleksitas kuadratik skala buruk, cocok untuk daftar kecil tetapi tidak praktis untuk mengurutkan jutaan titik data, karena dapat memakan waktu berhari-hari untuk menyelesaikannya. Menggandakan jumlah data membuat waktu eksekusi menjadi empat kali lipat.
Waktu loglinier: O(Nlog(N))
Ada algoritme untuk mengurutkan daftar dengan kompleksitas waktu O(N log(N)). Salah satunya disebut merge sort. Kita tidak akan membahas detail implementasinya, tetapi jika Anda ingin mempelajarinya lebih lanjut, lihat pengantar singkat tentang merge sort dari kursus Data Structures and Algorithms in Python ini.
Seperti disebutkan sebelumnya, kompleksitas logaritmik dalam praktik berperilaku mirip dengan kompleksitas konstan. Oleh karena itu, waktu eksekusi algoritme O(N log(N)) dapat sebanding dengan algoritme waktu linier dalam aplikasi dunia nyata.
Plot berikut menunjukkan bahwa N log(N) dan N tumbuh dengan laju yang serupa sementara N2 tumbuh sangat cepat, sehingga cepat menjadi sangat lambat.
Waktu kubik: O(N3)
Salah satu algoritme berkekompleksitas kubik yang banyak digunakan dalam AI adalah perkalian matriks, yang berperan penting dalam berfungsinya model bahasa besar seperti GPT. Algoritme ini krusial untuk perhitungan yang dilakukan selama fase pelatihan dan inferensi.
Untuk mengalikan dua matriks N x N, A dan B, kita perlu mengalikan setiap baris dari matriks pertama A dengan setiap kolom dari matriks kedua B. Secara spesifik, nilai hasil pada entri (i, j) ditentukan dengan mengalikan elemen pada baris i dari A dengan elemen yang sesuai pada kolom j dari B.
Berikut implementasi Python untuk perkalian matriks:
defmatrix_mul(A, B):
n =len(A)# 1 instruction
res =[[0for _ inrange(n)]for _ inrange(n)]# N^2 instructionsfor i inrange(n):for j inrange(n):for k inrange(n):
res[i][j]+= A[i][k]* B[k][j]# executed N×N×N = N^3 timesreturn res # 1 instructionDidukung oleh
Secara total, matrix_mul() mengeksekusi N3 + N2 + 2 instruksi sehingga kompleksitas waktunya adalah O(N3).
Sebagai alternatif, kita bisa menganalisis kompleksitas dengan menalar perhitungannya. Hasil perkalian matriks memiliki N2 entri. Setiap entri membutuhkan waktu O(N) untuk dihitung, sehingga kompleksitas keseluruhan adalah N2 × O(N) = O(N3).
Algoritme waktu kubik cukup lambat. Menggandakan jumlah data menghasilkan faktor delapan pada waktu eksekusi, membuat algoritme seperti ini berskala sangat buruk. Bahkan untuk nilai N yang relatif kecil, jumlah instruksi meningkat sangat cepat.
Perkalian matriks adalah contoh tantangan komputasional di mana kemajuan perangkat keras memberikan dampak signifikan. Meskipun ada algoritme yang sedikit lebih efisien untuk perkalian matriks, utamanya adalah kemajuan dalam desain chip GPU—yang disesuaikan khusus untuk melakukan perkalian matriks—yang secara signifikan mempermudah pelatihan model besar seperti GPT dalam kerangka waktu yang wajar.
Baru-baru ini, para peneliti mengusulkan untuk menghilangkan perkalian matriks dari model pembelajaran besar—Anda dapat membaca lebih lanjut dalam artikel tentang MatMul-Free LLMs: Konsep Kunci Dijelaskan.
Kompleksitas waktu eksponensial: O(2N) dan O(N!)
Algoritme waktu eksponensial biasanya muncul ketika sebuah masalah diselesaikan dengan menjelajahi semua kemungkinan solusi. Pertimbangkan perencanaan rute untuk truk pengiriman yang harus mengunjungi N lokasi. Salah satu pendekatan adalah mengevaluasi setiap urutan pengiriman yang mungkin. Paket Python itertoolsmenawarkan cara sederhana untuk menelusuri semua permutasi sebuah daftar.
import itertools
for order in itertools.permutations([1,2,3]):print(order)Didukung oleh
Jumlah permutasi dari daftar dengan panjang N dilambangkan dengan N!, dibaca "N faktorial." Fungsi faktorial menunjukkan pertumbuhan eksponensial. Misalnya, ketika N = 13, jumlah permutasi melebihi 1 miliar.
Misalkan lokasi pengiriman diberikan sebagai daftar titik 2D. Dalam hal ini, kita dapat menentukan urutan pengiriman yang meminimalkan jarak total dengan menelusuri semua urutan yang mungkin sambil melacak yang terbaik.
defoptimize_route(locations):
minimum_distance =float("inf")# 1 instruction
best_order =None# 1 instructionfor order in itertools.permutations(locations):# N! iterations
distance =0# 1 instruction, N! timesfor i inrange(1,len(order)):
distance += dist(order[i -1], order[i])# N-1 instructions, N! timesif distance < minimum_distance:
distance = minimum_distance # 1 instruction, N! times
best_order = order # 1 instruction, N! timesreturn best_order # 1 instructionDidukung oleh
Perulangan for pertama dieksekusi N! kali. Oleh karena itu, jumlah operasi dalam optimize_route() adalah N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3.
Kita belajar bahwa saat menghitung kompleksitas waktu, kita mengabaikan suku berpangkat lebih rendah. Namun, dalam skenario ini, kita menemui suku N! yang bukan merupakan pangkat dari N. Kita dapat memperhalus strategi penyederhanaan dengan memilih untuk mengabaikan suku-suku dengan laju pertumbuhan lebih lambat. Tabel di bawah mencantumkan suku yang umum ditemukan dalam kompleksitas waktu suatu algoritme, diurutkan dari laju pertumbuhan terendah ke tertinggi.
1
log(N)
N
N2
N3
Nk
2N
N!
Dengan demikian, kita dapat mengekspresikan kompleksitas waktu optimize_route() sebagai N! x N + 2N! + 3 = O(N! x N).
Algoritme dengan kompleksitas waktu eksponensial biasanya hanya efisien untuk menyelesaikan instance yang sangat kecil. Bahkan dengan hanya 13 lokasi, jumlah permutasi melebihi 1 miliar, membuat algoritme ini tidak praktis untuk skenario dunia nyata.
Kompleksitas Waktu: Kasus Terburuk dan Kasus Terbaik
Pada permainan tebak angka, kita berfokus pada kompleksitas kasus terburuk. Dengan berfokus pada kasus terburuk, kita menjamin laju pertumbuhan waktu eksekusi algoritme.
Dalam kasus terbaik, kita menebak pada percobaan pertama, jadi analisis kompleksitas kasus terbaik menghasilkan kompleksitas O(1). Ini akurat—dalam kasus terbaik, kita membutuhkan satu operasi konstan. Namun, ini tidak terlalu berguna karena sangat tidak mungkin terjadi.
Secara umum, saat kita menganalisis kompleksitas suatu algoritme, kita selalu fokus pada kasus terburuk karena:
Jaminan kinerja: Dengan berfokus pada kompleksitas kasus terburuk, kita dapat memastikan bahwa algoritme kita tidak akan berkinerja lebih buruk dari ambang tertentu. Ini penting untuk aplikasi yang memerlukan kinerja andal, seperti sistem waktu nyata, di mana keterlambatan dapat menyebabkan masalah signifikan.
Keandalan dan keselamatan: Analisis kasus terburuk membantu merancang algoritme yang tangguh yang dapat menangani skenario paling menuntut. Ini memastikan algoritme tetap berfungsi dalam batas yang dapat diterima bahkan dalam situasi terburuk.
Batas atas: Mengetahui kompleksitas kasus terburuk memberi kita batas atas kinerja. Ini berguna untuk memahami sumber daya maksimum (waktu, memori) yang mungkin diperlukan algoritme.
Kompleksitas Waktu: Implikasi Praktis
Kompleksitas waktu mungkin tampak sangat teoretis, tetapi bisa sangat berguna dalam praktik.
Sebagai contoh, jika sebuah fungsi secara konsisten menangani dataset kecil, algoritme O(N2) yang mudah dipahami mungkin lebih tepat daripada algoritme O(N) yang kompleks dan sulit dirawat. Namun, ini harus menjadi keputusan yang disengaja agar tidak lengah saat aplikasi tidak dapat menangani peningkatan lalu lintas pengguna.
Analisis kompleksitas waktu mengungkapkan bahwa optimasi kode kecil memiliki efek yang dapat diabaikan pada waktu eksekusi algoritme. Peningkatan signifikan dicapai dengan secara fundamental mengurangi jumlah operasi dasar yang diperlukan untuk menghitung hasil. Secara umum, menjaga kode tetap bersih dan mudah dipahami lebih disukai daripada mengoptimalkannya hingga menjadi sulit dimengerti.
Bagian kode yang lebih lambat akan mendominasi yang lain. Biasanya tidak ada gunanya mengoptimalkan bagian yang lebih cepat sebelum mengoptimalkan yang lebih lambat. Misalnya, bayangkan kita memiliki fungsi yang melakukan dua tugas:
defprocess_data(data):
clean_data(data)
analyze_data(data)Didukung oleh
Jika fungsi clean_data() memiliki kompleksitas O(N2) dan analyze_data() memiliki kompleksitas O(N3), maka mengurangi kompleksitas clean_data() tidak akan meningkatkan kompleksitas keseluruhan process_data(). Lebih baik fokus pada peningkatan fungsi analyze_data().
Selain itu, kompleksitas waktu dapat menginformasikan keputusan perangkat keras. Misalnya, algoritme O(N3), meskipun skalabilitasnya buruk, mungkin masih cukup cepat untuk tugas dengan data terbatas jika dijalankan pada perangkat keras unggul atau bahasa pemrograman yang lebih cepat. Sebaliknya, jika sebuah algoritme memiliki kompleksitas waktu eksponensial O(2N), peningkatan perangkat keras tidak akan cukup, yang menandakan perlunya algoritme yang lebih efisien.
Kesimpulan
Meskipun komputer makin cepat, kita berhadapan dengan lebih banyak data dari sebelumnya. Ibaratnya begini: setiap kali kita menggunakan Internet, ponsel pintar, atau perangkat rumah pintar, kita menciptakan banyak sekali informasi. Seiring gunungan data ini bertambah, memilah-milahnya dan menemukan yang penting menjadi semakin sulit. Itulah sebabnya sangat penting untuk terus membuat alat kita—terutama algoritme—semakin baik dalam menangani dan memahami semua informasi ini.
Analisis kompleksitas waktu menawarkan kerangka kerja yang lugas untuk menalar tentang waktu eksekusi algoritme. Tujuan utamanya adalah memberikan wawasan tentang laju pertumbuhan kompleksitas waktu alih-alih memprediksi waktu eksekusi yang tepat. Terlepas dari banyak penyederhanaan dan asumsi model, pendekatan ini terbukti sangat berguna dalam praktik, secara efektif menangkap esensi perilaku waktu eksekusi algoritme.
Bagaimana saya bisa mengetahui kompleksitas waktu dari fungsi bawaan Python? ⌄
Terkadang dokumentasi menyebutkan kompleksitasnya. Jika tidak, melihat kode sumber dan menganalisisnya adalah latihan yang baik. Sebagian besar bahasa mengikuti implementasi standar untuk struktur data umum seperti list dan dictionary, sehingga mencari kompleksitas struktur data tersebut akan menghasilkan jawaban yang benar. Kami merekomendasikan mengikuti kursus umum tentang struktur data dan algoritme untuk lebih memahami kompleksitas operasi umum.
Apakah kompleksitas berbentuk O(N^k) selalu lebih baik daripada O(2^N), terlepas dari nilai k?⌄
Secara teoretis, ya. Untuk N yang cukup besar, algoritme waktu eksponensial pada akhirnya akan menjadi lebih lambat. Namun, algoritme eksponensial bisa berkinerja jauh lebih baik untuk nilai N kecil. Dalam beberapa kasus langka, kita hanya peduli pada dataset kecil, sehingga algoritme O(2N) mungkin lebih disukai.
Apakah ada fungsi kompleksitas lain selain yang kita pelajari di sini?⌄
Ya. Ada algoritme dengan fungsi kompleksitas yang sangat aneh, tetapi untuk hampir semua algoritme, kompleksitasnya hanya akan melibatkan fungsi-fungsi yang kami sebutkan dalam artikel ini.
Bagaimana saya bisa tahu apakah mungkin menemukan algoritme yang lebih baik?⌄
Ini pertanyaan yang sulit secara umum. Membuktikan bahwa tidak ada algoritme dengan kompleksitas waktu yang lebih baik melibatkan penalaran tentang masalahnya dan menunjukkan bahwa menyelesaikannya dengan lebih sedikit operasi adalah tidak mungkin. Dalam beberapa kasus, ini mudah. Misalnya, untuk mengetahui apakah sebuah daftar berisi nilai tertentu, tidak mungkin memiliki algoritme dengan kompleksitas lebih rendah dari O(N) karena, pada kasus terburuk, kita perlu melihat semua elemen untuk menemukan jawabannya.
Bagaimana kita menganalisis kompleksitas waktu jika algoritmenya melibatkan keacakan?⌄
Bahkan dengan adanya elemen acak, sering kali tetap mungkin untuk menalar tentang kasus terburuk dari hasil acak dan menurunkan kompleksitasnya. Atau, untuk beberapa algoritme teracak, kita menganalisis kompleksitas rata-rata dengan mempelajari jumlah operasi yang diharapkan.
Insinyur full-stack & pendiri di CheapGPT. Mengajar selalu menjadi passion saya. Sejak masa awal sebagai mahasiswa, saya aktif mencari peluang untuk membimbing dan membantu mahasiswa lain. Passion ini mendorong saya menempuh studi PhD, di mana saya juga menjadi asisten pengajar untuk mendukung kegiatan akademik saya. Selama tahun-tahun itu, saya menemukan kepuasan besar dalam suasana kelas tradisional, membangun koneksi dan memfasilitasi proses belajar. Namun, dengan hadirnya platform pembelajaran daring, saya melihat potensi transformatif pendidikan digital. Bahkan, saya terlibat aktif dalam pengembangan salah satu platform tersebut di universitas kami. Saya sangat berkomitmen untuk mengintegrasikan prinsip-prinsip pengajaran tradisional dengan metodologi digital yang inovatif. Tujuan saya adalah menciptakan kursus yang tidak hanya menarik dan informatif, tetapi juga mudah diakses oleh para pembelajar di era digital ini.
Temukan alasan mengapa Anda sebaiknya (tidak) menggunakan spaghetti plot untuk menyampaikan ketidakpastian jalur prediksi badai serta dampaknya terhadap interpretasi.
Kuasai pertanyaan wawancara basis data, dari konsep SQL dasar hingga skenario desain sistem tingkat lanjut. Panduan mendalam ini mencakup semua yang Anda perlukan untuk sukses di wawancara DBMS dan meraih peran berikutnya.




Analisis kompleksitas waktu memberikan cara untuk menganalisis dan memprediksi efisiensi algoritme dengan cara yang independen dari bahasa pemrograman yang kita gunakan dan perangkat keras tempat algoritme dijalankan.
Tujuan analisis kompleksitas waktu bukanlah untuk memprediksi waktu jalan persis suatu algoritme, melainkan agar dapat menjawab pertanyaan-pertanyaan ini:
Di akhir artikel ini, Anda akan tahu cara menganalisis kompleksitas waktu suatu algoritme dan menjawab pertanyaan-pertanyaan tersebut.
Apakah Kompleksitas Waktu Masih Penting pada 2024?
Komputer semakin cepat sehingga mungkin muncul pertanyaan apakah kita masih perlu memikirkan kompleksitas waktu. Bukankah saat ini superkomputer bisa menangani masalah apa pun terlepas dari algoritme yang kita gunakan untuk menyelesaikannya?
Tidak juga. Ledakan AI banyak didorong oleh kemajuan besar dalam kinerja perangkat keras dalam beberapa tahun terakhir. Namun, bahkan pada perangkat keras paling canggih, masalah sederhana dapat menyebabkan kinerja yang buruk jika algoritme yang lambat digunakan.
Sebagai contoh, bayangkan menggunakan algoritme naif untuk mengurutkan tabel basis data dengan sepuluh juta entri. Bahkan pada komputer modern, operasi sederhana ini akan memakan waktu beberapa hari untuk diselesaikan, membuat basis data tidak dapat digunakan untuk aplikasi praktis apa pun. Sebaliknya, dengan menggunakan algoritme yang efisien, kita dapat mengharapkan waktunya kurang dari sepersepuluh detik.
Operasi Dasar dan Instruksi Dasar
Kita menganalisis algoritme menggunakan model Random Access Machine (RAM atau RA-machine). Model ini mengasumsikan operasi berikut memakan tepat satu langkah waktu:
ifataureturnOperasi-operasi ini disebut operasi dasar. Baris kode yang mengeksekusi jumlah operasi dasar yang konstan disebut instruksi dasar.
Karena jumlah operasi dalam instruksi dasar adalah konstan, jumlah tersebut tidak bergantung pada banyaknya data. Karena kita peduli pada bagaimana waktu eksekusi bertambah seiring bertambahnya data, kita dapat fokus pada menghitung jumlah instruksi dasar yang dilakukan algoritme.
Pemanggilan fungsi dan perulangan seperti
fordanwhiledievaluasi dengan menjumlahkan jumlah instruksi dasar di dalamnya. Pertimbangkan kode berikut yang menjumlahkan elemen-elemen dari sebuah daftar.Kita menambahkan komentar pada setiap baris untuk membantu memvisualisasikan jumlah instruksi dasar. Jika N adalah panjang
lst, maka total jumlah instruksi dasar adalah 1 + N + 1 = N + 2.Notasi Big-O
Bayangkan kita memiliki dua algoritme pengurutan. Kita menghitung jumlah instruksi dasar untuk masing-masing dan memperoleh ekspresi berikut:
Algoritme pertama
Algoritme kedua
4N2 + 2N + 7
3N2 + 5N + 13
Sekilas, tidak jelas mana yang skalanya lebih baik. Notasi Big-O memberi cara untuk menyederhanakan ekspresi-ekspresi ini lebih lanjut dengan menerapkan penyederhanaan berikut:
Jika kita menerapkan proses ini pada kedua ekspresi, kita memperoleh N2 pada kedua kasus:
Ekspresi yang kita peroleh setelah menyederhanakan adalah kompleksitas waktu algoritme, yang kita tulis dengan O(). Dalam kasus ini, kita dapat menulis bahwa 4N2 + 2N + 7 = O(N2) dan 3N2 + 5N + 13 = O(N2). Ini berarti kedua algoritme memiliki kompleksitas waktu yang sama, yaitu sebanding dengan kuadrat jumlah elemen daftar.
Di atas, kita menghitung bahwa algoritme
sum_listmelakukan N + 2 operasi, di mana N adalah panjang daftar. Menerapkan penyederhanaan yang sama, kita memperoleh N, sehingga kompleksitas waktusum_listadalah O(N).Ini berarti waktu eksekusi sebanding dengan ukuran daftar. Ini sesuai harapan karena saat menghitung jumlah, menggandakan jumlah elemen dalam daftar seharusnya memerlukan jumlah kerja dua kali lipat—tidak kurang, tidak lebih.
Notasi Big-O: penjelasan intuitif
Kita dapat mengabaikan suku-suku yang lebih rendah karena, saat N membesar, dampaknya terhadap jumlah total menjadi tidak signifikan dibandingkan suku tertinggi. Plot berikut menunjukkan kontribusi masing-masing dari tiga suku 4N2, 2N, dan 7 terhadap jumlah total.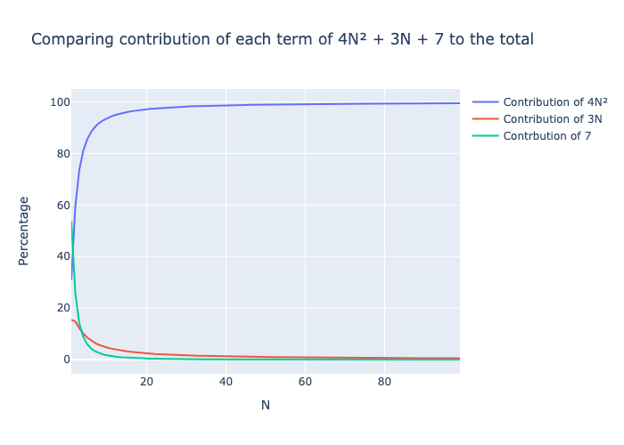
Suku kuadratik 4N2 sangat cepat menyumbang hampir 100% dari total jumlah operasi bahkan untuk nilai N yang kecil. Karena itu, saat berurusan dengan jumlah data besar, waktu yang terkait dengan suku berorde lebih rendah akan dapat diabaikan dibandingkan suku berorde lebih tinggi.
Kita menghapus konstanta pengali karena nilainya independen dari banyaknya data.
Notasi Big-O: definisi matematis
Langkah-langkah di atas sudah cukup untuk sebagian besar tujuan praktis guna menurunkan kompleksitas waktu suatu algoritme secara akurat. Kita dapat menghitung jumlah instruksi dasar yang dilakukan algoritme dan memperoleh suatu ekspresi f(N). Setelah menerapkan dua langkah penyederhanaan, kita memperoleh ekspresi sederhana g(N). Lalu, kita dapat menulis bahwa f(N) = O(g(N)). Kita membacanya sebagai “f adalah big O dari g.”
Namun, ini bukan definisi matematis formal, dan dalam beberapa kasus, ini tidak cukup.
Definisi matematisnya adalah fungsi positif f(N) = O(g(N)) jika kita dapat menemukan konstanta C sedemikian rupa sehingga untuk nilai N yang besar, berlaku:
f(N) ≤ C × g(N)
Kita dapat menggunakan definisi tersebut untuk menunjukkan bahwa f(N) = 4N2 + 2N + 7 = O(N2). Dalam hal ini, kita dapat memilih C = 5 dan melihat bahwa untuk setiap N > 4, f(N) ≤ 5 × N2:
Dalam praktik, kita akan menggunakan aturan penyederhanaan di atas.
Jenis-Jenis Kompleksitas Waktu
Sekarang setelah kita memahami dasar-dasar notasi Big-O, mari jelajahi kompleksitas waktu yang umum dan implikasinya, dimulai dari yang paling efisien: waktu konstan.
Waktu konstan: O(1)
Sesuai namanya, algoritme waktu konstan memiliki kompleksitas waktu konstan, artinya kinerjanya tidak bergantung pada jumlah data. Algoritme ini biasanya melibatkan perhitungan dengan jumlah masukan tetap, seperti menghitung jarak antara dua titik.
Jarak antara dua titik dihitung dengan mengambil akar kuadrat dari perbedaan koordinat x dan y dari kedua titik.
Fungsi
distdi bawah ini menghitung jarak antara dua titik. Fungsi ini terdiri dari tiga instruksi dasar, yang merupakan konstanta. Dalam kasus ini, kita menulis bahwa kompleksitas waktunya adalah O(1).Menariknya, sebuah fungsi bisa saja memiliki kompleksitas waktu konstan, bahkan saat memproses dataset besar. Misalnya, menghitung panjang daftar menggunakan fungsi len. Operasi ini O(1) karena implementasinya secara internal menyimpan ukuran daftar, sehingga tidak perlu menghitung elemen setiap kali panjangnya diminta.
Waktu linier: O(N)
Sebelumnya kita membahas
sum_listsebagai contoh fungsi waktu linier. Secara umum, algoritme waktu linier mengeksekusi tugas yang perlu memeriksa setiap titik data satu per satu. Menghitung nilai minimum, maksimum, atau rata-rata adalah operasi tipikal dalam kategori ini.Mari berlatih dengan menganalisis fungsi berikut untuk menghitung nilai minimum dari sebuah daftar:
Jika daftar memiliki N elemen, kompleksitasnya adalah 1 + (N - 1) + 1 = N + 1 = O(N).
Waktu eksekusi algoritme waktu linier berbanding lurus dengan jumlah data. Jadi, jika jumlah data digandakan, waktu yang dibutuhkan algoritme untuk memproses data juga akan menjadi dua kali lipat.
Waktu logaritmik: O(log(N))
Permainan tebak angka melibatkan upaya menebak angka tersembunyi antara 1 dan N, dengan tujuan mengidentifikasi angka ini dengan jumlah tebakan sesedikit mungkin. Setelah setiap tebakan, kita menerima umpan balik apakah angka tersembunyi lebih tinggi, lebih rendah, atau sama dengan tebakan. Jika tebakan benar, kita menang; jika tidak, kita lanjut menebak.
Salah satu strategi efektif untuk permainan ini adalah selalu menebak titik tengah. Misalkan N = 15. Dalam hal ini, tebakan pertama kita adalah 8. Jika angka rahasia lebih kecil dari 8, kita tahu angka tersebut harus berada antara 1 dan 7. Jika lebih besar, maka berada antara 9 dan 15. Kita terus menebak titik tengah dari rentang yang tersisa hingga menemukan jawaban yang benar. Diagram di bawah menggambarkan jalur potensial yang dapat diikuti strategi ini.
Mari kita lihat kompleksitas waktu pendekatan ini. Tidak seperti contoh sebelumnya, jumlah langkah yang diambil algoritme ini tidak hanya bergantung pada ukuran input N, karena ada kemungkinan menebak benar pada percobaan pertama.
Saat menganalisis algoritme seperti ini, kita berfokus pada skenario terburuk. Misalnya, dengan N = 15, dalam kasus terburuk, kita perlu membuat 4 tebakan. Setiap tebakan, yang merupakan titik tengah, mengeliminasi setengah dari kemungkinan yang tersisa. Dalam skenario terburuk, kita terus menebak hingga hanya tersisa satu kemungkinan. Maka, pertanyaan yang perlu kita jawab adalah:
Berapa kali kita harus membagi N dengan 2 untuk mendapatkan 1?
Jawabannya adalah logaritma basis-2 dari N, ditulis log2(N). Algoritme yang digunakan untuk menemukan angka yang benar ini dikenal sebagai pencarian biner. Karena jumlah tebakan maksimum adalah log2(N), kita dapat mengekspresikan kompleksitasnya sebagai O(log2(N)) atau cukup O(log(N)) karena konstanta tidak signifikan dalam notasi kompleksitas waktu.
Karena laju pertumbuhannya sangat lambat, kompleksitas waktu logaritmik sangat diinginkan dalam praktik, berperilaku hampir seperti waktu konstan. Bahkan untuk nilai N yang besar, jumlah operasi tetap sangat rendah. Misalnya, meskipun N satu miliar, jumlah operasi yang diperlukan hanya sekitar 30.
Pencarian biner adalah algoritme fundamental dalam ilmu komputer dengan banyak aplikasi. Misalnya, dalam pemrosesan bahasa alami, pemeriksa ejaan dan sistem koreksi otomatis dapat memanfaatkan variasi pencarian biner untuk mengidentifikasi kandidat kata secara efisien.
Waktu kuadratik: O(N2)
Mengurutkan data adalah tugas mendasar yang sering perlu dilakukan komputer. Salah satu cara untuk mengurutkan daftar N angka adalah dengan berulang kali mengidentifikasi elemen minimum dari daftar.
Untuk menganalisis kompleksitas sebuah perulangan
for, kita mengevaluasi kompleksitas instruksi di dalamnya dan kemudian mengalikan hasil tersebut dengan jumlah iterasi perulangan dieksekusi.Menghitung minimum dari daftar dan menghapus sebuah elemen dari daftar keduanya adalah operasi O(N). Menambah (append) dilakukan dalam waktu konstan, O(1). Oleh karena itu, setiap iterasi perulangan for memiliki kompleksitas O(N + N + 1) = O(2N + 1), yang menyederhana menjadi O(N). Karena ada N iterasi, kompleksitasnya adalah N × O(N) = O(N2). Sisanya dari fungsi
selection_sort()terdiri dari tiga instruksi sederhana, sehingga kompleksitas keseluruhan adalah O(N2 + 3) = O(N2).Analisis kita terhadap perulangan for melibatkan penyederhanaan berlebih. Pada setiap iterasi, kita menghapus satu elemen dari daftar, artinya tidak semua iterasi mengeksekusi jumlah instruksi yang sama. Iterasi pertama mengeksekusi N instruksi, kedua mengeksekusi N - 1, ketiga N - 2, dan seterusnya hingga iterasi terakhir, yang hanya mengeksekusi 1 instruksi.
Ini menyiratkan bahwa kompleksitas sebenarnya dari perulangan for adalah:
N + (N - 1) + (N - 2) + … + 1
Jumlah ini dapat ditunjukkan sama dengan (N2 + N) / 2. Namun,
(N2 + N) / 2 = ½N2 + ½N = O(N2)
Meskipun kita menghitung berlebih, kompleksitas keseluruhannya tetap kuadratik. Fungsi
selection_sort()mencontohkan algoritme pengurutan yang lebih lambat karena kompleksitasnya yang kuadratik, O(N2).Fungsi dengan kompleksitas kuadratik skala buruk, cocok untuk daftar kecil tetapi tidak praktis untuk mengurutkan jutaan titik data, karena dapat memakan waktu berhari-hari untuk menyelesaikannya. Menggandakan jumlah data membuat waktu eksekusi menjadi empat kali lipat.
Waktu loglinier: O(N log(N))
Ada algoritme untuk mengurutkan daftar dengan kompleksitas waktu O(N log(N)). Salah satunya disebut merge sort. Kita tidak akan membahas detail implementasinya, tetapi jika Anda ingin mempelajarinya lebih lanjut, lihat pengantar singkat tentang merge sort dari kursus Data Structures and Algorithms in Python ini.
Seperti disebutkan sebelumnya, kompleksitas logaritmik dalam praktik berperilaku mirip dengan kompleksitas konstan. Oleh karena itu, waktu eksekusi algoritme O(N log(N)) dapat sebanding dengan algoritme waktu linier dalam aplikasi dunia nyata.
Plot berikut menunjukkan bahwa N log(N) dan N tumbuh dengan laju yang serupa sementara N2 tumbuh sangat cepat, sehingga cepat menjadi sangat lambat.
Waktu kubik: O(N3)
Salah satu algoritme berkekompleksitas kubik yang banyak digunakan dalam AI adalah perkalian matriks, yang berperan penting dalam berfungsinya model bahasa besar seperti GPT. Algoritme ini krusial untuk perhitungan yang dilakukan selama fase pelatihan dan inferensi.
Untuk mengalikan dua matriks N x N, A dan B, kita perlu mengalikan setiap baris dari matriks pertama A dengan setiap kolom dari matriks kedua B. Secara spesifik, nilai hasil pada entri (i, j) ditentukan dengan mengalikan elemen pada baris i dari A dengan elemen yang sesuai pada kolom j dari B.
Berikut implementasi Python untuk perkalian matriks:
Secara total,
matrix_mul()mengeksekusi N3 + N2 + 2 instruksi sehingga kompleksitas waktunya adalah O(N3).Sebagai alternatif, kita bisa menganalisis kompleksitas dengan menalar perhitungannya. Hasil perkalian matriks memiliki N2 entri. Setiap entri membutuhkan waktu O(N) untuk dihitung, sehingga kompleksitas keseluruhan adalah N2 × O(N) = O(N3).
Algoritme waktu kubik cukup lambat. Menggandakan jumlah data menghasilkan faktor delapan pada waktu eksekusi, membuat algoritme seperti ini berskala sangat buruk. Bahkan untuk nilai N yang relatif kecil, jumlah instruksi meningkat sangat cepat.
Perkalian matriks adalah contoh tantangan komputasional di mana kemajuan perangkat keras memberikan dampak signifikan. Meskipun ada algoritme yang sedikit lebih efisien untuk perkalian matriks, utamanya adalah kemajuan dalam desain chip GPU—yang disesuaikan khusus untuk melakukan perkalian matriks—yang secara signifikan mempermudah pelatihan model besar seperti GPT dalam kerangka waktu yang wajar.
Baru-baru ini, para peneliti mengusulkan untuk menghilangkan perkalian matriks dari model pembelajaran besar—Anda dapat membaca lebih lanjut dalam artikel tentang MatMul-Free LLMs: Konsep Kunci Dijelaskan.
Kompleksitas waktu eksponensial: O(2N) dan O(N!)
Algoritme waktu eksponensial biasanya muncul ketika sebuah masalah diselesaikan dengan menjelajahi semua kemungkinan solusi. Pertimbangkan perencanaan rute untuk truk pengiriman yang harus mengunjungi N lokasi. Salah satu pendekatan adalah mengevaluasi setiap urutan pengiriman yang mungkin. Paket Python itertools menawarkan cara sederhana untuk menelusuri semua permutasi sebuah daftar.
Jumlah permutasi dari daftar dengan panjang N dilambangkan dengan N!, dibaca "N faktorial." Fungsi faktorial menunjukkan pertumbuhan eksponensial. Misalnya, ketika N = 13, jumlah permutasi melebihi 1 miliar.
Misalkan lokasi pengiriman diberikan sebagai daftar titik 2D. Dalam hal ini, kita dapat menentukan urutan pengiriman yang meminimalkan jarak total dengan menelusuri semua urutan yang mungkin sambil melacak yang terbaik.
Perulangan
forpertama dieksekusi N! kali. Oleh karena itu, jumlah operasi dalamoptimize_route()adalah N! x (1 + N - 1 + 2) + 3 = N! x (N + 2) + 3 = N! x N + 2N! + 3.Kita belajar bahwa saat menghitung kompleksitas waktu, kita mengabaikan suku berpangkat lebih rendah. Namun, dalam skenario ini, kita menemui suku N! yang bukan merupakan pangkat dari N. Kita dapat memperhalus strategi penyederhanaan dengan memilih untuk mengabaikan suku-suku dengan laju pertumbuhan lebih lambat. Tabel di bawah mencantumkan suku yang umum ditemukan dalam kompleksitas waktu suatu algoritme, diurutkan dari laju pertumbuhan terendah ke tertinggi.
1
log(N)
N
N2
N3
Nk
2N
N!
Dengan demikian, kita dapat mengekspresikan kompleksitas waktu
optimize_route()sebagai N! x N + 2N! + 3 = O(N! x N).Algoritme dengan kompleksitas waktu eksponensial biasanya hanya efisien untuk menyelesaikan instance yang sangat kecil. Bahkan dengan hanya 13 lokasi, jumlah permutasi melebihi 1 miliar, membuat algoritme ini tidak praktis untuk skenario dunia nyata.
Kompleksitas Waktu: Kasus Terburuk dan Kasus Terbaik
Pada permainan tebak angka, kita berfokus pada kompleksitas kasus terburuk. Dengan berfokus pada kasus terburuk, kita menjamin laju pertumbuhan waktu eksekusi algoritme.
Dalam kasus terbaik, kita menebak pada percobaan pertama, jadi analisis kompleksitas kasus terbaik menghasilkan kompleksitas O(1). Ini akurat—dalam kasus terbaik, kita membutuhkan satu operasi konstan. Namun, ini tidak terlalu berguna karena sangat tidak mungkin terjadi.
Secara umum, saat kita menganalisis kompleksitas suatu algoritme, kita selalu fokus pada kasus terburuk karena:
Kompleksitas Waktu: Implikasi Praktis
Kompleksitas waktu mungkin tampak sangat teoretis, tetapi bisa sangat berguna dalam praktik.
Sebagai contoh, jika sebuah fungsi secara konsisten menangani dataset kecil, algoritme O(N2) yang mudah dipahami mungkin lebih tepat daripada algoritme O(N) yang kompleks dan sulit dirawat. Namun, ini harus menjadi keputusan yang disengaja agar tidak lengah saat aplikasi tidak dapat menangani peningkatan lalu lintas pengguna.
Analisis kompleksitas waktu mengungkapkan bahwa optimasi kode kecil memiliki efek yang dapat diabaikan pada waktu eksekusi algoritme. Peningkatan signifikan dicapai dengan secara fundamental mengurangi jumlah operasi dasar yang diperlukan untuk menghitung hasil. Secara umum, menjaga kode tetap bersih dan mudah dipahami lebih disukai daripada mengoptimalkannya hingga menjadi sulit dimengerti.
Bagian kode yang lebih lambat akan mendominasi yang lain. Biasanya tidak ada gunanya mengoptimalkan bagian yang lebih cepat sebelum mengoptimalkan yang lebih lambat. Misalnya, bayangkan kita memiliki fungsi yang melakukan dua tugas:
Jika fungsi
clean_data()memiliki kompleksitas O(N2) dananalyze_data()memiliki kompleksitas O(N3), maka mengurangi kompleksitasclean_data()tidak akan meningkatkan kompleksitas keseluruhanprocess_data(). Lebih baik fokus pada peningkatan fungsianalyze_data().Selain itu, kompleksitas waktu dapat menginformasikan keputusan perangkat keras. Misalnya, algoritme O(N3), meskipun skalabilitasnya buruk, mungkin masih cukup cepat untuk tugas dengan data terbatas jika dijalankan pada perangkat keras unggul atau bahasa pemrograman yang lebih cepat. Sebaliknya, jika sebuah algoritme memiliki kompleksitas waktu eksponensial O(2N), peningkatan perangkat keras tidak akan cukup, yang menandakan perlunya algoritme yang lebih efisien.
Kesimpulan
Meskipun komputer makin cepat, kita berhadapan dengan lebih banyak data dari sebelumnya. Ibaratnya begini: setiap kali kita menggunakan Internet, ponsel pintar, atau perangkat rumah pintar, kita menciptakan banyak sekali informasi. Seiring gunungan data ini bertambah, memilah-milahnya dan menemukan yang penting menjadi semakin sulit. Itulah sebabnya sangat penting untuk terus membuat alat kita—terutama algoritme—semakin baik dalam menangani dan memahami semua informasi ini.
Analisis kompleksitas waktu menawarkan kerangka kerja yang lugas untuk menalar tentang waktu eksekusi algoritme. Tujuan utamanya adalah memberikan wawasan tentang laju pertumbuhan kompleksitas waktu alih-alih memprediksi waktu eksekusi yang tepat. Terlepas dari banyak penyederhanaan dan asumsi model, pendekatan ini terbukti sangat berguna dalam praktik, secara efektif menangkap esensi perilaku waktu eksekusi algoritme.
Jika Anda ingin mengeksplorasi lebih banyak topik ilmu komputer, lihat artikel saya tentang Struktur Data: Panduan Komprehensif dengan Contoh Python.