

Corso
Concetti di AWS
2 ore
53.5K
Pratica and corso your progress.
Continua Con GoogleAmazon S3 è uno di quegli strumenti che incontrerai più e più volte quando lavori nel cloud. S3 viene usato nella maggior parte dei progetti AWS, che si tratti di archiviare file statici o di costruire un’architettura scalabile, il che spiega perché sia un argomento così comune ai colloqui. Chi ti intervista non valuterà solo quante nozioni su S3 conosci, ma soprattutto se sai usare questo servizio in modo efficace per risolvere problemi reali, ottimizzare le prestazioni e garantire che i sistemi restino sicuri e scalabili.
In questo articolo ho raccolto 25 domande su AWS S3 per i colloqui che riflettono scenari reali. Le ho raggruppate in categorie – Base, Intermedio, Avanzato, e una sezione speciale per Cloud/DevOps Engineer – così, a prescindere dal tuo livello di carriera, troverai qualcosa per te!
E prima di iniziare: se sei completamente nuovo al cloud computing, ti consiglio di seguire prima il nostro corso Introduzione al cloud computing. Il corso spiega le basi del cloud, chiarisce termini chiave come scalabilità e latenza e illustra i vantaggi degli strumenti cloud di provider come AWS.
Queste domande vertono su che cos’è S3 e come funziona. Probabilmente le incontrerai se non hai mai lavorato con S3 o se l’intervistatore non è certo del tuo livello e vuole partire dalle basi.
Amazon S3 (Simple Storage Service) è un servizio di object storage che ti consente di archiviare, recuperare e gestire dati su qualsiasi scala.
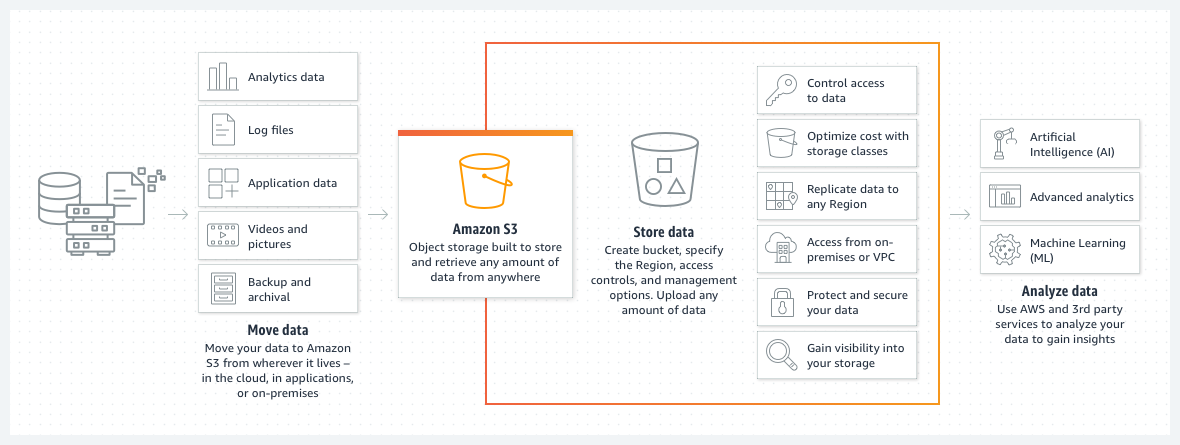
Fonte: AWS
Funzionalità principali:
Un bucket S3 è un contenitore per archiviare oggetti in Amazon S3. Ogni bucket ha un nome univoco a livello globale e funge da directory radice in cui puoi caricare file (oggetti). I bucket servono per organizzare i dati e gestire le autorizzazioni di accesso.
Amazon S3 offre più classi di storage pensate per diversi casi d’uso:

Tipi di classi di storage S3. Immagine dell’autore
Durabilità misura la probabilità che i tuoi dati restino intatti e non vadano persi a causa di guasti hardware, corruzione o altri eventi imprevisti. S3 garantisce il 99,999999999% di durabilità replicando automaticamente i dati su più dispositivi in più Availability Zone (AZ). In pratica, significa che se archivi 10 milioni di oggetti in S3, in media potresti perdere un oggetto ogni 10.000 anni per un guasto dello storage.
Disponibilità indica quanto spesso puoi accedere ai tuoi dati quando ti servono. Ad esempio, S3 Standard ha il 99,99% di disponibilità, il che significa che in un anno potrebbero esserci fino a 53 minuti di inattività in cui S3 è temporaneamente inaccessibile. Il servizio è progettato per gestire le interruzioni senza impattare gli utenti.
Esistono vari meccanismi che aiutano a mantenere i dati sicuri in S3:
S3 (Simple Storage Service): object storage per dati non strutturati. Ideale per archiviare file, backup e asset statici. Accesso via HTTP/HTTPS.
Se vuoi approfondire l’argomento, dai un’occhiata a questo tutorial pratico su S3 ed EFS.
Le domande di livello intermedio si concentrano su funzionalità e strategie pratiche, come gestire i costi, configurare la replica e integrare S3 con altri servizi AWS. Sono i concetti che incontrerai quando ottimizzi o scali un’applicazione che usa S3.
Una policy di ciclo di vita in S3 è un insieme di regole che gestiscono automaticamente il ciclo di vita degli oggetti in un bucket. Puoi usarla per spostare gli oggetti tra classi di storage o per eliminarli dopo un certo periodo. Questo semplifica la gestione dei dati e può ridurre drasticamente i costi.
La replica S3 serve a copiare automaticamente gli oggetti da un bucket a un altro.
La replica richiede l’abilitazione del versioning sia sul bucket di origine che su quello di destinazione ed è comunemente usata per esigenze di backup e compliance.
S3 + Lambda: attiva le funzioni Lambda usando le S3 Event Notifications per workflow serverless come elaborazione di immagini, trasformazioni dei dati o analisi dei log.
S3 + CloudFront: usa CloudFront come Content Delivery Network (CDN) per distribuire i contenuti archiviati in S3 con bassa latenza e alte prestazioni. CloudFront può mettere in cache gli oggetti S3 nelle edge location per una consegna più rapida agli utenti in tutto il mondo.
Il versioning è una funzionalità di S3 che ti consente di mantenere più versioni di un oggetto all’interno di un bucket ed è utile per:
Le S3 Event Notifications ti permettono di configurare S3 per inviare notifiche quando si verificano eventi specifici, come creazione, eliminazione o aggiornamento di oggetti. Le notifiche possono essere inviate a servizi come Amazon SQS per accodare eventi, AWS Lambda per elaborarli in tempo reale o Amazon SNS per diffonderli a più sottoscrittori.
Un URL pre-firmato fornisce accesso temporaneo e a tempo limitato a uno specifico oggetto in S3.Consentono agli utenti di scaricare file privati senza modificare le autorizzazioni del bucket e abilitano il caricamento su un bucket specifico senza concedere accesso completo: sono quindi ottimi per la condivisione di file.
La sezione avanzata entra in scenari più complessi, in cui devi dimostrare la comprensione di S3 su larga scala, come risolvere i problemi, e come proteggere e ottimizzare le soluzioni di storage. Queste domande servono a valutare quanto bene sai applicare S3 in produzione con attenzione a sicurezza, prestazioni e costi.
Le policy di sicurezza per i bucket S3 possono essere implementate usando le policy IAM (Identity and Access Management) e le policy dei bucket.
Policy IAM: definiscono i permessi per utenti o gruppi AWS, specificando quali azioni possono essere eseguite su quali risorse S3. Ad esempio, una policy IAM potrebbe consentire a un’applicazione di leggere oggetti da un bucket S3 ma non di eliminarli.
Policy del bucket: definiscono permessi direttamente sui bucket S3. Possono consentire o negare accessi in base a condizioni come indirizzo IP, user agent o presenza di MFA (autenticazione a più fattori). Le policy dei bucket sono più granulari delle policy IAM e si usano per controllare l’accesso a livello di bucket.
Ci sono alcune best practice da seguire, come applicare il principio del privilegio minimo, abilitare la crittografia e il logging del bucket per monitorare gli accessi e usare l’eliminazione con MFA per ulteriore protezione nelle operazioni di delete.
S3 Object Lock ti consente di impedire che gli oggetti vengano eliminati o sovrascritti per un periodo di conservazione specificato.
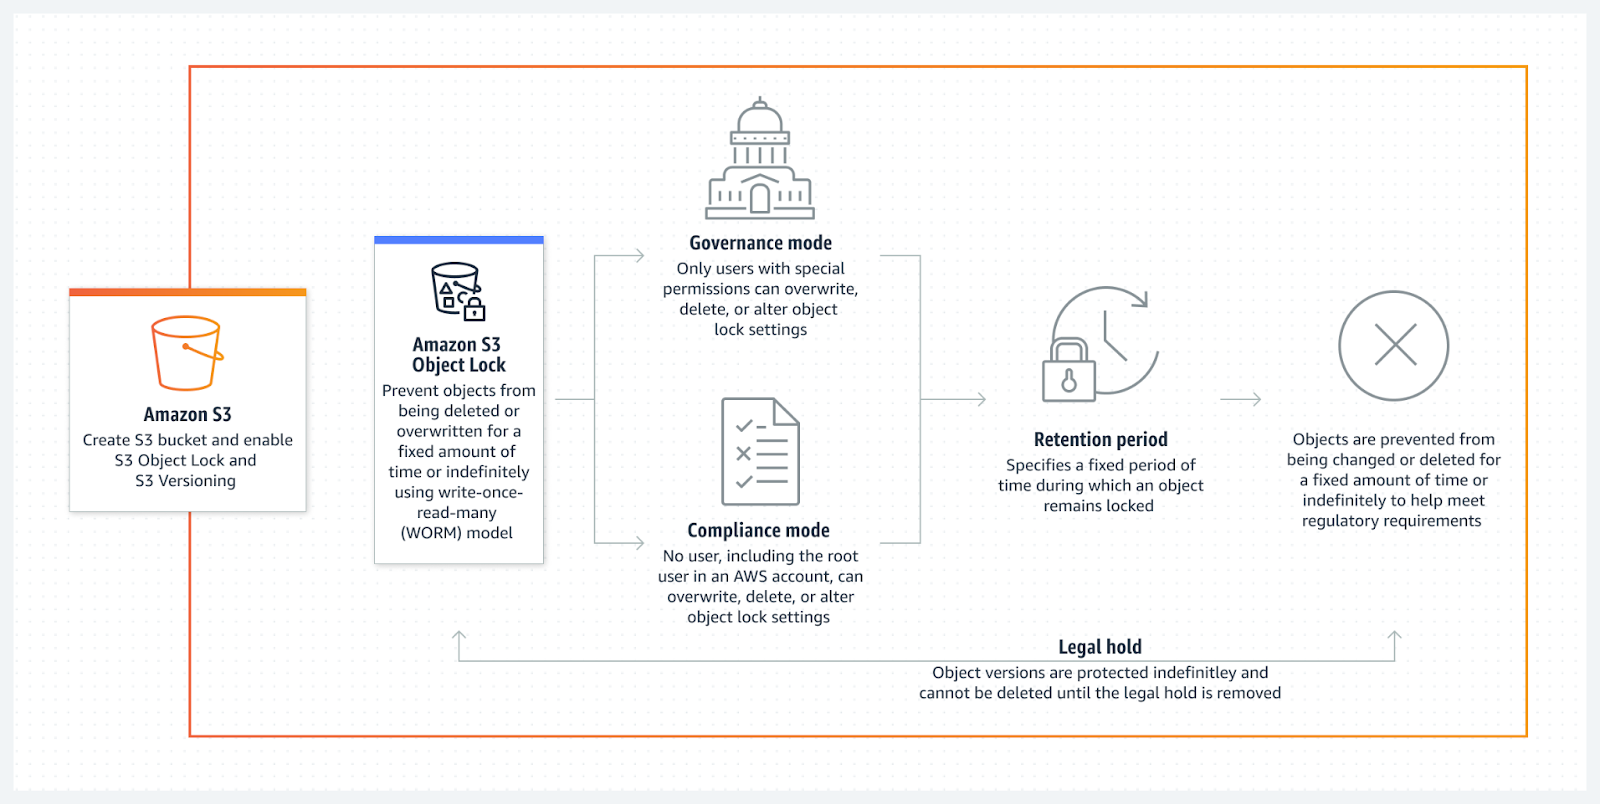
Fonte: AWS
È molto utile nei seguenti scenari:
A seconda delle esigenze, Object Lock funziona in due modalità:
Per ottimizzare i caricamenti di file grandi in S3 puoi usare:
S3 Select consente di recuperare un sottoinsieme di dati da un oggetto (come un file CSV o JSON) senza dover scaricare l’intero oggetto. Questo può ridurre significativamente sia i costi di trasferimento dati sia il tempo necessario per elaborare dataset molto grandi, come log o dati analitici.Definisci una query SQL per filtrare o recuperare colonne o righe specifiche da un oggetto. Solo i dati restituiti dalla query vengono trasmessi, evitando di trasferire oggetti completi.
Queste domande valutano non solo la conoscenza tecnica ma anche come applichi S3 per risolvere problemi di business, mantenere l’affidabilità del sistema e integrarti con workflow più ampi come le pipeline CI/CD.
Non esiste una risposta “giusta” qui, perché ti verrà chiesto di parlare della tua esperienza e di cosa faresti in scenari specifici, ma ho raccolto un elenco dei tipi di domande che potresti ricevere, cosa l’intervistatore vuole valutare e quali elementi dovrebbe includere una buona risposta.
Cosa cercano gli intervistatori:
Questa domanda mira a capire la tua capacità di identificare le sfide di business e come hai sfruttato S3 per affrontarle in modo efficace. L’intervistatore cerca le tue abilità di problem solving, come hai applicato le funzionalità di S3 e come la soluzione ha portato benefici al business.
Cosa includere nella risposta:
Risposta di esempio:
"In un progetto precedente, lavoravamo con un’azienda media che doveva archiviare e distribuire grandi file video a utenti in tutto il mondo. La sfida erano l’alta latenza e i costi di storage. Abbiamo usato S3 per archiviare i video e integrato CloudFront per una distribuzione globale veloce. Inoltre, abbiamo implementato S3 Intelligent-Tiering per spostare automaticamente i video a accesso raro su classi di storage più economiche. Questo ha ridotto i costi di storage del 30% e migliorato la velocità di consegna del 50%, con maggiore soddisfazione dei clienti."
Cosa cercano gli intervistatori:
Vogliono testare la tua comprensione del pricing AWS e la capacità di prendere decisioni informate sulle strategie di archiviazione. Vogliono sapere se sai bilanciare efficienza dei costi e prestazioni.
Cosa includere nella risposta:
Risposta di esempio:
"In un progetto avevamo un grande dataset a accesso frequente nelle prime fasi e raramente dopo un mese. Per ottimizzare i costi ho impostato policy di ciclo di vita S3 per spostare i dati più vecchi su S3 Glacier dopo 30 giorni. Inoltre ho usato S3 Intelligent-Tiering per i dati con pattern di accesso imprevedibili. Di conseguenza, i costi di storage sono diminuiti del 40% e abbiamo potuto destinare più budget ad altre parti dell’infrastruttura."
Cosa cercano gli intervistatori:
Vogliono valutare la tua conoscenza nel progettare per disponibilità, resilienza ed efficienza dei costi in un’architettura globale. Si aspettano che tu comprenda i trade-off di una configurazione multi-regione, come latenza, replica e costi.
Cosa includere nella risposta:
Risposta di esempio:
"In un progetto precedente mi è stato chiesto di progettare un’architettura S3 per servire clienti su più continenti. Per ottenere alta disponibilità e tolleranza ai guasti ho configurato la Cross-Region Replication (CRR) tra bucket S3 in due regioni: una negli Stati Uniti e una in Europa. Questo ha garantito la disponibilità dei dati anche in caso di failure in una regione. Per minimizzare la latenza ho integrato CloudFront come CDN per mettere in cache i dati vicino agli utenti, riducendo i tempi di accesso. Anche se la CRR ha aggiunto qualche costo, era giustificata dall’esigenza di resilienza della nostra base utenti globale."
Cosa cercano gli intervistatori:
Vogliono vedere che sai monitorare in modo proattivo e rilevare potenziali problemi nella tua infrastruttura S3. Cercano la tua capacità di usare gli strumenti AWS per il monitoraggio e di impostare avvisi per una gestione efficace degli incidenti.
Cosa includere nella risposta:
Risposta di esempio:
"Per monitorare i bucket S3 uso principalmente CloudWatch per tracciare metriche come numero di richieste, uso dello storage e tassi di errore. Imposto allarmi per picchi insoliti nel numero di richieste o nell’uso dello storage, che possono indicare potenziali problemi. Inoltre, abilito CloudTrail per registrare le chiamate API S3, così da poter tracciare e auditare tutte le interazioni con i bucket. Questo mi ha aiutato a identificare rapidamente problemi dovuti a modifiche inattese nelle policy dei bucket e a prevenire accessi non autorizzati."
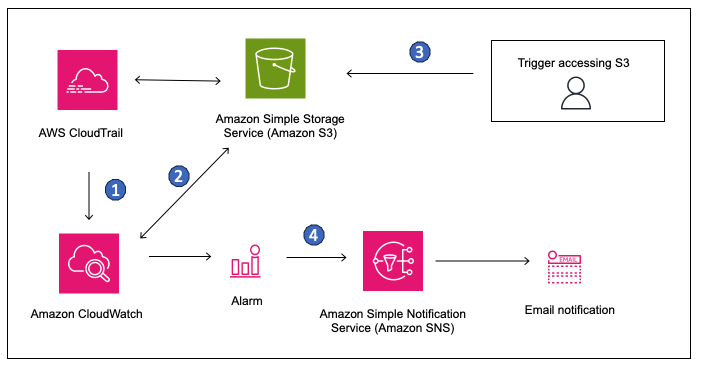
Fonte: AWS
Cosa cercano gli intervistatori:
Vogliono capire quanto bene sai integrare S3 nei workflow di sviluppo moderni come la CI/CD. Valutano la tua esperienza nell’automatizzare le operazioni di storage come parte di una pipeline DevOps più ampia.
Cosa includere nella risposta:
Risposta di esempio:
"In uno dei miei progetti recenti abbiamo integrato S3 nella pipeline CI/CD per gestire gli artifact di build. Dopo una build riuscita, la pipeline caricava automaticamente gli artifact su un bucket S3 dedicato. Poi abbiamo usato le S3 Event Notifications per attivare AWS Lambda, che avviava il processo di deploy. Questo ha reso più snello il flusso di rilascio e ci ha permesso di gestire gli artifact centralmente. Ha ridotto significativamente i tempi di deploy e migliorato il versioning degli artifact."
Cosa cercano gli intervistatori:
Vogliono sapere se sai progettare per ridondanza e resilienza e fare in modo che l’applicazione resti operativa anche in caso di guasti. Cercano strategie e strumenti specifici che hai usato per costruire tolleranza ai guasti nelle applicazioni basate su S3.
Cosa includere nella risposta:
Risposta di esempio:
"Per garantire alta disponibilità e tolleranza ai guasti in un’applicazione che dipendeva fortemente da S3, ho usato la Cross-Region Replication (CRR) per replicare i dati tra regioni. Questo garantiva che, anche se una regione fosse down, l’app potesse accedere ai dati dall’altra. Ho anche abilitato il versioning su S3 per evitare perdite dovute a eliminazioni o sovrascritture accidentali. Inoltre, ho impostato allarmi CloudWatch per monitorare lo stato dei processi di replica e avvisarci in caso di failure, così da poter intervenire rapidamente."
Cosa cercano gli intervistatori:
Questa domanda verifica la tua comprensione di compliance e governance negli ambienti AWS. L’intervistatore vuole conoscere la tua esperienza nel mantenere standard di sicurezza, nell’auditing e nel garantire che tutte le configurazioni rispettino le policy aziendali.
Cosa includere nella risposta:
Risposta di esempio:
"Per far rispettare la conformità delle configurazioni dei bucket S3 ho usato AWS Config per verificare che i bucket rispettassero le nostre policy interne, ad esempio che l’accesso pubblico fosse bloccato e la crittografia abilitata. Ho anche implementato policy IAM per limitare chi poteva accedere o modificare i bucket S3, garantendo che solo gli utenti autorizzati potessero apportare cambiamenti. Abbiamo usato CloudTrail per registrare tutta l’attività S3 ai fini di audit, semplificando il tracciamento dei pattern di accesso e il rispetto dei requisiti normativi."
Se sei arrivato fin qui, sei pronto per il tuo colloquio su AWS S3!
Detto questo, S3 è solo una piccola parte di AWS e probabilmente ti faranno domande anche su altri servizi. Se vuoi prepararti, o semplicemente colmare alcune lacune, ti consiglio il nostro corso Introduzione ad AWS oppure, se preferisci l’apprendimento pratico, il corso Tecnologie e servizi cloud AWS.
Puoi anche proseguire gli studi e aggiungere una certificazione AWS ufficiale al tuo CV o profilo LinkedIn per mettere in mostra le tue competenze ai potenziali datori di lavoro. AWS offre diverse certificazioni a seconda del livello e del ruolo, quindi c’è qualcosa per tutti!
In bocca al lupo per il colloquio!
Impara AWS con DataCamp
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min



