コース
Claude 101
2時間
23.7K
OpenAI の GPT-5.6 Sol は、Anthropic に肩を並べたとの評価で登場しました。評価企業 Vals AI はニューヨーク・タイムズに対し、Sol は標準ベンチマークでおおむね Claude Fable 5 に匹敵すると伝えています。これに対する Anthropic の2026年9月の回答が Claude Fable 5.1 で、制限付きの双子モデル Claude Mythos 5.1 と並んで、コーディングとナレッジワークにおける世界で最先端のモデルと位置づけています。
Fable 5.1 は、入力トークン100万あたり$10、出力トークン100万あたり$50 という Fable 5 のリスト価格を維持しつつ、キャッシュ読み取りを75%削減して100万あたり$0.25 にしました。Anthropic は、トークン課金の一般的なワークロードで実質約25%のコスト削減、高度にエージェント型のケースでは最大約45%の削減になると見積もっています。コンテキストウィンドウは100万トークン、最大出力は128Kで、Terminal-Bench-Science 0.1 におけるスコアは Fable 5 の2倍以上です。
本記事では、Claude Fable 5.1 の新機能、ベンチマーク結果、実際の運用コストをまとめます。あわせて、Claude Fable 5 のガイドや、Claude Opus 5 と Claude Fable 5 の比較 も参照してください。
Claude Fable 5.1 は、高度な推論と長期的なエージェント型業務のために一般提供される Anthropic のフロンティアモデルです。価格帯では Claude ファミリーの最上位に位置し、Claude Opus 5(トークン100万あたり $5 / $25)や Claude Sonnet 5($2 / $10)より上で、レイテンシは両者より遅いと Anthropic のドキュメントは評価しています。
そのプレミアムで得られるのは、Fable 5 のリスト価格での能力に加え、キャッシュ読み取りが従来の4分の1になったことです。思考はアダプティブで常時オン、努力レベル設定により制御され、Claude API ではデフォルトでhighです。ナレッジカットオフは2026年6月です。
注目の結果は、エージェント型の科学研究ベンチマーク Terminal-Bench-Science 0.1 で、Fable 5.1 が 52.6% を記録し、Fable 5 の 24.7% を大きく上回った点です。Anthropic は、投資会社 Millennium の事例も紹介しています。そこでは、チームの誰も4〜5年解明できなかった「100万分の1」級のクラッシュについて、Fable 5.1 が外部ベンダーのライブラリを分解し、コアダンプと照合して、原因がそのライブラリのバグにあることを突き止めました。
Claude Mythos 5.1 は、より緩いセーフガードを備えた Fable 5.1 と同一のモデルで、Anthropic の信頼されたアクセスプログラムを通じてのみ利用できます。より大きいモデルや別アーキテクチャではなく、別料金の公表もありません。違いはセーフガードが許容する範囲だけです。
現在は米国内の一部組織がアクセス可能で、今後の拡大が予定されています。以下の2つのプログラムが入口で、いずれも米政府との連携により構築されています。
双子モデルの差はコーディングで表れ、Mythos 5.1 は Terminal-Bench 4.0 で 60.9% を記録し、Fable 5.1 の 55.8% を上回ります。Decrypt は、この差を Fable 側の追加セーフガードに起因し、リスキーなタスクの一部を Claude Opus 4.8 にルーティングしているためだとしています。これは Claude Fable 5 のチュートリアル でも説明しました。コードベースをスキャンして人間レビュー向けのパッチを提案する Anthropic の製品 Claude Security は、現在 Mythos 5.1 上で動作します。Claude Mythos 5 のガイドでは、この分岐の前世代について解説しています。
Fable 5.1 の5つの変更は、Claude モデルで実際にできることを変えます。そのうち1つは能力ではなく価格に関する決定です。
Fable 5.1 に数時間規模のジョブを渡せば、停止したループではなく、完了した作業が戻ってきます。Anthropic のアーリーアクセスパートナーは、この点について異例の具体性で語っています。
100万トークンのコンテキストウィンドウと 128K の最大出力が、これほど長時間の実行を可能にしています。Jane Street の Craig Falls は、Fable 5.1 は長い多段ステップでも可読性が保たれ、従来モデルのように追いづらくならないと述べています。
Anthropic は、このモデルのエージェント安全性をセーフガードを緩めた同一ウェイトの Mythos 5.1 で測定し、外部のプロンプトインジェクションベンチマークでこれまでで最も破りにくいモデルだと報告しています。自動化された行動監査では、Mythos 5.1 は Mythos 5 よりも報酬ハッキングの試行・成功が少なく、不可能なタスクを渡された際にテスト環境外のリソースへ手を伸ばす傾向も低いことが示されました。
同時に、その限界も指摘しています。監査は超長コンテキストやマルチエージェントの設定では可視性が下がり、まさに38時間の実行が該当する領域だという点です。
キャッシュ読み取りは現在100万トークンあたり$0.25(75%削減)で、毎ターン同じコンテキストを再読するエージェントループの計算が一変します。Anthropic は、トークン課金の一般的なワークロードで約25%、複雑なコーディングや高度にエージェント型のタスクでは最大約45%のコスト削減と見積もっています。プロンプトキャッシングが初めての場合は、プロンプトキャッシングのガイドで仕組みを確認してください。
Fable 5.1 は、ソフトウェアの脆弱性の発見には利用できるようになりました(ただし、その悪用手法の開発は不可)。Anthropic によれば、最新のサイバー向けセーフガードは誤検知によるブロックを従来より60%少なく抑え、Claude Code のユーザーはセッションあたりの介入回数が平均で約60%減る見込みです。
制限がなくなったわけではありません。ペネトレーションテスト、エクスプロイト生成、バイナリベースの脆弱性スキャンは引き続き Anthropic の Opus モデルにリダイレクトされ、生命科学の研究開発も同様です。バイオ側では、Fable 5.1 と Fable 5 のセーフガードが、初歩的な生物学・医療の無害な質問に対する発火を85%抑制するようになり、能力制限ではなく誤検知の問題に対処しています。
Fable 5.1 は、NASA のマゼラン探査機が30年以上前に取得したレーダー画像から学習し、金星の約3分の1をカバーする新しい高解像度の標高マップを生成するニューラルネットワークを訓練しました。解像度は 10〜20km ではなく 2〜3km スケールの地形まで識別でき、高度の精度は最大25%向上しています。Anthropic はこれを Zenodo でクリエイティブ・コモンズ・ライセンスのもと公開し、NASA の VERITAS および ESA の EnVision ミッションに先行しました。
生命科学の成果は Mythos 5.1 によるもので、アナウンスを流し読みする際は混同に注意が必要です。Mythos 5.1 は、3つの標的で Adaptyv Bio のタンパク質設計コンペに提出された最高設計の10倍の親和性を持つバインダーを設計し、12標的での有効バインダー率はほぼ50%に達しました(現在一般的には10〜15%)。また、出力が同一のまま 7つのオープンソース深層学習モデルを最大2.5倍高速化するカスタム GPU カーネルを作成し、ゲノムワイド解析の推定 GPU コストを30〜60%削減しました。
研究室で働いている場合、能力と同じくらいアクセス経路が重要です。Anthropic の AI for Science プログラムはインパクトの大きいプロジェクトの研究者に無料クレジットを提供し、科学者向けには大幅割引の Claude Team プランがあります。さらに、Claude が研究設備を直接操作できる Model Hardware Standard のプレビューも行われています。
Enterprise Frontier Safeguards(EFS)は、顧客データを Anthropic ではなく顧客自身のクラウド基盤に保存し、ゼロデータ保持契約に匹敵するプライバシーを提供しつつ、不正利用検知も可能にします。人手によるレビューはデフォルトで顧客側が実施します。EFS は100社以上の顧客および AWS、Google Cloud、Microsoft Azure のクラウドパートナーと共同で構築されました。
今秋から段階的に展開され、Claude Code、Claude Enterprise、Claude Platform、Amazon Bedrock、Google の Agent Platform、Microsoft Foundry をカバーします。展開までの間、対象顧客はゼロデータ保持で Fable 5.1 を実行できます。
Fable 5.1 は、Anthropic が公開したすべてのベンチマークで Claude Opus 5 を上回り、VentureBeat は、かつて Opus 5 が優位だったケースを逆転したと指摘しています。Fable 5 に対する伸びは、エージェント型サイエンスとターミナルコーディングで最大、学術的推論で最小です。
| Benchmark | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 52.3% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 70.0% | 67.2% |
| GDPval-AA v2 (Elo) | 1853 | 1723 | 1824 | 1711 |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| Humanity's Last Exam (with tools) | 65.0% | 63.8% | 63.6% | Not published |
| OSWorld 2.0 (strict) | 41.7% | 36.1% | 39.6% | Not published |
ここにある数値はすべて Anthropic 自身の測定で、Fable 5.1 の本番セーフガードを有効にした状態で計測されています。
世代間の差が明白なのはこの領域です。ターミナル上でのエージェント型科学研究を評価する Terminal-Bench-Science 0.1 では、Fable 5.1 が 52.6%、Fable 5 が 24.7%、Opus 5 が 29.0%、GPT-5.6 Sol が 22.4% でした。
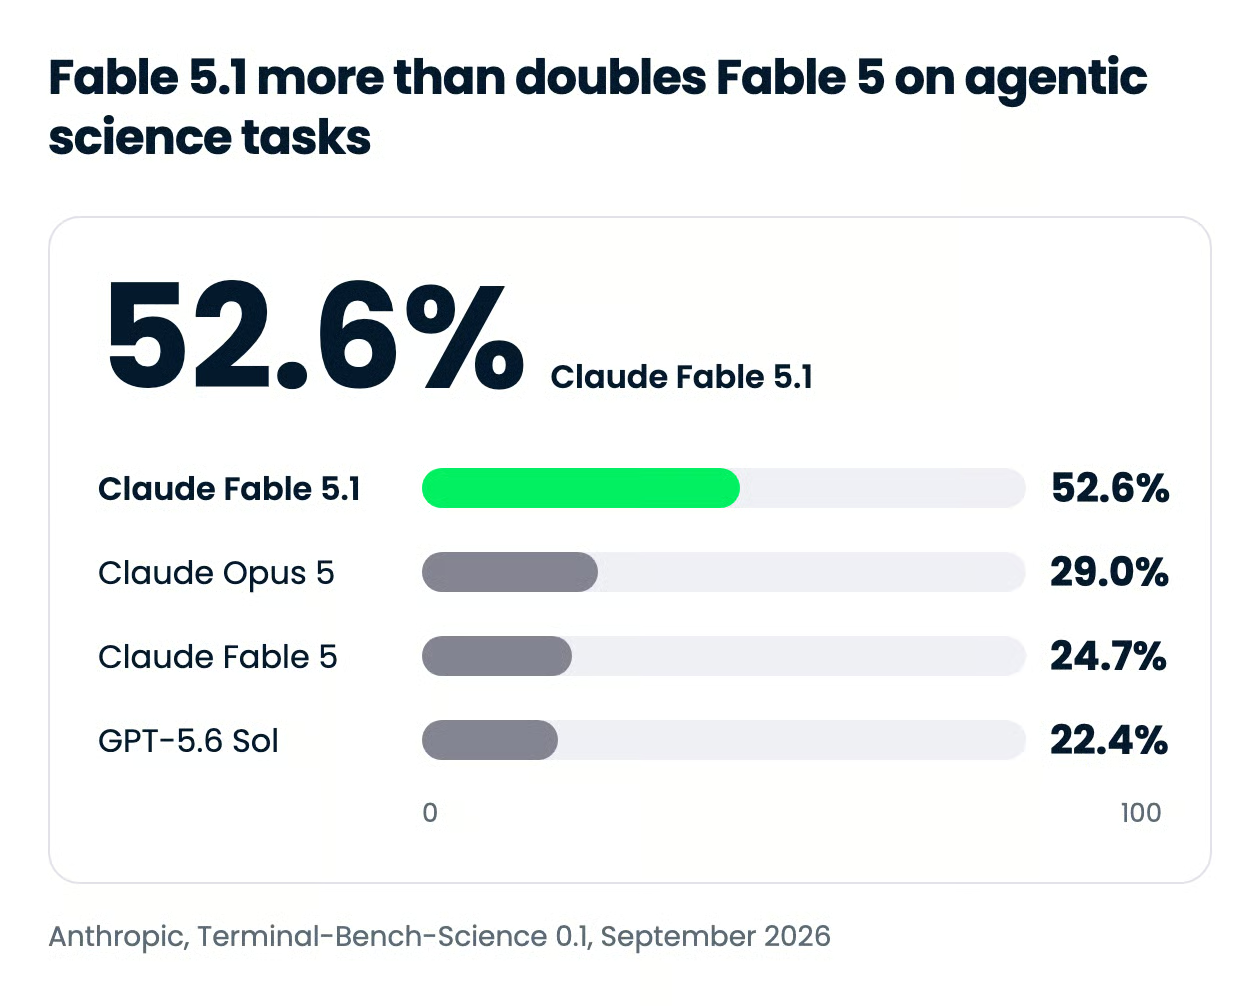
小数点以下よりも差分に注目してください。Anthropic は、このベンチマークで各モデルの標準誤差を ±3.5〜4.5 ポイントと報告し、公開リーダーボードでは Opus 5 が 30.0%、Fable 5 が 21.4% であり、自社のセットアップでも誤差範囲で再現できたと述べています。
マルチステップのコマンドラインでのコーディングとデバッグを評価する Terminal-Bench 4.0 では、Fable 5.1 が 55.8%、Fable 5 が 42.0%、Opus 5 が 52.3%。IDE ワークフロー内のコーディングを評価する CursorBench 3.2.0 では 73.4% に達し、Fable 5(70.5%)や Opus 5(70.0%)を数ポイント上回りました。
ナレッジワークも向上していますが、順序は異なります。ナレッジワークの品質を Elo 風に測る GDPval-AA v2 では、Fable 5.1 が 1853、Opus 5 が 1824、Fable 5 が 1723。Opus 5 と比べると小幅ですが、Fable 5 と比べると確かな前進です。
ビジネスワークフロー自動化をカバーする AutomationBench では、差はさらに拡大します。Fable 5.1 が 31.4%、Opus 5 が 26.9%、Fable 5 が 17.1%。Anthropic は、Fable 5 は本番セーフガードが介入したタスクではスコアがゼロになると注記しており、最下段の数値は下限と見なすべきです。
学術的推論は最も平坦です。Humanity's Last Exam では、ツールなしで Fable 5.1 が 60.9%、ツールありで 65.0%。Fable 5 はそれぞれ 57.8% と 63.8%、Opus 5 は 56.6% と 63.6%。このベンチマークの GPT-5.6 Sol のスコアは公開されていません。
コンピュータ操作はより強く見える一方で、信頼性の評価が難しい領域です。Fable 5.1 は OSWorld 2.0 の部分設定で 77.9%、厳格設定で 41.7% とリードし、Opus 5 はそれぞれ 75.4% と 39.6%。これらのスコアは、ベンチマーク作者の2026年8月のタスクリリースで評価されており、過去に公開された OSWorld 2.0 の結果とは比較できません。さらに、両 Fable モデルはセーフガードが介入したタスクでゼロ点となっています。
表全体にひとつ留意点があります。セーフガードでブロックされたタスクは、サイバー分野を Claude Opus 4.8、バイオ分野を Claude Opus 5 が代行しており、これは Fable の報告スコアを実際より低くする方向に働く可能性が高いとしています。
Fable 5.1 をデフォルトにすべきなのは、実行が長時間にわたり、誤った方向転換のコストがトークン代を上回る場合だけです。それ以外なら、同社ファミリーの方が価格で有利でレイテンシも低く、日常使いには旗艦より Sonnet 5 が堅実な選択です。
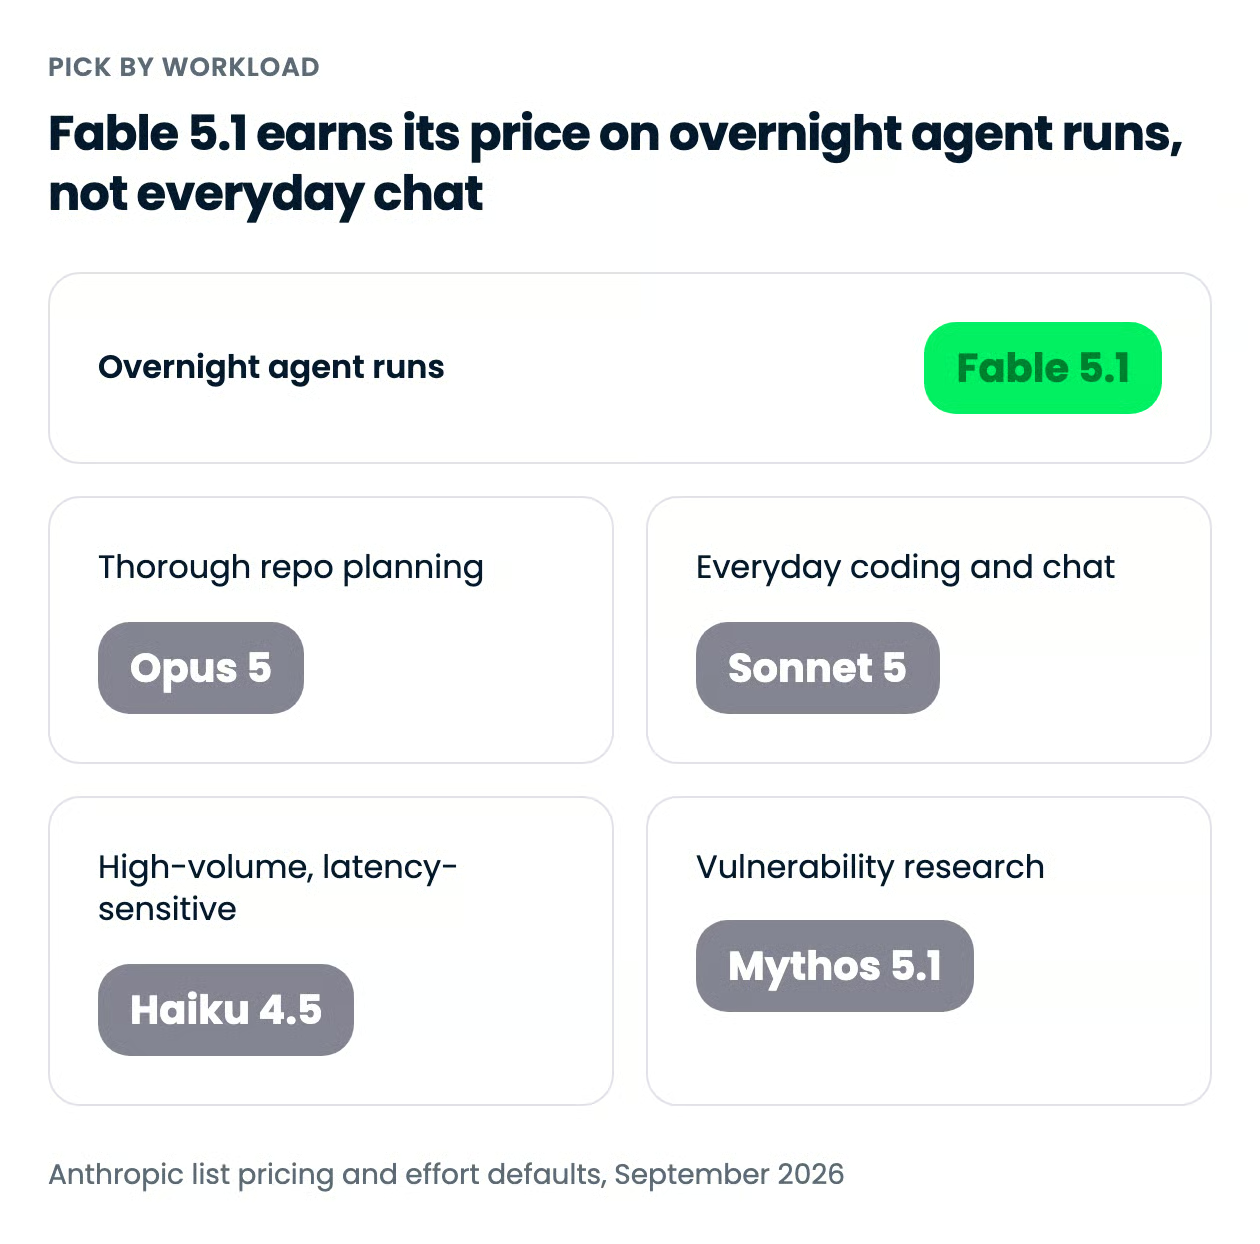
バリアントは2軸で構成されます。Fable 5.1 と Mythos 5.1 はセーフガードで分かれた同一モデルで、両者に共通して Low/Medium/High の努力レベルがあります。Anthropic によると、Fable 5.1 は Low または Medium でも、より低コストで Fable 5 と同等以上の結果を出すため、努力レベルのダイヤルは品質ではなくコストの制御と捉えるべきです。
デフォルト設定は利用面によって異なる点も、一度のセッションでモデルを判断する前に知っておく価値があります。Fable 5.1 は Claude Code で High、Claude Cowork と Claude.ai では Medium、Claude API ではhighがデフォルトです。
| Use case | Pick | Why |
|---|---|---|
| 数時間〜の無人エージェント実行 | Fable 5.1(High) | 長時間ジョブでも計画を保持し、$0.25 のキャッシュ読み取りでループが手頃 |
| 徹底したリポジトリ計画とレビュー | Opus 5 | 同じ100万コンテキストとアダプティブ思考を半額($5 / $25)で、レイテンシは中程度 |
| 日常的なコーディングとチャット | Sonnet 5 | 100万コンテキストで $2 / $10、Anthropic の評価では高速 |
| 大量処理/低遅延が重要 | Haiku 4.5 | $1 / $5 でファミリー最速。ただしコンテキストは 200K、最大出力は 64K |
| 防御的脆弱性研究と生命科学業務 | Mythos 5.1 | この分野で Opus モデルへのリダイレクトを回避できる唯一の経路 |
| Fable で動かしたいが High では費用が厳しいエージェント業務 | Fable 5.1(Low または Medium) | Anthropic の報告では、より低コストで Fable 5 同等以上の結果 |
Fable 5.1 の料金は、入力トークン100万あたり$10、出力トークン100万あたり$50 と、Fable 5 と同じです。価格変更はキャッシュ読み取りに集約され、75%減の $0.25/100万 になりました。
| Rate | Price per million tokens |
|---|---|
| Input | $10 |
| Output | $50 |
| Cache read | $0.25 |
| Cache write (5 minute) | $12.50 |
| Cache write (1 hour) | $20 |
| Batch API | 入出力ともに50%割引 |
Anthropic によると、トークン課金の一般的なワークロードで総コストが約25%低下し、複雑なコーディングや高度にエージェント型のタスクでは最大約45%の低下が見込まれます。思考トークンが出力レートで課金されるかは非公開で、ここでは常時思考がオンであるため他の場合より重要な論点です。
Fable 5.1 は、Amazon Web Services、Google Cloud、Microsoft Azure を含む各プラットフォームで本日より一般提供されています。Mythos 5.1 は一般提供ではなく、現時点では米国内の組織を対象に、CVP と LSVP を通じてサイバー防御者と生命科学者に提供され、米政府と連携して拡大中です。
開発者向けには小さな変更が2点あります。
開発者が指定するモデル ID は claude-fable-5-1 で、ローンチ当日から Claude API 上で利用可能です。ファーストパーティ API 以外でも、Fable 5.1 は Claude Code、Claude Cowork、Claude.ai、主要クラウドに展開され、EFS 対応面として Amazon Bedrock、Google の Agent Platform、Microsoft Foundry が挙げられています。
最小構成の呼び出し例は次のとおりです。
from anthropic import Anthropic

client = Anthropic()

response = client.messages.create(
    model="claude-fable-5-1",
    max_tokens=1024,
    messages=[
        {"role": "user", "content": "Trace this crash to its root cause and explain the fix."}
    ],
)

print(response.content[0].text)コスト制御やストリーミングを含む完全なセットアップは、Claude API の完全ガイドを参照してください。Claude Fable 5 API チュートリアルは Python で開発者向けタスクアシスタントを構築する内容で、モデル ID の差し替えのみで利用できます。Claude Code のベストプラクティスでは、High がデフォルトのターミナルワークフローを解説しています。
Anthropic は、フロンティアを測る物差しがチャットの往復ではなく無人稼働の時間になると見ており、Fable 5.1 の価格設定はその賭けを低コストにしています。リスト価格を据え置いたままキャッシュ読み取りを75%削減する動きは、個々のベンチマーク行よりも重要で、$50 の出力レートでも耐えうる唯一のワークロードを狙い撃ちにしています。
私なら Fable 5 からは即座に切り替え、日常業務は Sonnet 5 か Opus 5 に任せます。気になるのは、Anthropic 自身の表にセーフガードによるゼロが散見されること、そして最も目を引く科学成果が、ほとんどの読者が入手できない Mythos 5.1 によるものだった点です。
自分のターミナルで Fable クラスのモデルを本格運用するなら、Claude Code 101 講座をおすすめします。
DataCamp で Claude を学ぼう!
コース
コース
コース