

実験とハーネスを設計する
私の実装では、Claudeを4つのPython関数(ツール)と組み合わせます。データセットの後でツールを示します。完全なコードと任意のStreamlitインターフェースはGitHubリポジトリにあります。
4つの冷却モデルを定義する
ニュートンの冷却則では、物体は室温より大幅に高温なほど速く冷え、温度差が縮むにつれて遅くなります。式はT(t) = Ta + (T0 - Ta) * exp(-k * t)です。ここでT0は初期温度、Taは室温、kは1分あたりの冷却率です。
エージェントが選べるように、次の4つのモデル群を用意しました。
-
単一レート:全期間で1つの
k(ベースライン) -
時間切り替え:全ランで同じ経過時刻にレートが2段階で切り替わる
-
温度しきい値:共通の温度でレートが2段階に切り替わる(各ランで切り替えの分は異なる)
-
センサーオフセット:真のレートは1つ、途中から増大するプローブ誤差を加える
可視の測定値と隠れた真実を分離する
Claudeは3本の冷却系列と、ツールが返すものだけを見ます。真のレートやしきい値、データ設定、確認用の測定値は、ツールアクセスの外側に置きます。
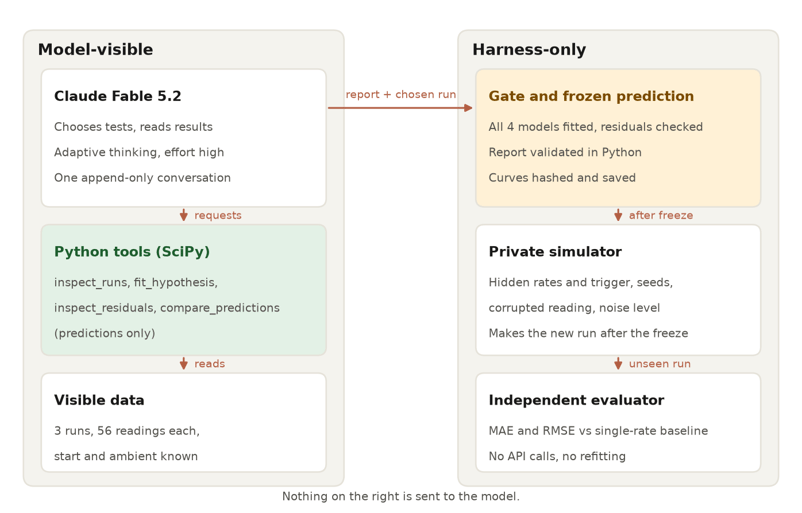
Claudeはツールにアクセスし、真実は隠したまま。画像:筆者作成。
ClaudeのまわりのPython一式がエージェントハーネスです。ツールの実行に加えて、要求数、時間、費用の上限も設けます(ツールループで説明します)。
最初のAPI呼び出し前に、候補モデル、パラメータ範囲、上限、そして新実験の合格基準を固定しました:RMSEが最大1.0 ℃、かつ単一レートのベースラインの半分以下。このルールは固定のままです。
PythonでClaude Fable 5.2をセットアップする
セットアップには仮想環境とAPIキーが必要です。claude-fable-5-2モデルは、最大100万トークンのプロンプトと履歴を読み、最大128Kの出力トークンを返せます。
モデルが回答前の推論量を自律的に調整する「適応的思考」は常に有効で、APIは既定で高い労力に設定されています。Claude APIの料金は入力100万トークンあたり$8、出力100万トークンあたり$40、5分間のプロンプトキャッシュ書き込みが$10、キャッシュ読み出しが$0.20です。
必要なもの:
-
Python 3.12+(NumPy 2.5.4とSciPy 1.18.1が要件。Anthropicパッケージ自体は3.10対応)
-
claude-fable-5-2へのアクセスを持つAPIキー -
anthropic2.7.0(このリリースでモデルIDが追加)
プロジェクトをクローンして固定の依存関係をインストールします。macOSやLinuxでは、python3.12 -m venv .venvで環境を作成し、source .venv/bin/activateで有効化、Copy-Itemはcpに置き換えてください。
git clone https://github.com/KhalidAbdelaty/claude-fable-5-2-api.git
cd claude-fable-5-2-api
py -3.12 -m venv .venv
.venv\Scripts\Activate.ps1
pip install -r requirements.txt
Copy-Item .env.example .env # then paste your key after ANTHROPIC_API_KEY=コードはAPIキーを環境変数から読み込み、表示しません。リポジトリのREADMEに実験一式のコマンドがあり、APIを呼ぶのはそのうち2つだけです。一般的なキーや課金についてはClaude APIガイドを参照してください。
最初のFable 5.2 APIリクエストを送る
以前にPythonからClaudeを呼んだことがあれば、この節は飛ばしてください。このリクエストは2つの仮説を分ける根拠に焦点を当てます。
import anthropic
from dotenv import load_dotenv
load_dotenv(".env", override=True)
client = anthropic.Anthropic() # reads ANTHROPIC_API_KEY
response = client.messages.create(
model="claude-fable-5-2",
max_tokens=4096,
output_config={"effort": "high"},
messages=[{"role": "user", "content": (
"Three cooling runs start at 80, 95, and 110 C. Each seems to slow down partway through. "
"In three short bullets: what pattern across the runs would point to a change after a fixed "
"time, what pattern would point to a change at a fixed temperature, and what the data alone "
"cannot tell us.")}],
)
print("block types:", [block.type for block in response.content])
print("stop reason:", response.stop_reason)
print("".join(block.text for block in response.content if block.type == "text"))Claudeは型付きコンテンツブロックのリストを返すため、テキストはブロック型で読んでください。content[0]は思考ブロックの場合があります。最初の返答は次のとおりです。
block types: ['thinking', 'text']
stop reason: end_turn
- **Fixed time:** the slowdown appears at the same elapsed time in all three runs but at different temperatures, with the hotter-start runs still hotter when it happens.
- **Fixed temperature:** the slowdown appears at the same temperature in all three runs but at different elapsed times, with the hotter-start runs reaching it later.
- **What the data cannot tell us:** the cause. A matching pattern shows what the change tracks, not why it happens (for example a phase change, a setup artifact, or a shift in the surroundings). Since cooling naturally slows as it nears room temperature, the data also cannot show on its own that there is a distinct change rather than a smooth curve.今回はthinkingとtextの両方のブロックが現れました。思考トークンも出力トークンとして課金されるため、コスト見積もりに含めてください。Claude Fable 5.2 移行ガイドによれば、budget_tokens、思考のdisabled、temperature、top_p、top_kは400エラーになります。
データ漏洩なしで冷却データセットを作る
データはモデル当てはめが必要な程度に雑であり、答えはClaudeの手の届かない場所に置く必要があります。
3本の冷却ランをシミュレートする
ニュートンの冷却則に基づき、冷却が連続的に変化していく隠れルールで3本のランをシミュレートしました。ランAは80 ℃(室温21.0 ℃)、Bは95 ℃(24.0 ℃)、Cは110 ℃(22.5 ℃)から開始します。固定のNumPy乱数生成器でガウスノイズを加え、1点だけ意図的に追加誤差を入れています。
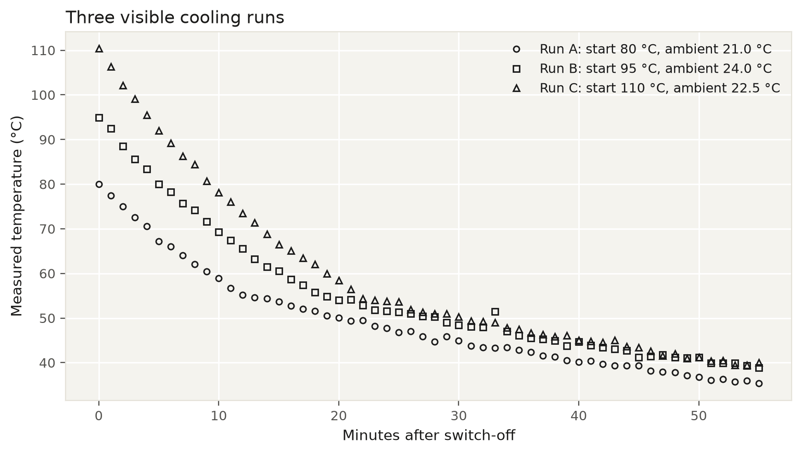
ノイズの多い3本のランに外れ値が1点含まれます。画像:筆者作成。
ランAは初期の方が後半より速く冷えます。指数関数は室温に近づくと自然に減速するため、このパターンだけでは不連続な変化を示しません。
ランBには約4 ℃の単発ジャンプがあり、他の箇所の隣接差は1.2 ℃未満に収まっています。各曲がりは数分にわたりノイズに埋もれるため、見た目だけでは時間切り替えモデルとしきい値モデルを分けられません。
Pythonツールで冷却仮説を検証する
Pythonは同一ルールの下で各候補モデルを当てはめ、パラメータと誤差を返します。Claudeは当てはめコード自体は見ず、各ツールの戻り値だけを見ます。
外れ値1点に支配されないよう共通パラメータを当てはめる
当てはめとは、予測曲線が測定値に近づくようにパラメータ値を選ぶことです。大きな誤差の影響を抑えつつ、その測定自体は残せるよう、ソフトL1損失を使います。
各ランの開始温度と室温は別々に持ちますが、当てはめるパラメータは全ランで共通です。しきい値モデルでは、各ランの切り替え時刻はln((T0 - Ta) / (threshold - Ta)) / k_aboveとなります。
SciPyのleast_squares()は最適な当てはめパラメータを探索し、パラメータ範囲でレートと切り替え点を事前に定めた範囲内に保ちます。
以下の抜粋はソルバー呼び出しと収束チェックを示します。残差関数とその周辺のグリッドスキャンはリポジトリを参照してください。
from scipy.optimize import least_squares
def _solve(hypothesis, names, x0, lo, hi, runs):
# soft L1: residuals under f_scale count roughly squared, larger ones roughly linearly
return least_squares(_residuals, x0, bounds=(lo, hi), method="trf",
loss="soft_l1", f_scale=0.5, args=(hypothesis, names, runs))
# scan the change point in 0.5 steps with the rates fitted at each step, then refine all three
res = _solve(hypothesis, names, best_grid_point, lo, hi, runs)
converged = bool(res.success and res.status > 0 and np.all(np.isfinite(res.x)))
at_bound = [n for n, v, a, b in zip(names, res.x, lo, hi) if min(v - a, b - v) < 1e-4 * (b - a)]実行前にf_scaleを0.5 ℃に設定しました。これより大きい残差はソフトL1のもとで影響が減り始めます。切り替え点のグリッドスキャンで、ソルバーに妥当な初期値を与えます。
Leave-One-Run-Outでモデルを検証する
MAEは平均の外し(℃)です。RMSEは誤差を二乗してから平均するため、大きい誤差の影響が増します。
学習誤差はパラメータが多いモデルに有利です。交差検証は、除外データを回し替えてホールドアウト誤差を見積もります。ここではLeave-One-Run-Out(LORO)で2本に当てはめ、残り1本を予測します。
Claudeのツール呼び出しスキーマを定義する
ツールスキーマは、Python関数とClaudeが送れる引数のJSON記述です。Strict tool useでは、Pythonが関数を実行する前にAPIがその形を検証します。
Claudeが呼べるツールは4つ:
-
inspect_runs:可視の測定値と簡単な傾きの要約を返す。 -
fit_hypothesis:1つの冷却モデルを当てはめ、パラメータとホールドアウト誤差を返す。 -
inspect_residuals:観測温度とモデル予測の差がどこで生じるかを示す。 -
compare_predictions:提案条件のもとで当てはめ済みモデルを比較する。
compare_predictionsのスキーマは、確認用の測定をツール外に保ちます。
{"name": "compare_predictions", "strict": True,
"description": "Predict a new run from existing fits under proposed conditions and report how far the "
"predictions differ. initial_temp_c must be 75 to 115 and ambient_temp_c 20 to 25. "
"Returns predictions only; no new measurements are generated.",
"input_schema": {"type": "object", "additionalProperties": False,
"properties": {"initial_temp_c": {"type": "number"},
"ambient_temp_c": {"type": "number"},
"fit_ids": {"type": "array", "items": {"type": "string"}}},
"required": ["initial_temp_c", "ambient_temp_c", "fit_ids"]}}fit_idsの値は、同じ調査内で以前に当てはめたモデルを指します。Strictスキーマはminimumやmaximumを受け付けないため、温度範囲の確認はPython側で行います。Fable 5.2ではツールの強制指定は400エラーになるため、tool_choiceは自動にしておきます。
Claudeのツールループを構築する
アプリケーションは1サイクルを繰り返します。会話をClaudeに送り、要求されたPythonツールを実行し、その結果を返す——必要な比較が終わるまで続け、最後に固定フォーマットの最終レポートを求めます。
仮説検証用のプロンプトを書く
システムプロンプトは、答えを示唆せず方法論だけを記述します。中核のプロンプトは次のとおりです。
SYSTEM = """You are a scientific investigator working on a controlled cooling experiment. You decide which
checks to run and how to read the results. Python tools do every numerical calculation.
How to work:
- Look at the measurements before you choose a model.
- Fit every candidate model with fit_hypothesis. Compare them on leave-one-run-out error as well as
training error, because a model with more parameters always fits the training runs at least as well.
- Use inspect_residuals to look for systematic patterns and to decide whether any single reading is
an outlier.
- Use only numbers that a tool returned. Do not invent measurements, parameters, or errors.
- Keep observed evidence separate from assumptions. The data can show which mathematical model fits
best; it cannot show the physical cause of a change.
- If the evidence does not separate the candidates, say so and treat the result as inconclusive.
..."""最も重視しているのは最後の箇条です。これがないと、誤差が拮抗している場合でも勝者を選ばざるを得なくなります。
ツールループは追記専用で保つ
毎回同じsystemとtoolsを送り、各応答はそのまま返します。以下はメッセージ処理の抜粋で、停止処理を含む完全版はリポジトリにあります。
resp = client.messages.create(
model="claude-fable-5-2",
max_tokens=20_000,
system=SYSTEM,
tools=TOOLS, # all four, declared on the first request
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
cache_control={"type": "ephemeral"}, # automatic prompt caching
messages=messages,
)
messages.append({"role": "assistant", "content": resp.content}) # unchanged, thinking included
if resp.stop_reason == "tool_use":
results = []
for block in resp.content:
if block.type == "tool_use":
out, is_error = box.run(block.name, dict(block.input))
results.append({"type": "tool_result", "tool_use_id": block.id,
"content": out, "is_error": is_error})
messages.append({"role": "user", "content": results})Preserved thinkingにより、system、tools、および過去のメッセージを変更しない限り、Claudeはターンをまたいで先の推論を保持できます。Fable 5.2では、これらのいずれかを編集すると既定で400エラーになります。
呼び出し間でoutput_config、tool_choice、max_tokensは変更できますが、新しい出力フォーマットはプロンプトキャッシュを利用できません。並列ツール結果は、上のループのように1つのユーザーメッセージにまとめましょう。
リクエスト・時間・費用の上限を設ける
Pythonはリクエスト数、ツール呼び出し数、経過時間、費用をカウントし、上限到達後は新規作業を開始しません。進行中のリクエストは時間や費用の上限を超える可能性があるため、この2つはソフトリミットとして扱います。
最終回答を受け入れる前に、Claudeが全候補を当てはめ、残差を確認し、確認実験の比較を行ったかもPythonがチェックします。Claudeがツール要求やターン終了以外の理由で停止した場合、調査は「結論不十分」で終了します。思考と回答の両方を出せるよう、max_tokensは十分大きく設定してください。
構造化レポートを返す
チェック通過後、同じ履歴に対して構造化出力を要求し、検証済みのPythonオブジェクトとして最終レポートを受け取ります。
messages.append({"role": "user", "content": REPORT_PROMPT})
resp = client.messages.parse(
model="claude-fable-5-2", max_tokens=20_000, system=SYSTEM, tools=TOOLS,
thinking={"type": "adaptive", "display": "summarized"},
output_config={"effort": "high"},
output_format=InvestigationReport, # the SDK sends this as output_config.format
tool_choice={"type": "none"}, # tools stay declared, so the prefix check passes
messages=messages,
)
problems = validate(resp.parsed_output, box.fits) # fit IDs exist, all four covered, ranges holdPydanticがレポートの形を検証し、validate()が引用された当てはめが存在すること、全候補が網羅されること、条件が許容範囲内であることを確認します。その後、モデル選択と条件は確定です。
Fable 5.2は温度しきい値モデルを選択
1回の調査をhighの労力で走らせました。Claudeがどうやって答えに至ったかを見ていきます。
Claudeの検証シーケンスを追う
Claudeは測定の点検から始めました。当てはめの前に出した要約はこうです:「変化はどのランでもおよそ55 ℃で現れる:Aでは12分、Bでは19分、Cでは22分。しきい値が示唆されるので4候補すべてを当てはめる」。
これは「確証バイアス寄り」と言えるでしょう。Claudeは検証前に答えを心に決めています。後の当てはめ結果は、切り替え時刻が12、18、22分付近で一致しました。端末のログには残りのチェックの順序が出ています。
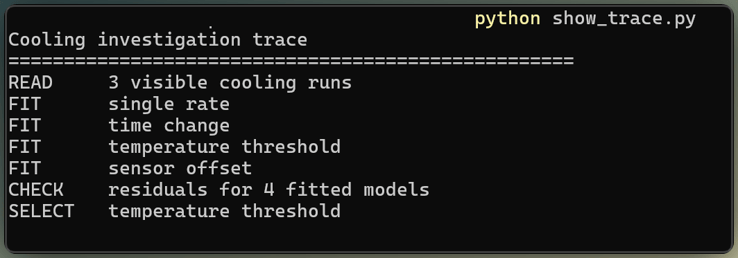
ターミナルログに検証順序が表示。画像:筆者作成。
4モデルのホールドアウト誤差を比較する
学習RMSEは3本すべてに対する当てはめの良さを測ります。ホールドアウト列は3回のLOROの平均です。
|
候補 |
主仮定 |
学習RMSE (℃) |
ホールドアウトMAE (℃) |
ホールドアウトRMSE (℃) |
|
単一レート |
全期間でレート1つ |
4.08 |
3.90 |
4.60 |
|
時間切り替え |
共通の切り替え時刻(約19分) |
1.92 |
2.17 |
2.63 |
|
温度しきい値 |
共通のしきい値(約55 ℃) |
0.49 |
0.32 |
0.48 |
|
センサーオフセット |
測定ドリフトの増大 |
1.49 |
1.45 |
1.87 |
しきい値モデルでは、学習とホールドアウトの誤差が近く、ランをまたいでも当てはまりが保たれています(ただし3本だけでは過学習の一般論は否定できません)。下の残差図は観測温度から各モデルの予測を引いたものです。
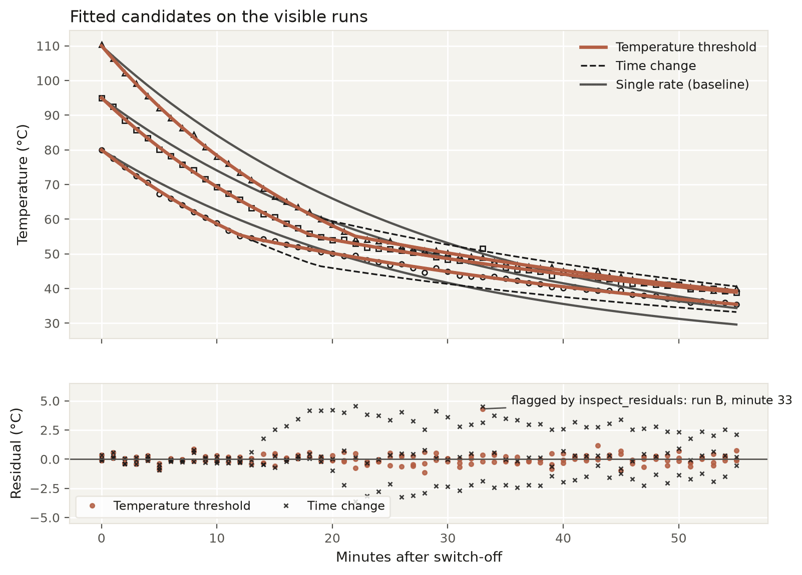
しきい値モデルの残差に系統的パターンは見られません。画像:筆者作成。
時間切り替え当てはめはランBに合いますが、切り替え後はランAを+2.5〜+3.5 ℃程度、ランCを-1.5〜-2.8 ℃程度外します。
順位だけより符号の違いが有用です。Aで早く、Cで遅く切り替わることを示し、温度トリガーの予測と一致します。センサーオフセットモデルはドリフトの追加で一部誤差を減らしますが、ホールドアウト誤差は依然として大きいままです。
破損した読み取りを確認する
エージェントはどの読み取りを破損させたか知りません。ランBの33分目に約+4.3 ℃の残差を検出しました。ロバストなzスコア(典型的な残差の広がりからの距離)は12を超えていました。
ソフトL1で影響が抑えられているため、Claudeはこの読み取りを残しました。確認のため、この点を除いて4モデルを再当てはめしましたが、しきい値モデルは大差で首位のまま、しきい値推定もほとんど動きませんでした。
確認実験を設計する
エージェントは複数の開始温度と室温で候補予測を比較し、新たな測定を見ることなく条件を選びました。
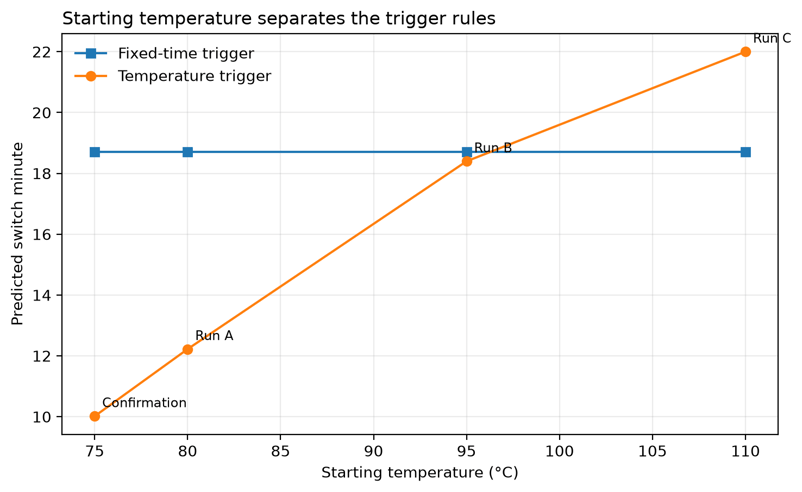
開始温度が各トリガールールをあぶり出します。画像:筆者作成。
モデルを分離できる条件を選ぶ
TL;DRでも述べたとおり、エージェントは開始75 ℃、室温20 ℃を選びました。しきい値モデルは約10分で切り替わり、時間モデルは約19分で切り替わります。センサーオフセットの曲線も、しきい値予測と分離されています。
ランBに近い中間的な条件では、しきい値と時間モデルの差は約0.6 ℃にしかなりません。選択した条件はテスト済み範囲のわずか外側に位置し、Claudeはレポート内でその点に言及しました。
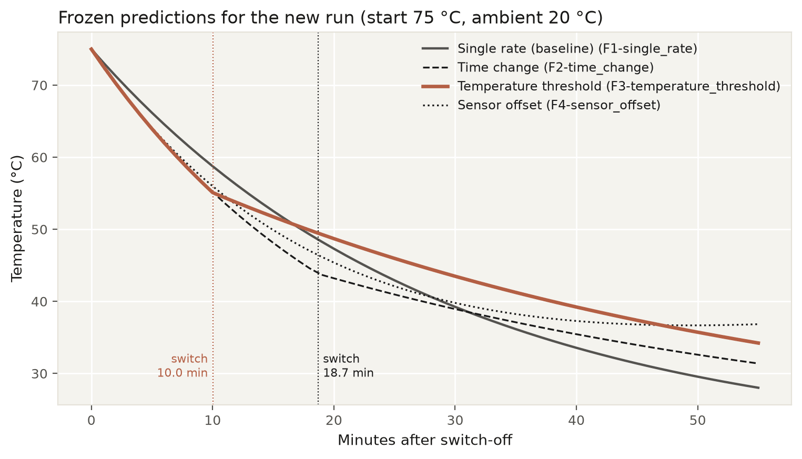
選択条件に対する候補予測。画像:筆者作成。
データ生成前に予測をロックする
新たな測定を生成する前に、選んだ条件、当てはめパラメータ、各候補の予測を凍結しました。エージェントは確認測定を受け取らず、結果を見た後に回答を修正することもできません。
確認用の測定は同じガウスノイズモデル、別の固定シード、外れ値なしで生成します。
未観測ランを採点する
凍結済み予測の採点は独立したPythonコードで行いました。APIは呼ばれないため、Claudeが自分の答えを採点することはありません。
独立したPythonで予測を採点
しきい値予測は、事前に定めた2つのテストをともにパスしました。未観測ランでのスコアはMAE 0.27 ℃、RMSE 0.32 ℃。固定時間はRMSE 3.67 ℃、センサーオフセットは2.35 ℃、単一レートは4.28 ℃でした。
確認ランには意図的な外れ値がないため、LORO結果と比べて誤差が小さい一因と考えられます。別のランダムノイズ標本も影響している可能性があります。
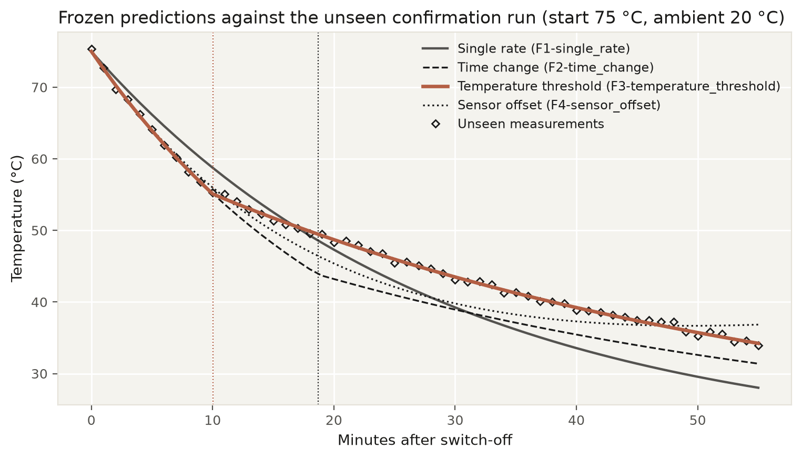
凍結予測は未観測の測定と一致。画像:筆者作成。
当てはめパラメータを隠れた真値と比較する
採点後、当てはめパラメータを生成側の真値と比較します。
import numpy as np
def true_curve(t0, ta, minutes, truth):
"""Newton cooling whose rate drops when the temperature crosses a threshold. Continuous at the switch."""
t = np.asarray(minutes, dtype=float)
k1, k2, th = truth["k_above"], truth["k_below"], truth["threshold_c"]
if t0 <= th:
return ta + (t0 - ta) * np.exp(-k2 * t)
t_cross = np.log((t0 - ta) / (th - ta)) / k1
fast = ta + (t0 - ta) * np.exp(-k1 * t)
slow = ta + (th - ta) * np.exp(-k2 * (t - t_cross)) # restarts from the threshold
return np.where(t <= t_cross, fast, slow)シミュレーターはこの曲線の周りにシード付きガウスノイズを加えます。
隠れたルールは55 ℃の温度しきい値で、レートはそれぞれ1分あたり0.045と0.020、ノイズの標準偏差は0.35 ℃でした。
当てはめたレートは小数点第3位まで一致し、しきい値は0.1 ℃以内、切り替え時刻の予測も0.1分以内でした。
データが特定するのは、シミュレーターが用いた数理ルールです。実機が55 ℃付近で遅くなるとして、その原因が相変化なのかファンの周期なのか周囲の変化なのかまでは示せません。
エージェントが答えに至った過程を振り返る
レポートは、根拠として当てはめIDやツール番号を挙げ、3本のランでは立証できない点も明記していました。弱点は前述の初期推測です。単発の調査だけでは、その種の推測がどれほど外れるかは示せません。
Streamlitで調査を見る
動画ではライブ実行を開始し、ツールログを追い、採点後にReport、Curves、Confirmation、Costタブを開いています。
Streamlitインターフェースで1件の調査を表示。動画:筆者作成。
Claude Fable 5.2 APIのコストを測る
調査(最終レポート含む)の費用は約$0.49、所要時間は1分強でした。SciPyはローカルで動くため、APIの請求には影響しません。
レポート要求だけで、費用と時間のおよそ半分を占めました。ツールループの節でも述べたように、新しい出力フォーマットはプロンプトキャッシュを外すため、最後のリクエストは長いレポートを書き出す前に会話全体を再処理しました。キャッシュなしの入力、キャッシュ書き込み、キャッシュ読み出し、出力はそれぞれ価格が異なるため、個別にトラッキングしてください。
制約と実務上の注意
ここで重要なのは2種類の制約です。実験で示せることと、コードがサービスとして動くために必要なことです。
科学的な制約
シミュレーターとしきい値候補は同じ式を使います。実機での緩やかな切り替えは、別の曲線に従いつつ、このモデルにも当てはまる可能性があります。
真のルールが候補に含まれていない場合でも、エージェントはinconclusiveではなく最も近い供給モデルを選ぶかもしれません。ノイズが多い、あるいはしきい値がかろうじて跨がれる程度だと、誤差が似通いすぎて分離できないことがあります。別の実行ではツールの順序が異なる可能性もあります。
本番前に
ツールループの制約は、ローカルでの1件の調査をカバーします。本番サービスにはさらに以下が必要です。
- SDKのリトライとリクエストタイムアウトを設定する
- すべてのツールの入出力をPythonで検証する
- 各リクエストのモデル、SDKバージョン、停止理由、トークン、レイテンシ、コストを記録する
- モデルとSDKのバージョンを固定し、隠しテストを再実行し、アップグレード前に30日間の保持ポリシーを確認する
このパターンが向いているとき
複数の説明が成り立ち、Pythonで検証でき、隠し実験で選択を採点できる場合に、このパターンを使ってください。特に次の実験コストがAPI呼び出しより大きいときに有効です。
モデル族がわかっているなら素のPythonで十分です。AnthropicのFable 5.2ガイダンスは、まずOpusを試し、要件を満たせない場合にFableを検討することを推奨しています。
まとめ
4つの冷却モデルを比較し、温度しきい値を選び、確認ランを設計し、未観測の測定を予測するエージェントを構築しました。この合成デバイスに関しては、冒頭の問いの答えは「はい」です。
ただし、これを実機やオープンエンドの探索にまで拡張するつもりはありません。制約の節で述べたとおり、候補にはシミュレーター自身の式が含まれており、実行は1回だけです。
汎用化できるのは手法です。真実を隠し、最初のリクエスト前に採点ルールを設定し、予測を凍結し、別の評価器を使う。次の有用なテストは、緩やかな遷移モデルを追加し、異なるノイズ水準で調査を繰り返すことです。
モデル選択については、当社のClaudeモデル入門コースでClaudeのラインアップとトレードオフを解説しています。
FAQs
Claude Fable 5.2で思考をオフにしたり、思考予算を設定できますか?
いいえ。適応的思考は常に有効で、thinking: {type: "disabled"}やbudget_tokensは400エラーになります。制御したい場合は既定でhighのeffortパラメータで調整してください。思考トークンは出力として課金され、max_tokensに算入されます。
以前のメッセージを編集すると、なぜClaude Fable 5.2が400エラーを返すのですか?
各思考ブロックは、それ以前のsystemプロンプト、tools、メッセージに対してのみ有効であり、Fable 5.2はこれを毎回チェックします。会話は追記専用に保ち、セッション中のsystemとtoolsは固定してください。当座の回避策として、ベータヘッダーでprefix_mismatch_behaviorを"drop_block"に設定すると、失敗の代わりに該当ブロックを落とします。
Claude Fable 5.2に特定のツール呼び出しを強制できますか?
いいえ。tool_choiceをanyや特定のツール名に設定すると400エラーになります。autoとnoneのみ動作します。指示文でツール名を述べ、strict: trueを設定して呼び出しがスキーマに一致するようにしてください。呼び出しを必須にする場合は、会話途中のsystemメッセージを使います。
Claude Fable 5.2がリクエストを拒否した場合はどうなりますか?
応答はstop_reason: "refusal"で戻り、stop_details.categoryにどのセーフガードが発動したかが示されます。自分で別モデルでリトライするか、サーバー側フォールバックのベータであるfallbacks: "default"にオプトインすると、Claude Opus 4.8またはClaude Opus 5で再試行します。フォールバック先のモデルはFable 5.2の思考ブロックを受け取りません。
データ保持ゼロでClaude Fable 5.2を使えますか?
既定ではできません。Fable 5.2は30日間のデータ保持を要件としており、これがない組織またはワークスペースからのAPIリクエストは400エラーになります。ZDRの取り決め下では、ワークスペースに30日保持を有効化するか、Anthropicのアカウントチームに連絡してください。
この実験のツールループをBatch APIで置き換えられますか?
いいえ。各ツールのステップは前段の応答を必要とするため、Batch API でこのループを直接置き換えることはできません。50%割引は独立したリクエストや並列評価に向いています。
LLMは、あたかも論理的に考えて答えに到達したかのように聞こえるのが得意です。実際にそうしたかどうかを確かめるのは難しいのが現実です。多くのタスクでは、モデルは過去に似たものを見ているか、誰も答えを検証できません。そこで、答えを隠したままにできるテストを作りました。
Claude Fable 5.2 は、電源を切った後に冷えていくシミュレート装置からノイズの多い測定値を受け取り、途中で冷却が遅くなる理由として考えられる4つの説明を与えられます。1つを選び、追試実験を設計し、新たな測定を1つも見る前に予測を確定しなければなりません。別のPythonコードがその予測を採点し、Claudeがそれに触れることはありません。
冷却装置はあくまでテストケースです。重要なのはセットアップです。真実をモデルから隠し、最初のAPI呼び出し前に採点ルールを固定し、予測を凍結し、モデルが見えないコードで採点します。これは「どの説明が正しいか?」という問題に汎用的に使え、原因分析からA/Bテストの読み解きまで応用できます。
このチュートリアルでは、そのエージェントをPythonで構築します。数値計算はSciPy、どの検証を次に走らせ何を結論づけるかはClaudeが決めます。Pythonの関数とAPIリクエストに慣れていれば追えますし、冷却の数式は初登場の箇所で説明します。扱う内容は次のとおりです。
当社のClaude Fable 5.2 概要ではリリースとベンチマークを取り上げています。本稿ではAPIと冷却テストに絞ります。実験はローンチ翌日に実施しました。
TL;DR
途中で冷却が遅くなるシミュレート装置のノイズ付きデータと、考えられる4つの説明をFable 5.2に与えました。1つを選び、新しい実験を設計し、結果を見る前に予測を確定する課題です。