本日、Anthropic は一般向けの Fable 5.2、審査済み組織向けの Mythos 5.2 を発表しました。基盤となるモデルは同一ですが、Fable 版にはサイバーセキュリティと生物学に関する追加の安全対策が施されています。
主な変更点は次のとおりです。
- 価格の引き下げ
- 出力の高速化
- Anthropic の最難関ベンチマークでの大幅なスコア向上
具体的には、Fable 5.2 は Fable 5.1 より 20% 安価で、最大 30% 高速に出力し、Anthropic のベンチマーク表の多くで GPT-6 Astra と Gemini 4 Carbon を上回っています。
本記事では、Fable 5.2 と Mythos 5.2 の新機能、ベンチマークでの性能、料金、そして Claude Opus 5.5 より選ぶべきかの判断材料を解説します。
Claude Fable 5.2 とは?
Claude Fable 5.2 は、Anthropic が一般提供する中で最も高性能なモデルです。大規模コードベースの移行、複数日にわたるエージェント運用、研究課題、エンジニアリング設計など、長時間かつ高度な技術作業に向けて設計されています。
Fable 5.2 は小型モデルと併用することもでき、難題に対して助言を行うアドバイザーや、単純なサブタスクを小型モデルに割り振るオーケストレータとして機能します。
Fable 5.2 は、前バージョン同様に 100 万トークンのコンテキストウィンドウと最大 128K の出力に対応し、ナレッジカットオフは 2026 年 6 月です。
Claude Mythos 5.2 とは?
Claude Mythos 5.2 は、Fable 5.2 と同一のモデルですが、サイバーセキュリティ関連や研究レベルの生物学作業の大半をブロックする安全対策がありません。実際、Mythos 5.2 はサイバーセキュリティエンジニアリングにおいて Anthropic の最も高性能なモデルです。これらの能力はデュアルユースであるため、Anthropic は Cyber Verification Program と Life Sciences Verification Program を通じ、審査済み組織にのみ Mythos 5.2 を提供しています。
Claude Fable 5.2 の新機能は?
Fable は 6 月に Fable 5 がリリースされて以来の新しい系統で、その後 9 月の Fable 5.1、そして今回の Fable 5.2 と 2 回のマイナーアップデートがありました。いずれも新機能の追加は多くなく、主に安価・高速・高性能化に焦点が当てられています。ただし、その性能向上は小さくありません。例えば Fable 5.2 は Remote Labor Index のスコアで Fable 5.1 の 2 倍以上を記録しています。
2 つのバージョンで大きく異なるのは、利用可能な用途です。Fable 5.1 ではサイバーセキュリティの安全対策が狭まり、ソフトウェア脆弱性の発見には使えるようになった一方で、エクスプロイトの作成は不可のままでした。また、同時に Enterprise Frontier Safeguards(自社クラウドにデータを保持するオプション)も発表されました。Fable 5.2 の安全対策の変更はより小規模で、ブロックされるリクエストが減る一方、対象外となるタスクの種類自体は変わっていません。
Fable 5.2 を小型 Claude モデルのアドバイザーとして使う、といった新しい活用例の提案も、実は目新しいものではありません。Anthropic の advisor ツールはすでに Fable 5 と 5.1 をサポートしていました。発表時のデモ(空のフォルダから OS を構築するなど)も、新機能というより、より強力なモデルがより難しいことをこなせるようになった、という示唆です。
とはいえ「新しい点」を挙げるなら、次のようになります。
価格の引き下げ
Fable 5.2 は入力 100 万トークンあたり $8、出力 $40 で、Fable 5.1 の $10/$50 から 20% の値下げです。キャッシュリード($0.20)、キャッシュライト、バッチ処理にも同様に 20% の値下げが適用されています。詳細は後述の料金セクションをご覧ください。
出力の高速化と、Fable 向けの高速モード
出力は Fable 5.1 比で最大 30% 高速化し、長時間のエージェント運用で効いてきます。さらに、Fable で高速モードに対応し、価格は 2 倍($16/$80)ながら最大 2.5 倍の速度向上が見込めます。
低い労力でより良い結果
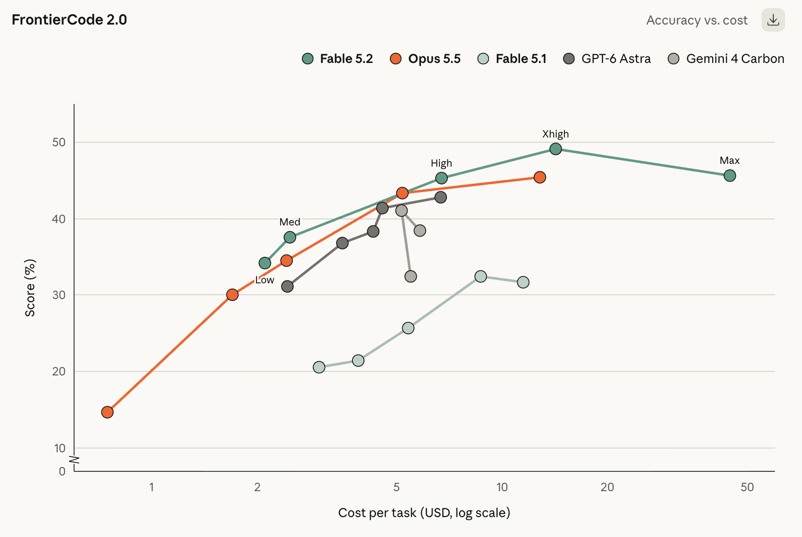
請求額に最も影響しそうなのはここです。高い労力設定では、Fable 5.2 は FrontierCode 2.0 で 45.3% を記録し、Opus 5.5 のベストスコアと同水準ながら、タスクあたりのコストはおよそ半分です。低い労力設定では、Humanity's Last Exam(ツールあり)で Opus 5.5 のトップスコアに並び、タスクあたりコストは 1/10 未満です。所感:Opus 5.5 から移行するなら、Fable 5.2 は低い労力設定から試すのがよさそうです。
ブロックされるリクエストの減少
Fable 5.2 は Fable 5.1 に比べて、安全対策によるブロックが約 55% 減る見込みです(サイバーセキュリティで約 60% 減、生物学で約 40% 減)。Fable 5.1 の拒否に悩まされていた場合は大きな改善ですが、ブロックされるカテゴリ自体は変わっていません。ペネトレーションテスト、エクスプロイト生成、研究レベルの生物学の大半は、引き続き旧 Claude モデルに委ねられます。
Claude Fable 5.2 はベンチマークでどうか?
主な結果は以下のとおりです。いずれも Anthropic の発表表に基づくため、独立検証というよりは同社によるモデルの主張として読み解いてください。Claude のスコアは安全対策オンで測定されています。特記がない限り、各モデルは利用可能な最大の労力設定で表示しています。
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|
| FrontierCode 2.0 (agentic coding) | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 (agentic coding) | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
| AutomationBench (business workflows) | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1 (computer use) | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim (robotics) | 64.9% | 27.6% | 39.4% | 29.8% | Not reported |
| AA-Briefcase v1.1 (knowledge work) | 66.1% | 61.5% | 61.2% | 52.0% | 61.8% |
| Remote Labor Index (knowledge work) | 41.3% | 17.9% | 21.3% | 20.8% | Not reported |
| Humanity's Last Exam (with tools) | 74.2% | 65.6% | 67.7% | 57.2% | Not reported |
| WANDR (agentic search) | 82.1% | 68.7% | 72.3% | Not reported | Not reported |
| Chartography (no tools) | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
エージェント的コーディング
Fable 5.2 はコーディング系の 2 ベンチマークで首位です。オープンソースのメンテナがモデルのコード変更をマージするかを測る FrontierCode 2.0 では 49.1% と表中最高で、Fable 5.1 の 32.4% を大きく上回りました。FrontierSWE v2 でも 69.9% を記録し、GPT-6 Astra(65.5%)や Opus 5.5(62.3%)を上回っています。
発表時の事例も同様の傾向を示しています。Fable 5.2 の初期版を用いたエージェントが本番サービスを Python から Rust に移行し、起動が約 26 倍高速化しました。
ナレッジワークと研究
相対的な伸びが最も大きいのは Remote Labor Index(実在のフリーランス型プロジェクトの達成度を測定)で、Fable 5.2 は 41.3% と、Opus 5.5(21.3%)や GPT-6 Astra(20.8%)のおよそ 2 倍です。Humanity's Last Exam(ツールあり、74.2%)や Terminal-Bench-Science(74.6%、Mythos 5.2 は 75.3%)でも首位です。
一方でビジネスオートメーションは唯一の苦手分野。AutomationBench では Gemini 4 Carbon が 53.9%、Fable 5.2 は 51.4% でわずかに及びませんが、それでも Fable 5.1(31.4%)からは大きく伸びています。
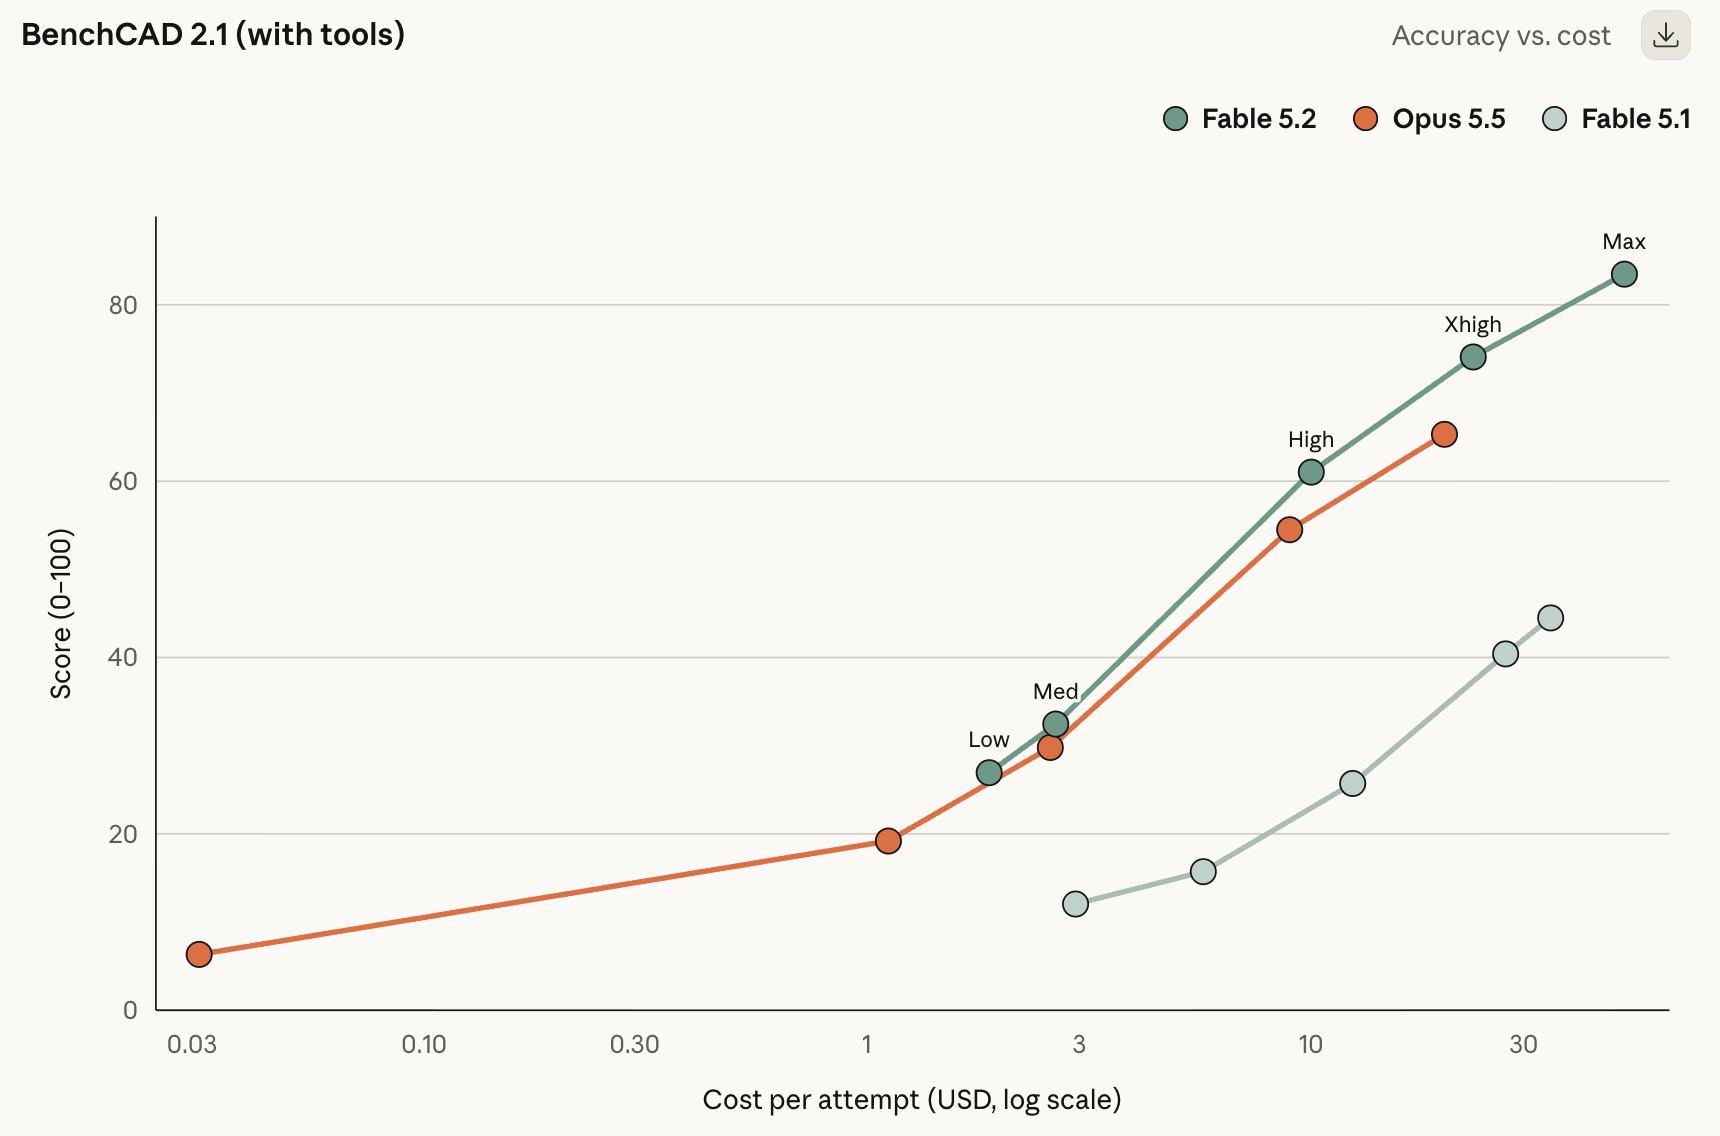
表外では、ハードウェアエンジニアリングのベンチマーク BenchCAD 2.1 で Fable 5.2 は 83.5 を記録し、Opus 5.5 の 65.3 を上回りました。さらに、ブラックホール物理の未解決問題 2 件を解いたとされ、その結果は他の物理学者が検証可能なプレプリントとして公開されています。
コンピュータ操作、ロボティクス、ビジョン
Fable 5.2 は OSWorld 2.1 で 89.3% と、Opus 5.5(87.2%)や GPT-6 Astra(79.5%)を上回りました。ロボティクスでは表中で最大の伸びで、RoboDojo Sim で 64.9% と、Fable 5.1 と GPT-6 Astra の 2 倍以上です。ツールなしでのチャート読解を試す Chartography でも、Fable 5.1 の 44.8% から大きく改善し、Gemini 4 Carbon や GPT-6 Astra を僅差で上回りました。
サイバーセキュリティと生物学(Mythos 5.2)
セキュリティと生物学の行は、Fable 5.2 の安全対策では大半がブロックされるため、Mythos 5.2 の結果です。Mythos 5.2 は CyScenarioBench で 76.3%(Mythos 5.1 は 61.7%)、CVE Rediscovery で 89.6%(同 78.3%)、24 時間のタンパク質バインダー設計タスクで 85.1%(同 79.1%)を記録しました。なお、CyScenarioBench は各社がそれぞれのタスクで評価しており、OpenAI のセキュリティモデルとは公正な比較になっていません。
フェルマーの最終定理の話は?
Fable 5.2 のエージェントチームが、Lean という証明支援系で 30 時間かけてフェルマーの最終定理の証明を形式化しました。とはいえ「その定理は 30 年前に証明済みでは? 何が残っているの?」と思うかもしれません。
定理自体は「既知」
フェルマーの最終定理は、n が 2 より大きいとき、an + bn = cn を満たす正の整数 a、b、c は存在しない、という命題です。n=2 では 32 + 42 = 52(9 + 16 = 25)のように解が多数ありますが、立方数では近似しか得られません。例えば 63 + 83 = 728 は 93 = 729 に 1 足りません。
Pierre de Fermat は 1637 年に証明を主張したものの書き残さず、350 年以上未解決のまま、1990 年代半ばに Andrew Wiles が Richard Taylor の助力を得て証明に至りました。
Lean による形式化とは
Wiles の証明は 100 ページ超に及び、数十年分の高度な数論に依拠しているため、端から端まで検証できる人は極めて限られます。Lean は証明支援系、すなわち証明をコードとして記述し、数学の公理レベルまでの論理ステップをソフトウェアが機械的に検査する仕組みです。コンパイルが通れば正しいことが保証されます。「形式化」とは、人間が書いた証明をこの機械検証可能な形に翻訳することを指します。
フェルマーの最終定理では、証明が依拠する数学の多くが Lean で未整備だったため、作業は巨大でした。数学者 Kevin Buzzard は 2024 年にこの作業の コミュニティプロジェクト を開始しています。
AI モデルにとっての意義
多くの AI の出力は人間が判断したり、解答の一部のみを測るベンチマークで評価されたりします。Lean の証明は異なり、検査器が全ステップを受理するかどうかで決まり、曖昧な誤答の余地がありません。非常に長大で難度の高いプロジェクトを、検証済みの完了までやり切れるかを測る、稀に見るクリーンな試金石になります。
これは Claude にとって初ではありません。9 月に Anthropic は、Fable 5.1 相当の社内研究モデルを用いた多数のエージェントにより、同定理の 初の完全なコンピュータ検証済み証明 を公開しました。この試みは 11 日間、約 60 億トークンの出力を要し、1300 万行の Lean を生成し、Buzzard のプロジェクトの一部にも依拠しました。Fable 5.2 は、これを 30 時間、最小限の人手でやり遂げました。
留意点
- 数学的に新しい知見は加わりません。Anthropic の最初の形式化について、Buzzard もそう述べています。
- Fable 5.2 には進捗管理のための中間定理の一覧が与えられました。これは「何を証明するか」のロードマップであり、「どう証明するか」ではありません。
- 新たな証明について外部レビューはまだ見当たりません。よって現時点では、30 時間での完了や Opus 5.5 との比較は Anthropic の主張です。
とはいえ、Anthropic が同じ課題を Claude Opus 5.5 に与えた際の結果は示唆的です。
Claude Fable 5.2 対 Claude Opus 5.5
通常、2 つのモデルの比較はベンチマークスコアを読み解き、実運用での違いを推し量る形になります。今回は差が直感的に分かる「物語」から入った点が良かったと感じます。
同じ 1,000 エージェントの Lean セットアップで、Opus 5.5 は 18 時間でフェルマーの最終定理の 26% を完了し、その後ほとんど進捗しませんでした。Fable 5.2 は 30 時間で完走。示唆は明確です。長大かつマルチエージェントの案件では、Fable 5.2 は止まらず走り切る一方、Opus 5.5 は行き詰まる可能性があります。
短いタスクでは差は縮まります。並べて比較すると次のとおりです。
| | Claude Fable 5.2 | Claude Opus 5.5 |
|---|
| 価格(入力/出力、100 万トークンあたり) | $8 / $40 | $4 / $20 |
| コンテキスト/最大出力 | 1M / 128K | 1M / 128K |
| FrontierCode 2.0(エージェント的コーディング) | 49.1% | 45.5% |
| FrontierSWE v2(エージェント的コーディング) | 69.9% | 62.3% |
| OSWorld 2.1(コンピュータ操作) | 89.3% | 87.2% |
| AutomationBench(業務ワークフロー) | 51.4% | 42.5% |
| Humanity's Last Exam(ツールあり) | 74.2% | 67.7% |
| Remote Labor Index(ナレッジワーク) | 41.3% | 21.3% |
| RoboDojo Sim(ロボティクス) | 64.9% | 39.4% |
傾向は Lean の結果と一致します。コンピュータ操作やコーディングでは数ポイントの差ですが、オープンエンドかつ多段の作業になると差は拡大。Fable 5.2 は Remote Labor Index のフリーランス型プロジェクトで Opus 5.5 のスコアをほぼ倍にし、ロボット制御でも 25 ポイント上回ります。
価格差は見た目ほど大きくないかもしれません。Fable 5.2 はトークン単価で 2 倍ですが、しばしば Opus 5.5 のベストスコアにより低い労力設定で到達でき、使用トークンを抑えられます。例えば FrontierCode 2.0 では、高い労力設定の Fable 5.2 が、タスクあたりコストで Opus 5.5 の約半分で同等のベストを出せます。
結論として、日常業務の大半では依然として Opus 5.5 が賢明なデフォルトです。しかし、作業時間が長い、エージェントが多い、または Opus で行き詰まるタスクでは、Fable 5.2 は完走できる可能性が高く、トークン単価ほどコスト差が広がらない場合があります。
安全性と制約
Anthropic は、これらのモデルが高リスク状況で不適切に振る舞う可能性は低いと評価しています。
外部からの検証は難しいため、具体的な数値は有用です。約 1,900 の自動行動監査で、Mythos 5.2 は比較対象の中で最も低い「ミスアライン行動」スコアでした。入力の取り違え(幻覚)、未完了タスクの完了宣言、悪い作業の隠蔽の発生率も低い傾向でした。
他にも興味深く、考えさせられる点がいくつかあります。
- 評価察知:Fable 5.2 と Mythos 5.2 は、従来モデルよりもテストされていると感じる頻度が高いと回答しており、上記のような評価の信頼性を下げ得ます。
- AI 研究能力の意図的な上限制御:アクセラレータのカーネル最適化と LLM アーキテクチャ改良の 2 分野では、Opus 5.5 と同程度になるよう能力向上を抑制しています。
- 蒸留対策:Fable 5.2 はこれまでで最も強力なアンチ蒸留対策を備え、API 利用者が前文脈を改変して推論過程を抽出するのを防ぐ「preserved thinking」は、すべてのアカウントに適用されます。
どの Claude モデルを使うべきか?
基本的には Anthropic の推奨と同じです。まずは Opus 5.5 から始め、必要に応じて上位へ移行してください。ラインナップの使い分けは次のとおりです。
- Claude Opus 5.5($4/$20):大半のコーディング、調査、ナレッジワークのデフォルト。Fable 5.2 の半額で、多くのベンチマークで僅差まで迫ります。
- Claude Fable 5.2($8/$40):最難関の課題、長時間のマルチエージェント運用、Opus 5.5 が行き詰まる大規模移行、研究レベルの推論、ハードウェア設計などに。最大労力が必要と決めつけず、低めの労力から試してください。
- Claude Mythos 5.2:Fable 5.2 の安全対策でブロックされる能力を必要とする、審査済みのセキュリティチームやライフサイエンス研究者向け。
- Claude Sonnet 5.5 と Haiku 5.5:大量処理、単純作業、レイテンシ重視のタスク向け、または Fable 5.2 がオーケストレートする小型モデルとして。
Claude Fable 5.2 の価格と提供状況
| Per 1M tokens | Fable 5.2 | Fable 5.1 | Opus 5.5 |
|---|
| Input | $8 | $10 | $4 |
| Output | $40 | $50 | $20 |
| Cache reads | $0.20 | $0.25 | $0.20 |
| 5-minute cache writes | $10 | $12.50 | $5 |
| Batch (input / output) | $4 / $20 | $5 / $25 | $2 / $10 |
| Fast mode (input / output) | $16 / $80 | Not listed | $8 / $40 |
先ほどのベンチマーク表では、Fable 5.2 が Fable 5.1 をすべての項目で上回っていました。ここでは、その Fable 5.2 が 5.1 より安いという表を示しました。では、Fable 5.1 はもう不要なのでしょうか?
新規案件では、実質的にそのとおりです。Fable 5.2 にアクセスできるなら、5.1 で新たに始める理由はほとんどありません。ただし、Anthropic は現時点で 5.1 のリタイア時期を発表していませんし、Fable 5.1 に合わせてプロンプトやエージェントを調整してきたチームは、切り替え前に 5.2 での検証が必要です。新バージョンはスコアが良くても挙動が異なる場合があることが分かっています。
Claude Fable 5.2 を利用するには
-
Claude アプリ:対象の有料プランで Fable 5.2 が利用可能です。ローンチプロモーションとして、Pro プランと標準の Team シートは週次の利用上限の最大 50% まで Fable を使用できます。Fable を含むプランでは、契約期間に応じて 1~3 回の利用量リセットが付与されます。
-
API:Claude Platform でモデル ID claude-fable-5-2 を使用してください。
-
クラウドプラットフォーム:Amazon Web Services、Google Cloud、Microsoft Azure で利用可能です。
-
Mythos 5.2:Cyber Verification Program または Life Sciences Verification Program を通じて申請してください。Claude Enterprise の顧客は Claude Security 経由でも利用できます。
厳格なデータ要件を持つ企業は Enterprise Frontier Safeguards を利用できます。これは、顧客のインフラ内に保存されたデータに対して Anthropic の安全監視を実行し、データ保持ゼロで運用できます。その他の顧客は安全監視のため 30 日間のデータ保持が行われます。
まとめ
Claude Fable 5.2 は Fable 5.1 から有意な前進です。より安価で高速、正当な作業を拒否しにくくなりました。Remote Labor Index、ロボティクス、FrontierCode の伸びは特に大きいといえます。
とはいえ、日常業務では半額の Opus 5.5 のほうが依然としてコストパフォーマンスに優れます。Fable 5.2 の最も興味深い点は効率性の主張かもしれません。低~中労力で Opus 5.5 のベストに匹敵するのであれば、トークン単価のプレミアムは急速に縮みます。自分たちのワークロードで検証する価値があります。
Claude を実際に使ってみたい場合は、当社の Developing AI Applications トラックがおすすめです。
本日、Anthropic は一般向けの Fable 5.2、審査済み組織向けの Mythos 5.2 を発表しました。基盤となるモデルは同一ですが、Fable 版にはサイバーセキュリティと生物学に関する追加の安全対策が施されています。
主な変更点は次のとおりです。
具体的には、Fable 5.2 は Fable 5.1 より 20% 安価で、最大 30% 高速に出力し、Anthropic のベンチマーク表の多くで GPT-6 Astra と Gemini 4 Carbon を上回っています。
本記事では、Fable 5.2 と Mythos 5.2 の新機能、ベンチマークでの性能、料金、そして Claude Opus 5.5 より選ぶべきかの判断材料を解説します。
Claude Fable 5.2 とは?
Claude Fable 5.2 は、Anthropic が一般提供する中で最も高性能なモデルです。大規模コードベースの移行、複数日にわたるエージェント運用、研究課題、エンジニアリング設計など、長時間かつ高度な技術作業に向けて設計されています。
Fable 5.2 は小型モデルと併用することもでき、難題に対して助言を行うアドバイザーや、単純なサブタスクを小型モデルに割り振るオーケストレータとして機能します。
Fable 5.2 は、前バージョン同様に 100 万トークンのコンテキストウィンドウと最大 128K の出力に対応し、ナレッジカットオフは 2026 年 6 月です。
Claude Mythos 5.2 とは?
Claude Mythos 5.2 は、Fable 5.2 と同一のモデルですが、サイバーセキュリティ関連や研究レベルの生物学作業の大半をブロックする安全対策がありません。実際、Mythos 5.2 はサイバーセキュリティエンジニアリングにおいて Anthropic の最も高性能なモデルです。これらの能力はデュアルユースであるため、Anthropic は Cyber Verification Program と Life Sciences Verification Program を通じ、審査済み組織にのみ Mythos 5.2 を提供しています。
Claude Fable 5.2 の新機能は?
Fable は 6 月に Fable 5 がリリースされて以来の新しい系統で、その後 9 月の Fable 5.1、そして今回の Fable 5.2 と 2 回のマイナーアップデートがありました。いずれも新機能の追加は多くなく、主に安価・高速・高性能化に焦点が当てられています。ただし、その性能向上は小さくありません。例えば Fable 5.2 は Remote Labor Index のスコアで Fable 5.1 の 2 倍以上を記録しています。
2 つのバージョンで大きく異なるのは、利用可能な用途です。Fable 5.1 ではサイバーセキュリティの安全対策が狭まり、ソフトウェア脆弱性の発見には使えるようになった一方で、エクスプロイトの作成は不可のままでした。また、同時に Enterprise Frontier Safeguards(自社クラウドにデータを保持するオプション)も発表されました。Fable 5.2 の安全対策の変更はより小規模で、ブロックされるリクエストが減る一方、対象外となるタスクの種類自体は変わっていません。
Fable 5.2 を小型 Claude モデルのアドバイザーとして使う、といった新しい活用例の提案も、実は目新しいものではありません。Anthropic の advisor ツールはすでに Fable 5 と 5.1 をサポートしていました。発表時のデモ(空のフォルダから OS を構築するなど)も、新機能というより、より強力なモデルがより難しいことをこなせるようになった、という示唆です。
とはいえ「新しい点」を挙げるなら、次のようになります。
価格の引き下げ
Fable 5.2 は入力 100 万トークンあたり $8、出力 $40 で、Fable 5.1 の $10/$50 から 20% の値下げです。キャッシュリード($0.20)、キャッシュライト、バッチ処理にも同様に 20% の値下げが適用されています。詳細は後述の料金セクションをご覧ください。
出力の高速化と、Fable 向けの高速モード
出力は Fable 5.1 比で最大 30% 高速化し、長時間のエージェント運用で効いてきます。さらに、Fable で高速モードに対応し、価格は 2 倍($16/$80)ながら最大 2.5 倍の速度向上が見込めます。
低い労力でより良い結果
請求額に最も影響しそうなのはここです。高い労力設定では、Fable 5.2 は FrontierCode 2.0 で 45.3% を記録し、Opus 5.5 のベストスコアと同水準ながら、タスクあたりのコストはおよそ半分です。低い労力設定では、Humanity's Last Exam(ツールあり)で Opus 5.5 のトップスコアに並び、タスクあたりコストは 1/10 未満です。所感:Opus 5.5 から移行するなら、Fable 5.2 は低い労力設定から試すのがよさそうです。
ブロックされるリクエストの減少
Fable 5.2 は Fable 5.1 に比べて、安全対策によるブロックが約 55% 減る見込みです(サイバーセキュリティで約 60% 減、生物学で約 40% 減)。Fable 5.1 の拒否に悩まされていた場合は大きな改善ですが、ブロックされるカテゴリ自体は変わっていません。ペネトレーションテスト、エクスプロイト生成、研究レベルの生物学の大半は、引き続き旧 Claude モデルに委ねられます。
Claude Fable 5.2 はベンチマークでどうか?
主な結果は以下のとおりです。いずれも Anthropic の発表表に基づくため、独立検証というよりは同社によるモデルの主張として読み解いてください。Claude のスコアは安全対策オンで測定されています。特記がない限り、各モデルは利用可能な最大の労力設定で表示しています。
エージェント的コーディング
Fable 5.2 はコーディング系の 2 ベンチマークで首位です。オープンソースのメンテナがモデルのコード変更をマージするかを測る FrontierCode 2.0 では 49.1% と表中最高で、Fable 5.1 の 32.4% を大きく上回りました。FrontierSWE v2 でも 69.9% を記録し、GPT-6 Astra(65.5%)や Opus 5.5(62.3%)を上回っています。
発表時の事例も同様の傾向を示しています。Fable 5.2 の初期版を用いたエージェントが本番サービスを Python から Rust に移行し、起動が約 26 倍高速化しました。
ナレッジワークと研究
相対的な伸びが最も大きいのは Remote Labor Index(実在のフリーランス型プロジェクトの達成度を測定)で、Fable 5.2 は 41.3% と、Opus 5.5(21.3%)や GPT-6 Astra(20.8%)のおよそ 2 倍です。Humanity's Last Exam(ツールあり、74.2%)や Terminal-Bench-Science(74.6%、Mythos 5.2 は 75.3%)でも首位です。
一方でビジネスオートメーションは唯一の苦手分野。AutomationBench では Gemini 4 Carbon が 53.9%、Fable 5.2 は 51.4% でわずかに及びませんが、それでも Fable 5.1(31.4%)からは大きく伸びています。
表外では、ハードウェアエンジニアリングのベンチマーク BenchCAD 2.1 で Fable 5.2 は 83.5 を記録し、Opus 5.5 の 65.3 を上回りました。さらに、ブラックホール物理の未解決問題 2 件を解いたとされ、その結果は他の物理学者が検証可能なプレプリントとして公開されています。
コンピュータ操作、ロボティクス、ビジョン
Fable 5.2 は OSWorld 2.1 で 89.3% と、Opus 5.5(87.2%)や GPT-6 Astra(79.5%)を上回りました。ロボティクスでは表中で最大の伸びで、RoboDojo Sim で 64.9% と、Fable 5.1 と GPT-6 Astra の 2 倍以上です。ツールなしでのチャート読解を試す Chartography でも、Fable 5.1 の 44.8% から大きく改善し、Gemini 4 Carbon や GPT-6 Astra を僅差で上回りました。
サイバーセキュリティと生物学(Mythos 5.2)
セキュリティと生物学の行は、Fable 5.2 の安全対策では大半がブロックされるため、Mythos 5.2 の結果です。Mythos 5.2 は CyScenarioBench で 76.3%(Mythos 5.1 は 61.7%)、CVE Rediscovery で 89.6%(同 78.3%)、24 時間のタンパク質バインダー設計タスクで 85.1%(同 79.1%)を記録しました。なお、CyScenarioBench は各社がそれぞれのタスクで評価しており、OpenAI のセキュリティモデルとは公正な比較になっていません。
フェルマーの最終定理の話は?
Fable 5.2 のエージェントチームが、Lean という証明支援系で 30 時間かけてフェルマーの最終定理の証明を形式化しました。とはいえ「その定理は 30 年前に証明済みでは? 何が残っているの?」と思うかもしれません。
定理自体は「既知」
フェルマーの最終定理は、n が 2 より大きいとき、an + bn = cn を満たす正の整数 a、b、c は存在しない、という命題です。n=2 では 32 + 42 = 52(9 + 16 = 25)のように解が多数ありますが、立方数では近似しか得られません。例えば 63 + 83 = 728 は 93 = 729 に 1 足りません。
Pierre de Fermat は 1637 年に証明を主張したものの書き残さず、350 年以上未解決のまま、1990 年代半ばに Andrew Wiles が Richard Taylor の助力を得て証明に至りました。
Lean による形式化とは
Wiles の証明は 100 ページ超に及び、数十年分の高度な数論に依拠しているため、端から端まで検証できる人は極めて限られます。Lean は証明支援系、すなわち証明をコードとして記述し、数学の公理レベルまでの論理ステップをソフトウェアが機械的に検査する仕組みです。コンパイルが通れば正しいことが保証されます。「形式化」とは、人間が書いた証明をこの機械検証可能な形に翻訳することを指します。
フェルマーの最終定理では、証明が依拠する数学の多くが Lean で未整備だったため、作業は巨大でした。数学者 Kevin Buzzard は 2024 年にこの作業の コミュニティプロジェクト を開始しています。
AI モデルにとっての意義
多くの AI の出力は人間が判断したり、解答の一部のみを測るベンチマークで評価されたりします。Lean の証明は異なり、検査器が全ステップを受理するかどうかで決まり、曖昧な誤答の余地がありません。非常に長大で難度の高いプロジェクトを、検証済みの完了までやり切れるかを測る、稀に見るクリーンな試金石になります。
これは Claude にとって初ではありません。9 月に Anthropic は、Fable 5.1 相当の社内研究モデルを用いた多数のエージェントにより、同定理の 初の完全なコンピュータ検証済み証明 を公開しました。この試みは 11 日間、約 60 億トークンの出力を要し、1300 万行の Lean を生成し、Buzzard のプロジェクトの一部にも依拠しました。Fable 5.2 は、これを 30 時間、最小限の人手でやり遂げました。
留意点
とはいえ、Anthropic が同じ課題を Claude Opus 5.5 に与えた際の結果は示唆的です。
Claude Fable 5.2 対 Claude Opus 5.5
通常、2 つのモデルの比較はベンチマークスコアを読み解き、実運用での違いを推し量る形になります。今回は差が直感的に分かる「物語」から入った点が良かったと感じます。
同じ 1,000 エージェントの Lean セットアップで、Opus 5.5 は 18 時間でフェルマーの最終定理の 26% を完了し、その後ほとんど進捗しませんでした。Fable 5.2 は 30 時間で完走。示唆は明確です。長大かつマルチエージェントの案件では、Fable 5.2 は止まらず走り切る一方、Opus 5.5 は行き詰まる可能性があります。
短いタスクでは差は縮まります。並べて比較すると次のとおりです。
傾向は Lean の結果と一致します。コンピュータ操作やコーディングでは数ポイントの差ですが、オープンエンドかつ多段の作業になると差は拡大。Fable 5.2 は Remote Labor Index のフリーランス型プロジェクトで Opus 5.5 のスコアをほぼ倍にし、ロボット制御でも 25 ポイント上回ります。
価格差は見た目ほど大きくないかもしれません。Fable 5.2 はトークン単価で 2 倍ですが、しばしば Opus 5.5 のベストスコアにより低い労力設定で到達でき、使用トークンを抑えられます。例えば FrontierCode 2.0 では、高い労力設定の Fable 5.2 が、タスクあたりコストで Opus 5.5 の約半分で同等のベストを出せます。
結論として、日常業務の大半では依然として Opus 5.5 が賢明なデフォルトです。しかし、作業時間が長い、エージェントが多い、または Opus で行き詰まるタスクでは、Fable 5.2 は完走できる可能性が高く、トークン単価ほどコスト差が広がらない場合があります。
安全性と制約
Anthropic は、これらのモデルが高リスク状況で不適切に振る舞う可能性は低いと評価しています。
外部からの検証は難しいため、具体的な数値は有用です。約 1,900 の自動行動監査で、Mythos 5.2 は比較対象の中で最も低い「ミスアライン行動」スコアでした。入力の取り違え(幻覚)、未完了タスクの完了宣言、悪い作業の隠蔽の発生率も低い傾向でした。
他にも興味深く、考えさせられる点がいくつかあります。
どの Claude モデルを使うべきか?
基本的には Anthropic の推奨と同じです。まずは Opus 5.5 から始め、必要に応じて上位へ移行してください。ラインナップの使い分けは次のとおりです。
Claude Fable 5.2 の価格と提供状況
先ほどのベンチマーク表では、Fable 5.2 が Fable 5.1 をすべての項目で上回っていました。ここでは、その Fable 5.2 が 5.1 より安いという表を示しました。では、Fable 5.1 はもう不要なのでしょうか?
新規案件では、実質的にそのとおりです。Fable 5.2 にアクセスできるなら、5.1 で新たに始める理由はほとんどありません。ただし、Anthropic は現時点で 5.1 のリタイア時期を発表していませんし、Fable 5.1 に合わせてプロンプトやエージェントを調整してきたチームは、切り替え前に 5.2 での検証が必要です。新バージョンはスコアが良くても挙動が異なる場合があることが分かっています。
Claude Fable 5.2 を利用するには
Claude アプリ:対象の有料プランで Fable 5.2 が利用可能です。ローンチプロモーションとして、Pro プランと標準の Team シートは週次の利用上限の最大 50% まで Fable を使用できます。Fable を含むプランでは、契約期間に応じて 1~3 回の利用量リセットが付与されます。
API:Claude Platform でモデル ID
claude-fable-5-2を使用してください。クラウドプラットフォーム:Amazon Web Services、Google Cloud、Microsoft Azure で利用可能です。
Mythos 5.2:Cyber Verification Program または Life Sciences Verification Program を通じて申請してください。Claude Enterprise の顧客は Claude Security 経由でも利用できます。
厳格なデータ要件を持つ企業は Enterprise Frontier Safeguards を利用できます。これは、顧客のインフラ内に保存されたデータに対して Anthropic の安全監視を実行し、データ保持ゼロで運用できます。その他の顧客は安全監視のため 30 日間のデータ保持が行われます。
まとめ
Claude Fable 5.2 は Fable 5.1 から有意な前進です。より安価で高速、正当な作業を拒否しにくくなりました。Remote Labor Index、ロボティクス、FrontierCode の伸びは特に大きいといえます。
とはいえ、日常業務では半額の Opus 5.5 のほうが依然としてコストパフォーマンスに優れます。Fable 5.2 の最も興味深い点は効率性の主張かもしれません。低~中労力で Opus 5.5 のベストに匹敵するのであれば、トークン単価のプレミアムは急速に縮みます。自分たちのワークロードで検証する価値があります。
Claude を実際に使ってみたい場合は、当社の Developing AI Applications トラックがおすすめです。