{count, plural, one {강의} other {강의}}
Python으로 시작하는 통계학
{hours}시간
199.6K
회귀 결과나 연구에서 "likelihood ratio(우도비)"라는 말을 보고도 무엇을 의미하는지 몰랐던 적이 있으신가요?
혼란스러운 건 자연스러운 일입니다. 이 용어는 가설 검정, 모델 비교, 분류, 진단 검사 등에서 자주 보이며, 각 분야마다 약간씩 다르게 사용합니다. 대부분의 설명은 우도가 무엇인지 알기도 전에 검정통계량과 카이제곱 분포부터 시작하죠. 그러다 보면 계산은 할 수 있지만 설명은 못 하는 숫자만 남습니다.
간단히 말해, 우도는 어떤 모수값이나 통계 모델이 관측한 데이터를 얼마나 잘 설명하는지를 나타냅니다. 우도비는 한 우도를 다른 우도로 나눈 값으로, 두 가설 중 어느 쪽이 데이터의 더 큰 지지를 받는지, 그리고 그 정도가 얼마인지 알 수 있게 해 줍니다.
이 글에서는 핵심 아이디어와 공식을 설명하고, 우도비 검정과 그 해석 방법, 그리고 실무에서 우도비를 접하게 되는 상황을 안내합니다.
통계가 필요하신가요? 저희의 확률 및 통계 과정을 살펴보고 딱 맞는 과정을 찾아보세요.
우도비는 한 가설 하에서 관측 데이터의 우도를 다른 가설 하에서의 우도로 나눈 값입니다. 두 가설은 두 개의 모수값일 수도 있고, 두 개의 완전한 통계 모델일 수도 있습니다.
우도비가 답하는 질문은 데이터가 얼마나 그럴듯한가가 아니라, 어느 설명이 데이터를 더 잘 설명하느냐입니다.
이 차이는 중요합니다. 동전 20번 던지기의 어떤 특정한 순서는 공정한 동전 하에서 약 백만 분의 일의 확률을 갖습니다. 그러니 작은 우도만으로는 많은 것을 말해주지 못하며, 다른 우도와 비교할 때에만 의미가 있습니다.
예를 들어 동전을 10번 던져 8번 앞면이 나왔다고 합시다. 하나의 가설은 동전이 공정하여 앞면 확률이 0.5라고 하고, 다른 가설은 치우쳐서 앞면 확률이 0.8이라고 합니다.
두 가설 모두 8번의 앞면을 만들어낼 수 있지만, 치우친 동전이 그 결과를 훨씬 자주 만들어냅니다. 따라서 데이터는 두 번째 가설을 더 지지하며, 우도비는 그 지지의 크기를 수치로 보여줍니다. 정확한 값은 뒤의 예시 섹션에서 계산하겠습니다.
우도와 확률은 같은 공식을 쓰지만, 다른 질문에 답합니다:
모든 가능한 결과에 대한 확률의 합은 1이지만, 모든 가능한 모수값에 대한 우도의 합은 1이 아닙니다. 그래서 우도는 가설이 참일 확률이 아니며, 우도비도 마찬가지입니다.
모든 우도비는 다음의 다섯 단계를 따릅니다:
비율의 의미는 어느 우도를 분자에 두느냐에 달려 있습니다. 가설 A가 분자라면:
비율이 4라는 것은 관측 데이터가 B보다 A 하에서 네 배 더 그럴듯하다는 뜻입니다. A가 참일 확률이 네 배라는 뜻은 아닙니다.
분자와 분모를 바꾸면 역수가 됩니다. A에 유리한 4는 B의 관점에서 0.25가 되며, 같은 내용을 반대로 말해줍니다.
분야별 관례는 다릅니다. 우도비 검정은 보통 귀무가설을 분자에 두어, 작은 값이 귀무가설에 불리한 증거가 되게 하고, 다른 많은 적용에서는 대립가설을 위에 둡니다.
따라서 어떤 우도비를 해석하기 전에는 분자에 어떤 가설이 있는지 꼭 확인하세요.
기본적인 우도비는 데이터에 대한 한 우도를 다른 우도로 나눕니다:
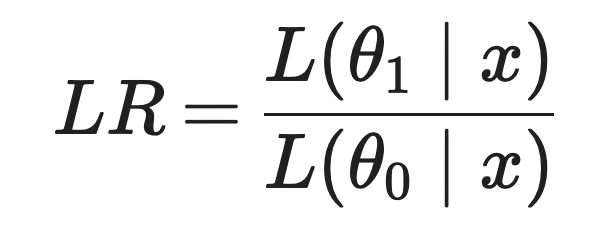
우도비 공식
각 항의 의미는 다음과 같습니다:
x: 관측 데이터(예: 10번 던져 8번 앞면)theta_1 및 theta_0: 비교하려는 두 모수값 또는 가설(예: 앞면 확률 0.8과 0.5)L(theta | x): 데이터가 주어졌을 때 theta의 우도. 이는 theta가 참 모수일 때 x의 확률(연속형 데이터의 경우 밀도)과 같습니다독립 관측치의 경우, 우도는 관측치 하나당 하나의 확률을 곱한 값입니다:
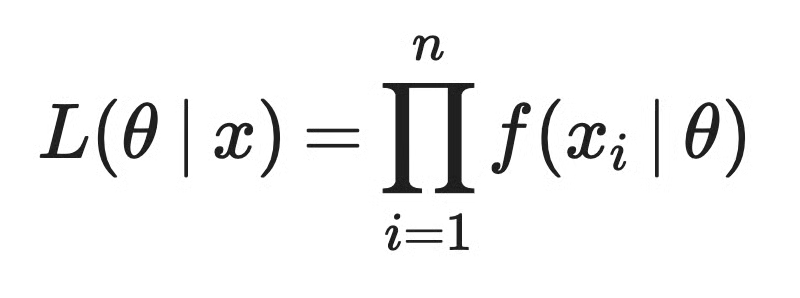
독립 관측치에서의 우도
그때부터 문제가 시작됩니다. 각 인수는 1보다 작으므로 표본이 커질수록 곱은 빠르게 줄어듭니다.
공정한 동전에서 특정한 1,000번 던지기 순서의 확률은 약 9.3 * 10^-302로, 64비트 부동소수가 저장할 수 있는 최솟값에 가깝습니다. 2,000번이 되면 Python에서 0.5 ** 2000은 0.0을 반환합니다.
로그는 이를 피하는 방법입니다. 곱의 로그는 로그의 합이므로, 로그-우도는 미세한 수들의 곱을 다룰 만한 수들의 합으로 바꿉니다:
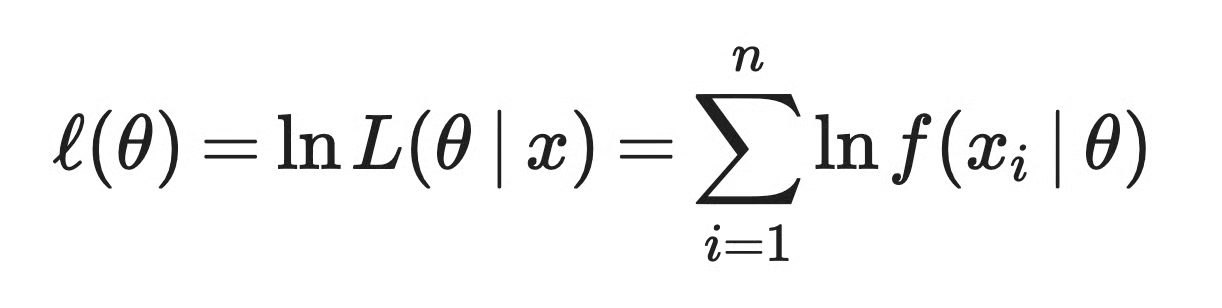
로그-우도
비율은 차로 바뀝니다:
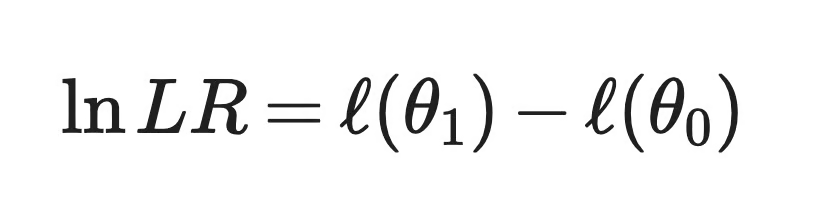
로그 우도비
합은 곱보다 미분도 더 간단하여, 최대우도추정 역시 로그-우도를 사용합니다.
로그 버전의 해석은 우도비와 동일하지만 기준점이 1이 아닌 0입니다. 값이 0이면 지지가 동일하고, 양수면 theta_1에, 음수면 theta_0에 유리합니다.
앞서 본 동전 예로 돌아가겠습니다. 10번 던져 8번 앞면, 2번 뒷면이 나왔습니다.
두 가설은 다음과 같습니다:
가설 0: 동전은 공정하여 p = 0.5
가설 1: 동전은 앞면으로 치우쳐 p = 0.8
10번 중 앞면의 개수는 이항분포를 따르므로, 각 가설의 우도는 다음과 같습니다:
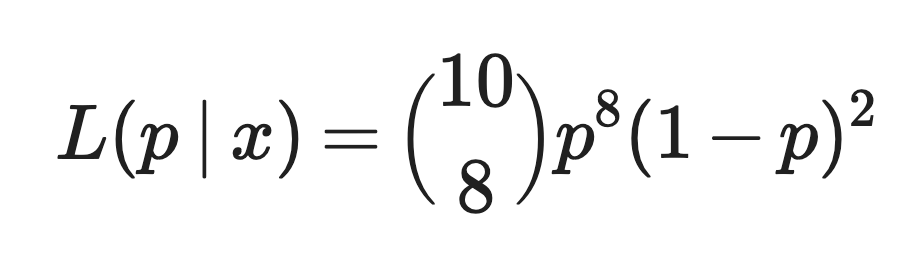
우도비 예시
공정한 동전 가설 하에서는:
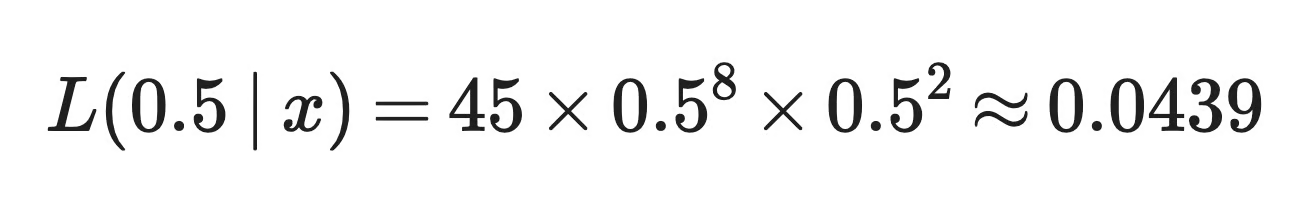
우도비 예시
치우친 동전 가설 하에서는:
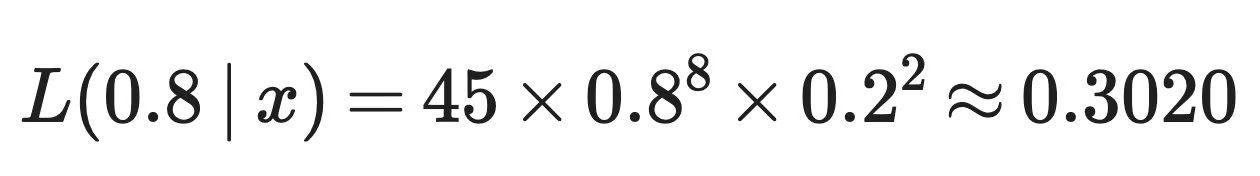
우도비 예시
우도비는 다음과 같습니다:
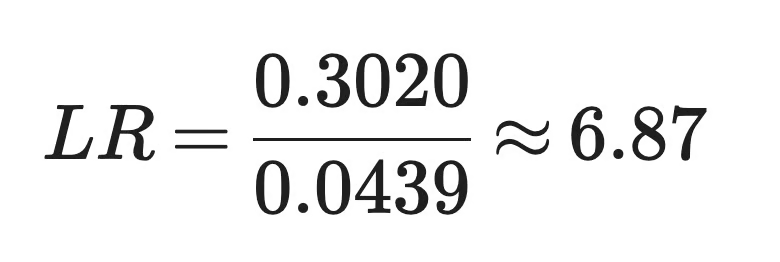
우도비 예시
이항계수 45는 두 우도에 모두 나타나므로 비율에서 상쇄됩니다. 동전 던지기 정확한 순서의 확률을 사용해도 같은 6.87을 얻습니다.
쉽게 말해, 관측 데이터는 동전이 80% 확률로 앞면이 나올 때가 공정할 때보다 약 6.9배 더 그럴듯합니다. 그게 전부입니다.
이 비율은 동전이 치우쳤을 확률이 6.9배라는 뜻이 아닙니다. 어느 가설이 참일 확률을 얻으려면 두 가설의 사전확률이 필요합니다. 사전 오즈가 50/50이라면 사후 오즈는 6.87 대 1, 즉 치우친 동전일 확률이 약 87%가 되지만, 이 값은 선택한 사전에 따라 달라집니다.
또한 이 지지는 두 가설에 대해서만 상대적입니다. p = 0.7 같은 값은 비교에 포함되지 않았습니다. 여기서 0.8은 우연히도 최대우도추정치이기도 한데, 10번 중 8번 앞면이 나왔기 때문입니다. 따라서 이 데이터에서 p의 다른 어떤 값도 더 큰 지지를 받지 못합니다.
동전 예시는 p의 두 고정값을 비교했습니다. 통계에서의 대부분 질문은 더 넓습니다. 예컨대 몇 개의 추가 예측 변수가 회귀모형을 개선하는지 등입니다.
우도비 검정은 그런 질문에 답합니다. 두 개의 중첩된 모델을 비교하는데, 작은 모델이 큰 모델의 특수한 경우가 되는 관계를 말합니다:
검정은 다섯 단계로 진행됩니다:
각 모델은 미리 정한 모수값이 아니라, 최대우도추정치에서 평가됩니다. 이것이 동전 예시와의 주요 차이점입니다.
우도비는 임의의 두 가설을 비교해 상대적 지지를 제공하지만, p값도, 의사결정도 제공하지 않습니다. LRT는 중첩 모형의 최대화된 우도비를 검정통계량으로 변환하고, 그 분포를 사용해 귀무가설을 기각할지 결정합니다. 모든 LRT는 우도비를 사용하지만, 모든 우도비가 LRT의 일부인 것은 아닙니다 — 이 글 뒤에서 나오는 진단 우도비가 그 예입니다.
LRT는 최대화된 우도비에서 시작하며, 분자에 제약 모형을 둡니다:
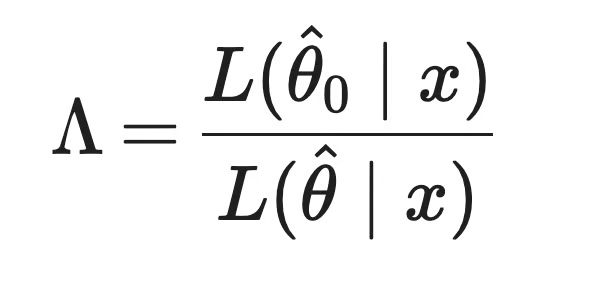
우도비 검정 통계량
여기서 theta_hat_0는 제약 모형에서의 최대우도추정치이고, theta_hat은 완전 모형에서의 추정치입니다. 완전 모형은 제약 모형을 포함하므로 항상 적어도 동일하게는 잘 맞습니다. 따라서 lambda는 0과 1 사이입니다.
검정통계량은 다음과 같습니다:
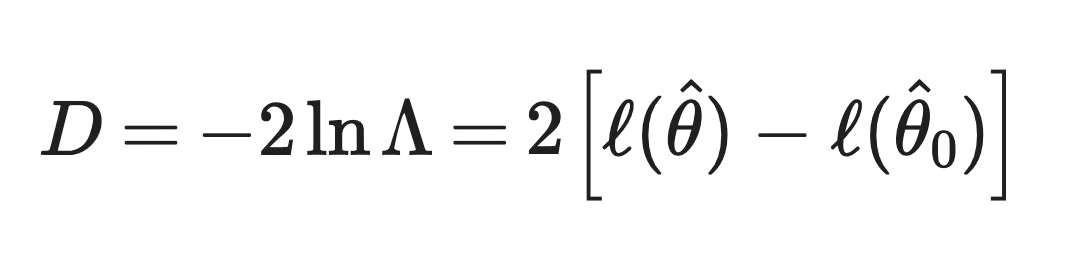
우도비 검정 통계량
로그는 앞서와 같은 이유로 사용됩니다. 아주 작은 수들의 비를 통계 패키지들이 보고하는 로그-우도의 차로 바꿔줍니다.
-2에는 두 가지 목적이 있습니다. lambda <= 1이므로 ln(lambda)는 0 이하이며, 마이너스 기호는 이를 양수로 바꿔 완전 모형이 더 잘 맞을수록 커지게 합니다. 계수 2는 통계량이 카이제곱 분포를 따르도록 스케일합니다. 일반화 선형모형(GLM)에서는 D가 두 모델 간 일탈도의 차와 같아, 흔히 그렇게 보고됩니다.
윌크스 정리가 검정을 가능하게 합니다. 귀무가설이 참이고 표준 규칙조건이 성립하면, 표본 크기가 커질수록 D는 대략 카이제곱 분포를 따른다고 말합니다. 쉽게 말해, 모델은 중첩되어야 하고, 귀무값은 허용 모수 범위의 경계에 있으면 안 됩니다. 이 조건이 깨질 때는 한계 섹션에서 다룹니다.
자유도는 보통 두 모델 간 자유 모수 수의 차이와 같습니다. 완전 모형이 예측변수 두 개를 추가한다면, D를 자유도 2인 카이제곱 분포와 비교합니다.
따라서 로지스틱 회귀, 포아송 회귀 등 대부분의 최대우도 기반 모델에서 같은 기준 분포를 사용합니다.
구독 해지 여부를 예측하려 한다고 합시다. 데이터셋에는 고객 1,000명이 있고, 약 32%가 이탈했습니다.
두 개의 로지스틱 회귀모형을 적합합니다:
제약 모형: tenure_months만으로 이탈을 예측하며, 로그-우도는 -556.88
완전 모형: monthly_charges와 support_tickets를 추가하며, 로그-우도는 -515.99
검정의 각 부분을 이 예시에 적용하면 다음과 같습니다:
귀무가설: monthly_charges와 support_tickets의 계수는 모두 0이므로, 추가 예측변수는 적합을 개선하지 않음
대립가설: 두 계수 중 적어도 하나는 0이 아님
검정통계량: D = 2 * (-515.99 - (-556.88)) = 81.78
자유도: 완전 모형이 두 개의 모수를 더 가지므로 자유도는 2
p값: 자유도 2인 카이제곱 분포에서 이만큼 크거나 더 큰 통계량이 나올 확률로, 약 1.7 * 10^-18
이 p값은 0.05 같은 일반 임계값보다 훨씬 작습니다. 귀무가설을 기각하고, 추가 예측변수가 적합을 개선한다는 강한 증거가 있다고 결론내립니다.
하지만 귀무가설을 기각한다고 해서 완전 모형이 실제 용도에 더 적합하다는 뜻은 아닙니다.
표본이 크면 아주 작은 적합 향상도 작은 p값을 만듭니다. 이 검정은 효과 크기나 새로운 데이터 예측 성능을 알려주지 않습니다. 더 큰 모델을 채택하기 전, 계수와 홀드아웃 데이터의 성능을 확인하세요.
또한 p값이 크다고 해서 추가 예측변수가 쓸모없다는 뜻은 아닙니다. 단지 데이터가 귀무가설을 기각하기에 충분한 증거를 제공하지 못한다는 의미입니다.
LRT는 추가 모수가 적합을 개선하는지 말해줄 뿐이며, 그 개선이 실질적으로 중요한지 판단하는 것은 여전히 사용자의 몫입니다.
LRT는 회귀모형을 비교할 때 가장 자주 쓰입니다. 아이디어는 언제나 같습니다 — 제약 모형을 적합하고, 완전 모형을 적합한 뒤, 최대화된 로그-우도를 비교합니다.
로지스틱 회귀는 LRT를 접하는 가장 흔한 곳입니다.
해석 섹션에서는 tenure_months만 있는 모델과 monthly_charges, support_tickets를 추가한 모델을 비교했습니다. 한 걸음 더 나아가, 모든 고객에게 동일한 이탈 확률을 예측하는 절편만 포함한 모델과 완전 모형을 비교할 수도 있습니다.
같은 이탈 데이터에서 절편 전용 모델의 로그-우도는 -627.62, 완전 모형은 -515.99입니다. 따라서 D = 2 * (-515.99 - (-627.62)) = 223.27이고, 예측변수마다 1씩 합쳐 총 3 자유도이며, p값은 약 3.9 x 10^-48입니다.
이 검정은 예측변수들이 함께 모여, 아무런 예측변수가 없을 때보다 이탈을 더 잘 설명하는지를 묻습니다. 선형회귀의 전체 F-검정에 해당하는 로지스틱 회귀 버전이며, statsmodels는 모델 요약에서 LLR p-value로 보고합니다.
로지스틱 회귀는 GLM(일반화 선형모형)이라는 더 큰 가족의 일원입니다. 여기에는 카운트를 위한 포아송 회귀, 양의 연속형 결과를 위한 감마 회귀 등도 포함됩니다.
모든 GLM은 일탈(deviance)을 보고하는데, 이는 모델이 완벽한 적합에서 얼마나 떨어져 있는지를 측정합니다. 두 중첩 GLM의 일탈 차이는 LRT 통계량 D와 같아, 이 검정을 일탈 분석(analysis of deviance)이라고도 합니다.
자유도는 이전과 마찬가지로 모수 수의 차이입니다. 감마나 가우시안 GLM처럼 분산 모수를 추정하는 모델의 경우, 카이제곱 대신 일탈 차이에 대한 F-검정을 사용하는 경우가 많습니다.
최대우도로 적합되는 모든 모델은, 모델이 중첩되어 있기만 하면 LRT를 사용할 수 있습니다. 예를 들어:
LRT는 Wald 검정과 점수(score) 검정과 유사합니다. 세 검정 모두 같은 귀무가설을 검정하며, 큰 표본에서 카이제곱 분포를 따릅니다. 차이는 어떤 모델을 적합하고 무엇을 측정하느냐에 있습니다.
LRT는 두 모델을 모두 적합하여 로그-우도를 비교합니다. Wald 검정은 완전 모형만 적합하고, 각 추정치가 귀무값으로부터 표준오차 단위로 얼마나 떨어져 있는지를 봅니다.
단일 계수의 경우, Wald 통계량은 추정치를 표준오차로 나눈 값입니다. 회귀 요약표의 p값은 보통 이 검정에서 나옵니다.
Wald 검정은 모델 하나만 적합하므로 빠릅니다. 하지만 모형의 파라미터화 방식에 따라 달라지고, 로지스틱 회귀에서는 계수가 매우 클 때 표준오차가 추정치보다 더 빨리 커져서 성능이 나쁠 수 있습니다. LRT는 이런 문제가 없어 더 안전한 선택입니다.
점수 검정은 제약 모형만 적합합니다.
귀무 모수값에서 로그-우도의 기울기를 봅니다. 귀무가설이 맞다면 기울기는 0에 가까워야 합니다. 가파른 기울기는 그 모수들이 귀무값에서 벗어날수록 우도가 증가함을 의미합니다.
따라서 완전 모형을 적합하기 비싸거나 어려울 때 점수 검정이 유용합니다. 라그랑주 승수 검정으로도 알려져 있으며, 보통 후보 예측변수를 추가하기 전에 선별하는 데 사용합니다.
LRT 통계량은 큰 표본에서 카이제곱 분포를 따르지만, 그렇다고 LRT가 일반적으로 말하는 "카이제곱 검정"인 것은 아닙니다.
"카이제곱 검정"은 통계량이 카이제곱 분포를 따르는 모든 검정을 아우르는 용어입니다. 대부분의 경우, 피어슨의 카이제곱 독립성/적합도 검정을 가리키는 데 사용됩니다.
두 검정은 연결되어 있긴 합니다. 피어슨 검정의 우도비 버전은 G-검정이라 하며, 제곱 차이 대신 로그-우도를 사용해 관측도수와 기댓값을 비교합니다. 큰 표본에서는 두 방법이 유사한 결과를 줍니다.
세 가지 모델 기반 검정을 비교하면 다음과 같습니다:
| Wald 검정 | 우도비 검정 | 점수 검정 | |
|---|---|---|---|
| 적합하는 모델 | 완전 모형만 | 제약 모형과 완전 모형 | 제약 모형만 |
| 측정 대상 | 추정치의 귀무값으로부터의 거리(표준오차 단위) | 최대화된 로그-우도의 차이 | 귀무값에서의 로그-우도 기울기 |
| 주 사용처 | 회귀 요약의 계수 p값 | 중첩 모델 비교, 일탈 분석 | 새 예측변수 선별, 적합이 어려운 모델 |
| 약점 | 파라미터화에 민감, 매우 큰 추정치에서는 신뢰도 저하 | 두 모델 모두 적합해야 함 | 귀무값 근방의 정보만 사용 |
| 큰 표본 분포 | 카이제곱 | 카이제곱 | 카이제곱 |
다른 통계 검정과의 비교: 우도비
두 용어 모두 이름에 "ratio(비)"가 들어가고 로지스틱 회귀에서 흔하지만, 유사점은 거기까지입니다.
우도비는 두 가설이 관측 데이터를 얼마나 잘 설명하는지를 비교합니다. 오즈비는 두 집단/조건 간 결과의 오즈를 비교합니다.
오즈는 사건의 확률을 그 사건이 일어나지 않을 확률로 나눈 값입니다. 이탈 확률이 25%라면 오즈는 0.25 / 0.75, 즉 1 대 3입니다.
앞서의 이탈 모델에서 support_tickets의 계수는 0.456입니다. 이를 지수화하면 오즈비는 약 1.58로, 지원 티켓이 1개 늘어날 때마다 이탈 오즈가 1.58배가 된다는 뜻입니다.
이는 데이터에서의 효과에 관한 진술입니다. 우도비는 증거에 관한 진술 — 동일한 데이터를 두고 한 가설/모형이 다른 것보다 얼마나 더 잘 설명하는지 — 입니다.
따라서 오즈비는 "효과의 크기는 어느 정도인가?"에 답하고, 우도비는 "데이터가 어느 설명을 더 지지하는가?"에 답합니다.
의학에서는 "우도비"가 두 번째 의미를 가집니다. 이는 검사 결과가 환자에게 질환이 있을 오즈를 얼마나 바꾸는지를 설명하며, 모델 적합이나 p값과 관련이 없습니다.
진단 우도비는 검사 특성 두 가지에서 나옵니다:
어떤 검사의 민감도가 90%, 특이도가 80%라고 합시다.
양성 우도비(LR+)는 양성 결과가 질환자에서 비질환자보다 얼마나 더 흔한지를 나타냅니다:
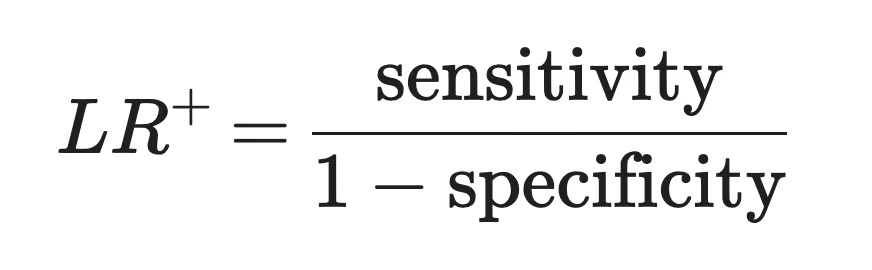
양성 우도비
예시 검사에서는 0.9 / 0.2 = 4.5입니다. 즉 양성 결과는 질환자에게서 4.5배 더 흔합니다. 1보다 큰 값은 질환 오즈를 높이며, 값이 클수록 양성 결과의 정보량이 큽니다.
음성 우도비(LR-)는 음성 결과가 질환자에게서 비질환자에 비해 얼마나 흔한지를 나타냅니다:
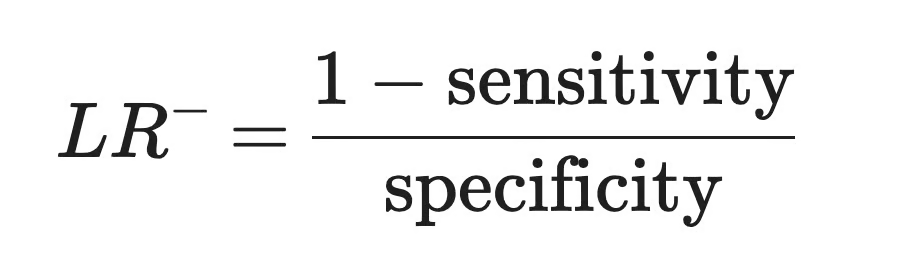
음성 우도비
예시 검사에서는 0.1 / 0.8 = 0.125입니다. 1보다 작은 값은 질환 오즈를 낮추며, 0에 가까울수록 음성 결과의 정보량이 큽니다.
진단 우도비가 유용한 이유는 기존 지식을 업데이트해 주기 때문입니다:
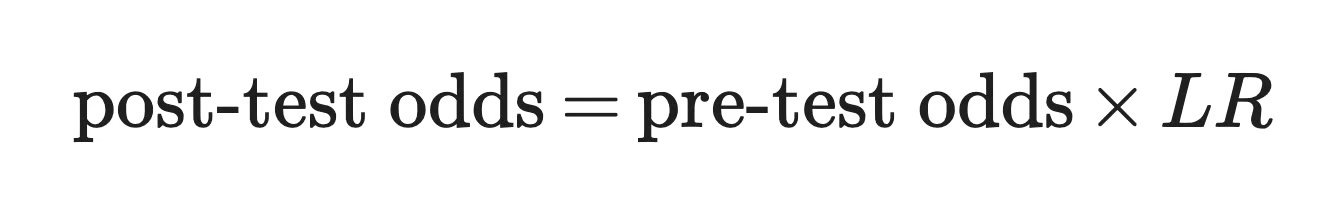
진단 우도비
이와 같은 환자 중 10%가 질환을 갖는다고 합시다. 이는 사전 오즈 0.1 / 0.9, 즉 약 0.111입니다.
양성 결과 후 오즈는 0.111 * 4.5 = 0.5가 되어 확률로는 약 33%입니다. 음성 결과 후에는 0.111 * 0.125 = 0.014가 되어 약 1.4%입니다.
이 글에서 우도비가 가설의 확률로 이어지는 유일한 경우이며, 가능한 이유는 사전 오즈가 사전을 제공하기 때문입니다.
두 언어 모두 몇 줄로 LRT를 실행하는 데 필요한 모든 것을 제공합니다. 앞서 언급한 이탈 데이터셋을 사용해, 해석 및 회귀 섹션의 숫자와 일치시키겠습니다.
numpy, pandas, statsmodels, scipy가 필요합니다. 먼저 데이터셋을 생성하세요:
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf
from scipy import stats

# Generate a synthetic customer churn dataset
rng = np.random.default_rng(42)
n_customers = 1000

churn = pd.DataFrame({
    "tenure_months": rng.integers(1, 73, n_customers),
    "monthly_charges": rng.uniform(20, 120, n_customers).round(2),
    "support_tickets": rng.poisson(1.5, n_customers),
})

# Churn gets less likely with tenure and more likely with charges and tickets
log_odds = (
    -0.5
    - 0.04 * churn["tenure_months"]
    + 0.01 * churn["monthly_charges"]
    + 0.25 * churn["support_tickets"]
)
churn["churned"] = rng.binomial(1, 1 / (1 + np.exp(-log_odds)))

# Save the data so you can load the same dataset in R
churn.to_csv("churn.csv", index=False)
이 데이터셋에서 이탈 비율은 32.1%입니다.
다음으로, 제약 모형과 완전 모형 로지스틱 회귀를 적합합니다. 각 모델의 최대화된 로그-우도는 .llf 속성에 있습니다:
# Fit the restricted and full models
reduced_model = smf.logit("churned ~ tenure_months", data=churn).fit(disp=0)
full_model = smf.logit(
    "churned ~ tenure_months + monthly_charges + support_tickets",
    data=churn,
).fit(disp=0)

# Get the maximized log-likelihoods
print(f"Restricted model log-likelihood: {reduced_model.llf:.2f}")
print(f"Full model log-likelihood: {full_model.llf:.2f}")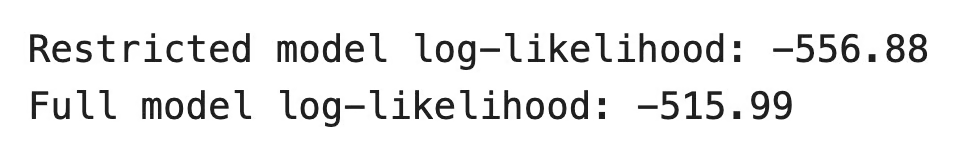
제약 모형과 완전 모형의 로그-우도
statsmodels에는 로지스틱 회귀 전용 일반 LRT 함수가 없으므로, 두 로그-우도에서 통계량을 계산합니다. .df_model 속성은 각 모델의 예측변수 수를 제공하며, stats.chi2.sf()는 p값을 반환합니다:
lr_stat = 2 * (full_model.llf - reduced_model.llf)
df_diff = full_model.df_model - reduced_model.df_model
p_value = stats.chi2.sf(lr_stat, df_diff)

print(f"LR statistic: {lr_stat:.2f}")
print(f"Degrees of freedom: {df_diff:.0f}")
print(f"P-value: {p_value:.1e}")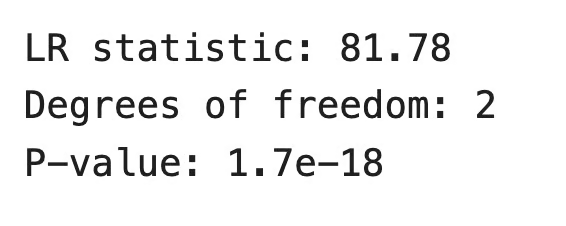
검정통계량, 자유도, p값
p값이 0.05보다 훨씬 작으므로 귀무가설을 기각합니다. 데이터는 tenure_months만 있는 모델보다 monthly_charges와 support_tickets를 추가한 모델이 적합을 개선한다는 강한 증거를 제공합니다.
절편 전용 모델과의 비교는 추가 코드 없이 수행할 수 있습니다. statsmodels는 모든 로지스틱 회귀 모델에 대해 이를 계산합니다:
print(f"Intercept-only log-likelihood: {full_model.llnull:.2f}")
print(f"LR statistic: {full_model.llr:.2f}")
print(f"P-value: {full_model.llr_pvalue:.1e}")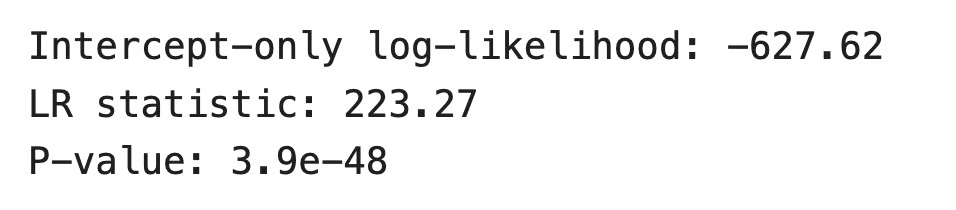
완전 모형과 절편 전용 모델의 비교
R은 NumPy와 같은 난수 생성기를 사용하지 않으므로, 동일한 데이터를 사용하려면 Python 예제에서 저장한 churn.csv 파일을 불러오세요. 그런 다음 glm()으로 두 모델을 적합하고 anova()에 전달합니다:
# Load the churn dataset saved from Python
churn <- read.csv("churn.csv")

# Fit the restricted and full models
reduced_model <- glm(churned ~ tenure_months, data = churn, family = binomial)
full_model <- glm(
  churned ~ tenure_months + monthly_charges + support_tickets,
  data = churn,
  family = binomial
)

# Check the maximized log-likelihoods
logLik(reduced_model)
logLik(full_model)

# Run the likelihood ratio test
anova(reduced_model, full_model, test = "Chisq")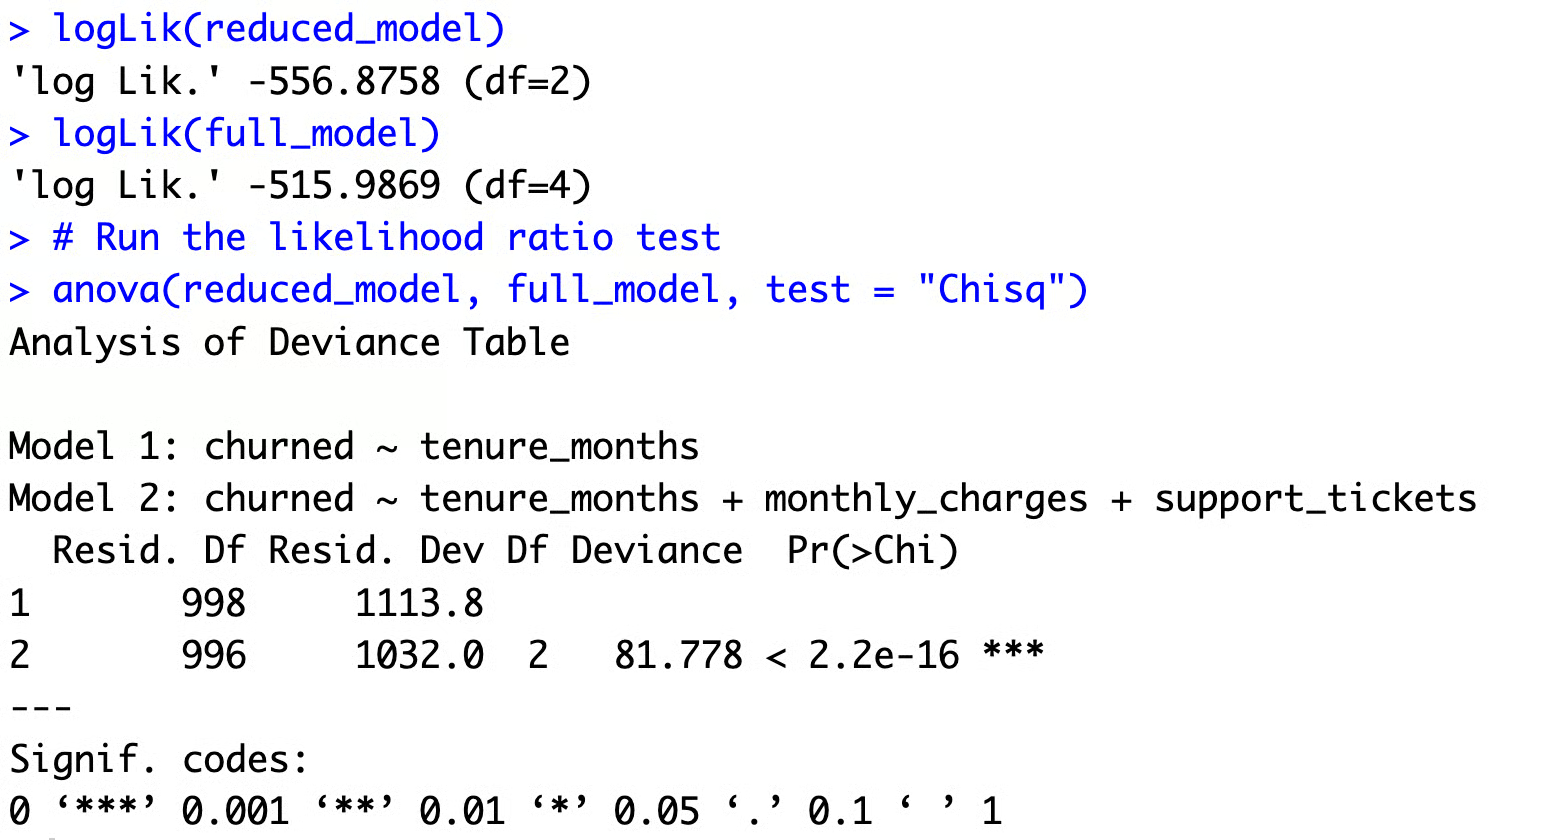
R에서의 로그-우도와 비율 검정
df 값은 각 로그-우도 옆에 표시되며, 절편을 포함한 추정 모수의 수입니다. 완전 모형은 두 개가 더 많으며, 이는 anova() 표의 Df 열과 일치합니다.
Deviance 열은 81.778을 보여주며, Python에서 얻은 LRT 통계량과 같습니다. 이는 GLM 섹션의 일탈 분석이 작동한 것으로, 잔차 일탈이 1113.8에서 1032.0으로 감소한 값이 검정통계량입니다.
R은 기본적으로 표시하는 가장 작은 값 때문에 p값을 < 2.2e-16으로 출력합니다. Python 결과와 다르기 때문은 아닙니다. 어느 쪽이든 결론은 같고, 추가 예측변수가 적합을 개선합니다.
전용 함수를 선호한다면, lmtest 패키지의 lrtest()로 lrtest(reduced_model, full_model)을 실행하면 동일한 비교를 수행합니다.
LRT는 지금까지 다룬 환경에서 잘 작동하지만, 카이제곱 결과는 몇 가지 조건에 의존합니다.
표준 LRT는 제약 모형이 완전 모형의 특수한 경우인 중첩 모델만 비교합니다.
로지스틱 회귀와 프로빗 모델을 비교하거나, 예측변수가 서로 다른 두 모델을 비교하려 하면 어느 쪽도 다른 쪽의 특수한 경우가 아닙니다. 이때 카이제곱 분포는 적용되지 않습니다. 대신 AIC와 BIC, 또는 비중첩 모델에 특화된 Vuong 검정을 사용하세요.
검정은 최대화된 우도를 비교하므로, 두 모델 모두 같은 데이터에서 최대우도로 적합되어야 합니다.
여기서 흔히 두 가지 문제가 생깁니다. 많은 패키지의 기본값인 REML로 적합한 혼합효과모형은 고정효과가 다른 경우 LRT로 비교할 수 없습니다 — 먼저 최대우도로 다시 적합해야 합니다. 그리고 라쏘나 릿지 회귀 같은 벌점화 모델은 우도 자체를 최대화하지 않으므로, 일반적인 검정을 적용할 수 없습니다.
또한 두 모델은 같은 관측치를 사용해야 합니다. 어떤 예측변수에 결측값이 있으면 완전 모형이 행을 삭제할 수 있고, 두 로그-우도는 더 이상 비교 가능하지 않습니다.
윌크스 정리는 큰 표본에서 성립하는 결과입니다. 우도가 매끄럽고, 모수가 식별 가능하며, 참 모수값이 허용 범위의 내부(경계가 아님)에 있어야 한다는 등의 규칙조건이 필요합니다.
이 조건이 충족되면 큰 표본에서 카이제곱 분포가 좋은 근사가 됩니다. 어디까지나 근사임을 기억하세요.
소표본에서는 LRT 통계량이 카이제곱 분포를 따르지 않을 수 있어 p값이 과소 또는 과대로 나올 수 있습니다.
여기에는 몇 가지 선택지가 있습니다. 모수적 부트스트랩으로 제약 모형에서 새로운 데이터셋을 모의하여 통계량 분포를 구성할 수 있습니다. 분할표 같은 단순한 경우에는 정확검정으로 근사를 피할 수 있습니다.
일부 귀무가설은 모수를 허용 범위의 경계에 둡니다. 가장 흔한 예는 혼합모형에서 무작위효과 분산이 0인지 검정하는 것입니다(분산은 음수가 될 수 없습니다).
이 경우 통계량은 통상적인 카이제곱 분포를 따르지 않습니다. 단일 분산 성분의 경우, 자유도 0과 1인 카이제곱의 50:50 혼합분포를 따르므로, 표준 p값은 실제보다 약 두 배 큽니다. 표준 검정은 여기서 보수적이어서, 실제 효과를 더 자주 놓칩니다.
혼합분포에서 성분 개수를 검정할 때도 비슷한 문제가 있습니다. 한 성분과 두 성분을 비교하면 규칙조건이 깨지고, 카이제곱 근사가 전혀 성립하지 않습니다.
LRT는 완전 모형이 올바르다고 가정합니다. 두 모델 모두 데이터의 분포를 잘못 지정하면(예: 평균보다 분산이 훨씬 큰 카운트에 포아송 모형 적용), 큰 표본에서도 통계량이 카이제곱 분포를 따르지 않습니다.
검정을 신뢰하기 전에 완전 모형의 적합을 확인하세요. 과산포 카운트에는 음이항 모형이나 준우도의 F-검정이 더 나은 선택인 경우가 많습니다.
즉, 카이제곱 근사는 기본값일 뿐 보장은 아니며, 윌크스 정리의 조건에 부합할 때만 적용됩니다.
우도비는 두 가설 또는 모델이 동일한 관측 데이터를 얼마나 잘 설명하는지 비교합니다. 이것이 전부이며, 이 글의 모든 내용은 여기에 기반합니다.
우도비 검정은 그 아이디어를 형식적 절차로 만듭니다. 두 중첩 모형을 적합하고, 최대화된 로그-우도를 비교하며, 카이제곱 분포를 사용해 p값을 구합니다. 로지스틱 회귀와 다른 GLM에서 가장 자주 보게 되며, statsmodels와 R 모두 몇 줄의 코드로 실행합니다.
하지만 숫자의 의미를 잊지 마세요. 우도비는 한 가설이 다른 가설보다 상대적으로 얼마나 지지를 받는지를 보여줄 뿐, 어느 쪽이 참일 확률을 말해주지 않습니다. 그 확률을 얻으려면 진단 검사에서처럼 사전 오즈가 필요합니다.
더 알아보고 싶다면, 검정의 구성요소인 우도 자체, 최대우도추정, 그리고 Wald 검정을 비롯한 다른 가설 검정이 LRT와 어떻게 비교되는지 살펴보세요.
DataCamp로 학습하세요
{count, plural, one {강의} other {강의}}
{count, plural, one {강의} other {강의}}
{count, plural, one {강의} other {강의}}