
{count, plural, one {Khóa học} other {Khóa học}}
Nhập môn Thống kê với Python
{hours} giờ
199.5K
Bạn đã từng thấy thuật ngữ "tỷ số hợp lý" trong kết quả hồi quy hoặc trong một nghiên cứu mà không hiểu nó đang nói gì chưa?
Bạn không phải là người duy nhất. Thuật ngữ này thường xuất hiện trong kiểm định giả thuyết, so sánh mô hình, phân loại và kiểm tra chẩn đoán, và mỗi lĩnh vực lại dùng hơi khác nhau. Phần lớn lời giải thích cũng bắt đầu bằng một thống kê kiểm định và phân phối chi-bình phương trước khi bạn kịp biết "hợp lý" là gì. Kết quả là bạn có một con số có thể tính được nhưng lại không thể giải thích.
Tóm lại, hợp lý cho thấy một giá trị tham số hoặc một mô hình thống kê giải thích dữ liệu bạn quan sát tốt đến mức nào. Tỷ số hợp lý chia một hợp lý cho một hợp lý khác, để bạn thấy giả thuyết nào trong hai giả thuyết nhận được nhiều ủng hộ hơn từ dữ liệu, và nhiều hơn bao nhiêu.
Trong bài viết này, tôi sẽ hướng dẫn bạn qua ý tưởng cốt lõi và công thức, kiểm định tỷ số hợp lý và cách diễn giải, cũng như những nơi bạn sẽ gặp tỷ số hợp lý trong thực tế.
Cần ôn lại thống kê? Duyệt danh mục các khóa học Xác suất và Thống kê của chúng tôi và tìm lựa chọn phù hợp.
Tỷ số hợp lý là hợp lý của dữ liệu quan sát dưới một giả thuyết chia cho hợp lý của cùng dữ liệu đó dưới một giả thuyết khác. Hai giả thuyết có thể là hai giá trị tham số hoặc hai mô hình thống kê đầy đủ.
Câu hỏi nó trả lời là lời giải thích nào giải thích dữ liệu tốt hơn, không phải liệu dữ liệu có khả dĩ hay không.
Đó là một khác biệt quan trọng. Bất kỳ chuỗi 20 lần tung đồng xu cụ thể nào cũng có xác suất khoảng một phần triệu dưới đồng xu công bằng, vì vậy một hợp lý nhỏ tự thân không nói lên nhiều điều. Nó chỉ có ý nghĩa khi đặt cạnh một hợp lý khác.
Giả sử bạn tung đồng xu 10 lần và được 8 mặt ngửa. Một giả thuyết nói đồng xu là công bằng, xác suất ra ngửa là 0,5. Giả thuyết khác nói nó bị lệch, xác suất ra ngửa là 0,8.
Cả hai giả thuyết đều có thể tạo ra 8 mặt ngửa, nhưng đồng xu bị lệch tạo ra kết quả đó thường xuyên hơn nhiều. Vì vậy dữ liệu ủng hộ giả thuyết thứ hai nhiều hơn, và tỷ số hợp lý gán một con số cho mức độ "nhiều hơn" đó. Tôi sẽ tính các giá trị chính xác trong phần ví dụ sau trong bài viết này.
Hợp lý và xác suất dùng cùng một công thức, nhưng trả lời những câu hỏi khác nhau:
Tổng các xác suất trên mọi kết quả có thể bằng 1, nhưng tổng các hợp lý trên mọi giá trị tham số có thể thì không. Đó là lý do một hợp lý không phải là xác suất một giả thuyết là đúng, và tỷ số hợp lý cũng vậy.
Mọi tỷ số hợp lý đều theo cùng năm bước:
Ý nghĩa của tỷ số phụ thuộc vào hợp lý nào ở phía trên. Với giả thuyết A ở tử số:
Tỷ số 4 nghĩa là dữ liệu quan sát có xác suất gấp bốn lần dưới A so với dưới B. Nó không có nghĩa A có khả năng đúng gấp bốn lần.
Nếu bạn hoán đổi tử và mẫu, bạn sẽ được nghịch đảo. Tỷ số 4 nghiêng về A trở thành 0,25, nói cùng điều từ phía B.
Quy ước khác nhau giữa các lĩnh vực. Kiểm định tỷ số hợp lý thường đặt giả thuyết không ở tử số, nên các giá trị nhỏ được tính là bằng chứng chống lại nó, trong khi nhiều ứng dụng khác đặt giả thuyết đối ở trên.
Vì vậy trước khi diễn giải bất kỳ tỷ số hợp lý nào, hãy kiểm tra giả thuyết nào ở tử số.
Tỷ số hợp lý cơ bản chia một hợp lý của dữ liệu cho một hợp lý khác:
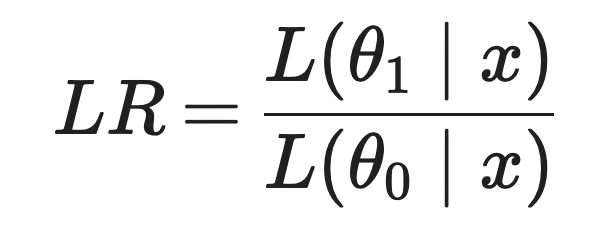
Công thức tỷ số hợp lý
Ý nghĩa của mỗi ký hiệu:
x: Dữ liệu quan sát, như 8 mặt ngửa trong 10 lần tungtheta_1 và theta_0: Hai giá trị tham số hoặc giả thuyết bạn muốn so sánh, như xác suất ra ngửa 0,8 và 0,5L(theta | x): Hợp lý của theta khi biết dữ liệu, bằng với xác suất của x khi theta là tham số đúng, hoặc mật độ của nó với dữ liệu liên tụcVới các quan sát độc lập, hợp lý là tích của một xác suất cho mỗi quan sát:
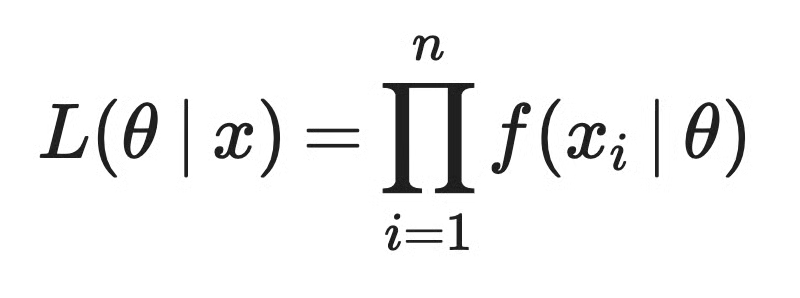
Hợp lý với các quan sát độc lập
Và đó là nơi rắc rối bắt đầu. Mỗi thừa số đều nhỏ hơn 1, nên tích giảm rất nhanh khi mẫu tăng.
Xác suất của một chuỗi 1.000 lần tung cụ thể dưới đồng xu công bằng khoảng 9,3 * 10^-302, gần bằng số nhỏ nhất mà số thực dấu phẩy động 64-bit có thể lưu trữ. Với 2.000 lần tung, 0.5 ** 2000 trong Python trả về 0.0.
Logarit là cách để vượt qua. Log của một tích bằng tổng các log, nên log-hợp lý biến một tích các số cực nhỏ thành một tổng các số vừa phải:
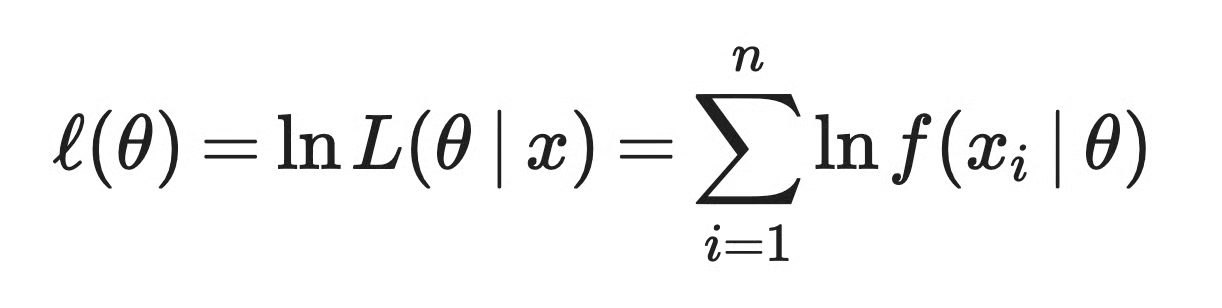
Log hợp lý
Tỷ số trở thành hiệu:
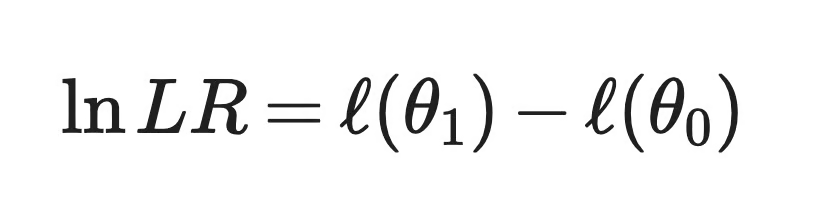
Log tỷ số hợp lý
Tổng cũng dễ lấy đạo hàm hơn tích, đó là lý do ước lượng hợp lý cực đại cũng làm việc với log-hợp lý.
Phiên bản log được đọc giống như tỷ số, chỉ là quanh 0 thay vì 1. Giá trị 0 nghĩa là ủng hộ ngang nhau, giá trị dương nghiêng về theta_1, và giá trị âm nghiêng về theta_0.
Quay lại đồng xu trước đó. Bạn tung 10 lần và được 8 mặt ngửa và 2 mặt sấp.
Hai giả thuyết là:
Giả thuyết 0: Đồng xu công bằng, nên p = 0.5
Giả thuyết 1: Đồng xu lệch về mặt ngửa, nên p = 0.8
Số mặt ngửa trong 10 lần tung tuân theo phân phối nhị thức, nên hợp lý của mỗi giả thuyết là:
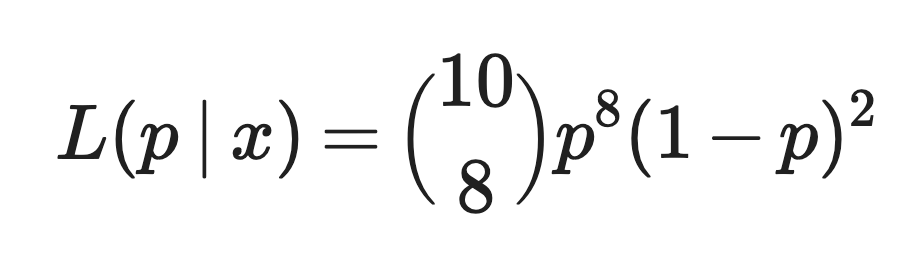
Ví dụ về tỷ số hợp lý
Dưới giả thuyết đồng xu công bằng:
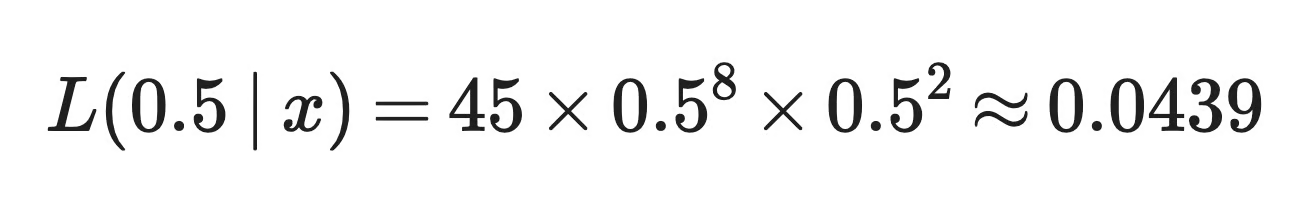
Ví dụ về tỷ số hợp lý
Dưới giả thuyết đồng xu lệch:
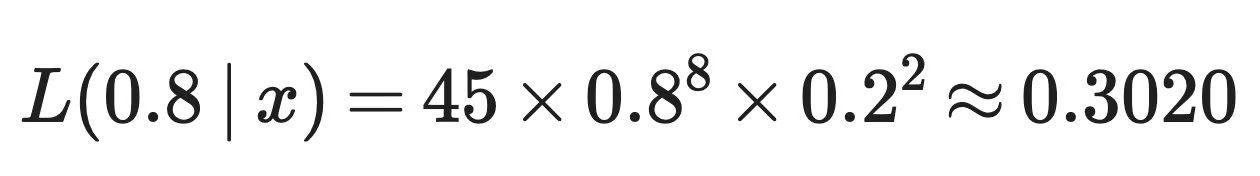
Ví dụ về tỷ số hợp lý
Tỷ số hợp lý là:
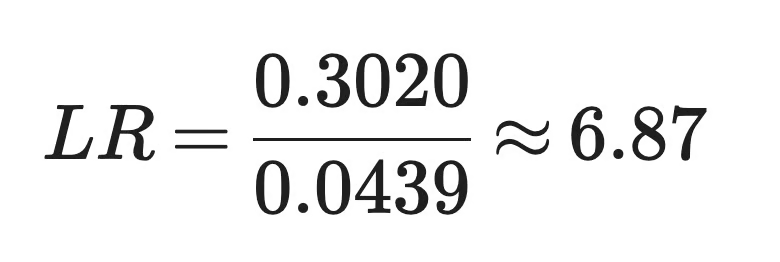
Ví dụ về tỷ số hợp lý
Hệ số nhị thức 45 xuất hiện trong cả hai hợp lý, nên triệt tiêu trong tỷ số. Bạn sẽ thu được cùng giá trị 6,87 từ xác suất của chuỗi tung cụ thể.
Nói đơn giản, dữ liệu quan sát có xác suất khoảng 6,9 lần nếu đồng xu ra ngửa 80% thời gian so với nếu nó công bằng. Hết.
Tỷ số không nói đồng xu có khả năng bị lệch gấp 6,9 lần. Để có xác suất một giả thuyết là đúng, bạn cần xác suất tiên nghiệm cho cả hai. Với tỷ lệ odds tiên nghiệm 50/50, odds hậu nghiệm sẽ là 6,87 so với 1, tức khoảng 87% cho đồng xu lệch, nhưng con số đó phụ thuộc vào tiên nghiệm bạn chọn.
Mức độ ủng hộ cũng chỉ tương đối giữa hai giả thuyết này. Một giá trị như p = 0.7 không nằm trong so sánh. Ở đây, 0,8 cũng là ước lượng hợp lý cực đại, vì 8 trong 10 lần tung là mặt ngửa, nên không giá trị p nào khác được ủng hộ nhiều hơn từ dữ liệu này.
Ví dụ về đồng xu so sánh hai giá trị cố định của p. Hầu hết các câu hỏi trong thống kê rộng hơn, như liệu vài biến dự báo bổ sung có cải thiện mô hình hồi quy hay không.
Kiểm định tỷ số hợp lý trả lời kiểu câu hỏi đó. Nó so sánh hai mô hình lồng nhau, nghĩa là mô hình nhỏ hơn là trường hợp đặc biệt của mô hình lớn hơn:
Bài kiểm định có năm bước:
Mỗi mô hình được đánh giá tại ước lượng hợp lý cực đại của nó, không phải tại một giá trị tham số bạn chọn trước. Đó là khác biệt chính so với ví dụ đồng xu.
Tỷ số hợp lý so sánh bất kỳ hai giả thuyết nào và cho bạn mức ủng hộ tương đối, nhưng không có p-value và không có quyết định. LRT lấy tỷ số các hợp lý đã tối đa hóa từ các mô hình lồng nhau, chuyển nó thành một thống kê kiểm định, và dùng phân phối của nó để quyết định có bác bỏ giả thuyết không hay không. Mọi LRT đều dùng tỷ số hợp lý, nhưng không phải mọi tỷ số hợp lý đều là một phần của LRT - các tỷ số hợp lý chẩn đoán sau trong bài là một ví dụ.
LRT bắt đầu với tỷ số các hợp lý đã tối đa hóa, với mô hình bị ràng buộc ở tử số:
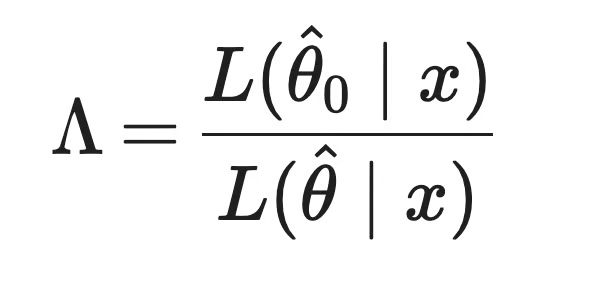
Thống kê kiểm định tỷ số hợp lý
Ở đây, theta_hat_0 là ước lượng hợp lý cực đại dưới mô hình bị ràng buộc, và theta_hat là ước lượng dưới mô hình đầy đủ. Mô hình đầy đủ chứa mô hình bị ràng buộc, nên nó luôn khớp ít nhất là tốt bằng. Điều này có nghĩa lambda nằm giữa 0 và 1.
Thống kê kiểm định là:
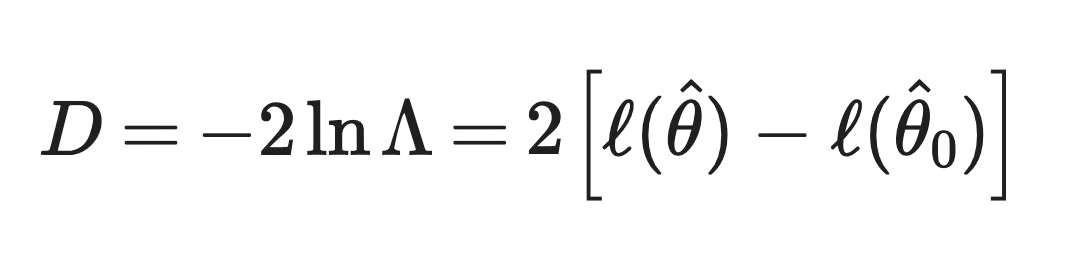
Thống kê kiểm định tỷ số hợp lý
Logarit có mặt vì cùng lý do như trước. Chúng biến một tỷ số các số rất nhỏ thành một hiệu các log-hợp lý, thứ mà mọi phần mềm thống kê đều báo cáo.
Hệ số -2 có hai nhiệm vụ. Vì lambda <= 1, ln(lambda) bằng 0 hoặc âm, nên dấu trừ biến nó thành một số dương tăng khi mô hình đầy đủ khớp tốt hơn. Hệ số 2 chuẩn hóa thống kê để nó tuân theo phân phối chi-bình phương. Với các mô hình tuyến tính tổng quát, D giống với chênh lệch độ lệch (deviance) giữa hai mô hình, đó là lý do bạn thường thấy nó được báo cáo theo cách đó.
Định lý Wilks làm cho kiểm định hoạt động. Nó nói rằng khi giả thuyết không đúng và các điều kiện quy luật chuẩn được thỏa, D xấp xỉ theo phân phối chi-bình phương khi kích thước mẫu tăng. Nói đơn giản, các mô hình cần lồng nhau, và các giá trị tham số theo giả thuyết không không được ở biên của miền tham số cho phép. Phần hạn chế sau trong bài đề cập điều gì xảy ra khi các điều kiện này vi phạm.
Bậc tự do thường bằng chênh lệch số tham số tự do giữa hai mô hình. Nếu mô hình đầy đủ thêm hai biến dự báo, bạn so sánh D với phân phối chi-bình phương với 2 bậc tự do.
Vì vậy cùng một phân phối tham chiếu hoạt động cho hồi quy logistic, hồi quy Poisson, và hầu hết các mô hình khác được khớp bằng hợp lý cực đại.
Giả sử bạn muốn dự đoán liệu một khách hàng hủy đăng ký. Bộ dữ liệu có 1.000 khách hàng, và khoảng 32% trong số họ rời bỏ.
Bạn khớp hai mô hình hồi quy logistic:
Mô hình bị ràng buộc: Dự đoán rời bỏ từ tenure_months thôi, với log-hợp lý -556,88
Mô hình đầy đủ: Thêm monthly_charges và support_tickets, với log-hợp lý -515,99
Mỗi phần của kiểm định áp dụng vào ví dụ này như sau:
Giả thuyết không: Hệ số của monthly_charges và support_tickets đều bằng 0, nên các biến bổ sung không cải thiện độ khớp
Giả thuyết đối: Ít nhất một trong hai hệ số đó không bằng 0
Thống kê kiểm định: D = 2 * (-515.99 - (-556.88)) = 81.78
Bậc tự do: Mô hình đầy đủ có nhiều hơn hai tham số, nên kiểm định dùng 2 bậc tự do
P-value: Xác suất nhận được một thống kê lớn như vậy hoặc lớn hơn dưới phân phối chi-bình phương với 2 bậc tự do, khoảng 1.7 * 10^-18
P-value đó thấp hơn rất nhiều so với bất kỳ ngưỡng phổ biến nào, như 0,05. Bạn bác bỏ giả thuyết không và kết luận rằng dữ liệu cung cấp bằng chứng mạnh mẽ rằng các biến bổ sung cải thiện độ khớp.
Nhưng bác bỏ giả thuyết không không có nghĩa mô hình đầy đủ là lựa chọn tốt hơn cho trường hợp sử dụng của bạn.
Với mẫu lớn, ngay cả những cải thiện rất nhỏ về độ khớp cũng tạo ra p-value nhỏ. Kiểm định không cho bạn biết hiệu ứng lớn đến đâu hay mô hình dự đoán dữ liệu mới tốt thế nào. Hãy kiểm tra các hệ số và hiệu năng trên dữ liệu giữ lại trước khi giữ mô hình lớn hơn.
Và p-value lớn không chứng minh các biến bổ sung là vô dụng. Nó chỉ có nghĩa dữ liệu không cung cấp đủ bằng chứng chống lại giả thuyết không.
Một LRT cho bạn biết liệu các tham số bổ sung có cải thiện độ khớp hay không, và việc quyết định liệu cải thiện đó có ý nghĩa hay không vẫn là việc của bạn.
Bạn sẽ gặp LRT thường xuyên nhất khi so sánh các mô hình hồi quy. Ý tưởng luôn như nhau - khớp một mô hình bị ràng buộc, khớp một mô hình đầy đủ, và so sánh các log-hợp lý đã tối đa hóa của chúng.
Hồi quy logistic là nơi phổ biến nhất thấy LRT.
Phần diễn giải so sánh mô hình với tenure_months với mô hình còn có monthly_charges và support_tickets. Bạn có thể đi xa hơn một bước và so sánh mô hình đầy đủ với mô hình chỉ có hệ số chặn, mô hình dự đoán cùng xác suất rời bỏ cho mọi khách hàng.
Trên cùng dữ liệu rời bỏ, mô hình chỉ có hệ số chặn có log-hợp lý -627,62, và mô hình đầy đủ là -515,99. Điều này cho D = 2 * (-515.99 - (-627.62)) = 223.27 với 3 bậc tự do, một cho mỗi biến dự báo, và p-value khoảng 3,9 x 10^-48.
Kiểm định này hỏi liệu các biến dự báo, xét chung, giải thích việc rời bỏ tốt hơn so với không có biến dự báo nào không. Đây là phiên bản hồi quy logistic của kiểm định F tổng quát trong hồi quy tuyến tính, và statsmodels báo cáo nó trong tóm tắt mô hình là LLR p-value.
Hồi quy logistic là một thành viên của họ lớn hơn gọi là các mô hình tuyến tính tổng quát, hay GLM. Họ này cũng bao gồm hồi quy Poisson cho dữ liệu đếm và hồi quy gamma cho biến liên tục dương, cùng những mô hình khác.
Mỗi GLM báo cáo một độ lệch (deviance), đo xem mô hình cách một khớp hoàn hảo bao xa. Với hai GLM lồng nhau, chênh lệch độ lệch của chúng bằng thống kê LRT D, nên kiểm định thường được gọi là phân tích độ lệch.
Bậc tự do hoạt động giống như trước, là chênh lệch số tham số. Với các mô hình có ước lượng tham số phân tán, như GLM gamma hoặc Gaussian, kiểm định F trên chênh lệch độ lệch thường được dùng thay cho phiên bản chi-bình phương.
Bất kỳ mô hình nào được khớp bằng hợp lý cực đại đều có thể dùng LRT, miễn là các mô hình lồng nhau. Ví dụ:
LRT tương tự kiểm định Wald và kiểm định score. Cả ba kiểm định cùng một giả thuyết không, và cả ba theo phân phối chi-bình phương khi mẫu lớn. Khác biệt nằm ở mô hình bạn khớp và cái bạn đo lường.
LRT khớp cả hai mô hình và so sánh log-hợp lý của chúng. Kiểm định Wald chỉ khớp mô hình đầy đủ và kiểm tra mỗi ước lượng cách xa giá trị theo giả thuyết không bao nhiêu, đo bằng sai số chuẩn.
Với một hệ số, thống kê Wald là ước lượng chia cho sai số chuẩn của nó. Các p-value trong bảng tóm tắt hồi quy thường đến từ kiểm định này.
Kiểm định Wald nhanh, vì bạn chỉ khớp một mô hình. Nhưng nó phụ thuộc vào cách tham số hóa mô hình, và trong hồi quy logistic nó có thể hoạt động kém khi hệ số rất lớn, vì sai số chuẩn tăng nhanh hơn ước lượng. LRT không gặp hai vấn đề đó, nên là lựa chọn an toàn hơn.
Kiểm định score chỉ khớp mô hình bị ràng buộc.
Nó xem xét độ dốc của log-hợp lý tại các giá trị tham số theo giả thuyết không. Nếu giả thuyết không đúng, độ dốc nên gần 0. Độ dốc lớn nghĩa là hợp lý sẽ tăng nếu bạn cho phép các tham số đó rời khỏi giá trị không.
Điều này khiến kiểm định score hữu ích khi mô hình đầy đủ đắt đỏ hoặc khó khớp. Nó còn được biết đến là kiểm định nhân tử Lagrange, và thường dùng để sàng lọc các biến dự báo tiềm năng trước khi bạn thêm chúng vào.
Thống kê LRT theo phân phối chi-bình phương khi mẫu lớn, nhưng điều đó không khiến LRT là một "kiểm định chi-bình phương" theo nghĩa thông thường.
"Kiểm định chi-bình phương" là nhãn rộng cho bất kỳ kiểm định nào có thống kê theo phân phối chi-bình phương. Hầu hết thời gian, người ta dùng nó để chỉ kiểm định chi-bình phương Pearson về độc lập hoặc độ phù hợp trong các bảng chéo.
Dù vậy, hai thứ có liên quan. Phiên bản tỷ số hợp lý của kiểm định Pearson được gọi là G-test, và nó so sánh tần suất quan sát và kỳ vọng bằng log-hợp lý thay vì các sai khác bình phương. Khi mẫu lớn, cả hai cho kết quả tương tự.
Dưới đây là so sánh ba kiểm định dựa trên mô hình:
| Kiểm định Wald | Kiểm định tỷ số hợp lý | Kiểm định score | |
|---|---|---|---|
| Mô hình bạn khớp | Chỉ mô hình đầy đủ | Mô hình bị ràng buộc và mô hình đầy đủ | Chỉ mô hình bị ràng buộc |
| Đo lường điều gì | Khoảng cách của ước lượng tới giá trị theo giả thuyết không, tính theo sai số chuẩn | Độ chênh giữa các log-hợp lý đã tối đa hóa | Độ dốc của log-hợp lý tại các giá trị theo giả thuyết không |
| Nơi bạn sẽ gặp | P-value của hệ số trong tóm tắt hồi quy | So sánh mô hình lồng nhau và phân tích độ lệch | Sàng lọc biến dự báo mới, các mô hình khó khớp |
| Điểm yếu | Phụ thuộc cách tham số hóa, kém tin cậy khi ước lượng rất lớn | Yêu cầu khớp cả hai mô hình | Chỉ dùng thông tin gần các giá trị theo giả thuyết không |
| Phân phối khi mẫu lớn | Chi-bình phương | Chi-bình phương | Chi-bình phương |
Tỷ số hợp lý so với các kiểm định thống kê khác
Cả hai thuật ngữ đều có chữ "ratio" và đều phổ biến trong hồi quy logistic. Sự tương đồng kết thúc ở đó.
Tỷ số hợp lý so sánh việc hai giả thuyết giải thích dữ liệu quan sát tốt đến mức nào. Tỷ số odds so sánh odds của một kết cục giữa hai nhóm hoặc điều kiện.
Odds là xác suất xảy ra sự kiện chia cho xác suất nó không xảy ra. Xác suất rời bỏ 25% nghĩa là odds 0,25 / 0,75, hay 1 trên 3.
Trong mô hình rời bỏ trước đó, hệ số của support_tickets là 0,456. Số mũ của nó cho tỷ số odds khoảng 1,58, nghĩa là mỗi phiếu hỗ trợ tăng thêm nhân odds rời bỏ lên 1,58 lần.
Đó là một phát biểu về một hiệu ứng trong dữ liệu. Tỷ số hợp lý là một phát biểu về bằng chứng - một giả thuyết hay mô hình giải thích cùng dữ liệu tốt hơn giả thuyết khác bao nhiêu.
Vì vậy tỷ số odds trả lời "hiệu ứng lớn đến đâu?", và tỷ số hợp lý trả lời "dữ liệu ủng hộ lời giải thích nào hơn?"
Trong y học, "tỷ số hợp lý" có một nghĩa thứ hai. Nó mô tả mức một kết quả xét nghiệm thay đổi odds rằng bệnh nhân mắc một tình trạng nào đó bao nhiêu, và nó không liên quan đến khớp mô hình hay p-value.
Tỷ số hợp lý chẩn đoán đến từ hai thuộc tính của một xét nghiệm:
Giả sử một xét nghiệm có độ nhạy 90% và độ đặc hiệu 80%.
Tỷ số hợp lý dương, hay LR+, cho biết kết quả dương tính phổ biến hơn bao nhiêu ở những người có tình trạng so với người không có:
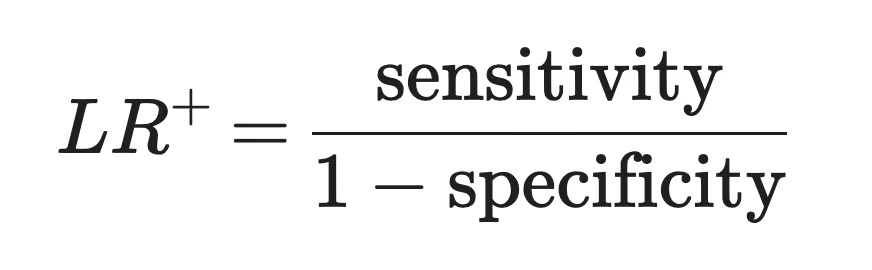
Tỷ số hợp lý dương
Với xét nghiệm ví dụ, đó là 0,9 / 0,2 = 4,5. Kết quả dương phổ biến gấp 4,5 lần ở người có tình trạng. Giá trị trên 1 làm tăng odds của tình trạng, và giá trị càng cao, kết quả dương càng cung cấp nhiều thông tin.
Tỷ số hợp lý âm, hay LR-, cho biết kết quả âm tính phổ biến thế nào ở người có tình trạng so với người không có:
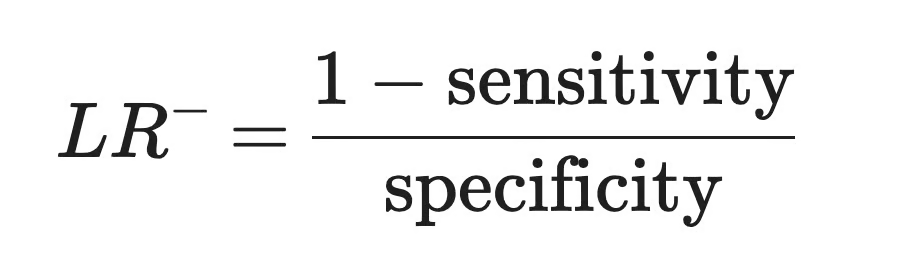
Tỷ số hợp lý âm
Với xét nghiệm ví dụ, đó là 0,1 / 0,8 = 0,125. Giá trị dưới 1 làm giảm odds của tình trạng, và giá trị càng gần 0, kết quả âm càng cung cấp nhiều thông tin.
Tỷ số hợp lý chẩn đoán hữu ích vì chúng cập nhật những gì bạn biết trước khi xét nghiệm:
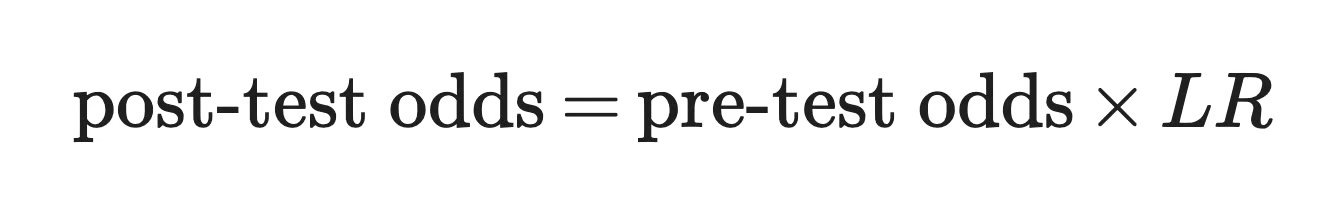
Tỷ số hợp lý chẩn đoán
Giả sử 10% bệnh nhân giống như bệnh nhân này mắc tình trạng. Đó là odds trước xét nghiệm 0,1 / 0,9, tức khoảng 0,111.
Sau một kết quả dương, odds trở thành 0,111 * 4,5 = 0,5, tương ứng xác suất khoảng 33%. Sau một kết quả âm, chúng trở thành 0,111 * 0,125 = 0,014, tức khoảng 1,4%.
Đây là nơi duy nhất trong bài mà một tỷ số hợp lý dẫn đến xác suất của một giả thuyết, và chỉ có thể vì odds trước xét nghiệm cung cấp tiên nghiệm.
Cả hai ngôn ngữ đều có mọi thứ bạn cần để chạy LRT trong vài dòng. Tôi sẽ dùng bộ dữ liệu rời bỏ đã đề cập, để các con số khớp với phần diễn giải và hồi quy.
Bạn sẽ cần numpy, pandas, statsmodels, và scipy. Bắt đầu bằng cách tạo bộ dữ liệu:
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf
from scipy import stats

# Generate a synthetic customer churn dataset
rng = np.random.default_rng(42)
n_customers = 1000

churn = pd.DataFrame({
    "tenure_months": rng.integers(1, 73, n_customers),
    "monthly_charges": rng.uniform(20, 120, n_customers).round(2),
    "support_tickets": rng.poisson(1.5, n_customers),
})

# Churn gets less likely with tenure and more likely with charges and tickets
log_odds = (
    -0.5
    - 0.04 * churn["tenure_months"]
    + 0.01 * churn["monthly_charges"]
    + 0.25 * churn["support_tickets"]
)
churn["churned"] = rng.binomial(1, 1 / (1 + np.exp(-log_odds)))

# Save the data so you can load the same dataset in R
churn.to_csv("churn.csv", index=False)
Trong bộ dữ liệu này, tỷ lệ rời bỏ là 32,1%.
Tiếp theo, khớp các mô hình hồi quy logistic bị ràng buộc và đầy đủ. Thuộc tính .llf chứa log-hợp lý đã tối đa hóa của mỗi mô hình:
# Fit the restricted and full models
reduced_model = smf.logit("churned ~ tenure_months", data=churn).fit(disp=0)
full_model = smf.logit(
    "churned ~ tenure_months + monthly_charges + support_tickets",
    data=churn,
).fit(disp=0)

# Get the maximized log-likelihoods
print(f"Restricted model log-likelihood: {reduced_model.llf:.2f}")
print(f"Full model log-likelihood: {full_model.llf:.2f}")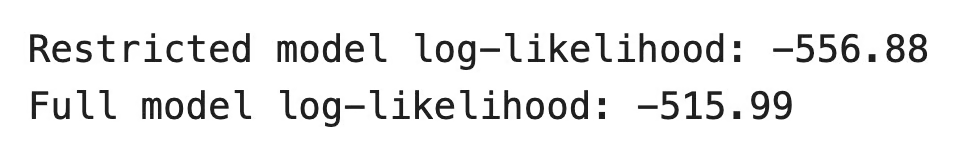
Log-hợp lý của mô hình bị ràng buộc và đầy đủ
statsmodels không có hàm LRT tổng quát cho hồi quy logistic, nên bạn tự tính thống kê từ hai log-hợp lý. Thuộc tính .df_model cho số biến dự báo trong mỗi mô hình, và stats.chi2.sf() trả về p-value:
lr_stat = 2 * (full_model.llf - reduced_model.llf)
df_diff = full_model.df_model - reduced_model.df_model
p_value = stats.chi2.sf(lr_stat, df_diff)

print(f"LR statistic: {lr_stat:.2f}")
print(f"Degrees of freedom: {df_diff:.0f}")
print(f"P-value: {p_value:.1e}")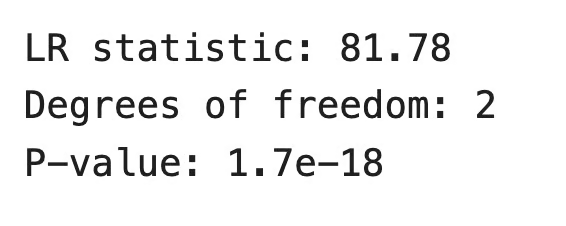
Thống kê kiểm định, bậc tự do và p-value
P-value nhỏ hơn nhiều so với 0,05, nên bạn bác bỏ giả thuyết không. Dữ liệu cung cấp bằng chứng mạnh mẽ rằng monthly_charges và support_tickets cải thiện độ khớp so với mô hình chỉ có tenure_months.
Với so sánh với mô hình chỉ có hệ số chặn, bạn không cần mã bổ sung. statsmodels tính nó cho mọi mô hình hồi quy logistic:
print(f"Intercept-only log-likelihood: {full_model.llnull:.2f}")
print(f"LR statistic: {full_model.llr:.2f}")
print(f"P-value: {full_model.llr_pvalue:.1e}")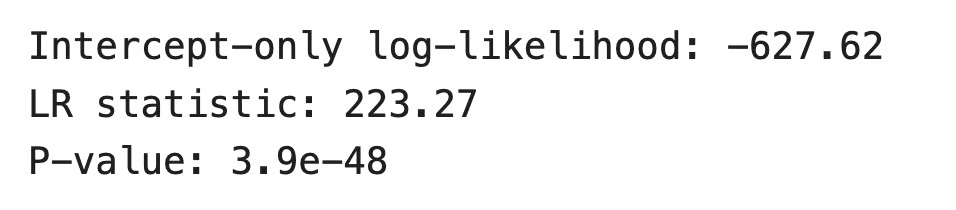
So sánh mô hình đầy đủ với mô hình chỉ có hệ số chặn
R không dùng bộ sinh số ngẫu nhiên như NumPy, nên hãy tải tệp churn.csv từ ví dụ Python để làm việc với dữ liệu giống hệt. Sau đó khớp cả hai mô hình với glm() và truyền chúng vào anova():
# Load the churn dataset saved from Python
churn <- read.csv("churn.csv")

# Fit the restricted and full models
reduced_model <- glm(churned ~ tenure_months, data = churn, family = binomial)
full_model <- glm(
  churned ~ tenure_months + monthly_charges + support_tickets,
  data = churn,
  family = binomial
)

# Check the maximized log-likelihoods
logLik(reduced_model)
logLik(full_model)

# Run the likelihood ratio test
anova(reduced_model, full_model, test = "Chisq")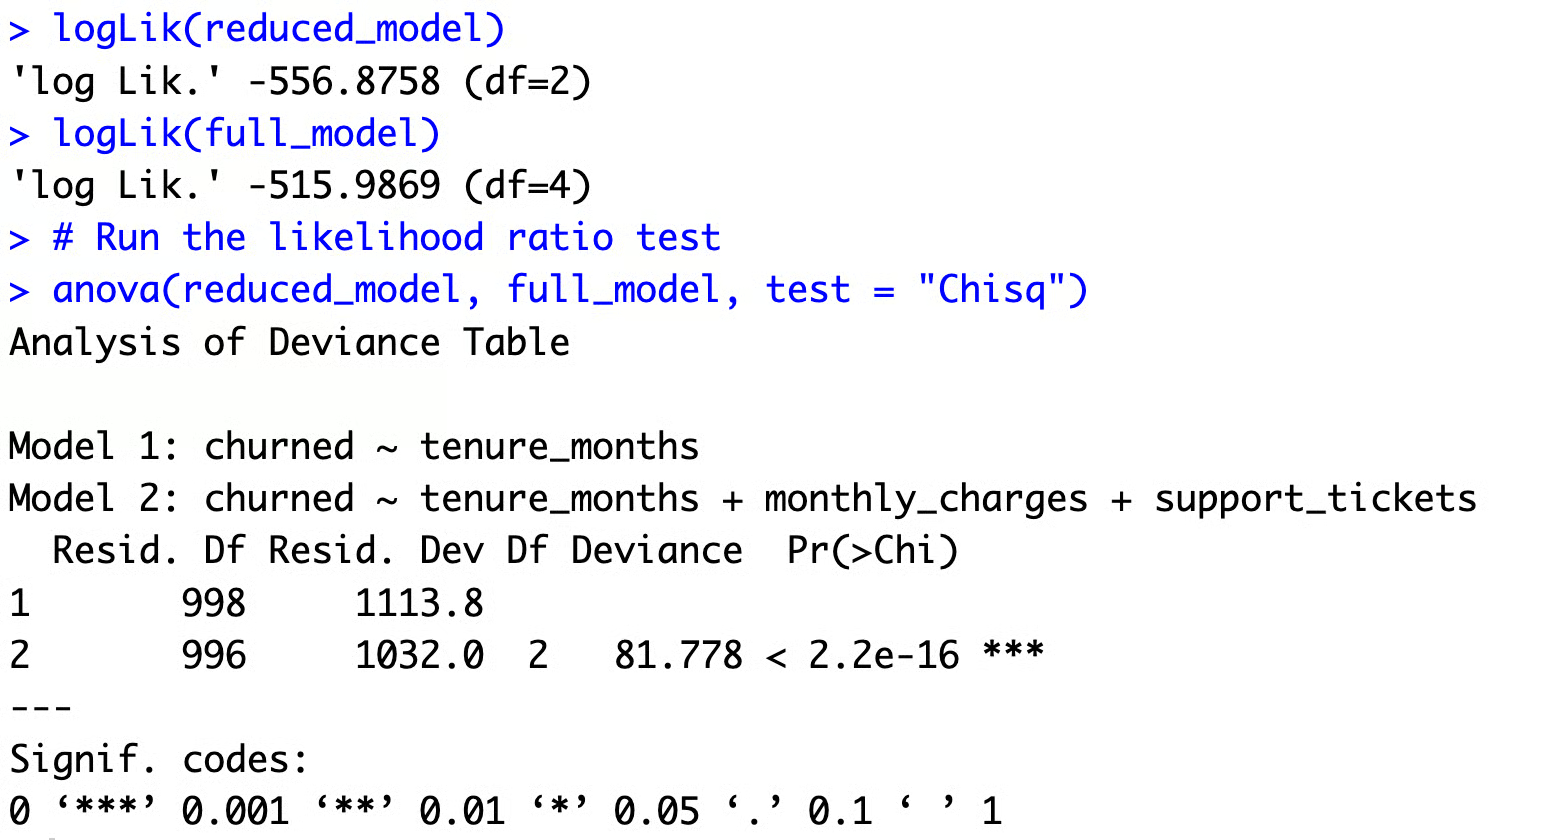
Log-hợp lý và kiểm định tỷ số trong R
Các giá trị df cạnh mỗi log-hợp lý là số tham số được ước lượng, bao gồm hệ số chặn. Mô hình đầy đủ có nhiều hơn hai, khớp với cột Df trong bảng anova().
Cột Deviance hiển thị 81,778, cùng thống kê LR bạn thu được trong Python. Đó là phân tích độ lệch trong phần GLM - mức giảm độ lệch dư từ 1113,8 xuống 1032,0 chính là thống kê kiểm định.
R in p-value là < 2.2e-16 vì đó là giá trị nhỏ nhất nó hiển thị mặc định, không phải vì khác với kết quả Python. Dù thế nào, kết luận giống nhau, và các biến bổ sung cải thiện độ khớp.
Nếu bạn thích một hàm riêng, lrtest() từ gói lmtest chạy cùng so sánh với lrtest(reduced_model, full_model).
LRT hoạt động tốt trong các bối cảnh đã đề cập, nhưng kết quả chi-bình phương của nó phụ thuộc vào một vài điều kiện.
LRT tiêu chuẩn chỉ so sánh các mô hình lồng nhau, nơi mô hình bị ràng buộc là trường hợp đặc biệt của mô hình đầy đủ.
Nếu bạn muốn so sánh hồi quy logistic với mô hình probit, hoặc hai mô hình với các biến dự báo khác nhau, không mô hình nào là trường hợp đặc biệt của mô hình kia. Phân phối chi-bình phương không áp dụng ở đó. Hãy dùng các tiêu chí thông tin như AIC và BIC, hoặc kiểm định Vuong cho các mô hình không lồng nhau.
Kiểm định so sánh các hợp lý đã tối đa hóa, nên cả hai mô hình phải được khớp bằng hợp lý cực đại trên cùng dữ liệu.
Hai điều phổ biến có thể sai ở đây. Các mô hình hiệu ứng hỗn hợp được khớp bằng REML, mặc định trong nhiều gói, không thể so sánh bằng LRT khi chúng khác nhau ở hiệu ứng cố định - vì vậy hãy khớp lại bằng hợp lý cực đại trước. Và các mô hình có phạt như lasso hoặc ridge không tối đa hóa chính hợp lý, nên kiểm định thông thường không áp dụng cho chúng.
Các mô hình cũng cần cùng các quan sát. Nếu một biến dự báo có giá trị thiếu, mô hình đầy đủ có thể loại bỏ các hàng, và hai log-hợp lý không còn so sánh được.
Định lý Wilks là kết quả khi mẫu lớn. Nó đúng dưới các điều kiện quy luật, nghĩa là hợp lý trơn tru, các tham số nhận diện được, và các giá trị tham số thật nằm bên trong miền cho phép thay vì ở biên.
Khi các điều kiện này đúng, phân phối chi-bình phương là xấp xỉ tốt khi mẫu lớn. Nó vẫn chỉ là xấp xỉ.
Với mẫu nhỏ, thống kê LRT có thể không theo phân phối chi-bình phương, và p-value có thể quá nhỏ hoặc quá lớn.
Bạn có vài lựa chọn. Bootstrap tham số mô phỏng các bộ dữ liệu mới từ mô hình bị ràng buộc và xây dựng phân phối của thống kê. Với các trường hợp đơn giản, như bảng chéo, các kiểm định chính xác tránh được xấp xỉ.
Một số giả thuyết không đặt tham số ở mép của miền cho phép. Ví dụ phổ biến nhất là kiểm định xem phương sai hiệu ứng ngẫu nhiên trong mô hình hỗn hợp có bằng 0 không, vì phương sai không thể âm.
Trong trường hợp này, thống kê không theo phân phối chi-bình phương thông thường. Với một thành phần phương sai, nó theo hỗn hợp 50:50 của chi-bình phương với 0 và 1 bậc tự do, nên p-value tiêu chuẩn khoảng gấp đôi so với nên có. Kiểm định tiêu chuẩn ở đây là bảo thủ, nghĩa là bỏ sót hiệu ứng thật thường xuyên hơn.
Kiểm định số thành phần trong mô hình hỗn hợp (mixture) có vấn đề tương tự. Khi bạn so sánh một thành phần với hai, các điều kiện quy luật thất bại, và xấp xỉ chi-bình phương không còn đúng.
LRT giả định mô hình đầy đủ là đúng. Nếu cả hai mô hình mô tả sai phân phối dữ liệu, như mô hình Poisson cho dữ liệu đếm có phương sai lớn hơn nhiều so với trung bình, thống kê sẽ không theo phân phối chi-bình phương ngay cả khi mẫu lớn.
Hãy kiểm tra độ khớp của mô hình đầy đủ trước khi tin vào kiểm định. Với dữ liệu đếm quá phân tán, mô hình nhị thức âm hoặc kiểm định F dựa trên quasi-likelihood thường là lựa chọn tốt hơn.
Vì vậy xấp xỉ chi-bình phương là mặc định, không phải đảm bảo, và chỉ áp dụng khi thiết lập phù hợp với các điều kiện đằng sau định lý Wilks.
Tỷ số hợp lý so sánh mức hai giả thuyết hoặc mô hình giải thích cùng dữ liệu quan sát tốt đến mức nào. Đó là toàn bộ ý tưởng, và mọi thứ khác trong bài xây dựng trên đó.
Kiểm định tỷ số hợp lý biến ý tưởng đó thành thủ tục chính quy. Nó khớp hai mô hình lồng nhau, so sánh các log-hợp lý đã tối đa hóa của chúng, và dùng phân phối chi-bình phương để lấy p-value. Bạn sẽ thấy nó thường nhất trong hồi quy logistic và các GLM khác, và cả statsmodels lẫn R đều chạy nó với vài dòng mã.
Nhưng hãy nhớ ý nghĩa của con số. Tỷ số hợp lý cho thấy mức ủng hộ tương đối cho một giả thuyết so với giả thuyết khác, không phải xác suất rằng giả thuyết nào đúng. Để có điều đó, bạn cần odds tiên nghiệm, như trong kiểm tra chẩn đoán.
Nếu bạn muốn đi xa hơn, các bước tiếp theo là những khối xây dựng đằng sau kiểm định: bản thân hợp lý, ước lượng hợp lý cực đại, và cách kiểm định Wald và các kiểm định giả thuyết khác so với LRT.
Học cùng DataCamp
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {Khóa học} other {Khóa học}}
{count, plural, one {blog} other {blog}}
Matt Crabtree
10 phút
