
Last chance! 50% off DataCamp Premium
Sale ends in
回帰の出力や論文で「尤度比」という用語を目にして、何を示しているのか分からなかったことはありませんか?
同じ経験をした方は多いはずです。尤度比は仮説検定、モデル比較、分類、診断テストなどで頻出しますが、分野ごとに少しずつ使い方が異なります。多くの解説は、そもそも尤度が何かを理解する前に、検定統計量やカイ二乗分布から話を始めます。その結果、計算はできても説明はできない数値だけが手元に残りがちです。
要するに、尤度は、あるパラメータ値や統計モデルが観測データをどれだけうまく説明できるかを示します。尤度比は一方の尤度をもう一方の尤度で割ったもので、2つの仮説のどちらが、どの程度データからより支持されているかを示します。
本記事では、この核心となる考え方と式、尤度比検定とその解釈、そして実務で尤度比に出会う場面を順に解説します。
統計を復習したい場合は、当社の確率・統計コースをチェックして、最適な学習を見つけてください。
尤度比は、ある仮説の下での観測データの尤度を、別の仮説の下での同じデータの尤度で割ったものです。2つの仮説は、2つのパラメータ値であっても、2つの完全な統計モデルであってもかまいません。
この比が答えるのは、どちらの説明がデータをよりよく説明するかであって、データそれ自体がどれくらい「起こりやすい」かではありません。
これは重要な違いです。例えば、公平なコインで任意の20回の表裏の並びが出る確率は約100万分の1です。したがって、小さな尤度それ自体にはあまり意味がありません。別の尤度と並べて初めて意味を持ちます。
コインを10回投げて8回表が出たとします。仮説Aはコインは公平(表の確率0.5)。仮説Bはコインは表に偏っている(表の確率0.8)とします。
どちらの仮説でも8回の表は起こりえますが、偏ったコインの方がその結果をはるかに頻繁に生みます。したがって、データは後者の仮説をより支持しており、尤度比はその「どれだけ」を数値化します。具体的な値は後半の例で計算します。
尤度と確率は同じ式を使いますが、答える問いが異なります。
全ての可能な結果にわたる確率の総和は1になりますが、全ての可能なパラメータ値にわたる尤度の総和は1にはなりません。だからこそ、尤度は仮説が真である確率ではなく、尤度比も同様です。
どの尤度比でも、基本の流れは同じ5ステップです。
分子にどちらの尤度を置くかで意味は変わります。仮説Aを分子に置いた場合:
比が4なら、観測データはBの下よりもAの下で4倍起こりやすいという意味です。Aが真である確率が4倍という意味ではありません。
分子と分母を入れ替えれば逆数になります。Aに有利な4という比は、Bの側から見れば0.25になり、同じ内容を表します。
分野によって慣習が異なります。尤度比検定では帰無仮説を分子に置くのが一般的で、小さい値が帰無仮説への反証になります。一方で、他の多くの用途では対立仮説を分子に置きます。
ですから、尤度比を解釈する前に、どの仮説が分子にあるかを必ず確認してください。
基本的な尤度比は、あるデータに対する一方の尤度を、他方の尤度で割ったものです。
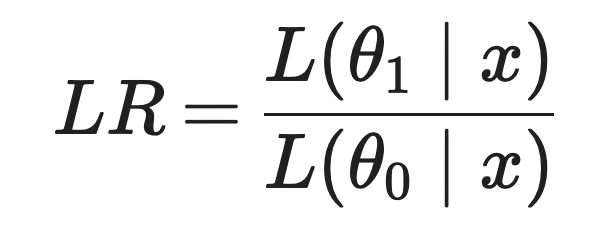
尤度比の式
各記号の意味は次のとおりです。
x: 観測データ(例:10回中8回表)theta_1 と theta_0: 比較したい2つのパラメータ値または仮説(例:表の確率0.8と0.5)L(theta | x): データが与えられたときの theta の尤度。これは、theta が真のパラメータであるときの x の確率(連続データでは密度)に等しい独立な観測では、尤度は観測ごとの確率の積になります。
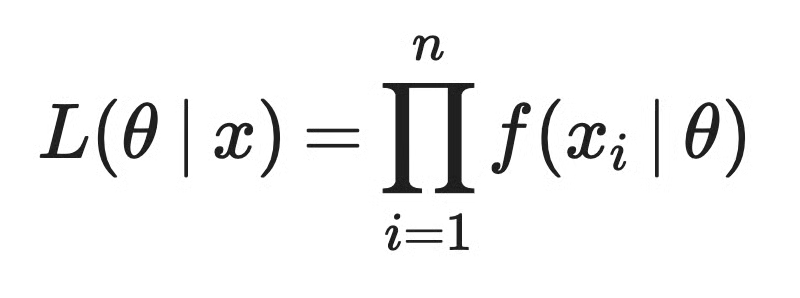
独立観測における尤度
ここから問題が始まります。各因子は1未満なので、サンプルが大きくなるほど積は急速に小さくなります。
公平なコインで1,000回の特定の並びが出る確率はおよそ 9.3 * 10^-302 で、64ビット浮動小数点数が表現できる最小の数に近い値です。2,000回では、Python で 0.5 ** 2000 を計算すると 0.0 になります。
対数はこの問題を回避する方法です。積の対数は対数の和なので、対数尤度は極小の数の積を扱いやすい数の和に変えます。
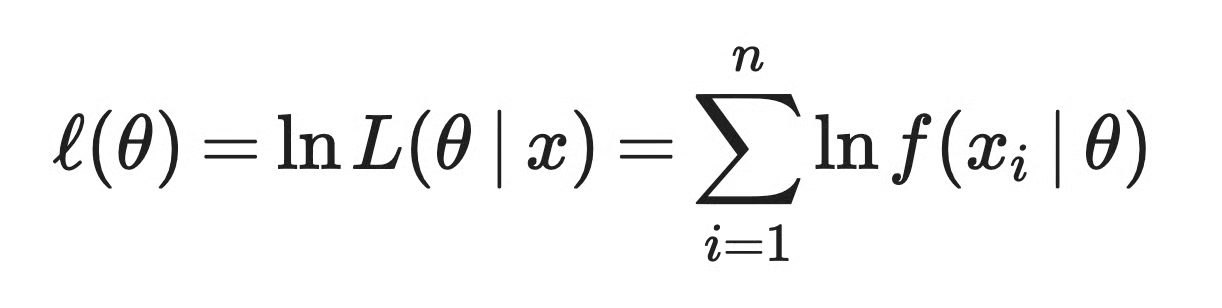
対数尤度
比は差になります。
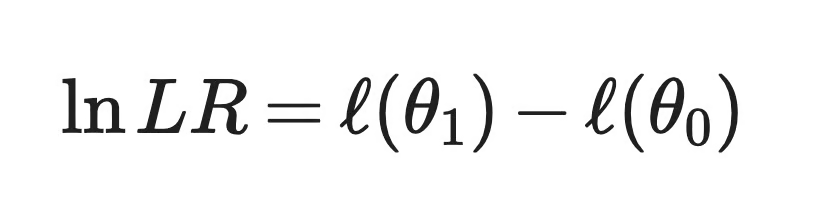
対数尤度比
和は積より微分が容易です。これは最尤推定でも対数尤度を用いる理由です。
対数版の読み方は、1を基準にする比と同じで、基準が0になるだけです。値が0なら支持は同等、正なら theta_1 を、負なら theta_0 を支持します。
先ほどのコインに戻りましょう。10回投げて表8回、裏2回が出ました。
2つの仮説は次のとおりです。
仮説0: コインは公平で、p = 0.5
仮説1: コインは表に偏っており、p = 0.8
10回中の表の回数は二項分布に従うので、各仮説の尤度は次のとおりです。
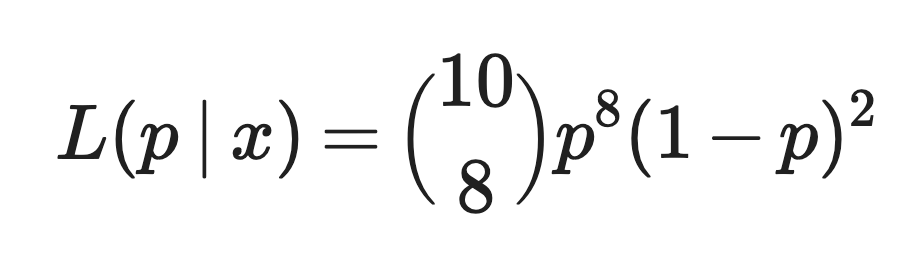
尤度比の例
公平なコインの仮説の下では:
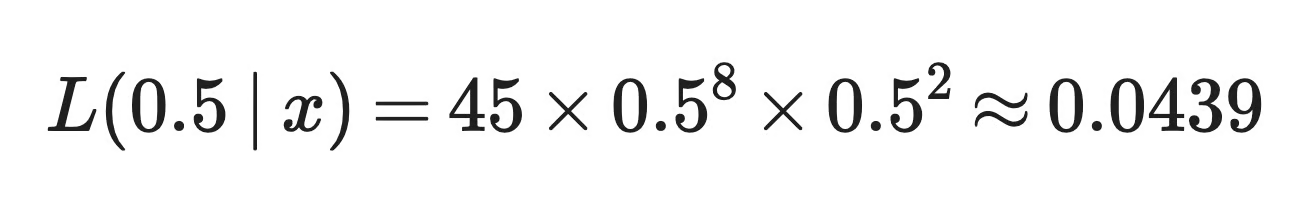
尤度比の例
偏ったコインの仮説の下では:
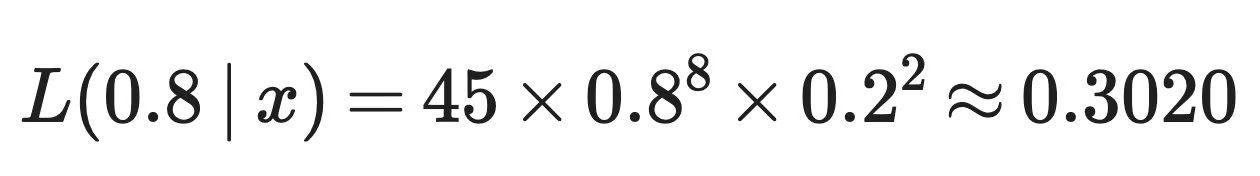
尤度比の例
尤度比は次のとおりです。
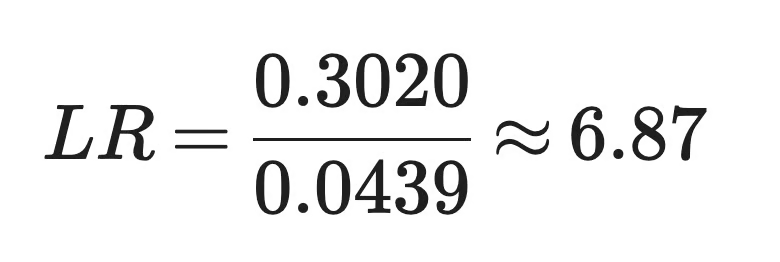
尤度比の例
二項係数45は両方の尤度に現れるため、比では打ち消し合います。コインの並びの「具体的な順序」の確率を使っても、同じ6.87が得られます。
平たく言えば、この観測データは、そのコインが80%の確率で表を出す場合の方が、公平な場合に比べて約6.9倍起こりやすい、ということです。それだけです。
この比は、コインが偏っている確率が6.9倍という意味ではありません。どちらの仮説が真である確率を得るには、両者の事前確率が必要です。事前オッズが50/50なら、事後オッズは6.87対1、すなわち偏ったコインの確率は約87%になりますが、その数値は選んだ事前分布に依存します。
また、支持の関係はあくまでこの2つの仮説間の相対比較です。例えば p = 0.7 は比較の対象に入っていません。ここでは、10回中8回が表のため0.8が最尤推定値にもなっており、このデータからは他の p の値がこれ以上の支持を受けることはありません。
コインの例では p の2つの固定値を比較しました。統計で扱う多くの問いは、例えば回帰モデルに説明変数をいくつか追加すると改善するか、といったより広いものです。
尤度比検定は、その種の問いに答えます。2つのネストされたモデル(小さいモデルが大きいモデルの特殊例)を比較します。
検定は次の5ステップです。
各モデルは、事前に選んだパラメータ値ではなく、最尤推定値で評価します。これはコインの例との主な違いです。
尤度比は任意の2つの仮説を比較して相対的な支持を与えますが、p値や棄却の判断までは与えません。LRTは、ネストされたモデルの最大化尤度の比から検定統計量を作り、その分布を用いて帰無仮説を棄却するかどうかを判断します。すべてのLRTは尤度比を使いますが、すべての尤度比がLRTの一部とは限りません——本記事後半の診断テストの尤度比がその一例です。
LRTは、制限モデルを分子に置いた最大化尤度の比から始まります。
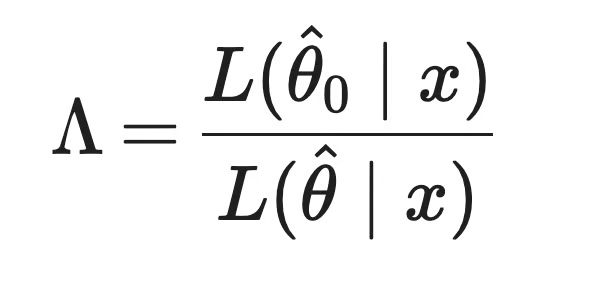
尤度比検定の検定統計量
ここで、theta_hat_0 は制限モデル下での最尤推定、theta_hat は完全モデルでの推定です。完全モデルは制限モデルを包含しているため、当てはまりは常に少なくとも同等以上です。したがって lambda は0から1の間になります。
検定統計量は次のとおりです。
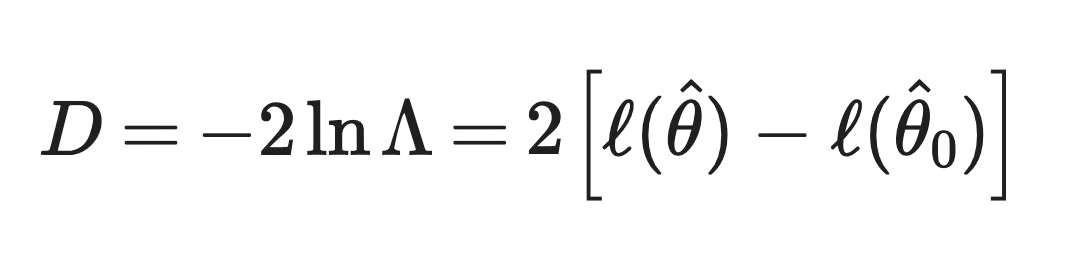
尤度比検定の検定統計量
ここで対数を使う理由は前述と同じです。極小の数の比を、各統計ソフトが報告する対数尤度の差に変換できます。
-2 には2つの役割があります。lambda <= 1 なので、ln(lambda) は0か負になり、マイナスを掛けることで、完全モデルの当てはまりが良くなるほど大きくなる正の数に変わります。さらに2を掛けることで、この統計量がカイ二乗分布に従うようスケールします。一般化線形モデルでは、D は2つのモデルの逸脱度の差と同じで、しばしばその形で報告されます。
Wilksの定理がこの検定を支えています。帰無仮説が真で標準的な規則性条件が成り立つとき、サンプルサイズが大きくなるにつれて D は近似的にカイ二乗分布に従うと述べます。平たく言えば、モデルはネストされており、帰無のパラメータ値は許容範囲の端にない必要があります。これらが破れるとどうなるかは、後述の「限界と仮定」で扱います。
自由度は通常、2つのモデル間の自由パラメータ数の差に等しくなります。完全モデルが2つの予測子を追加したなら、D は自由度2のカイ二乗分布と比較します。
つまり、ロジスティック回帰、ポアソン回帰、その他ほとんどの最尤推定で当てはめるモデルに同じ参照分布が使えます。
たとえば、顧客がサブスクリプションを解約するかどうかを予測したいとします。データセットには1,000人の顧客がいて、そのうち約32%が離脱しています。
ロジスティック回帰モデルを2つ当てはめます。
制限モデル: tenure_months のみから離脱を予測。対数尤度は -556.88
完全モデル: monthly_charges と support_tickets を追加。対数尤度は -515.99
各要素はこの例に次のように対応します。
帰無仮説: monthly_charges と support_tickets の係数は共に0(追加の予測子は当てはまりを改善しない)
対立仮説: 少なくとも一方の係数は0ではない
検定統計量: D = 2 * (-515.99 - (-556.88)) = 81.78
自由度: 完全モデルは2つ多くパラメータがあるため、自由度は2
p値: 自由度2のカイ二乗分布の下で、これ以上に大きい統計量が出る確率で、約 1.7 * 10^-18
このp値は0.05などの一般的な閾値よりはるかに小さいため、帰無仮説を棄却します。追加の予測子が当てはまりを改善するという強い証拠がデータから得られます。
ただし、帰無を棄却したからといって、完全モデルが用途にとって最適とは限りません。
サンプルが大きいと、ごく小さな当てはまりの改善でもp値は小さくなります。検定は効果の大きさや新しいデータに対する予測性能を教えてくれません。大きいモデルを採用する前に、係数とホールドアウトデータでの性能を確認してください。
また、p値が大きいからといって、追加の予測子が無用だと証明されるわけではありません。単に、帰無仮説に反する十分な証拠がデータからは得られなかったことを意味します。
LRTは、追加パラメータが当てはまりを改善するかどうかを教えてくれます。その改善に意味があるかどうかの判断は、引き続き利用者の役目です。
LRTは回帰モデルの比較で最もよく見かけます。考え方は常に同じで、制限モデルを当てはめ、完全モデルを当てはめ、最大化対数尤度を比較します。
ロジスティック回帰はLRTが最も一般的に登場する場所です。
解釈の節では、tenure_months のみのモデルと、monthly_charges と support_tickets を含むモデルを比較しました。さらに一歩進めて、完全モデルと切片のみのモデル(すべての顧客に同じ離脱確率を予測する)を比較することもできます。
同じ離脱データで、切片のみモデルの対数尤度は -627.62、完全モデルは -515.99 です。これにより D = 2 * (-515.99 - (-627.62)) = 223.27、自由度は予測子ごとに1で合計3、p値は約 3.9 x 10^-48 となります。
この検定は、予測子をまとめて見たとき、まったく予測子がない場合より離脱をよく説明できるかを問うものです。これは線形回帰における全体のF検定のロジスティック版で、statsmodels はモデル要約で LLR p-value として報告します。
ロジスティック回帰は一般化線形モデル(GLM)と呼ばれる大家族の一員です。この家族には、カウント用のポアソン回帰や、正の連続値用のガンマ回帰なども含まれます。
すべてのGLMは逸脱度(deviance)を報告し、これは完全当てはまりからの離れ具合を測ります。ネストされた2つのGLMでは、逸脱度の差がLRT統計量 D に等しく、しばしば分析(アナリシス)・オブ・ディビアンスと呼ばれます。
自由度はこれまでと同様、パラメータ数の差です。ガンマやガウスGLMのように分散パラメータを推定するモデルでは、カイ二乗の代わりに逸脱度差に対するF検定がよく用いられます。
最尤法で当てはめたモデルであれば、モデルがネストされている限りLRTを使えます。例えば:
LRTはWald検定やスコア検定と似ています。3者はいずれも同じ帰無仮説を検定し、大標本ではいずれもカイ二乗分布に従います。違いは、どのモデルを当てはめ、何を測るかです。
LRTは両方のモデルを当てはめ、対数尤度を比較します。Wald検定は完全モデルだけを当てはめ、各推定値が帰無値から標準誤差の何倍離れているかを調べます。
単一係数の場合、Wald統計量は推定値をその標準誤差で割ったものです。回帰のサマリー表にあるp値は通常この検定に基づきます。
Wald検定は1つのモデルだけを当てはめればよいので高速です。しかし、パラメータ化の仕方に依存し、ロジスティック回帰では係数が非常に大きいと不安定になりがちです(標準誤差が推定値より速く増えるため)。LRTにはこれらの問題がないため、より堅実な選択です。
スコア検定は制限モデルだけを当てはめます。
対数尤度の、帰無パラメータ値における傾きを見ます。帰無が正しければ傾きは0付近であるはずです。急な傾きは、そのパラメータを帰無値から動かすと尤度が増えることを示唆します。
完全モデルの当てはめが高コスト・困難な場合に便利です。ラグランジュ乗数検定としても知られ、追加候補の予測子を導入する前のふるい分けにもよく使われます。
LRTの統計量は大標本でカイ二乗分布に従いますが、それはLRTが一般的な意味での「カイ二乗検定」と同一であることを意味しません。
「カイ二乗検定」は、統計量がカイ二乗分布に従うあらゆる検定の包括的な呼称です。多くの場合、分割表におけるピアソンの独立性検定や適合度検定を指す意味で使われます。
両者にはつながりもあります。ピアソン検定の尤度比版はG検定と呼ばれ、二乗差の代わりに対数尤度で観測度数と期待度数を比較します。大標本では両者は類似の結果を与えます。
以下は、モデルベースの3つの検定の比較です。
| Wald検定 | 尤度比検定 | スコア検定 | |
|---|---|---|---|
| 当てはめるモデル | 完全モデルのみ | 制限モデルと完全モデル | 制限モデルのみ |
| 測るもの | 推定値の帰無値からの距離(標準誤差単位) | 最大化対数尤度の差 | 帰無値における対数尤度の傾き |
| よく見る場面 | 回帰サマリーの係数p値 | ネストされたモデル比較、逸脱度分析 | 新規予測子のスクリーニング、当てはめ困難なモデル |
| 弱点 | パラメータ化に依存、非常に大きな推定値で不安定 | 両モデルの当てはめが必要 | 帰無近傍の情報しか使わない |
| 大標本での分布 | カイ二乗 | カイ二乗 | カイ二乗 |
他の統計検定との比較
どちらも名前に「比」が付き、ロジスティック回帰でよく見かけますが、共通点はその程度です。
尤度比は、2つの仮説が観測データをどれだけよく説明するかを比較します。オッズ比は、2つの集団や条件での事象のオッズを比較します。
オッズは、事象の確率をそれが起きない確率で割ったものです。離脱確率25%なら、オッズは 0.25 / 0.75、つまり1対3です。
先ほどの離脱モデルでは、support_tickets の係数は0.456で、その指数はオッズ比およそ1.58です。すなわちサポートチケットが1件増えるごとに離脱のオッズが1.58倍になります。
これはデータにおける効果に関する記述です。尤度比は証拠に関する記述であり、同じデータを別の仮説やモデルがどれだけよく説明するかを表します。
つまり、オッズ比は「効果の大きさはどれくらいか?」に答え、尤度比は「どちらの説明をデータがより支持しているか?」に答えます。
医療では、「尤度比」にはもう一つの意味があります。検査結果が、患者がある疾患を持つオッズをどれだけ変えるかを表すもので、モデル当てはめやp値は伴いません。
診断の尤度比は、検査の2つの性質から導かれます。
感度90%、特異度80%の検査を考えます。
陽性的中尤度比(LR+)は、疾患を持つ人で陽性が出る確率が、持たない人で陽性が出る確率の何倍かを示します。
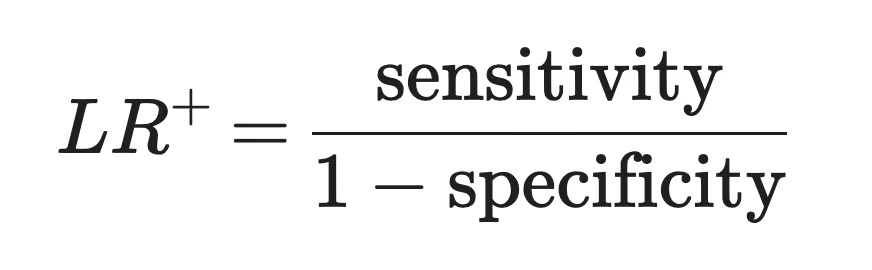
陽性的中尤度比
この例では 0.9 / 0.2 = 4.5 です。陽性は、疾患を持つ人の方が4.5倍起こりやすいことを意味します。1より大きい値は疾患のオッズを高め、値が大きいほど陽性結果の情報量が大きくなります。
陰性的中尤度比(LR-)は、疾患を持つ人で陰性が出る確率が、持たない人で陰性が出る確率の何倍かを示します。
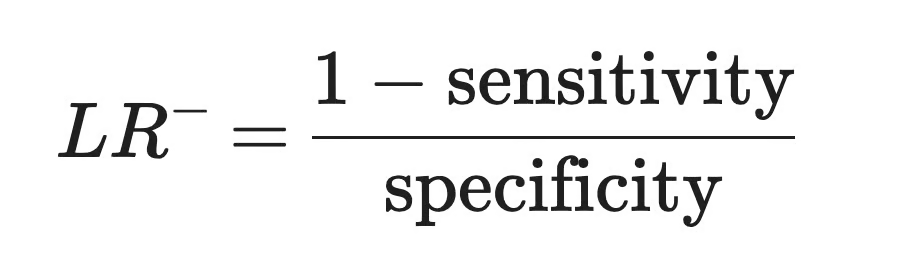
陰性的中尤度比
この例では 0.1 / 0.8 = 0.125 です。1より小さい値は疾患のオッズを下げ、0に近いほど陰性結果の情報量が大きくなります。
診断の尤度比が有用なのは、検査前に知っていた情報を更新できるからです。
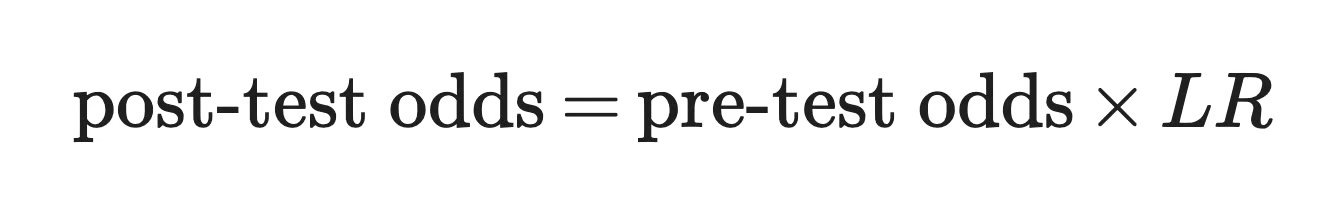
診断における尤度比
このタイプの患者の10%が疾患を持っているとします。事前オッズは 0.1 / 0.9、すなわち約0.111です。
陽性なら事後オッズは 0.111 * 4.5 = 0.5、すなわち確率約33%。陰性なら 0.111 * 0.125 = 0.014、すなわち約1.4%になります。
この記事で尤度比から仮説の確率に至るのはこの部分だけで、事前オッズという「事前分布」が与えられているから可能なのです。
どちらの言語にも、数行でLRTを実行するために必要な機能が揃っています。ここでは先に触れた離脱データを使い、前節の数値と一致するようにします。
必要なのは numpy、pandas、statsmodels、scipy です。まずはデータセットを生成します。
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf
from scipy import stats

# Generate a synthetic customer churn dataset
rng = np.random.default_rng(42)
n_customers = 1000

churn = pd.DataFrame({
    "tenure_months": rng.integers(1, 73, n_customers),
    "monthly_charges": rng.uniform(20, 120, n_customers).round(2),
    "support_tickets": rng.poisson(1.5, n_customers),
})

# Churn gets less likely with tenure and more likely with charges and tickets
log_odds = (
    -0.5
    - 0.04 * churn["tenure_months"]
    + 0.01 * churn["monthly_charges"]
    + 0.25 * churn["support_tickets"]
)
churn["churned"] = rng.binomial(1, 1 / (1 + np.exp(-log_odds)))

# Save the data so you can load the same dataset in R
churn.to_csv("churn.csv", index=False)
このデータセットにおける離脱率は32.1%です。
次に、制限モデルと完全モデルのロジスティック回帰を当てはめます。各モデルの最大化対数尤度は .llf 属性に入っています。
# Fit the restricted and full models
reduced_model = smf.logit("churned ~ tenure_months", data=churn).fit(disp=0)
full_model = smf.logit(
    "churned ~ tenure_months + monthly_charges + support_tickets",
    data=churn,
).fit(disp=0)

# Get the maximized log-likelihoods
print(f"Restricted model log-likelihood: {reduced_model.llf:.2f}")
print(f"Full model log-likelihood: {full_model.llf:.2f}")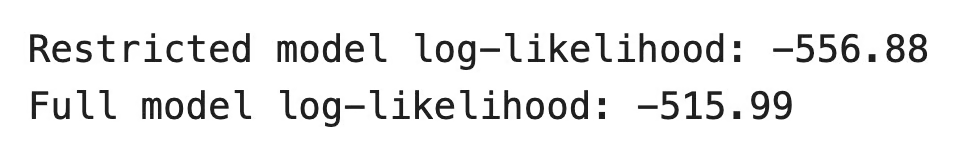
制限モデルと完全モデルの対数尤度
statsmodels にはロジスティック回帰用の汎用LRT関数がないため、2つの対数尤度から統計量を計算します。.df_model は各モデルの予測子の数を示し、stats.chi2.sf() がp値を返します。
lr_stat = 2 * (full_model.llf - reduced_model.llf)
df_diff = full_model.df_model - reduced_model.df_model
p_value = stats.chi2.sf(lr_stat, df_diff)

print(f"LR statistic: {lr_stat:.2f}")
print(f"Degrees of freedom: {df_diff:.0f}")
print(f"P-value: {p_value:.1e}")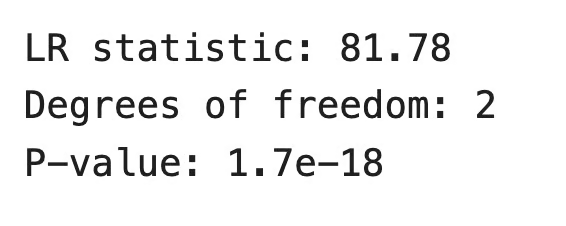
検定統計量、自由度、p値
p値は0.05を大きく下回るため、帰無仮説を棄却します。tenure_months のみのモデルに比べ、monthly_charges と support_tickets が当てはまりを改善するという強い証拠があります。
切片のみモデルとの比較については、追加コードは不要です。statsmodels はすべてのロジスティック回帰モデルでこれを計算します。
print(f"Intercept-only log-likelihood: {full_model.llnull:.2f}")
print(f"LR statistic: {full_model.llr:.2f}")
print(f"P-value: {full_model.llr_pvalue:.1e}")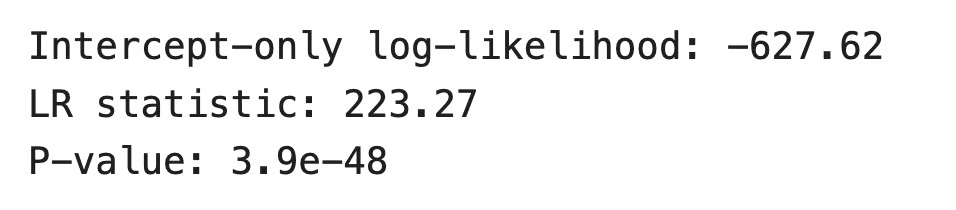
完全モデルと切片のみモデルの比較
RはNumPyと同じ乱数生成器を使わないため、Pythonの例で保存した churn.csv を読み込んで同一データを用います。次に glm() で両モデルを当てはめ、anova() に渡します。
# Load the churn dataset saved from Python
churn <- read.csv("churn.csv")

# Fit the restricted and full models
reduced_model <- glm(churned ~ tenure_months, data = churn, family = binomial)
full_model <- glm(
  churned ~ tenure_months + monthly_charges + support_tickets,
  data = churn,
  family = binomial
)

# Check the maximized log-likelihoods
logLik(reduced_model)
logLik(full_model)

# Run the likelihood ratio test
anova(reduced_model, full_model, test = "Chisq")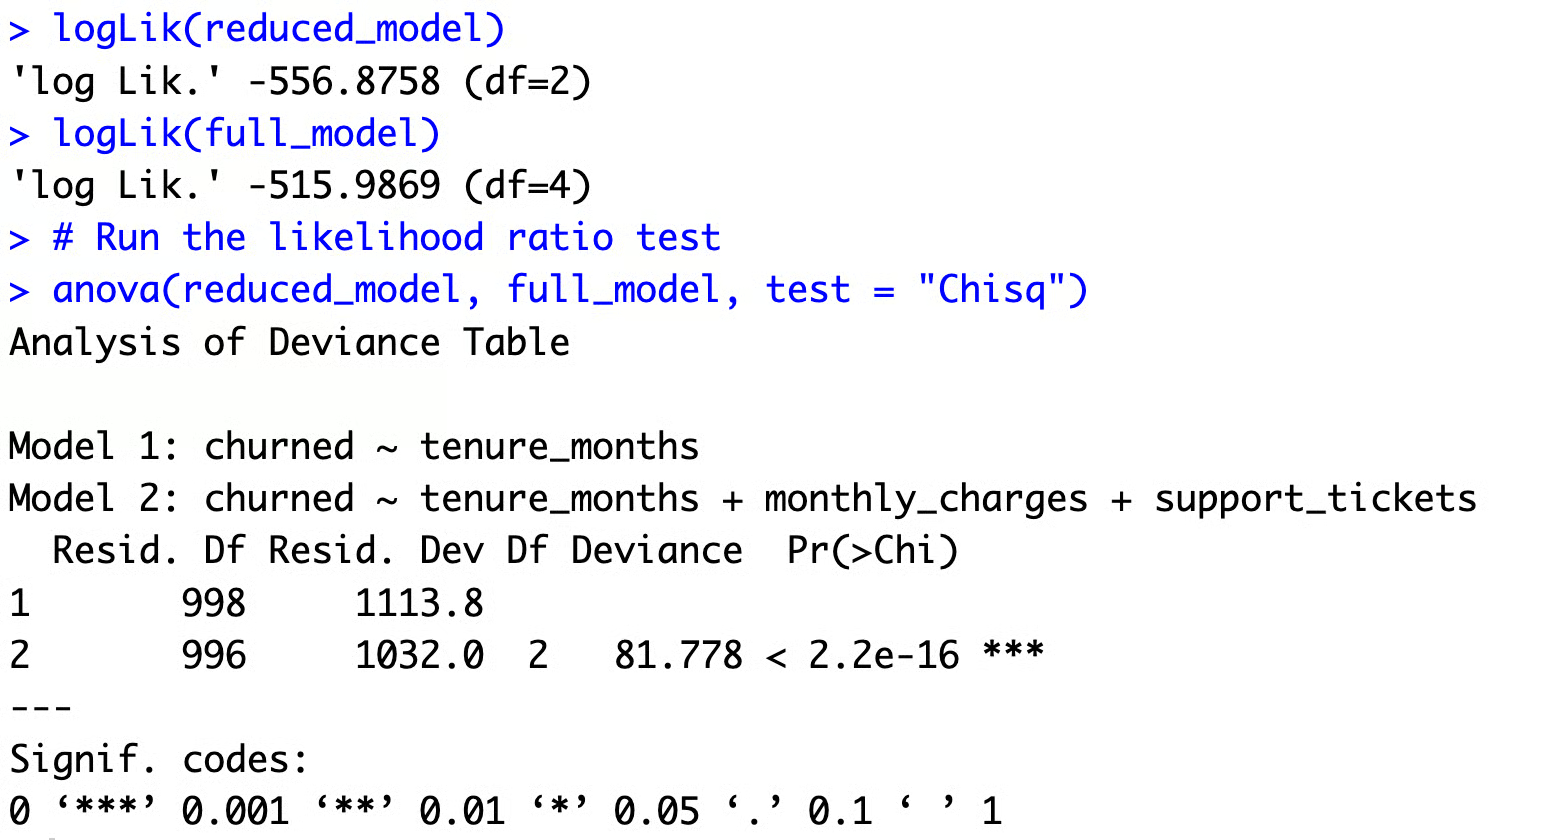
Rにおける対数尤度と尤度比検定
logLik の横に出る df は推定パラメータの数(切片を含む)です。完全モデルは2つ多く、anova() 表の Df 列とも一致します。
Deviance 列の 81.778 は、Pythonで得たLR統計量と同じです。これはGLMの節で触れた逸脱度分析がそのまま働いており、残差逸脱度が 1113.8 から 1032.0 に下がった差が検定統計量になっています。
Rは既定で表示する最小値の都合で p値を < 2.2e-16 と出しますが、Pythonの結果と異なるわけではありません。いずれにせよ結論は同じで、追加の予測子は当てはまりを改善します。
専用関数を使いたい場合は、lmtest パッケージの lrtest() が同じ比較を lrtest(reduced_model, full_model) で実行します。
ここまでの設定ではLRTは有効ですが、カイ二乗による結果は複数の条件に依存します。
標準的なLRTは、制限モデルが完全モデルの特殊例であるネストされたモデルのみを比較します。
ロジスティック回帰とプロビットモデルを比較したい、あるいは異なる予測子を持つ2つのモデルを比較したい場合、どちらも相手の特殊例ではありません。そこではカイ二乗分布は当てはまりません。代わりにAICやBIC、非ネストモデル用のVuong検定を使ってください。
検定は最大化尤度を比較するため、両モデルを同じデータに対して最尤法で当てはめなければなりません。
ここで2つの典型的な落とし穴があります。多くのパッケージで既定のREMLで当てはめた混合効果モデルは、固定効果が異なる場合にLRTで比較できません——最尤で当てはめ直してください。また、ラッソやリッジ回帰 のような正則化モデルは、尤度そのものを最大化しないため、通常の検定は適用できません。
また、両モデルは同じ観測を用いる必要があります。ある予測子に欠損があると完全モデルが行を落とすことがあり、その場合、2つの対数尤度は比較不能になります。
Wilksの定理は大標本での結果です。平たく言えば、尤度が滑らかで、パラメータが識別可能で、真のパラメータが許容範囲の内部にある(境界上ではない)という規則性条件が必要です。
これらが満たされれば、大標本ではカイ二乗分布が良い近似になります。ただし、あくまで近似です。
小標本では、LRT統計量がカイ二乗分布に従わないことがあり、p値が小さすぎたり大きすぎたりすることがあります。
この場合の選択肢として、パラメトリック・ブートストラップにより制限モデルから新しいデータセットをシミュレートして統計量の分布を構築する方法があります。分割表のような単純なケースでは、正確検定により近似を避けられます。
帰無仮説が、パラメータを許容範囲の境界に置く場合があります。最も一般的なのは、混合モデルにおけるランダム効果分散が0かどうかの検定です(分散は負になれない)。
この場合、統計量は通常のカイ二乗分布には従いません。単一の分散成分なら、自由度0と1のカイ二乗の50:50混合に従うため、標準的なp値は本来より約2倍大きくなります。標準的な検定はここでは保守的で、真の効果を見逃しやすくなります。
混合分布モデルの成分数の検定でも同様の問題が起きます。1成分と2成分を比較する場合、規則性条件が破れ、カイ二乗近似は全く成り立ちません。
LRTは完全モデルが正しいことを前提にします。両モデルがデータの分布を誤って仮定している(例:平均より分散がはるかに大きいカウントデータをポアソンで扱う)場合、大標本でも統計量はカイ二乗分布に従いません。
検定を信頼する前に完全モデルの当てはまりを点検してください。過分散のカウントでは、負の二項モデルや準尤度に基づくF検定がより適切なことが多いです。
つまり、カイ二乗近似は既定値であって保証ではありません。Wilksの定理の前提が満たされる場合にのみ適用されます。
尤度比は、2つの仮説やモデルが同じ観測データをどれだけよく説明するかを比較します。これが核心であり、本記事の他の内容はすべてこの上に成り立っています。
尤度比検定は、この考え方を形式的な手続きにします。ネストされた2つのモデルを当てはめ、最大化対数尤度を比較し、カイ二乗分布からp値を求めます。最もよく見るのはロジスティック回帰や他のGLMで、statsmodels とRのどちらでも数行で実行できます。
ただし数値の意味を忘れないでください。尤度比が示すのは、一方の仮説が他方に比べてどれだけ支持されるかという相対的な指標であり、どちらが真である確率ではありません。確率を得るには、診断テストのように事前オッズが必要です。
さらに学ぶなら、検定の土台となる概念——尤度そのもの、最尤推定、そしてWald検定などの他の仮説検定とLRTの比較——に進んでください。
DataCampで学ぶ
コース
コース
コース