
Kurs
Python ile İstatistiğe Giriş
4 sa
199.1K
Bir regresyon çıktısında veya bir çalışmada "olabilirlik oranı" terimini görüp ne anlattığını hiç anlamadığınız oldu mu?
Yalnız değilsiniz. Terim; hipotez testlerinde, model karşılaştırmalarında, sınıflandırmada ve tanısal testlerde sıkça görülür ve her alan bunu biraz farklı kullanır. Çoğu açıklama da daha siz olabilirliğin ne olduğunu bilmeden önce bir test istatistiği ve ki-kare dağılımıyla başlar. Sonuçta hesaplayabildiğiniz ama açıklayamadığınız bir sayı kalır elinizde.
Kısaca, olabilirlik; bir parametre değerinin veya istatistiksel bir modelin gözlemlediğiniz verileri ne kadar iyi açıkladığını gösterir. Olabilirlik oranı bir olabilirliği diğerine böler; böylece iki hipotezden hangisinin verilerden daha çok destek aldığını ve bunun ne kadar olduğunu görebilirsiniz.
Bu yazıda, temel fikri ve formülü, olabilirlik oranı testini ve nasıl yorumlanacağını, ayrıca olabilirlik oranlarını uygulamada nerede göreceğinizi adım adım anlatacağım.
İstatistik tazelemesine mi ihtiyacınız var? Kataloğumuza göz atın: Olasılık ve İstatistik kursları arasından size uygun olanı bulun.
Olabilirlik oranı, gözlenen verilerin bir hipotez altında olabilirliğinin aynı verilerin başka bir hipotez altındaki olabilirliğine bölünmesidir. İki hipotez iki parametre değeri olabileceği gibi iki tam istatistiksel model de olabilir.
Yanıtladığı soru, verilerin ne kadar olası olduğu değil, hangi açıklamanın verileri daha iyi açıkladığıdır.
Bu önemli bir farktır. Adil bir yazı-tura için 20 atışın herhangi bir belirli dizisinin olasılığı yaklaşık milyonda birdir; dolayısıyla tek başına küçük bir olabilirlik pek bir şey söylemez. Yalnızca başka bir olabilirlikle yan yana anlam kazanır.
Diyelim ki bir madeni parayı 10 kez attınız ve 8 tura geldi. Bir hipotez, paranın adil olduğunu ve turanın olasılığının 0,5 olduğunu söyler. Bir diğeri, paranın yanlı olduğunu ve turanın olasılığının 0,8 olduğunu söyler.
Her iki hipotez de 8 tura üretebilir, ancak yanlı para bu sonucu çok daha sık üretir. Dolayısıyla veriler ikinci hipoteze daha fazla destek verir ve olabilirlik oranı bunun ne kadar fazla olduğunu sayısallaştırır. Kesin değerleri bu yazının ilerleyen örnek bölümünde hesaplayacağım.
Olabilirlik ve olasılık aynı formülü kullanır ancak farklı soruları yanıtlar:
Tüm olası sonuçlar üzerindeki olasılıkların toplamı 1 eder, ancak tüm olası parametre değerleri üzerindeki olabilirlikler böyle toplanmaz. Bu yüzden bir olabilirlik, bir hipotezin doğru olma olasılığı değildir; olabilirlik oranı da öyle.
Her olabilirlik oranı aynı beş adımı izler:
Oranın anlamı, hangi olabilirliğin üste konduğuna bağlıdır. A hipotezi paydaysa:
4’lük bir oran, gözlenen verilerin A altında B’ye kıyasla dört kat daha olası olduğu anlamına gelir. Bu, A’nın dört kat daha doğru olma olasılığına sahip olduğu anlamına gelmez.
Pay ve paydayı yer değiştirirseniz, karşılığını (resiprokalini) elde edersiniz. A lehine 4’lük oran, B tarafından bakıldığında aynı şeyi söyleyen 0,25 olur.
Alanlar arasında teamüller farklıdır. Olabilirlik oranı testi genellikle sıfır hipotezini paya koyar; böylece küçük değerler ona karşı kanıt sayılırken, diğer birçok uygulama alternatif hipotezi üste koyar.
Dolayısıyla herhangi bir olabilirlik oranını yorumlamadan önce, payda hangi hipotezin olduğunu kontrol edin.
Temel olabilirlik oranı, verilerin bir olabilirliğini diğerine böler:
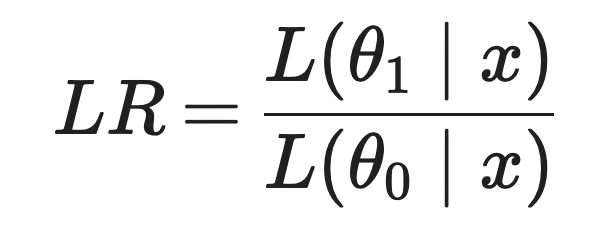
Olabilirlik oranı formülü
Her terim şunu ifade eder:
x: Gözlenen veriler; örneğin 10 atışta 8 turatheta_1 ve theta_0: Karşılaştırmak istediğiniz iki parametre değeri veya hipotez; örneğin turanın 0,8 ve 0,5 olasılığıL(theta | x): Veriler verildiğinde theta’nın olabilirliği; bu da theta gerçek parametre iken x’in olasılığına veya sürekli veriler için yoğunluğuna eşittirBağımsız gözlemlerle, olabilirlik her gözlem için bir olasılığın çarpımıdır:
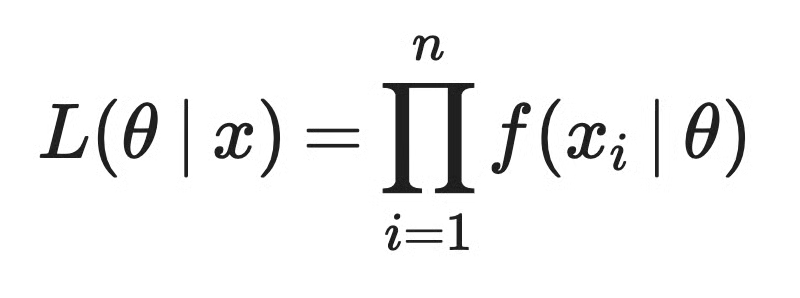
Bağımsız gözlemlerde olabilirlik
Ve sorunlar burada başlar. Her çarpan 1’in altındadır; dolayısıyla örneklem büyüdükçe çarpım hızla küçülür.
Adil bir parayla 1.000 atışın belirli bir dizisinin olasılığı yaklaşık 9,3 * 10^-302’dir; bu da 64 bitlik bir kayan noktanın saklayabileceği en küçük sayıya yakındır. 2.000 atışta, Python’da 0.5 ** 2000 ifadesi 0.0 döndürür.
Logaritmalar bu sorunu aşmanın bir yoludur. Bir çarpımın logu, logların toplamıdır; dolayısıyla log-olabilirlik, küçücük sayıların çarpımını yönetilebilir sayıların toplamına dönüştürür:
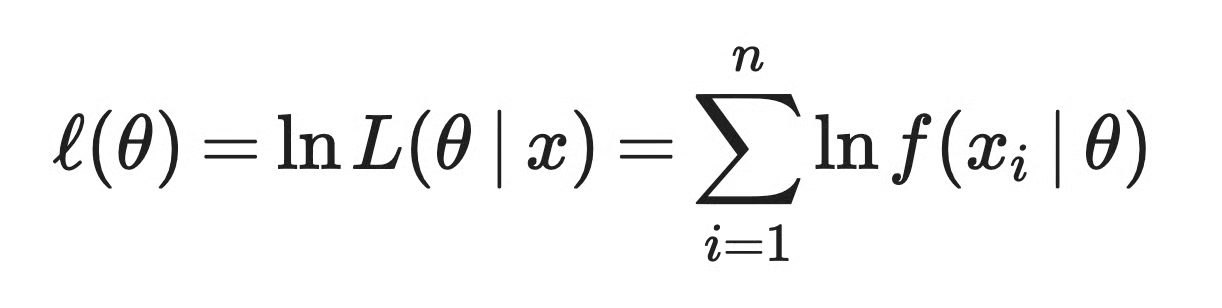
Log olabilirlik
Oran, bir farka dönüşür:
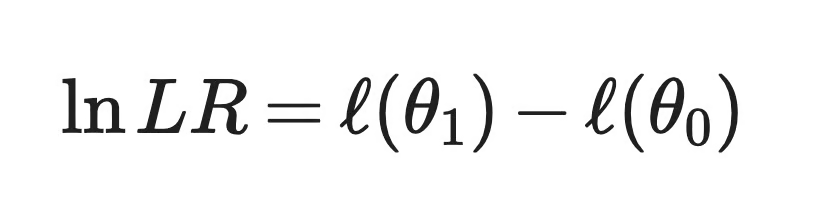
Log olabilirlik oranı
Toplamlar, çarpımlardan türev almaya da daha elverişlidir; bu yüzden maksimum olabilirlik kestirimi de log-olabilirliklerle çalışır.
Log versiyonu, 1 etrafı yerine 0 etrafında olmak üzere oranla aynı şekilde okunur. 0 değeri eşit destek anlamına gelir; pozitif değerler theta_1’i, negatif değerler theta_0’ı destekler.
Az önceki paraya geri dönelim. Parayı 10 kez atıyorsunuz; 8 tura ve 2 yazı geliyor.
İki hipotez şunlardır:
Hipotez 0: Para adildir, dolayısıyla p = 0.5
Hipotez 1: Para tura lehine yanlıdır, dolayısıyla p = 0.8
10 atışta tura sayısı binom dağılımına uyar; dolayısıyla her hipotezin olabilirliği şöyledir:
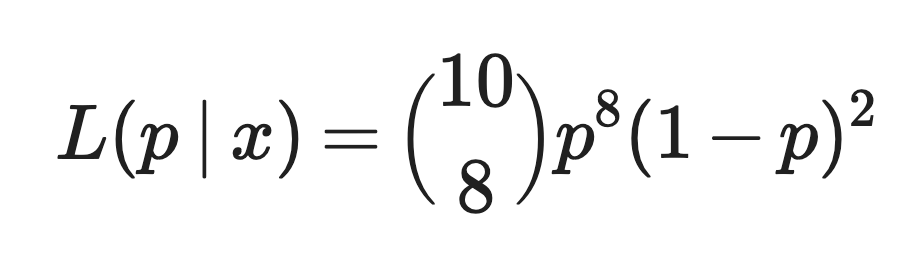
Olabilirlik oranı örneği
Adil para hipotezi altında:
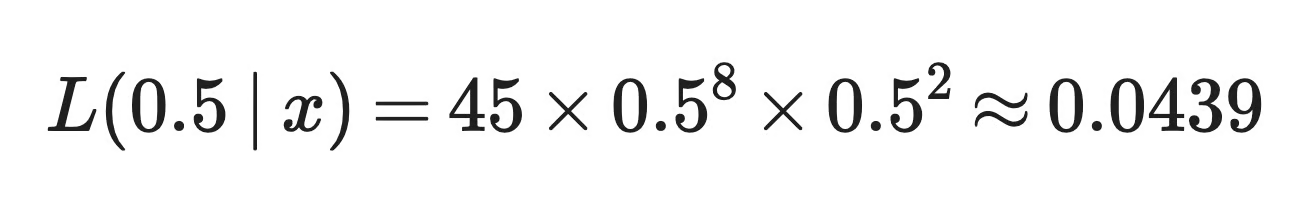
Olabilirlik oranı örneği
Yanlı para hipotezi altında:
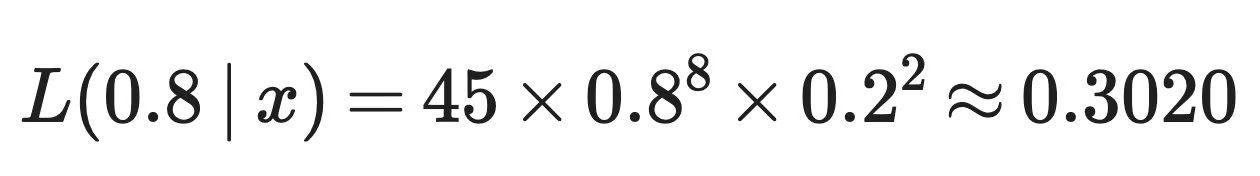
Olabilirlik oranı örneği
Olabilirlik oranı şöyledir:
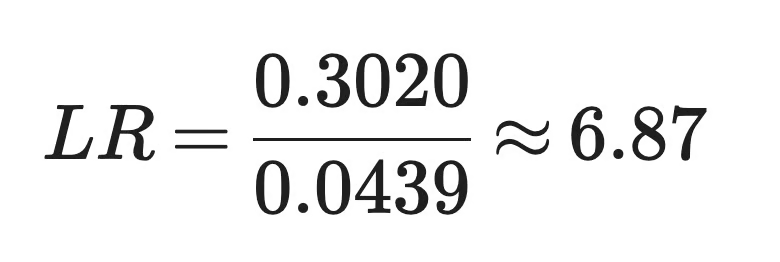
Olabilirlik oranı örneği
45’lik binom katsayısı her iki olabilirlikte de yer aldığından oranda sadeleşir. Atışların tam dizisinin olasılığından da aynı 6,87’yi elde ederdiniz.
Düz Türkçeyle, gözlenen veriler; para turayı %80 getirdiğinde adil olmasına göre yaklaşık 6,9 kat daha olasıdır. Hepsi bu.
Oran, paranın yanlı olmasının 6,9 kat daha olası olduğunu söylemez. Hipotezlerin herhangi birinin doğru olma olasılığını elde etmek için her ikisi için de öncül olasılıklara ihtiyaç vardır. 50/50 öncül oranlarla, artçıl oranlar 6,87’ye 1 olur; bu da yanlı para için yaklaşık %87 demektir; ancak bu sayı seçtiğiniz öncüle bağlıdır.
Destek yalnızca bu iki hipoteze göredir. p = 0.7 gibi bir değer karşılaştırmanın parçası değildi. Burada 0,8, aynı zamanda maksimum olabilirlik kestirimidir; çünkü 10 atışın 8’i tura gelmiştir; dolayısıyla bu verilerden hiçbir başka p değeri daha fazla destek almaz.
Para örneği, p’nin iki sabit değerini karşılaştırdı. İstatistikteki çoğu soru daha geniştir; örneğin birkaç ek yordayıcının bir regresyon modelini iyileştirip iyileştirmediği gibi.
Olabilirlik oranı testi bu tür bir soruyu yanıtlar. İç içe (içiçe) iki modeli karşılaştırır; yani küçük model, büyük modelin özel bir durumudur:
Test beş adıma sahiptir:
Her model, önceden seçtiğiniz bir parametre değerinde değil, kendi maksimum olabilirlik kestiriminde değerlendirilir. Bu, para örneğinden temel farktır.
Olabilirlik oranı herhangi iki hipotezi karşılaştırır ve göreli destek verir; ancak p-değeri ve karar vermez. OROT (LRT), iç içe modellerden maksimize edilmiş olabilirliklerin oranını alır, bunu bir test istatistiğine çevirir ve sıfır hipotezini reddedip reddetmeye karar vermek için dağılımını kullanır. Her OROT bir olabilirlik oranı kullanır; ancak her olabilirlik oranı bir OROT’un parçası değildir — bu yazının ilerleyen kısımlarındaki tanısal olabilirlik oranları buna örnektir.
OROT, kısıtlı model üste olacak şekilde maksimize edilmiş olabilirliklerin oranıyla başlar:
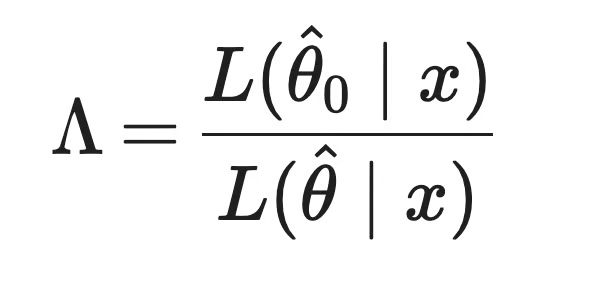
Olabilirlik oranı test istatistiği
Burada theta_hat_0, kısıtlı model altındaki maksimum olabilirlik kestirimidir; theta_hat ise tam model altındaki kestirimdir. Tam model kısıtlı olanı içerir; dolayısıyla her zaman en az o kadar iyi uyum sağlar. Bu da lambda’nın 0 ile 1 arasında olduğu anlamına gelir.
Test istatistiği şöyledir:
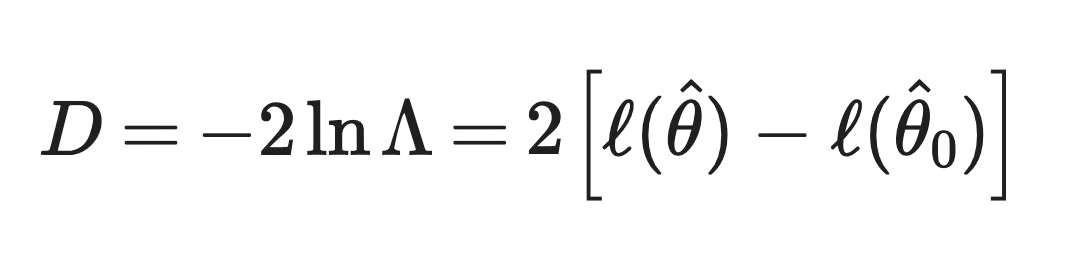
Olabilirlik oranı test istatistiği
Logaritmalar, öncekiyle aynı nedenle vardır. Ufacık sayıların oranını, her istatistik paketinin raporladığı log-olabilirlik farkına dönüştürürler.
-2’nin iki görevi vardır. lambda <= 1 olduğundan ln(lambda) 0 veya negatiftir; bu yüzden eksi işareti, tam model daha iyi uyum sağladıkça büyüyen pozitif bir sayıya çevirir. 2 çarpanı ise istatistiği ki-kare dağılımını izleyecek şekilde ölçekler. Genelleştirilmiş doğrusal modellerde D, iki model arasındaki sapma (deviance) farkına eşittir; bu yüzden çoğu zaman bu şekilde rapor edildiğini görürsünüz.
Wilks teoremi testi çalıştırır. Sıfır hipotezi doğruyken ve standart düzenlilik koşulları sağlandığında, örneklem büyüdükçe D’nin yaklaşık olarak ki-kare dağılımını izlediğini söyler. Düz Türkçeyle, modellerin iç içe olması ve sıfırdaki parametre değerlerinin izin verilen aralığın kenarında olmaması gerekir. Bu yazının ilerleyen bölümlerindeki sınırlamalar kısmı, bu koşullar bozulduğunda ne olduğunu ele alır.
Serbestlik dereceleri genellikle iki model arasındaki serbest parametre sayısı farkına eşittir. Tam model iki yordayıcı ekliyorsa, D’yi 2 serbestlik dereceli bir ki-kare dağılımıyla karşılaştırırsınız.
Dolayısıyla aynı referans dağılımı; lojistik regresyon, Poisson regresyonu ve maksimum olabilirlikle kurulan diğer çoğu model için de geçerlidir.
Diyelim ki bir müşterinin aboneliği iptal edip etmeyeceğini tahmin etmek istiyorsunuz. Veri kümesinde 1.000 müşteri var ve yaklaşık %32’si ayrılmış.
İki lojistik regresyon modeli kuruyorsunuz:
Kısıtlı model: Sadece tenure_months ile ayrılmayı tahmin eder; log-olabilirliği -556,88
Tam model: monthly_charges ve support_tickets eklenmiştir; log-olabilirliği -515,99
Testin her parçası bu örneğe şöyle uygulanır:
Sıfır hipotezi: monthly_charges ve support_tickets katsayılarının her ikisi de 0’dır; bu nedenle ek yordayıcılar uyumu iyileştirmez
Alternatif hipotez: Bu iki katsayıdan en az biri 0 değildir
Test istatistiği: D = 2 * (-515.99 - (-556.88)) = 81.78
Serbestlik dereceleri: Tam modelde iki parametre fazladır; bu nedenle test 2 serbestlik derecesi kullanır
p-değeri: 2 serbestlik dereceli bir ki-kare dağılımında bu kadar büyük veya daha büyük bir istatistiğin olasılığı; yaklaşık 1.7 * 10^-18
Bu p-değeri 0,05 gibi yaygın eşiklerin çok altındadır. Sıfır hipotezini reddeder ve verilerin ek yordayıcıların uyumu iyileştirdiğine dair güçlü kanıt sunduğu sonucuna varırsınız.
Ancak sıfır hipotezini reddetmek, tam modelin kullanım senaryonuz için daha iyi tercih olduğu anlamına gelmez.
Büyük örneklemlerde, uyumdaki çok küçük iyileşmeler bile küçük p-değerleri üretir. Test, etkilerin ne kadar büyük olduğunu veya modelin yeni verileri ne kadar iyi tahmin ettiğini söylemez. Daha büyük modeli tutmadan önce katsayıları ve ayrılmış verilerdeki performansı kontrol edin.
Ve büyük bir p-değeri, ek yordayıcıların işe yaramaz olduğunu kanıtlamaz. Yalnızca verilerin sıfır hipotezine karşı yeterli kanıt sunmadığı anlamına gelir.
Bir OROT, ek parametrelerin uyumu iyileştirip iyileştirmediğini söyler; bu iyileştirmenin önemli olup olmadığına karar vermek ise hâlâ sizin işinizdir.
OROT’u en sık regresyon modellerini karşılaştırırken görürsünüz. Fikir hep aynıdır: Kısıtlı bir model kurun, tam bir model kurun ve maksimize edilmiş log-olabilirliklerini karşılaştırın.
Lojistik regresyon, OROT’u görmenin en yaygın yeridir.
Yorumlama bölümünde tenure_months’lü bir modeli; monthly_charges ve support_tickets’ın da yer aldığı bir modelle karşılaştırdık. Bir adım daha ileri gidip tam modeli, her müşteri için aynı ayrılma olasılığını tahmin eden yalnızca sabit terimli bir modelle karşılaştırabilirsiniz.
Aynı ayrılma verilerinde, yalnızca sabit terimli modelin log-olabilirliği -627,62; tam modelinki -515,99’dur. Bu, her yordayıcı için birer olmak üzere 3 serbestlik derecesiyle D = 2 * (-515.99 - (-627.62)) = 223.27 ve yaklaşık 3,9 x 10^-48’lik bir p-değeri verir.
Bu test, yordayıcıların bir bütün olarak, hiç yordayıcı olmamasına göre ayrılmayı daha iyi açıklayıp açıklamadığını sorar. Bu, doğrusal regresyondaki genel F-testinin lojistik regresyon versiyonudur ve statsmodels model özetinde LLR p-value olarak raporlar.
Lojistik regresyon, genelleştirilmiş doğrusal modeller veya GDM’ler (GLM) denilen daha büyük bir ailenin üyesidir. Aile; sayımlar için Poisson regresyonunu ve pozitif sürekli çıktılar için gamma regresyonunu da içerir.
Her GLM, modelin mükemmel uyumdan ne kadar uzak olduğunu ölçen bir sapma (deviance) raporlar. İç içe iki GLM için, sapmalarının farkı OROT istatistiği D’ye eşittir; bu nedenle teste sıklıkla sapma analizi denir.
Serbestlik dereceleri, daha önce olduğu gibi, parametre sayısındaki farka göre işler. Gamma veya Gauss GLM’leri gibi saçılma parametresi kestirilen modeller için, ki-kare yerine genellikle sapma farkına F-testi uygulanır.
Maksimum olabilirlikle kurulan herhangi bir model, modeller iç içe olduğu sürece OROT kullanabilir. Örneğin:
OROT, Wald testi ve skor testiyle benzerdir. Üçü de aynı sıfır hipotezini test eder ve üçü de büyük örneklemlerde ki-kare dağılımını izler. Fark; hangi modelleri kurduğunuzda ve neyi ölçtüğünüzdedir.
OROT her iki modeli de kurar ve log-olabilirliklerini karşılaştırır. Wald testi yalnızca tam modeli kurar ve her kestirimin sıfır değerinden kaç standart hata uzakta olduğunu kontrol eder.
Tek bir katsayı için Wald istatistiği, kestirimin standart hatasına bölünmesidir. Regresyon özet tablolarındaki p-değerleri genellikle bu testten gelir.
Wald testi hızlıdır; çünkü yalnızca bir model kurarsınız. Ancak modelin nasıl parametrize edildiğine bağlıdır ve lojistik regresyonda katsayılar çok büyük olduğunda kötü davranabilir; çünkü standart hata kestirimden daha hızlı büyür. OROT’ta bu iki sorun yoktur; dolayısıyla daha güvenli bir seçimdir.
Skor testi yalnızca kısıtlı modeli kurar.
Sıfır parametre değerlerinde log-olabilirliğin eğimine bakar. Sıfır hipotezi doğruysa eğim 0’a yakın olmalıdır. Dik bir eğim, bu parametrelerin sıfırdan uzaklaşmasına izin verirseniz olabilirliğin artacağını gösterir.
Bu, tam modelin pahalı veya zor kurulabildiği durumlarda skor testini kullanışlı kılar. Lagrange çarpanı testi olarak da bilinir ve genellikle eklenmeden önce aday yordayıcıları taramak için kullanılır.
OROT istatistiği büyük örneklemlerde ki-kare dağılımını izlese de bu, OROT’u alışılagelmiş anlamda bir "ki-kare testi" yapmaz.
"Ki-kare testi", istatistiği ki-kare dağılımını izleyen herhangi bir test için geniş bir etikettir. Çoğu zaman insanlar bunu, bağımsızlık veya uygunluk için Pearson’ın ki-kare testi anlamında kullanır.
Yine de ikisi bağlantılıdır. Pearson testinin olabilirlik oranı versiyonuna G-testi denir ve beklenen ve gözlenen sayımları kare farklar yerine log-olabilirliklerle karşılaştırır. Büyük örneklemlerde her ikisi de benzer sonuçlar verir.
Üç model temelli test şu şekilde karşılaştırılır:
| Wald testi | Olabilirlik oranı testi | Skor testi | |
|---|---|---|---|
| Kurulan modeller | Yalnızca tam | Kısıtlı ve tam | Yalnızca kısıtlı |
| Ölçtüğü şey | Kestirimin sıfır değerinden uzaklığı, standart hatalar cinsinden | Maksimize edilmiş log-olabilirlikler arasındaki fark | Sıfır değerlerinde log-olabilirliğin eğimi |
| Nerede görülür | Regresyon özetlerindeki katsayı p-değerleri | İç içe model karşılaştırmaları ve sapma analizi | Yeni yordayıcıların taranması, kurulması zor modeller |
| Zayıf yön | Parametrizasyona bağlıdır, çok büyük kestirimlerle güvenilmez | Her iki modelin de kurulmasını gerektirir | Yalnızca sıfır değerlerinin yakınındaki bilgiyi kullanır |
| Büyük örneklem dağılımı | Ki-kare | Ki-kare | Ki-kare |
Olabilirlik oranının diğer istatistiksel testlerle karşılaştırması
Her iki terimde de "oran" vardır ve her ikisi de lojistik regresyonda yaygındır. Benzerlik burada biter.
Olabilirlik oranı, iki hipotezin gözlenen verileri ne kadar iyi açıkladığını karşılaştırır. Oran oranı ise bir sonucun iki grup veya koşul arasındaki oranlarını karşılaştırır.
Oran, bir olayın olasılığının, olmama olasılığına bölünmesidir. %25’lik bir ayrılma olasılığı, 0,25 / 0,75 veya 1’e 3 oran demektir.
Önceki ayrılma modelinde, support_tickets katsayısı 0,456’dır. Üstelini almak yaklaşık 1,58’lik bir oran oranı verir; bu da her ek destek biletiyle ayrılma oranlarının 1,58 ile çarpıldığı anlamına gelir.
Bu, verilerdeki bir etki hakkında bir ifadedir. Olabilirlik oranı ise bir kanıt ifadesidir — aynı verileri bir hipotez veya modelin diğerine göre ne kadar daha iyi açıkladığı hakkında.
Dolayısıyla oran oranı "etki ne kadar büyük?" sorusunu yanıtlarken, olabilirlik oranı "veriler hangi açıklamayı daha çok destekliyor?" sorusunu yanıtlar.
Tıpta, "olabilirlik oranı"nın ikinci bir anlamı vardır. Bir test sonucunun bir hastada belirli bir durumun var olma oranlarını ne kadar değiştirdiğini açıklar ve model kurma veya p-değerlerini içermez.
Tanısal olabilirlik oranları bir testin iki özelliğinden gelir:
Diyelim ki bir testin duyarlılığı %90 ve özgüllüğü %80.
Pozitif olabilirlik oranı (LR+), pozitif sonucun durumu olan kişilerde, durumu olmayanlara göre ne kadar daha olası olduğunu gösterir:
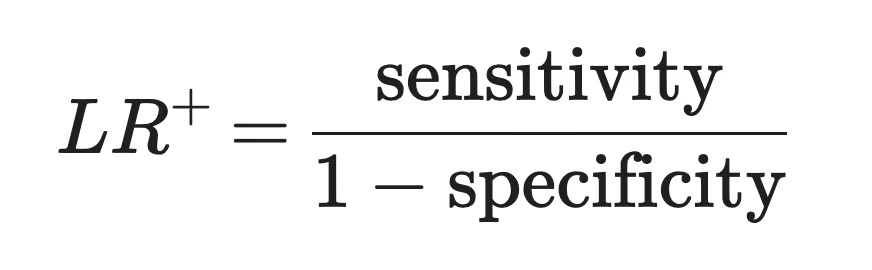
Pozitif olabilirlik oranı
Örnek test için bu, 0,9 / 0,2 = 4,5’tir. Pozitif bir sonuç, durumu olan birinde 4,5 kat daha olasıdır. 1’in üzerindeki değerler durumun oranlarını artırır; değer ne kadar yüksekse pozitif sonucun size anlattığı şey o kadar fazladır.
Negatif olabilirlik oranı (LR-), negatif sonucun durumu olan kişilerde, durumu olmayanlara kıyasla ne kadar olası olduğunu gösterir:
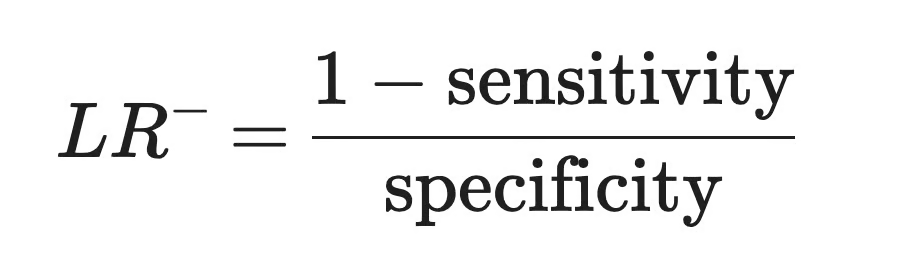
Negatif olabilirlik oranı
Örnek test için bu, 0,1 / 0,8 = 0,125’tir. 1’in altındaki değerler durumun oranlarını düşürür; değer 0’a ne kadar yakınsa negatif sonucun size anlattığı şey o kadar fazladır.
Tanısal olabilirlik oranları kullanışlıdır; çünkü testten önce bildiklerinizi güncellerler:
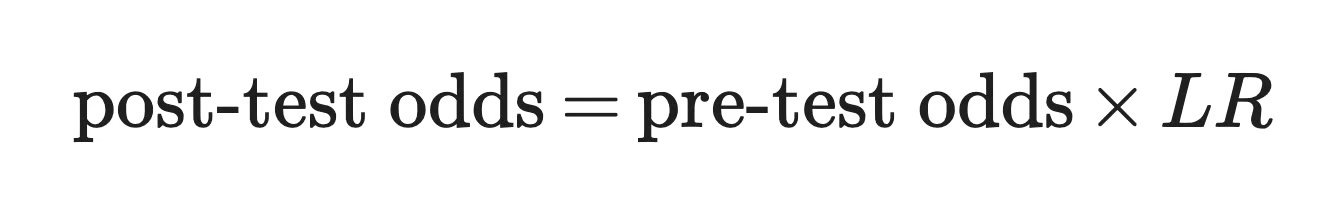
Tanısal olabilirlik oranı
Diyelim ki bu tür hastaların %10’unda durum mevcut. Bu, 0,1 / 0,9 yani yaklaşık 0,111 ön-test oranıdır.
Pozitif sonuçtan sonra oranlar 0,111 * 4,5 = 0,5 olur; bu da yaklaşık %33 olasılıktır. Negatif sonuçtan sonra 0,111 * 0,125 = 0,014 olur; bu da yaklaşık %1,4’tür.
Bu, yazıda olabilirlik oranının bir hipotezin olasılığına götürdüğü tek yerdir ve yalnızca ön-test oranları öncülü sağladığı için mümkündür.
Her iki dil de birkaç satırda OROT çalıştırmanız için gereken her şeye sahiptir. Daha önce bahsedilen ayrılma veri setini kullanacağım; böylece sayılar yorumlama ve regresyon bölümlerindekilerle eşleşir.
numpy, pandas, statsmodels ve scipy’a ihtiyacınız olacak. Veri kümesini oluşturarak başlayın:
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf
from scipy import stats

# Generate a synthetic customer churn dataset
rng = np.random.default_rng(42)
n_customers = 1000

churn = pd.DataFrame({
    "tenure_months": rng.integers(1, 73, n_customers),
    "monthly_charges": rng.uniform(20, 120, n_customers).round(2),
    "support_tickets": rng.poisson(1.5, n_customers),
})

# Churn gets less likely with tenure and more likely with charges and tickets
log_odds = (
    -0.5
    - 0.04 * churn["tenure_months"]
    + 0.01 * churn["monthly_charges"]
    + 0.25 * churn["support_tickets"]
)
churn["churned"] = rng.binomial(1, 1 / (1 + np.exp(-log_odds)))

# Save the data so you can load the same dataset in R
churn.to_csv("churn.csv", index=False)
Bu veri kümesinde ayrılma oranı %32,1’dir.
Sonra kısıtlı ve tam lojistik regresyon modellerini kurun. .llf niteliği, her birinin maksimize edilmiş log-olabilirliğini tutar:
# Fit the restricted and full models
reduced_model = smf.logit("churned ~ tenure_months", data=churn).fit(disp=0)
full_model = smf.logit(
    "churned ~ tenure_months + monthly_charges + support_tickets",
    data=churn,
).fit(disp=0)

# Get the maximized log-likelihoods
print(f"Restricted model log-likelihood: {reduced_model.llf:.2f}")
print(f"Full model log-likelihood: {full_model.llf:.2f}")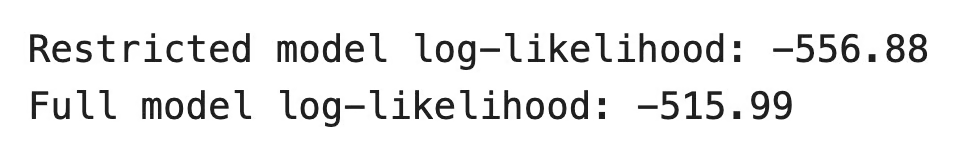
Kısıtlı ve tam model log olabilirlikleri
statsmodels lojistik regresyon için genel bir OROT fonksiyonuna sahip değildir; dolayısıyla istatistiği iki log-olabilirlikten hesaplayın. .df_model niteliği her modeldeki yordayıcı sayısını verir ve stats.chi2.sf() p-değerini döndürür:
lr_stat = 2 * (full_model.llf - reduced_model.llf)
df_diff = full_model.df_model - reduced_model.df_model
p_value = stats.chi2.sf(lr_stat, df_diff)

print(f"LR statistic: {lr_stat:.2f}")
print(f"Degrees of freedom: {df_diff:.0f}")
print(f"P-value: {p_value:.1e}")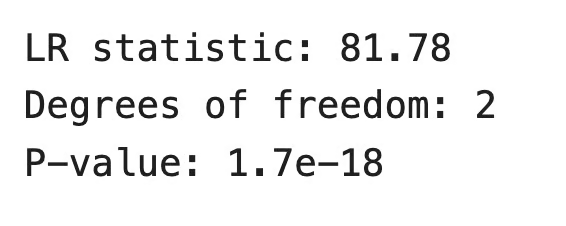
Test istatistiği, serbestlik dereceleri ve p-değeri
p-değeri 0,05’in çok altındadır; bu nedenle sıfır hipotezini reddedersiniz. Veriler, monthly_charges ve support_tickets’ın yalnızca tenure_months içeren bir modele göre uyumu iyileştirdiğine dair güçlü kanıt sunar.
Yalnızca sabit terimli modelle karşılaştırma için ek koda gerek yoktur. statsmodels bunu her lojistik regresyon modeli için hesaplar:
print(f"Intercept-only log-likelihood: {full_model.llnull:.2f}")
print(f"LR statistic: {full_model.llr:.2f}")
print(f"P-value: {full_model.llr_pvalue:.1e}")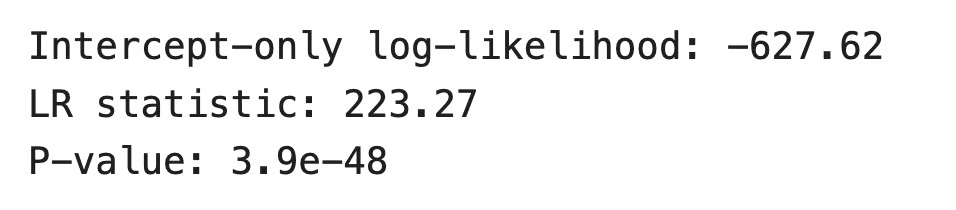
Tam modelin yalnızca sabit terimli modelle karşılaştırması
R, NumPy ile aynı rastgele sayı üretecini kullanmaz; bu yüzden aynı verilerle çalışmak için Python örneğindeki churn.csv dosyasını yükleyin. Ardından her iki modeli de glm() ile kurun ve anova()’ya gönderin:
# Load the churn dataset saved from Python
churn <- read.csv("churn.csv")

# Fit the restricted and full models
reduced_model <- glm(churned ~ tenure_months, data = churn, family = binomial)
full_model <- glm(
  churned ~ tenure_months + monthly_charges + support_tickets,
  data = churn,
  family = binomial
)

# Check the maximized log-likelihoods
logLik(reduced_model)
logLik(full_model)

# Run the likelihood ratio test
anova(reduced_model, full_model, test = "Chisq")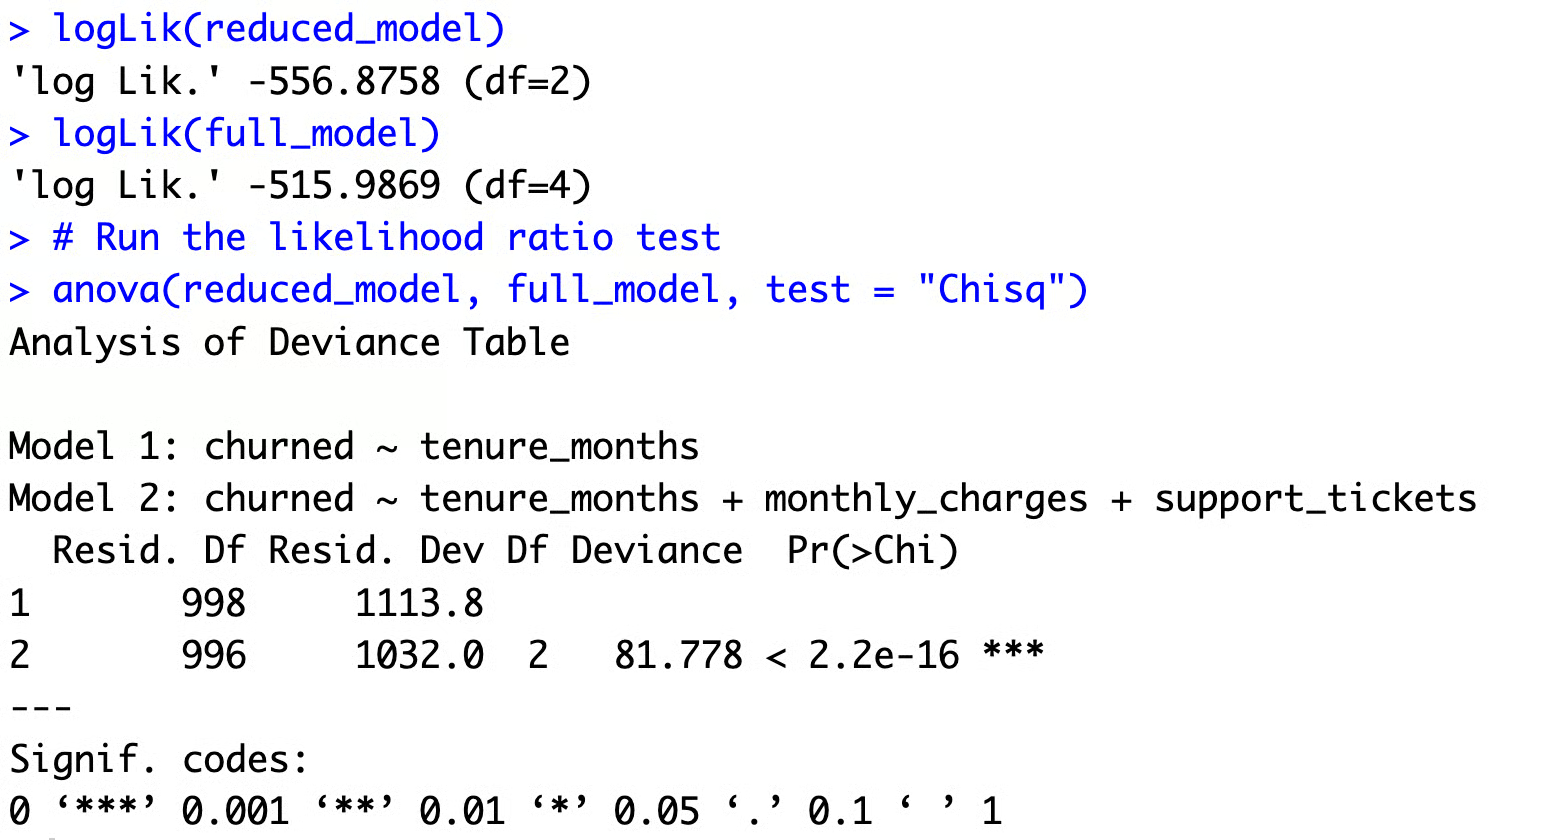
R’da log olabilirlikler ve oran testi
df değerleri, her log-olabilirliğin yanındaki kestirilen parametre sayısıdır (sabit terim dahil). Tam model iki tane fazladır; bu da anova() tablosundaki Df sütunuyla eşleşir.
Deviance sütunu 81,778’i gösterir; bu, Python’da elde ettiğinizle aynı OR istatistiğidir. Bu, GLM bölümündeki sapma analizinin çalışmasıdır — 1113,8’den 1032,0’a artık sapmadaki düşüş, test istatistiğidir.
R, p-değerini varsayılan olarak gösterdiği en küçük değer olduğu için < 2.2e-16 şeklinde yazdırır; Python sonucundan farklı olduğundan değil. Her iki durumda da sonuç aynıdır ve ek yordayıcılar uyumu iyileştirir.
Tercih ederseniz, lmtest paketindeki lrtest() aynı karşılaştırmayı lrtest(reduced_model, full_model) ile yapar.
OROT, şimdiye kadar ele alınan ortamlarda iyi çalışır; ancak ki-kare sonucu birkaç koşula bağlıdır.
Standart OROT yalnızca, kısıtlı modelin tam modelin özel bir durumu olduğu iç içe modelleri karşılaştırır.
Bir lojistik regresyonla probit modeli karşılaştırmak veya farklı yordayıcılara sahip iki modeli karşılaştırmak isterseniz, hiçbiri diğerinin özel durumu değildir. Ki-kare dağılımı burada geçerli değildir. Bunun yerine AIC ve BIC gibi bilgi ölçütlerini veya iç içe olmayan modeller için Vuong testini kullanın.
Test, maksimize edilmiş olabilirlikleri karşılaştırır; dolayısıyla her iki model de aynı veriler üzerinde maksimum olabilirlikle kurulmalıdır.
Burada iki yaygın sorun çıkabilir. Birçok pakette varsayılan olan REML ile kurulan karma etkili modeller, sabit etkilerde farklılık olduğunda OROT ile karşılaştırılamaz — önce maksimum olabilirlikle yeniden kurun. Ve lasso veya ridge regresyonu gibi cezalı modeller, olabilirliğin kendisini maksimize etmez; bu yüzden olağan test onlara uygulanmaz.
Modeller aynı gözlemleri de kullanmalıdır. Bir yordayıcıda eksik değerler varsa, tam model satırları düşürebilir ve iki log-olabilirlik artık karşılaştırılabilir olmaz.
Wilks teoremi büyük örneklem sonucudur. Düzenlilik koşulları altında geçerlidir; düz Türkçeyle, olabilirlik düzgün (pürüzsüz) olmalı, parametreler tanımlanabilir olmalı ve gerçek parametre değerleri izin verilen aralığın içinde olmalı; kenarında değil.
Bu koşullar sağlandığında ki-kare dağılımı büyük örneklemler için iyi bir yaklaşımdır. Yine de bir yaklaşımdır.
Küçük örneklemlerde OROT istatistiği ki-kare dağılımını izlemeyebilir ve p-değerleri fazla küçük veya fazla büyük olabilir.
Burada birkaç seçeneğiniz vardır. Parametrik bootstrap, kısıtlı modelden yeni veri setleri simüle eder ve istatistiğin dağılımını oluşturur. Kontenjans tabloları gibi basit durumlarda, yaklaşımdan kaçınan kesin testler kullanılır.
Bazı sıfır hipotezleri, bir parametreyi izin verilen aralığın kenarına yerleştirir. En yaygın örnek, karma bir modelde bir rastgele etki varyansının 0’a eşit olup olmadığının test edilmesidir; çünkü bir varyans negatif olamaz.
Bu durumda istatistik, olağan ki-kare dağılımını izlemez. Tek bir varyans bileşeni için, 0 ve 1 serbestlik dereceli ki-karelerin 50:50 karışımını izler; dolayısıyla standart p-değeri olması gerekenden yaklaşık iki kat büyüktür. Standart test burada tutucudur; yani gerçek etkileri daha sık kaçırır.
Karışım modelinde bileşen sayısını test etmek benzer bir sorundur. Bir bileşenle ikiyi karşılaştırdığınızda düzenlilik koşulları başarısız olur ve ki-kare yaklaşımı hiç tutmaz.
OROT, tam modelin doğru olduğunu varsayar. Her iki model de verilerin dağılımını yanlış alıyorsa — örneğin ortalamadan çok daha büyük varyansa sahip sayımlar için Poisson modeli — istatistik büyük örneklemlerde bile ki-kare dağılımını izlemez.
Teste güvenmeden önce tam modelinizin uyumunu kontrol edin. Aşırı saçılmış sayımlar için, negatif binom model veya yarı-olabilirlik (quasi-likelihood) F-testi genellikle daha iyi bir seçimdir.
Dolayısıyla ki-kare yaklaşımı bir varsayılandır, garanti değil; ve yalnızca düzenlilik koşullarını sağlayan kurulumlarda geçerlidir.
Olabilirlik oranı, iki hipotezin veya modelin aynı gözlenen verileri ne kadar iyi açıkladığını karşılaştırır. Tüm fikir budur ve bu yazıdaki her şey bunun üzerine kurulur.
Olabilirlik oranı testi bu fikri resmi bir prosedüre dönüştürür. İç içe iki modeli kurar, maksimize edilmiş log-olabilirliklerini karşılaştırır ve p-değeri elde etmek için ki-kare dağılımını kullanır. En sık lojistik regresyon ve diğer GLM’lerde karşınıza çıkar; hem statsmodels hem de R bunu birkaç satır kodla çalıştırır.
Ama sayının ne anlama geldiğini unutmayın. Olabilirlik oranı, bir hipoteze diğerine göre göreli desteği gösterir; hipotezlerden herhangi birinin doğru olma olasılığını değil. Buna ulaşmak için, tanısal testlerde olduğu gibi öncül oranlara ihtiyacınız vardır.
Daha ileri gitmek isterseniz, testin yapı taşları şunlardır: olabilirliğin kendisi, maksimum olabilirlik kestirimi ve Wald testi ile diğer hipotez testlerinin OROT’la karşılaştırması.
DataCamp ile öğrenin
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




