
Cursus
Inleiding tot statistiek in Python
4 uur
199.2K
Heb je de term "likelihoodratio" weleens gezien in een regressie-output of studie en geen idee gehad wat die je vertelt?
Je bent niet de enige. De term komt vaak voor bij hypothesetoetsen, modelvergelijkingen, classificatie en diagnostische tests, en elk vakgebied gebruikt hem net even anders. Veel uitleg begint bovendien met een toetsingsgrootheid en een chi-kwadraatverdeling nog vóór je weet wat een likelihood is. Zo hou je een getal over dat je wel kunt uitrekenen, maar niet kunt uitleggen.
Kort gezegd laat likelihood zien hoe goed een parameterwaarde of statistisch model de geobserveerde data verklaart. Een likelihoodratio deelt de ene likelihood door de andere, zodat je ziet welke van twee hypotheses meer steun krijgt van de data, en met hoeveel.
In dit artikel neem ik je mee door het kernidee en de formule, de likelihoodratiotoets en hoe je die interpreteert, en waar je likelihoodratio’s in de praktijk tegenkomt.
Een opfrisser statistiek nodig? Bekijk ons aanbod Probability and Statistics-cursussen en vind de perfecte match.
Een likelihoodratio is de likelihood van de geobserveerde data onder de ene hypothese gedeeld door de likelihood van dezelfde data onder een andere hypothese. De twee hypotheses kunnen twee parameterwaarden zijn of twee volledige statistische modellen.
De vraag die het beantwoordt is welke verklaring de data beter verklaart, niet of de data waarschijnlijk zijn.
Dat is een belangrijk verschil. Elke specifieke reeks van 20 muntworpen heeft onder een eerlijke munt een kans van ongeveer één op een miljoen, dus een kleine likelihood op zichzelf zegt weinig. Het krijgt pas betekenis naast een andere likelihood.
Stel, je werpt een munt 10 keer en krijgt 8 keer kop. Eén hypothese zegt dat de munt eerlijk is, met een kans van 0,5 op kop. Een andere zegt dat hij scheef is, met een kans van 0,8 op kop.
Beide hypotheses kunnen 8 keer kop opleveren, maar de scheve munt produceert dat resultaat veel vaker. Dus de data geven meer steun aan de tweede hypothese, en de likelihoodratio geeft daar een getal aan. De exacte waarden reken ik voor in het voorbeeldgedeelte verderop in dit artikel.
Likelihood en kans gebruiken dezelfde formule, maar beantwoorden andere vragen:
Kansen over alle mogelijke uitkomsten tellen op tot 1, maar likelihoods over alle mogelijke parameterwaarden niet. Daarom is een likelihood niet de kans dat een hypothese waar is, en een likelihoodratio ook niet.
Elke likelihoodratio volgt dezelfde vijf stappen:
De betekenis van de ratio hangt af van welke likelihood bovenaan staat. Met hypothese A in de teller:
Een ratio van 4 betekent dat de geobserveerde data vier keer zo waarschijnlijk zijn onder A als onder B. Het betekent niet dat A vier keer zo waarschijnlijk waar is.
Als je teller en noemer omwisselt, krijg je het omgekeerde. Een ratio van 4 ten gunste van A wordt 0,25, wat hetzelfde zegt maar dan vanuit B gezien.
Conventies verschillen per vakgebied. De likelihoodratiotoets zet meestal de nulhypothese in de teller, zodat lage waarden tellen als bewijs ertegen, terwijl veel andere toepassingen de alternatieve hypothese bovenaan zetten.
Controleer dus altijd welke hypothese in de teller staat voordat je een likelihoodratio interpreteert.
De basis-likelihoodratio deelt de ene likelihood van de data door de andere:
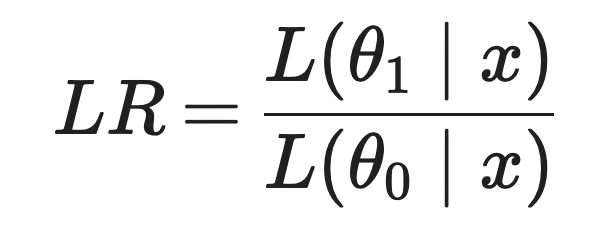
Formule van de likelihoodratio
Dit betekenen de termen:
x: De geobserveerde data, zoals 8 keer kop in 10 worpentheta_1 en theta_0: De twee te vergelijken parameterwaarden of hypotheses, zoals een kans op kop van 0,8 en 0,5L(theta | x): De likelihood van theta gegeven de data, gelijk aan de kans op x wanneer theta de ware parameter is, of de dichtheid bij continue dataBij onafhankelijke observaties is de likelihood een product van één kans per observatie:
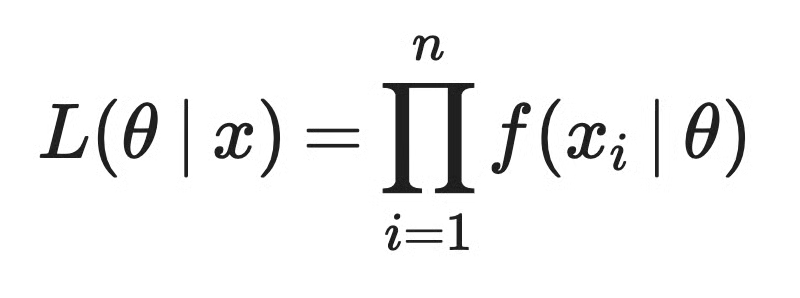
Likelihood bij onafhankelijke observaties
En daar beginnen de problemen. Elke factor is kleiner dan 1, dus het product daalt snel naarmate de steekproef groeit.
De kans op een specifieke reeks van 1.000 worpen onder een eerlijke munt is ongeveer 9,3 * 10^-302, wat dicht bij het kleinste getal ligt dat een 64-bits float kan opslaan. Bij 2.000 worpen geeft 0.5 ** 2000 in Python 0.0 terug.
Logaritmen bieden uitkomst. Het logaritme van een product is de som van de logaritmen, dus de log-likelihood verandert een product van piepkleine getallen in een som van hanteerbare getallen:
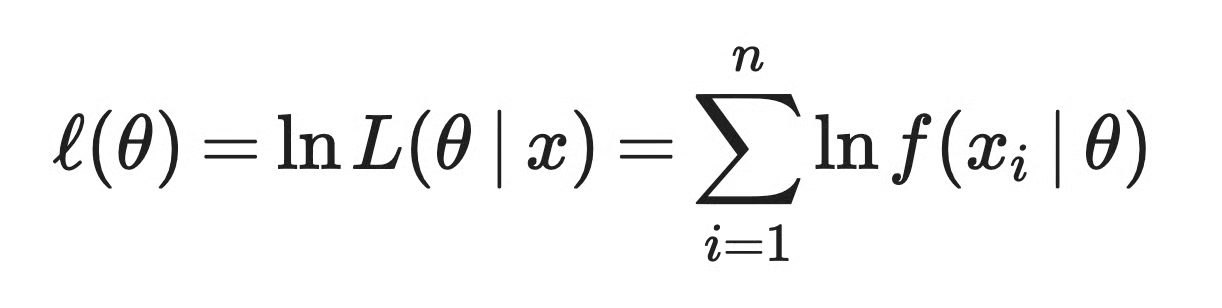
Log-likelihood
De ratio wordt een verschil:
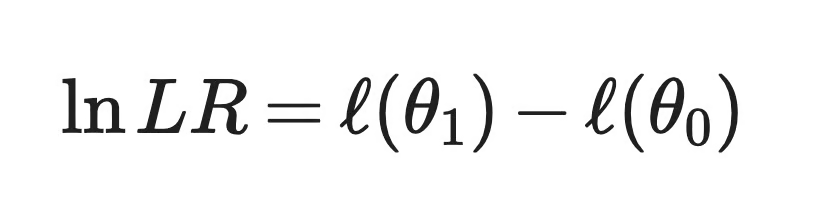
Log-likelihoodratio
Sommaties zijn ook eenvoudiger te differentiëren dan producten, daarom werkt maximum likelihoodschatting ook met log-likelihoods.
De logversie leest hetzelfde als de ratio, alleen rond 0 in plaats van 1. Een waarde van 0 betekent gelijke steun, positieve waarden zijn in het voordeel van theta_1, en negatieve waarden in het voordeel van theta_0.
Terug naar de munt van eerder. Je werpt hem 10 keer en krijgt 8 keer kop en 2 keer munt.
De twee hypotheses zijn:
Hypothese 0: De munt is eerlijk, dus p = 0.5
Hypothese 1: De munt is bevooroordeeld richting kop, dus p = 0.8
Het aantal keer kop in 10 worpen volgt een binomiale verdeling, dus de likelihood van elke hypothese is:
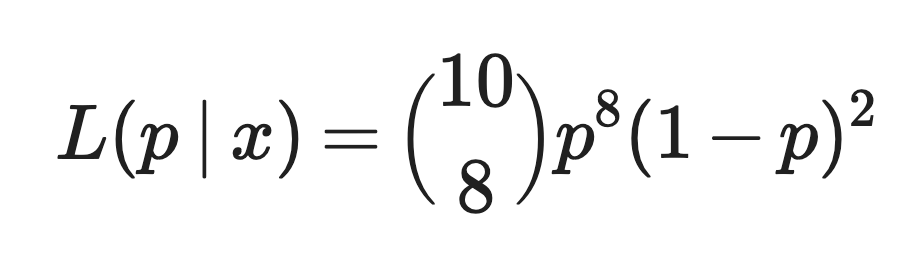
Voorbeeld likelihoodratio
Onder de hypothese van de eerlijke munt:
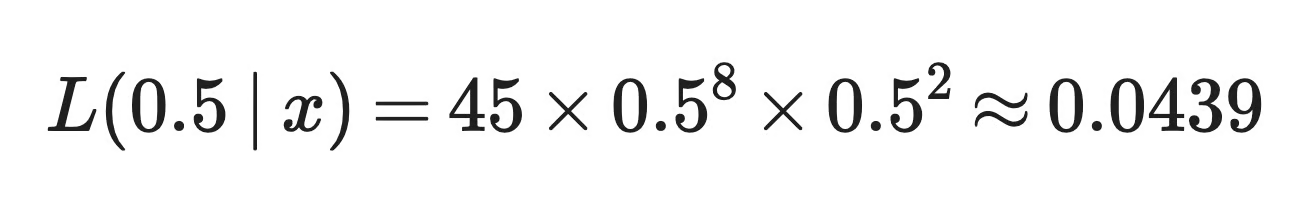
Voorbeeld likelihoodratio
Onder de hypothese van de scheve munt:
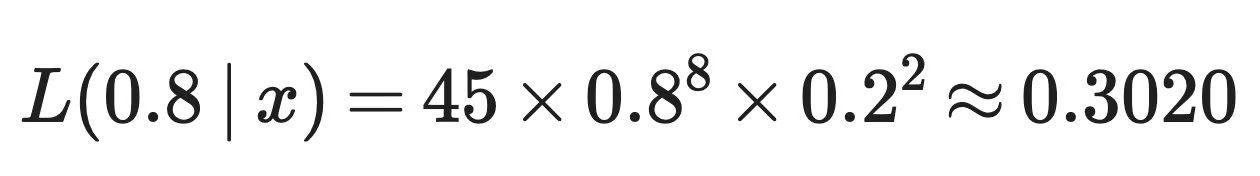
Voorbeeld likelihoodratio
De likelihoodratio is:
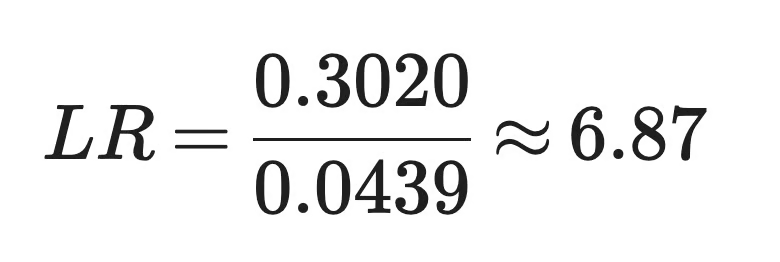
Voorbeeld likelihoodratio
De binomiale coëfficiënt 45 komt in beide likelihoods voor, dus valt weg in de ratio. Je zou dezelfde 6,87 krijgen uit de kans op de exacte volgorde van worpen.
In gewone taal: de geobserveerde data zijn ongeveer 6,9 keer zo waarschijnlijk als de munt 80% van de tijd op kop landt dan wanneer hij eerlijk is. Dat is alles.
De ratio zegt niet dat de munt 6,9 keer zo waarschijnlijk scheef is. Om de kans te krijgen dat een van beide hypotheses waar is, heb je voorafkansen voor beide nodig. Met 50/50 voorafkansen zouden de achteraf-odds 6,87 tegen 1 zijn, of ongeveer 87% voor de scheve munt, maar dat getal hangt af van de gekozen prior.
De steun is ook alleen relatief tussen deze twee hypotheses. Een waarde als p = 0.7 maakte geen deel uit van de vergelijking. Hier is 0,8 toevallig ook de maximum likelihood-schatting, omdat 8 van de 10 worpen kop waren, dus geen andere waarde van p krijgt meer steun van deze data.
Het muntvoorbeeld vergeleek twee vaste waarden van p. De meeste vragen in de statistiek zijn breder, zoals of een paar extra voorspellers een regressiemodel verbeteren.
De likelihoodratiotoets (LRT) beantwoordt dat soort vragen. Hij vergelijkt twee geneste modellen, wat betekent dat het kleinere model een speciaal geval is van het grotere:
De toets heeft vijf stappen:
Elk model wordt geëvalueerd op zijn maximum likelihood-schatting, niet op een parameterwaarde die je vooraf koos. Dat is het belangrijkste verschil met het muntvoorbeeld.
De likelihoodratio vergelijkt willekeurige twee hypotheses en geeft je relatieve steun, maar geen p-waarde en geen beslissing. De LRT neemt een ratio van gemaximaliseerde likelihoods uit geneste modellen, zet die om in een toetsingsgrootheid en gebruikt de verdeling daarvan om te beslissen of je de nulhypothese verwerpt. Elke LRT gebruikt een likelihoodratio, maar niet elke likelihoodratio is onderdeel van een LRT - de diagnostische likelihoodratio’s later in dit artikel zijn één voorbeeld.
De LRT begint met de ratio van gemaximaliseerde likelihoods, met het beperkte model bovenaan:
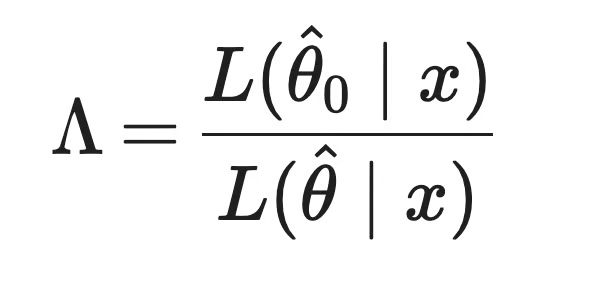
Toetsingsgrootheid likelihoodratiotoets
Hier is theta_hat_0 de maximum likelihood-schatting onder het beperkte model, en theta_hat de schatting onder het volledige model. Het volledige model bevat het beperkte, dus het past altijd minstens even goed. Dit betekent dat lambda tussen 0 en 1 ligt.
De toetsingsgrootheid is:
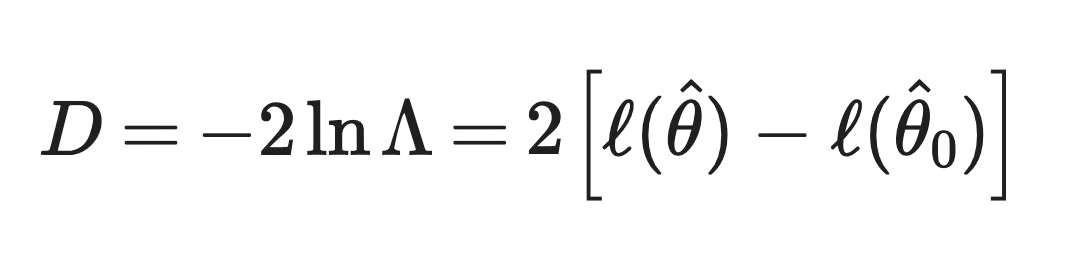
Toetsingsgrootheid likelihoodratiotoets
Logaritmen staan er om dezelfde reden als eerder. Ze veranderen een ratio van piepkleine getallen in een verschil van log-likelihoods, wat elk statistisch pakket rapporteert.
De -2 heeft twee taken. Omdat lambda <= 1 is, is ln(lambda) 0 of negatief, dus het minteken maakt er een positief getal van dat groter wordt naarmate het volledige model beter past. De factor 2 schaalt de grootheid zodat die een chi-kwadraatverdeling volgt. Voor gegeneraliseerde lineaire modellen is D gelijk aan het verschil in deviantie tussen de twee modellen, daarom zie je het vaak zo gerapporteerd.
Het stelling van Wilks laat de toets werken. Die zegt dat wanneer de nulhypothese waar is en standaardregulariteitsvoorwaarden gelden, D bij toenemende steekproefomvang ongeveer een chi-kwadraatverdeling volgt. In gewone taal: de modellen moeten genest zijn, en de nul-parameterwaarden mogen niet op de rand van het toegestane bereik liggen. De beperkingen verderop in dit artikel behandelen wat er gebeurt als die voorwaarden niet gelden.
De vrijheidsgraden zijn meestal gelijk aan het verschil in aantal vrije parameters tussen de twee modellen. Als het volledige model twee voorspellers toevoegt, vergelijk je D met een chi-kwadraatverdeling met 2 vrijheidsgraden.
Zo werkt dezelfde referentieverdeling voor logistische regressie, Poissonregressie en de meeste andere modellen die met maximum likelihood worden geschat.
Stel, je wilt voorspellen of een klant een abonnement opzegt. De dataset bevat 1.000 klanten, en ongeveer 32% daarvan haakte af.
Je past twee logistische regressiemodellen:
Beperkt model: Voorspelt churn op basis van tenure_months alleen, met een log-likelihood van -556,88
Volledig model: Voegt monthly_charges en support_tickets toe, met een log-likelihood van -515,99
Zo past elk deel van de toets op dit voorbeeld:
Nulhypothese: De coëfficiënten van monthly_charges en support_tickets zijn allebei 0, dus de extra voorspellers verbeteren de fit niet
Alternatieve hypothese: Ten minste één van die twee coëfficiënten is niet 0
Toetsingsgrootheid: D = 2 * (-515.99 - (-556.88)) = 81.78
Vrijheidsgraden: Het volledige model heeft twee parameters meer, dus de toets gebruikt 2 vrijheidsgraden
P-waarde: De kans op een zo grote of grotere grootheid onder een chi-kwadraatverdeling met 2 vrijheidsgraden, die ongeveer 1.7 * 10^-18 is
Die p-waarde ligt ver onder elke gangbare drempel, zoals 0,05. Je verwerpt de nulhypothese en concludeert dat de data sterk bewijs leveren dat de extra voorspellers de fit verbeteren.
Maar de nul verwerpen betekent niet dat het volledige model de beste keuze is voor jouw toepassing.
Bij grote steekproeven leveren zelfs minieme verbeteringen in fit kleine p-waarden op. De toets vertelt je niet hoe groot de effecten zijn of hoe goed het model nieuwe data voorspelt. Bekijk de coëfficiënten en de prestaties op achtergehouden data voordat je het grotere model houdt.
En een grote p-waarde bewijst niet dat de extra voorspellers nutteloos zijn. Het betekent alleen dat de data niet genoeg bewijs tegen de nulhypothese leveren.
Een LRT vertelt je of extra parameters de fit verbeteren, en bepalen of die verbetering ertoe doet blijft jouw taak.
Je komt de LRT het vaakst tegen bij het vergelijken van regressiemodellen. Het idee blijft steeds hetzelfde: pas een beperkt model, pas een volledig model en vergelijk hun gemaximaliseerde log-likelihoods.
Logistische regressie is de meest voorkomende plek om de LRT te zien.
Het interpretatiegedeelte vergeleek een model met tenure_months met een model dat ook monthly_charges en support_tickets heeft. Je kunt nog een stap verder gaan en het volledige model vergelijken met een model met alleen intercept, dat voor elke klant dezelfde churnkans voorspelt.
Op dezelfde churndata heeft het model met alleen intercept een log-likelihood van -627,62, en het volledige model -515,99. Dit geeft D = 2 * (-515.99 - (-627.62)) = 223.27 met 3 vrijheidsgraden, één per voorspeller, en een p-waarde van ongeveer 3,9 x 10^-48.
Deze toets vraagt of de voorspellers, samen genomen, churn beter verklaren dan helemaal geen voorspellers. Het is de logistische-regressieversie van de overall F-toets in lineaire regressie, en statsmodels rapporteert het in de model-samenvatting als LLR p-value.
Logistische regressie is één lid van een grotere familie, de gegeneraliseerde lineaire modellen (GLM). Die familie omvat ook Poissonregressie voor tellingen en gammaregressie voor positieve continue uitkomsten, onder andere.
Elk GLM rapporteert een deviantie, die meet hoe ver het model van een perfecte fit af zit. Voor twee geneste GLM’s is het verschil in hun devianties gelijk aan de LRT-grootheid D, dus heet de toets vaak een analyse van deviantie.
De vrijheidsgraden werken hetzelfde als eerder, als het verschil in aantal parameters. Voor modellen met een geschatte spreidingsparameter, zoals gamma- of Gaussiaanse GLM’s, wordt vaak een F-toets op het deviantieverschil gebruikt in plaats van de chi-kwadraatversie.
Elk model dat met maximum likelihood is geschat kan een LRT gebruiken, zolang de modellen genest zijn. Bijvoorbeeld:
De LRT lijkt op de Wald-toets en de scoretoets. Alle drie testen dezelfde nulhypothese en volgen in grote steekproeven een chi-kwadraatverdeling. Het verschil zit in welke modellen je past en wat je meet.
De LRT past beide modellen en vergelijkt hun log-likelihoods. De Wald-toets past alleen het volledige model en kijkt hoe ver elke schatting van zijn nulwaarde afligt, gemeten in standaardfouten.
Voor één coëfficiënt is de Wald-grootheid de schatting gedeeld door zijn standaardfout. De p-waarden in een regressietabel komen doorgaans uit deze toets.
De Wald-toets is snel, omdat je maar één model past. Maar hij hangt af van hoe je het model parameteriseert, en bij logistische regressie kan hij slecht gedrag vertonen wanneer coëfficiënten heel groot zijn, omdat de standaardfout sneller groeit dan de schatting. De LRT heeft geen van beide problemen en is daarom de veiligere keuze.
De scoretoets past alleen het beperkte model.
Hij kijkt naar de helling van de log-likelihood bij de nul-parameterwaarden. Als de nulhypothese klopt, zou de helling dicht bij 0 moeten zijn. Een steile helling betekent dat de likelihood zou toenemen als je die parameters van de nul laat afwijken.
Dit maakt de scoretoets handig wanneer het volledige model duur of lastig te passen is. Hij staat ook bekend als de Lagrange-multiplicatortoets en wordt vaak gebruikt om kandidaat-voorspellers te screenen voordat je ze toevoegt.
De LRT-grootheid volgt in grote steekproeven een chi-kwadraatverdeling, maar dat maakt de LRT geen "chi-kwadraattoets" in de gebruikelijke zin.
"Chi-kwadraattoets" is een brede aanduiding voor elke toets waarvan de grootheid een chi-kwadraatverdeling volgt. Meestal bedoelen mensen ermee de chi-kwadraattoets van Pearson voor onafhankelijkheid of voor goodness-of-fit in kruistabellen.
De twee zijn wel verbonden. De likelihoodversie van Pearson’s toets heet de G-toets en vergelijkt geobserveerde en verwachte tellingen met log-likelihoods in plaats van gekwadrateerde verschillen. In grote steekproeven geven beide vergelijkbare resultaten.
Zo vergelijken de drie modelgebaseerde toetsen:
| Wald-toets | Likelihoodratiotoets | Scoretoets | |
|---|---|---|---|
| Modellen die je past | Alleen volledig | Beperkt en volledig | Alleen beperkt |
| Wat het meet | Afstand van de schatting tot de nulwaarde, in standaardfouten | Verschil tussen de gemaximaliseerde log-likelihoods | Helling van de log-likelihood bij de nulwaarden |
| Waar je het ziet | Coëfficiënt-p-waarden in regressiesamenvattingen | Vergelijkingen van geneste modellen en analyse van deviantie | Screening van nieuwe voorspellers, modellen die lastig te passen zijn |
| Zwak punt | Hangt af van de parameterisatie, onbetrouwbaar bij zeer grote schattingen | Vereist dat je beide modellen past | Gebruikt alleen informatie dicht bij de nulwaarden |
| Grote-steekproefverdeling | Chi-kwadraat | Chi-kwadraat | Chi-kwadraat |
Likelihoodratio vergeleken met andere statistische toetsen
Beide termen hebben "ratio" in de naam en komen allebei vaak voor bij logistische regressie. Daar houdt de overeenkomst op.
Een likelihoodratio vergelijkt hoe goed twee hypotheses de geobserveerde data verklaren. Een oddsratio vergelijkt de odds van een uitkomst tussen twee groepen of condities.
Odds zijn de kans op een gebeurtenis gedeeld door de kans dat die niet gebeurt. Een churnkans van 25% betekent odds van 0,25 / 0,75, of 1 op 3.
In het churnmodel van eerder is de coëfficiënt van support_tickets 0,456. De exponent daarvan geeft een oddsratio van ongeveer 1,58, wat betekent dat elk extra supportticket de odds op churn met 1,58 vermenigvuldigt.
Dat is een uitspraak over een effect in de data. Een likelihoodratio is een uitspraak over bewijs: hoeveel beter de ene hypothese of het ene model dezelfde data verklaart dan de andere.
Dus de oddsratio beantwoordt "hoe groot is het effect?", en de likelihoodratio beantwoordt "welke verklaring steunen de data meer?"
In de geneeskunde heeft "likelihoodratio" een tweede betekenis. Het beschrijft hoeveel een testresultaat de odds verandert dat een patiënt een aandoening heeft, en het omvat geen modelschatting of p-waarden.
Diagnostische likelihoodratio’s komen voort uit twee eigenschappen van een test:
Stel, een test heeft een sensitiviteit van 90% en een specificiteit van 80%.
De positieve likelihoodratio, of LR+, laat zien hoeveel waarschijnlijker een positieve uitslag is bij mensen met de aandoening dan bij mensen zonder:
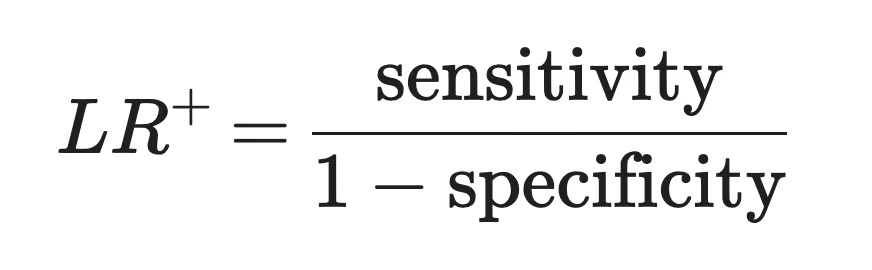
Positieve likelihoodratio
Voor de voorbeeldtest is dat 0,9 / 0,2 = 4,5. Een positieve uitslag is 4,5 keer zo waarschijnlijk bij iemand met de aandoening. Waarden boven 1 verhogen de odds op de aandoening, en hoe hoger de waarde, hoe informatiever een positieve uitslag is.
De negatieve likelihoodratio, of LR-, laat zien hoe waarschijnlijk een negatieve uitslag is bij mensen met de aandoening vergeleken met mensen zonder:
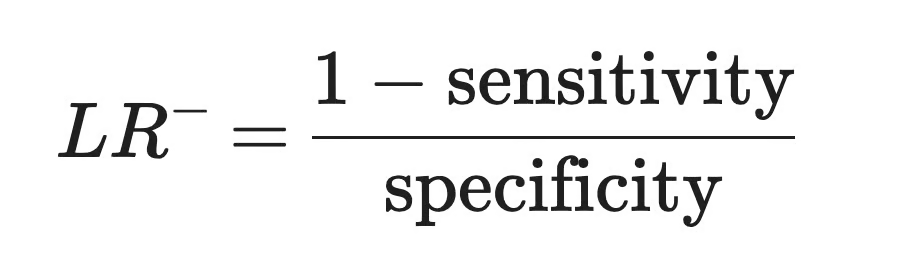
Negatieve likelihoodratio
Voor de voorbeeldtest is dat 0,1 / 0,8 = 0,125. Waarden onder 1 verlagen de odds op de aandoening, en hoe dichter de waarde bij 0 ligt, hoe informatiever een negatieve uitslag is.
Diagnostische likelihoodratio’s zijn nuttig omdat ze updaten wat je vóór de test wist:
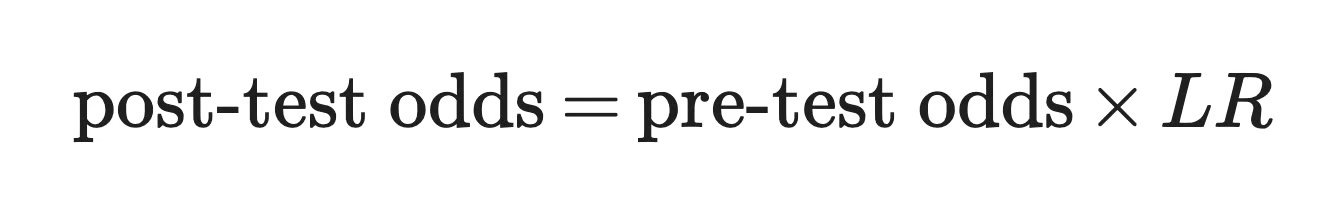
Diagnostische likelihoodratio
Stel dat 10% van de patiënten zoals deze de aandoening heeft. Dat zijn pretest-odds van 0,1 / 0,9, of ongeveer 0,111.
Na een positieve uitslag worden de odds 0,111 * 4,5 = 0,5, wat een kans van ongeveer 33% is. Na een negatieve uitslag worden ze 0,111 * 0,125 = 0,014, of ongeveer 1,4%.
Dit is de enige plek in het artikel waar een likelihoodratio leidt tot de kans op een hypothese, en dat kan alleen omdat de pretest-odds de prior leveren.
Beide talen hebben alles wat je nodig hebt om in een paar regels een LRT te draaien. Ik gebruik de eerdergenoemde churn-dataset, zodat de getallen overeenkomen met die in de interpretatie- en regressiesecties.
Je hebt numpy, pandas, statsmodels en scipy nodig. Begin met het genereren van de dataset:
import numpy as np
import pandas as pd
import statsmodels.formula.api as smf
from scipy import stats

# Generate a synthetic customer churn dataset
rng = np.random.default_rng(42)
n_customers = 1000

churn = pd.DataFrame({
    "tenure_months": rng.integers(1, 73, n_customers),
    "monthly_charges": rng.uniform(20, 120, n_customers).round(2),
    "support_tickets": rng.poisson(1.5, n_customers),
})

# Churn gets less likely with tenure and more likely with charges and tickets
log_odds = (
    -0.5
    - 0.04 * churn["tenure_months"]
    + 0.01 * churn["monthly_charges"]
    + 0.25 * churn["support_tickets"]
)
churn["churned"] = rng.binomial(1, 1 / (1 + np.exp(-log_odds)))

# Save the data so you can load the same dataset in R
churn.to_csv("churn.csv", index=False)
In deze dataset is de churnratio 32,1%.
Pas vervolgens de beperkte en volledige logistische regressiemodellen. Het attribuut .llf bevat de gemaximaliseerde log-likelihood van elk model:
# Fit the restricted and full models
reduced_model = smf.logit("churned ~ tenure_months", data=churn).fit(disp=0)
full_model = smf.logit(
    "churned ~ tenure_months + monthly_charges + support_tickets",
    data=churn,
).fit(disp=0)

# Get the maximized log-likelihoods
print(f"Restricted model log-likelihood: {reduced_model.llf:.2f}")
print(f"Full model log-likelihood: {full_model.llf:.2f}")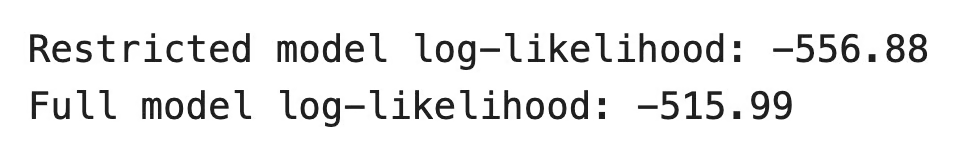
Log-likelihood beperkt en volledig model
statsmodels heeft geen algemene LRT-functie voor logistische regressie, dus je berekent de grootheid uit de twee log-likelihoods. Het attribuut .df_model geeft het aantal voorspellers in elk model, en stats.chi2.sf() retourneert de p-waarde:
lr_stat = 2 * (full_model.llf - reduced_model.llf)
df_diff = full_model.df_model - reduced_model.df_model
p_value = stats.chi2.sf(lr_stat, df_diff)

print(f"LR statistic: {lr_stat:.2f}")
print(f"Degrees of freedom: {df_diff:.0f}")
print(f"P-value: {p_value:.1e}")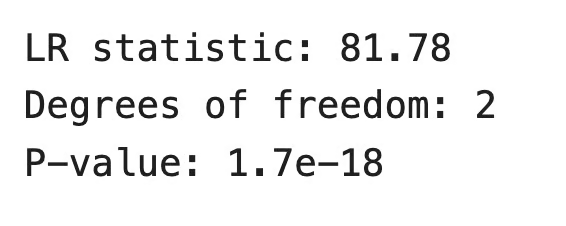
Toetsingsgrootheid, vrijheidsgraden en p-waarde
De p-waarde ligt ver onder 0,05, dus je verwerpt de nulhypothese. De data leveren sterk bewijs dat monthly_charges en support_tickets de fit verbeteren ten opzichte van een model met alleen tenure_months.
Voor de vergelijking met een model met alleen intercept heb je geen extra code nodig. statsmodels berekent dit voor elk logistisch regressiemodel:
print(f"Intercept-only log-likelihood: {full_model.llnull:.2f}")
print(f"LR statistic: {full_model.llr:.2f}")
print(f"P-value: {full_model.llr_pvalue:.1e}")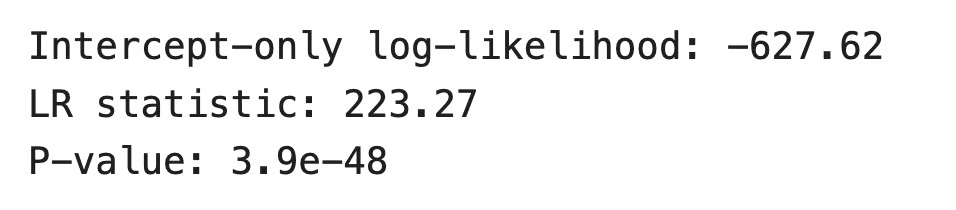
Vergelijking van een volledig model met een model met alleen intercept
R gebruikt niet dezelfde generator voor willekeurige getallen als NumPy, dus laad het bestand churn.csv uit het Python-voorbeeld om met identieke data te werken. Pas dan beide modellen met glm() en geef ze door aan anova():
# Load the churn dataset saved from Python
churn <- read.csv("churn.csv")

# Fit the restricted and full models
reduced_model <- glm(churned ~ tenure_months, data = churn, family = binomial)
full_model <- glm(
  churned ~ tenure_months + monthly_charges + support_tickets,
  data = churn,
  family = binomial
)

# Check the maximized log-likelihoods
logLik(reduced_model)
logLik(full_model)

# Run the likelihood ratio test
anova(reduced_model, full_model, test = "Chisq")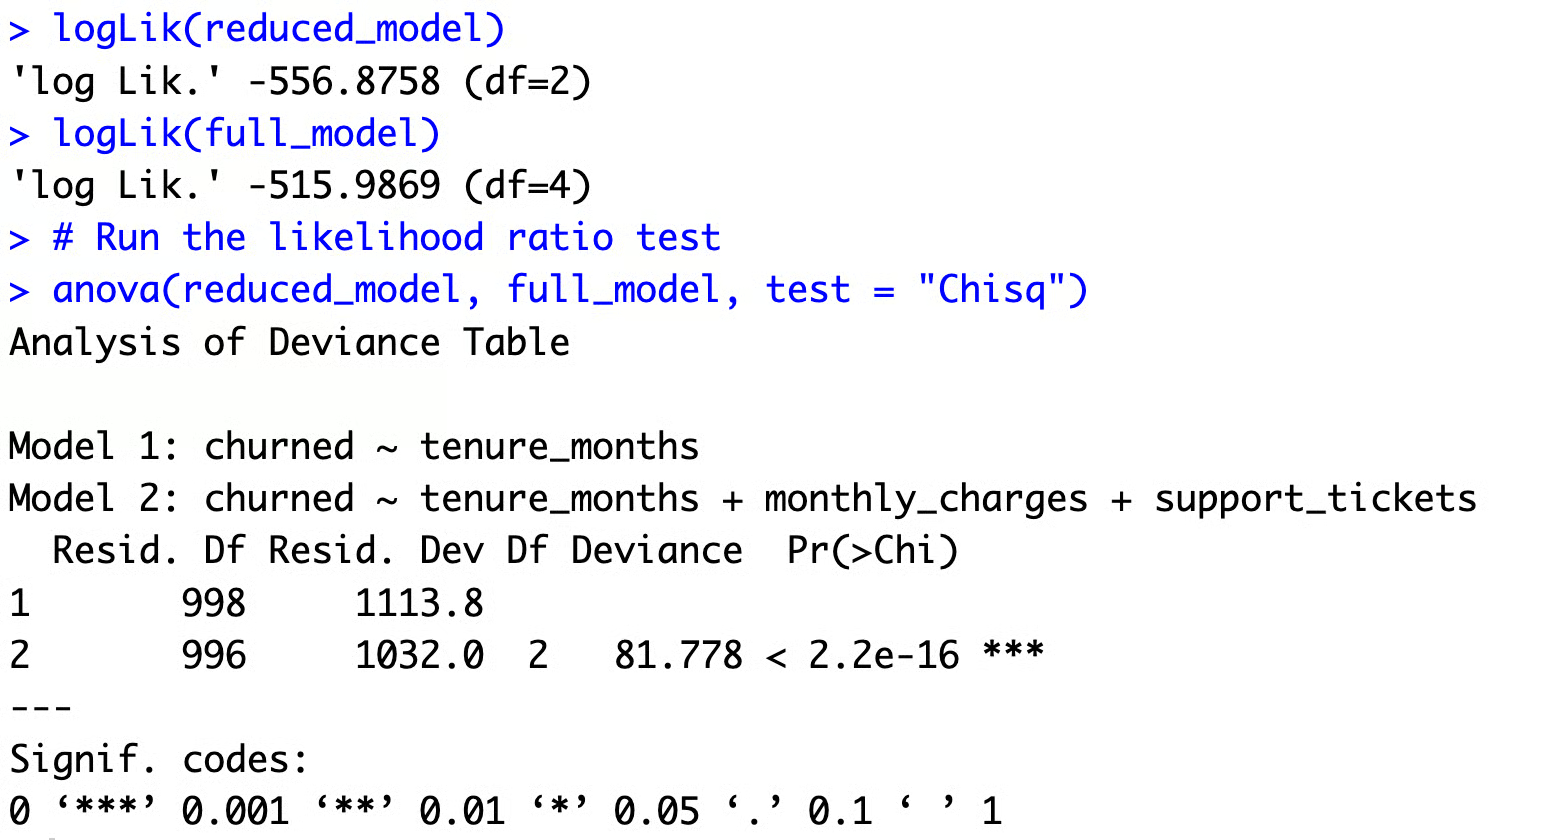
Log-likelihoods en ratiotoets in R
De df-waarden naast elke log-likelihood zijn het aantal geschatte parameters, inclusief intercept. Het volledige model heeft er twee meer, wat overeenkomt met de kolom Df in de anova()-tabel.
De kolom Deviance toont 81,778, dezelfde LR-grootheid als je in Python kreeg. Dat is de analyse van deviantie uit de GLM-sectie in actie: de daling in residuele deviantie van 1113,8 naar 1032,0 is de toetsingsgrootheid.
R print de p-waarde als < 2.2e-16 omdat dat de kleinste waarde is die het standaard toont, niet omdat die afwijkt van het Python-resultaat. Hoe dan ook is de conclusie hetzelfde, en de extra voorspellers verbeteren de fit.
Als je een speciale functie verkiest, voert lrtest() uit het pakket lmtest dezelfde vergelijking uit met lrtest(reduced_model, full_model).
De LRT werkt goed in de situaties die tot nu toe aan bod kwamen, maar zijn chi-kwadraatresulaat hangt af van een paar voorwaarden.
De standaard LRT vergelijkt alleen geneste modellen, waarbij het beperkte model een speciaal geval is van het volledige model.
Wil je een logistisch regressiemodel met een probitmodel vergelijken, of twee modellen met verschillende voorspellers, dan is geen van beide een speciaal geval van de ander. De chi-kwadraatverdeling is daar niet van toepassing. Gebruik in plaats daarvan informatiecriteria zoals AIC en BIC, of de Vuong-toets voor niet-geneste modellen.
De toets vergelijkt gemaximaliseerde likelihoods, dus beide modellen moeten met maximum likelihood op dezelfde data zijn gepast.
Twee veelvoorkomende dingen kunnen hier misgaan. Mixed-effects-modellen die met REML zijn gepast, de standaard in veel pakketten, kunnen niet met een LRT worden vergeleken wanneer ze verschillen in fixed effects - pas ze dus eerst met maximum likelihood. En gepenaliseerde modellen zoals lasso of ridge-regressie maximaliseren de likelihood zelf niet, dus de gebruikelijke toets is daarop niet van toepassing.
De modellen hebben ook dezelfde observaties nodig. Als één voorspeller missende waarden heeft, kan het volledige model rijen laten vallen, en zijn de twee log-likelihoods niet langer vergelijkbaar.
De stelling van Wilks is een resultaat voor grote steekproeven. Hij geldt onder regulariteitsvoorwaarden, wat in gewone taal betekent dat de likelihood glad verloopt, de parameters identificeerbaar zijn en de ware parameterwaarden binnen het toegestane bereik liggen in plaats van op de rand.
Wanneer deze voorwaarden gelden, is de chi-kwadraatverdeling een goede benadering voor grote steekproeven. Het blijft een benadering.
Bij kleine steekproeven hoeft de LRT-grootheid geen chi-kwadraatverdeling te volgen, en kunnen de p-waarden te klein of te groot uitvallen.
Je hebt hier een paar opties. Een parametrische bootstrap simuleert nieuwe datasets uit het beperkte model en bouwt de verdeling van de grootheid op. Voor simpele gevallen, zoals kruistabellen, vermijden exacte toetsen de benadering.
Sommige nulhypothesen plaatsen een parameter op de rand van zijn toegestane bereik. Het meest voorkomende voorbeeld is testen of een variantie van een random effect in een mixed model gelijk is aan 0, omdat een variantie niet negatief kan zijn.
In dat geval volgt de grootheid niet de gebruikelijke chi-kwadraatverdeling. Voor één variantiecomponent volgt die een 50:50-mix van een chi-kwadraat met 0 en 1 vrijheidsgraden, dus de standaard p-waarde is ongeveer twee keer zo groot als hij zou moeten zijn. De standaardtoets is hier conservatief, wat betekent dat hij echte effecten vaker mist.
Het testen van het aantal componenten in een mixmodel heeft een vergelijkbaar probleem. Als je één component vergelijkt met twee, falen de regulariteitsvoorwaarden, en de chi-kwadraatbenadering houdt helemaal niet meer stand.
De LRT gaat ervan uit dat het volledige model correct is. Als beide modellen de verdeling van de data verkeerd hebben, zoals een Poissonmodel voor tellingen met veel meer variantie dan het gemiddelde, volgt de grootheid zelfs in grote steekproeven geen chi-kwadraatverdeling.
Controleer de fit van je volledige model voordat je de toets vertrouwt. Voor overgedispergeerde tellingen is een negatief-binomiaal model of een quasi-likelihood F-toets vaak een betere keuze.
De chi-kwadraatbenadering is dus een default, geen garantie, en geldt alleen wanneer de opzet overeenkomt met de voorwaarden achter de stelling van Wilks.
Een likelihoodratio vergelijkt hoe goed twee hypotheses of modellen dezelfde geobserveerde data verklaren. Dat is het hele idee, en alles in dit artikel bouwt daarop voort.
De likelihoodratiotoets maakt van dat idee een formele procedure. Hij past twee geneste modellen, vergelijkt hun gemaximaliseerde log-likelihoods en gebruikt de chi-kwadraatverdeling om een p-waarde te krijgen. Je ziet hem het vaakst bij logistische regressie en andere GLM’s, en zowel statsmodels als R voeren hem uit met een paar regels code.
Maar onthoud wat het getal betekent. Een likelihoodratio toont relatieve steun voor de ene hypothese boven de andere, niet de kans dat een van beide waar is. Daarvoor heb je voorafkansen nodig, zoals in diagnostische tests.
Wil je verder gaan, dan zijn de volgende stappen de bouwstenen achter de toets: likelihood zelf, maximum likelihoodschatting, en hoe de Wald-toets en andere hypothesetoetsen zich tot de LRT verhouden.
Leer met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

