Cursus
Praktische AI met Google Gemini en NotebookLM
2 uur
10K
Google brengt Flash-modellen uit in een tempo dat nauwelijks is bij te houden. Gemini 3.8 Flash is de derde Flash-release van het bedrijf in zes weken en is het beste redeneer- en codemodel in de Flash-laag, met dezelfde snelheid en lage kosten als 3.7 Flash van drie weken eerder.
Naast het standaardmodel introduceerde Google Gemini 3.8 Flash Cyber, een variant afgestemd op cybersecuritywerk die alleen beschikbaar is voor vertrouwde verdedigers via het Fairwind Program, een initiatief met beperkte toegang dat tegelijk met de nieuwe modellen werd gelanceerd. Beide modellen delen dezelfde fundamentele intelligentie.
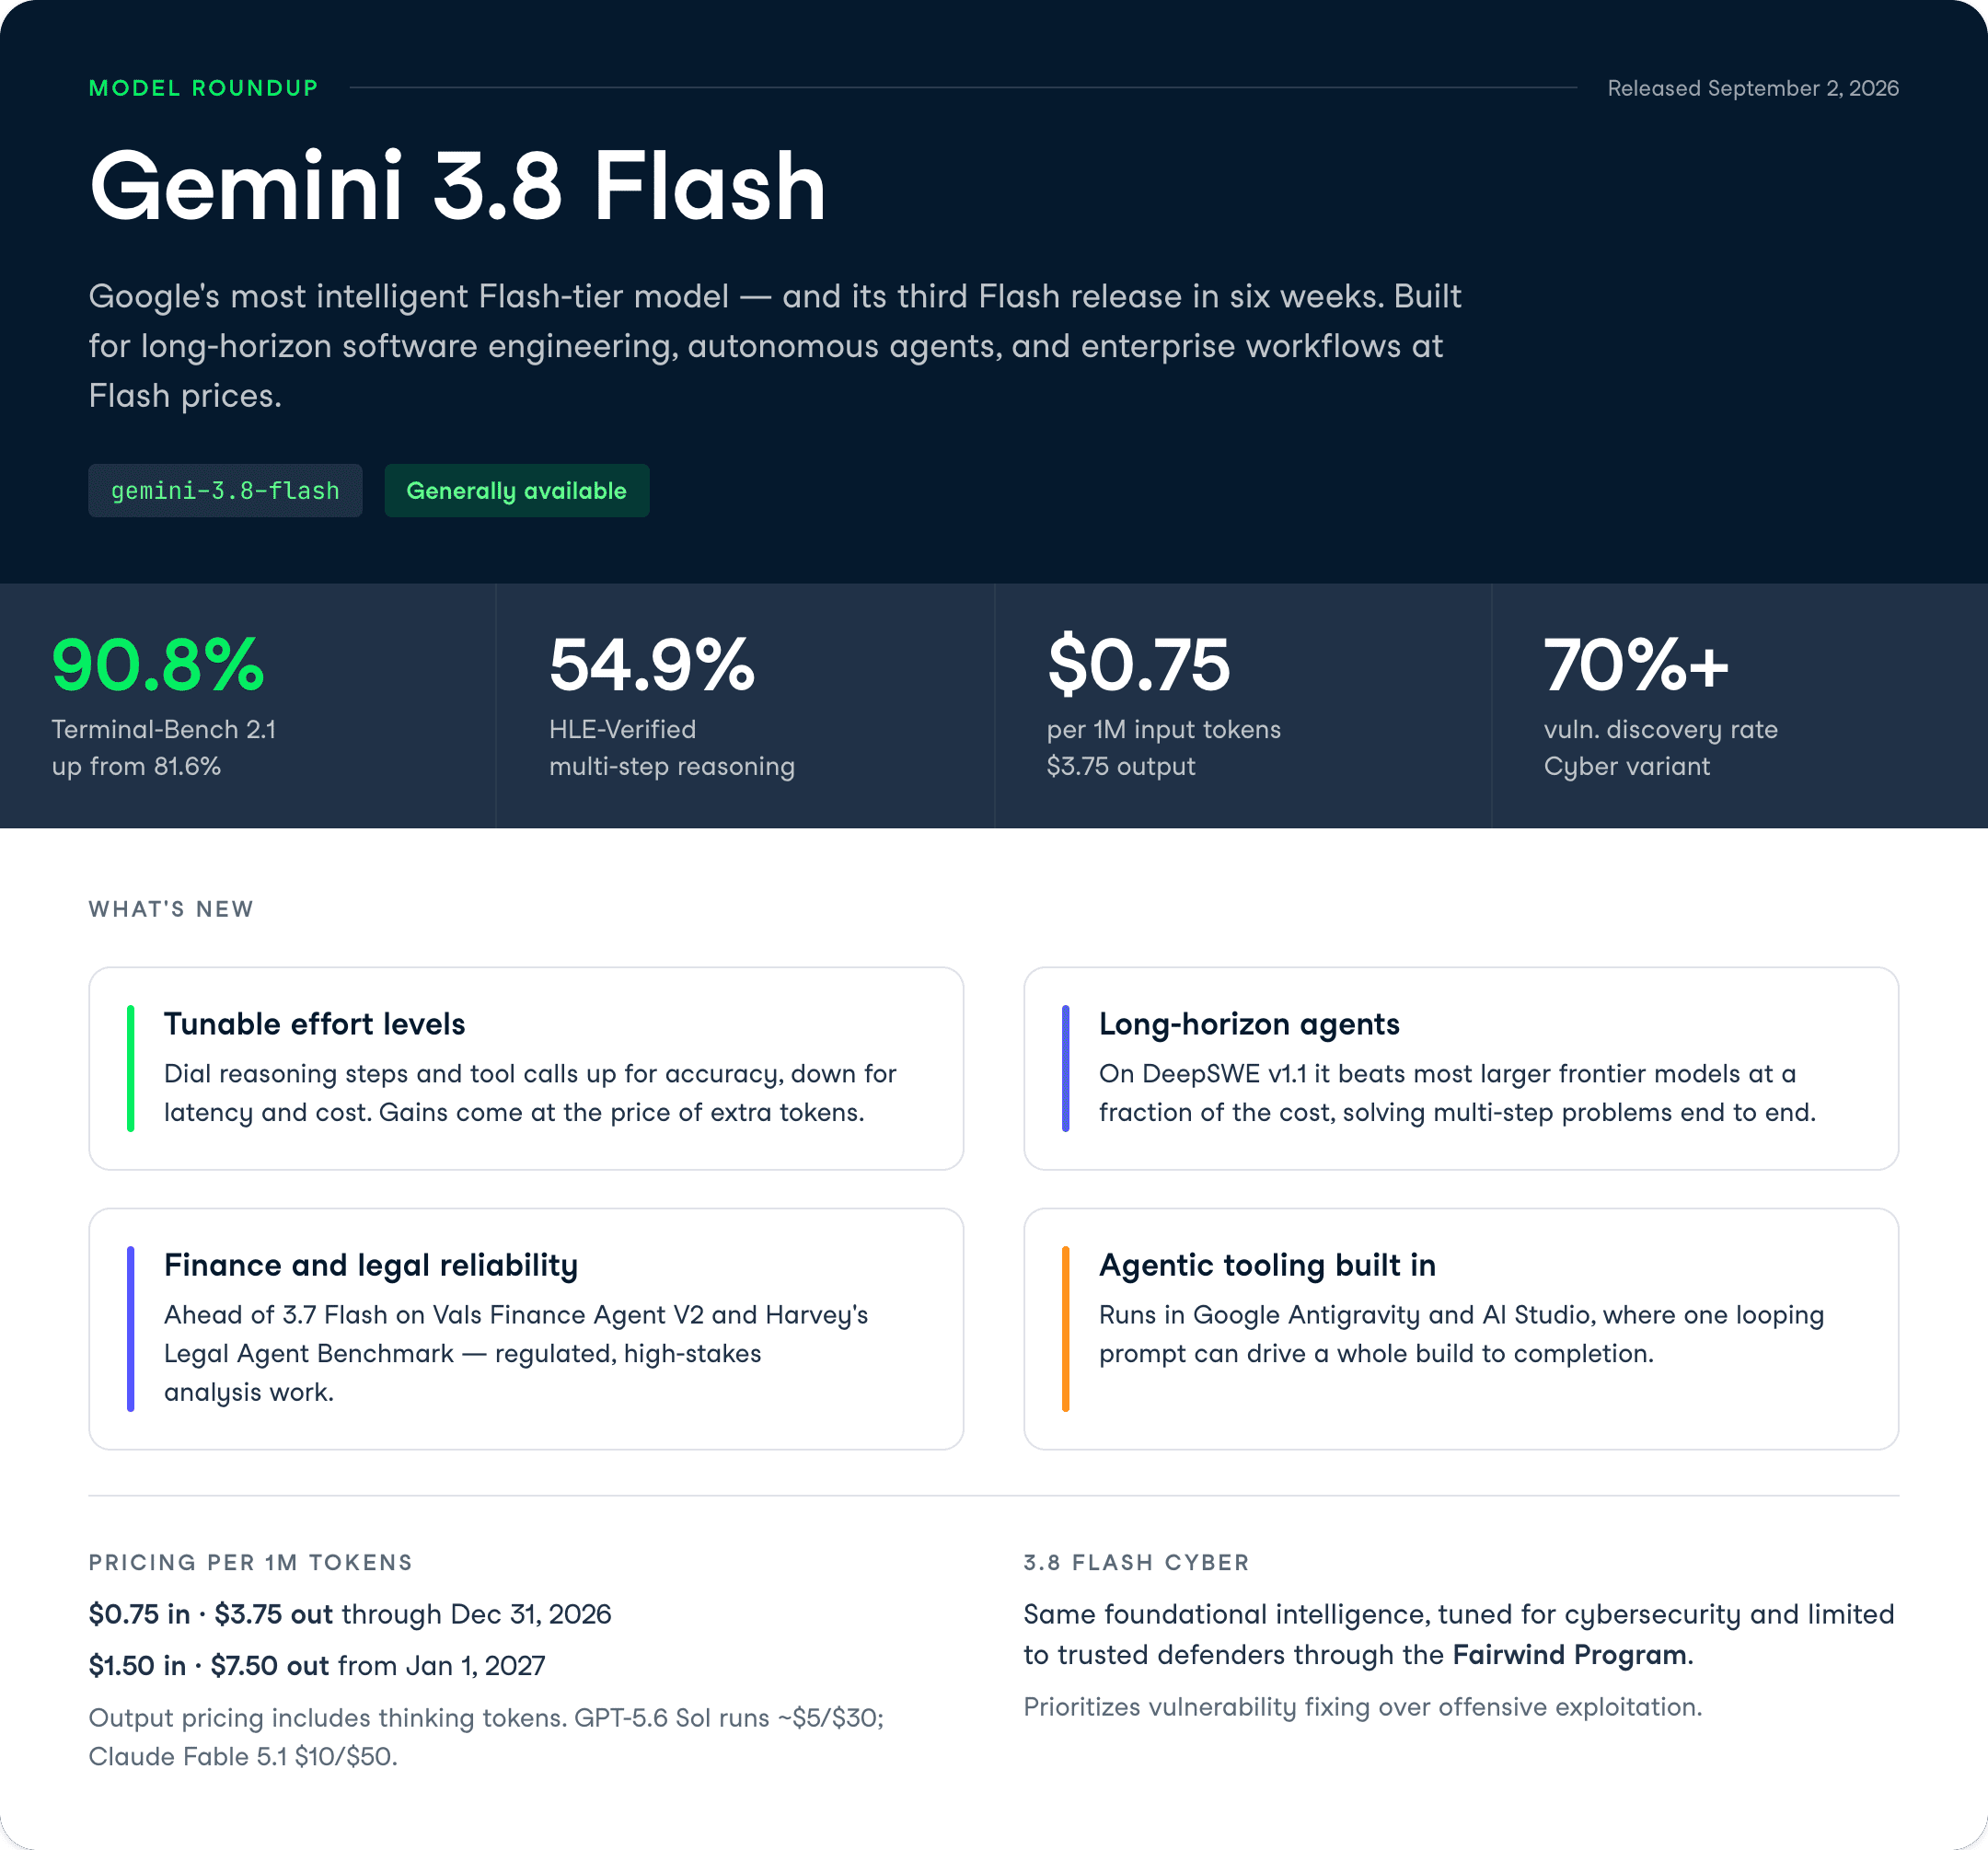
De headline-cijfers zijn sterk: Gemini 3.8 Flash scoort 90,8% op Terminal-Bench 2.1 (tegenover 81,6% voor 3.7 Flash), 54,9% op HLE-Verified, en een discovery rate voor kwetsbaarheden in de echte wereld van boven de 70% voor de Cyber-variant.
In dit artikel behandel ik alles wat nieuw is in Gemini 3.8 Flash en 3.8 Flash Cyber: de nieuwe functies, de benchmarks en hands-on voorbeelden. Zie het model in actie in onze Gemini 3.8 Flash API-tutorial, en lees over Google’s nieuwste spraakassistentmodel in onze gids Gemini 3.8 Live.
Wil je de concurrenten begrijpen waartegen deze modellen het opnemen? Lees dan onze gidsen DeepSeek v4.1 vs Gemini 3.8 Flash en Claude Opus 5 vs Sonnet 5.
Gemini 3.8 Flash is Google’s meest intelligente model in de Flash-laag, ontworpen voor long-horizon softwareontwikkeling, autonome agents en complexe bedrijfsworkflows.
Het zit onder de Pro-laag (zoals Gemini 3.1 Pro) maar kost een fractie daarvan, met het introductietarief van $0,75 per 1M inputtokens en $3,75 per 1M outputtokens t/m 31 december 2026.
De belangrijkste verandering ten opzichte van 3.7 Flash is dat 3.8 Flash simpelweg harder werkt.
Bij complexe taken draait het extra redeneerstappen en roept het iteratief tools aan, waardoor het de prestaties van duurdere frontiermodellen kan benaderen. De keerzijde is token-overhead: op hogere inspanningsniveaus kan het model meer tokens verbruiken om de laatste paar punten nauwkeurigheid eruit te persen.
De meest opvallende benchmark is Terminal-Bench 2.1, waar 3.8 Flash 90,8% scoorde tegenover 81,6% voor 3.7 Flash. Terminal-Bench meet hoe betrouwbaar een model echte command-line- en codetaken van begin tot eind voltooit, dus een sprong van 9 punten wijst direct op beter agentisch codeergedrag.
 Wat is er nieuw in Gemini 3.8 Flash?
De functies in 3.8 Flash zijn gericht op developers die agents en lange codingsessies draaien, niet op casual chatgebruikers.
Dit zijn de capaciteiten die de moeite waard zijn om te kennen.
Je kunt de inspanning van het model hoger of lager zetten, afhankelijk van of je nauwkeurigheid of kosten belangrijker vindt.
Dit is relevant omdat de winst van 3.8 Flash gepaard gaat met extra tokens.
Als je workload primair om efficiëntie draait, zegt Google expliciet dat je op 3.7 Flash kunt blijven, dat volledig ondersteund blijft.
Dat is een ongewoon eerlijke noot voor Google om in een lancering te zetten en laat zien dat de inspanningsknop een echte trade-off is in plaats van gratis performance.
Gemini 3.8 Flash is gebouwd om agents te draaien die meerstaps engineeringproblemen zonder begeleiding doorlopen.
Op DeepSWE v1.1, een long-horizon software-engineeringbenchmark, overtreft het de meeste grotere frontiermodellen voor een fractie van hun kosten, terwijl het complexe problemen end-to-end oplost.
Voor bouwers van codeeragents is dit het cijfer dat telt.
Reddit- en X-gebruikers die pre-release-indrukken lekte, beschreven het als "Fable 5-niveau prestaties tegen Flash-prijzen", en volgens berichtgeving van de Wall Street Journal gaven engineers in Google’s interne Jetski head-to-head tests de voorkeur aan 3.8 Flash boven Anthropic’s Opus-model voor coderen.
Dat is een pittige concurrentieclaim en het is de moeite waard om te verifiëren zodra de API breed beschikbaar is.
3.8 Flash richt zich op gereguleerde, risicovolle sectoren waar een fout antwoord duur is.
Het presteert beter dan 3.7 Flash en andere frontiermodellen op Vals Finance Agent V2 en Harvey’s Legal Agent Benchmark, die beide analyse en rapportage in financiën en recht testen.
Denk aan een workflow waarin een agent een set kwartaalrapportages leest en een compliance-samenvatting opstelt, of contractclausules toetst aan beleid. De vereiste betrouwbaarheid is daar anders dan bij generieke chat, en Google positioneert 3.8 Flash direct voor enterprise-autonomie in deze kennisdomeinen.
Gemini 3.8 Flash draait binnen Google Antigravity en Google AI Studio, waar één doorlopende prompt het door een volledige build kan sturen.
Google’s eigen voorbeeld is een volledig speelbare DOS-achtige versie van Google Maps, gegenereerd uit één prompt in Antigravity, inclusief locaties, routebeschrijvingen en Street View.
Voor je eigen werk: stel je voor dat je één instructie geeft als "bouw een interactief dashboard dat deze CSV inleest, drie grafiektypen plot en me laat filteren op regio", en de agentische loop laat itereren tot het draait.
Het patroon met de doorlopende instructie is waar de extra inspanningsniveaus zich uitbetalen, omdat het model blijft verfijnen in plaats van te stoppen bij een eerste versie.
Het benchmarkbeeld is ongelijk, wat nuttiger is dan een clean sweep omdat het laat zien waar de winst daadwerkelijk is geland.
Coderen en terminaltaken verbeterden sterk, terwijl examengericht redeneren nauwelijks bewoog.
Dit zijn de cijfers uit Google’s developerdocumentatie en aankondiging.
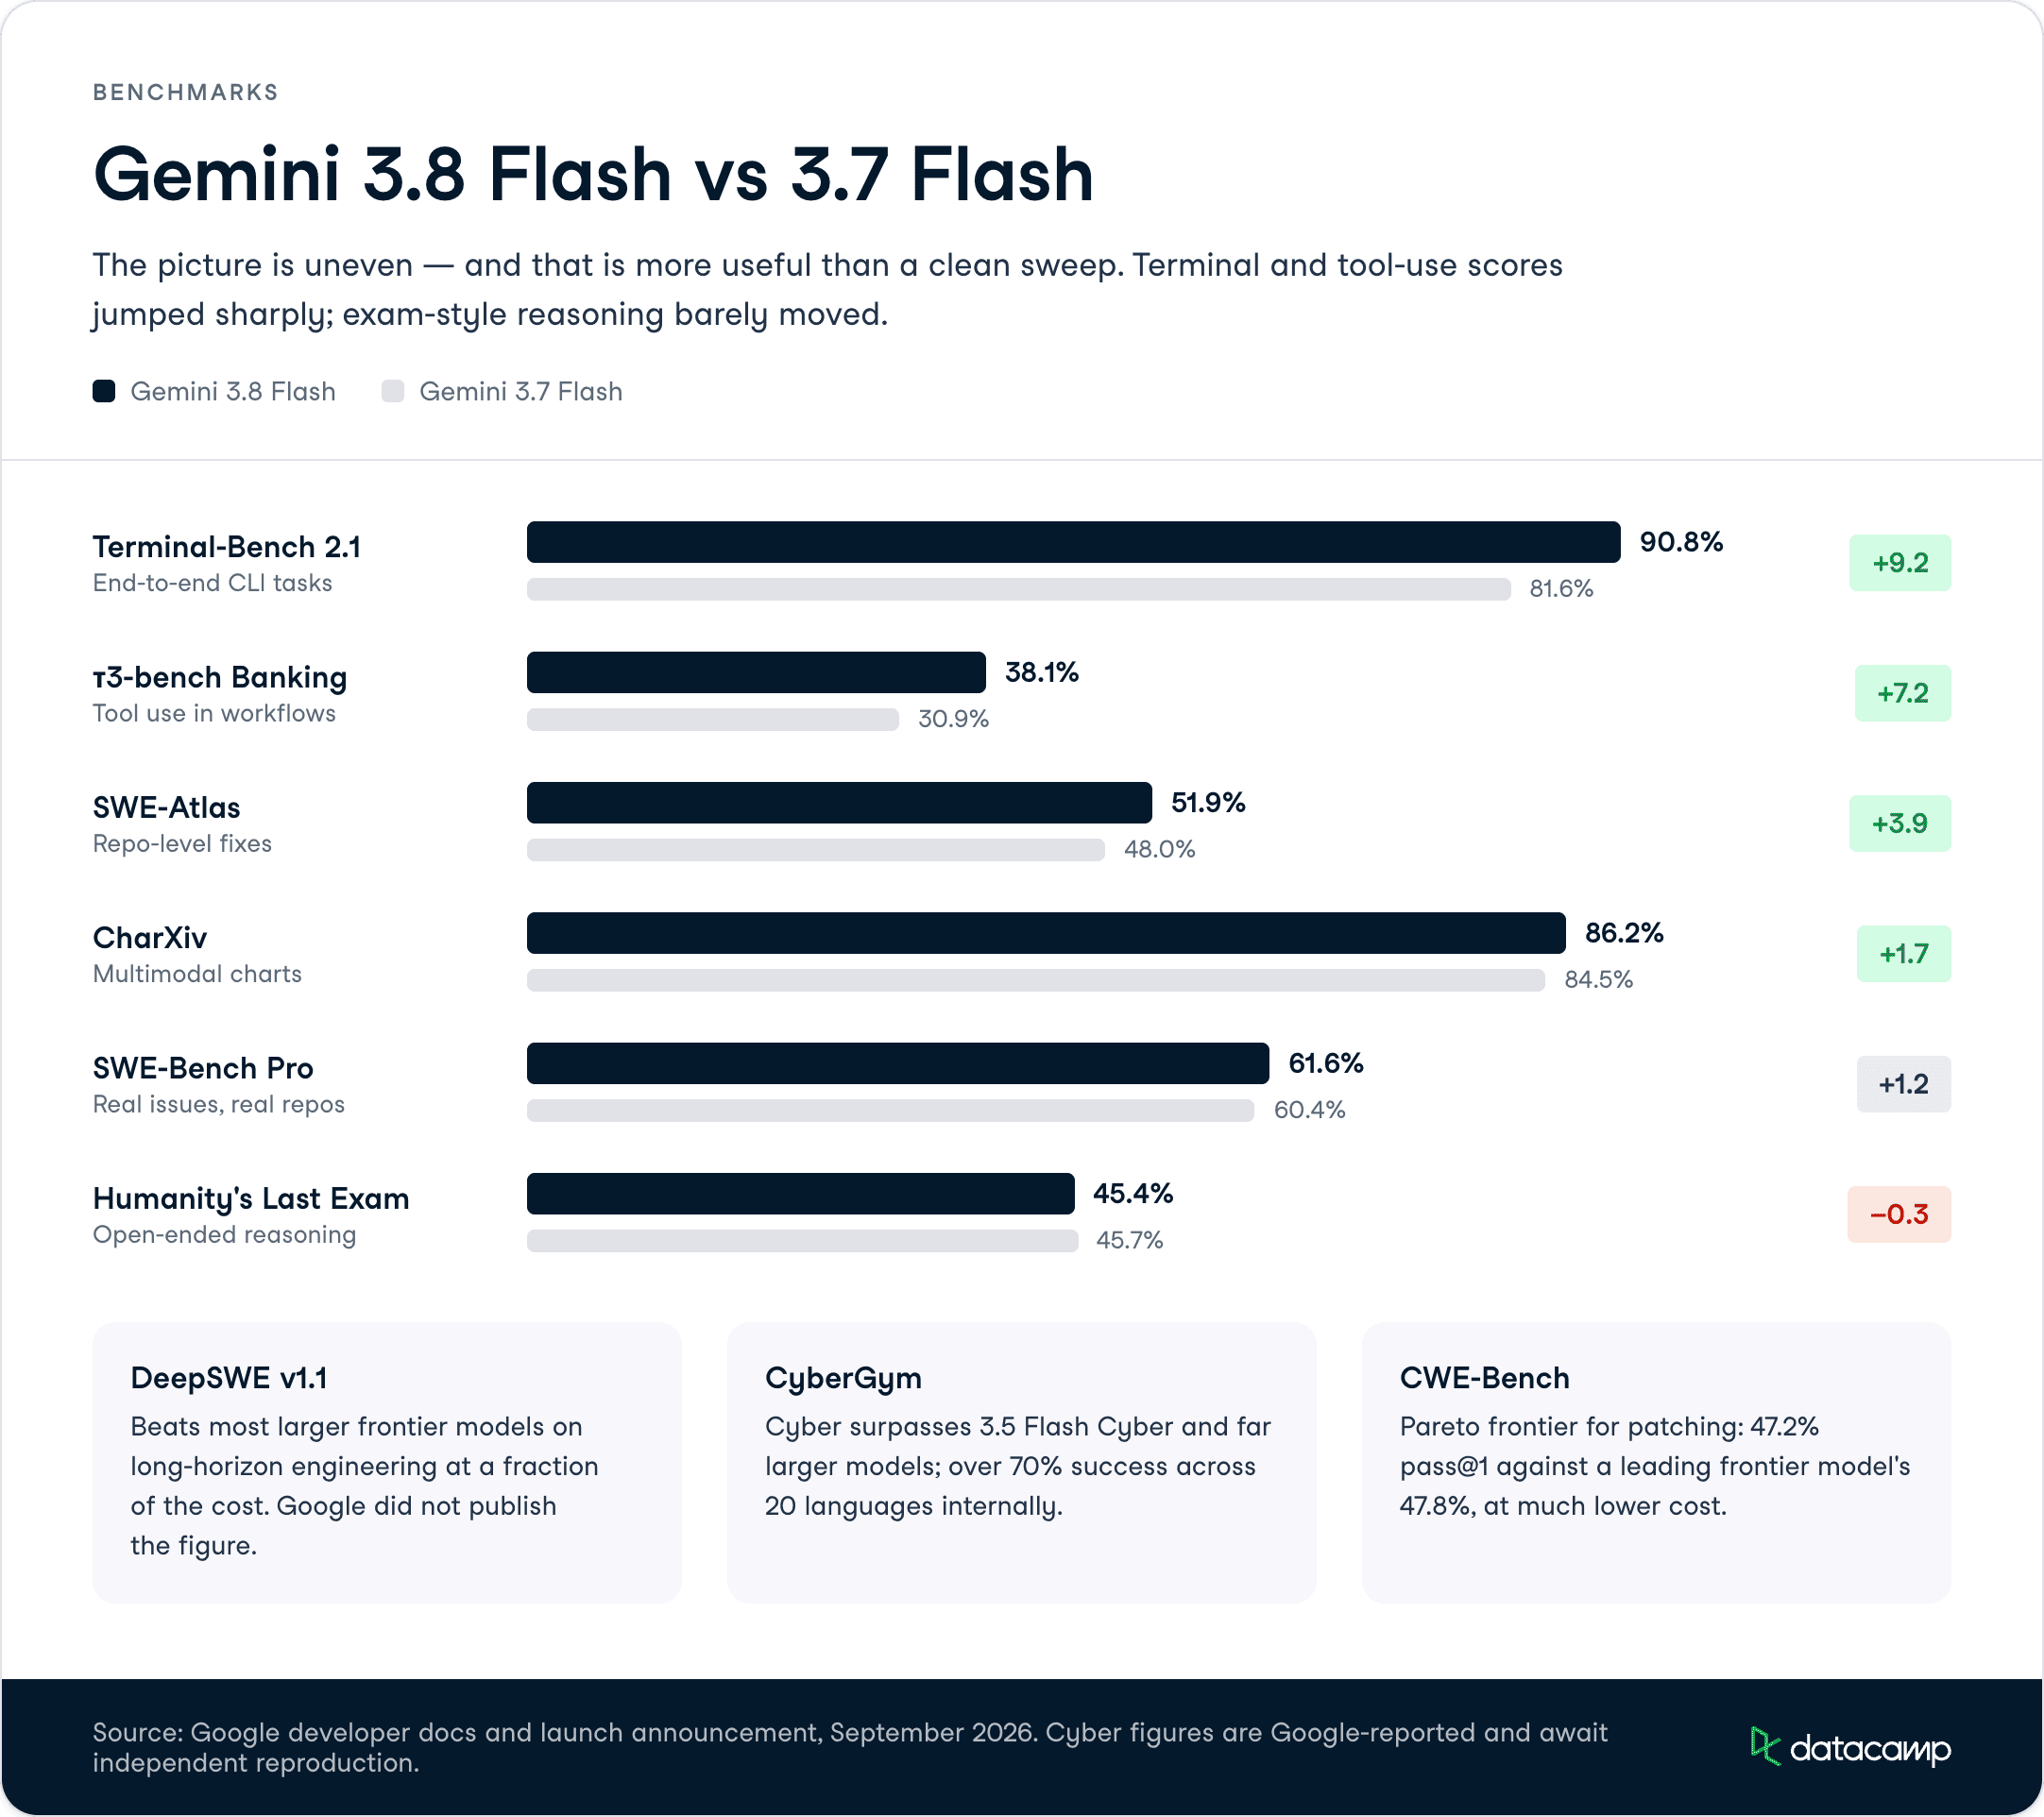
Gemini 3.8 Flash scoorde 90,8% op Terminal-Bench 2.1, tegenover 81,6% voor 3.7 Flash.
Deze benchmark meet hoe betrouwbaar een model echte command-line- en codetaken van begin tot eind voltooit, inclusief het draaien van tools en herstellen van fouten.
Ter context voor rivaliserende mid-tier modellen: in onze GPT-5.6 Terra vs Claude Sonnet 5-vergelijking zagen we dat Terra 87,4% scoorde op Terminal-Bench 2.1 en Sonnet 5 80,4%. Op die scorelijn ligt de 90,8% van 3.8 Flash voor op beide, wat opmerkelijk is voor een Flash-model met $0,75 input.
Op DeepSWE v1.1, een long-horizon software-engineeringbenchmark, overtreft 3.8 Flash de meeste grotere frontiermodellen voor een fractie van hun kosten.
Google publiceerde het exacte percentage niet in de samengevatte notities, maar de strekking is dat het complexe engineeringproblemen autonoom, end-to-end oplost.
Dit is de benchmark die de pitch "een agent die de klus afmaakt" ondersteunt.
Als je workload een agent omvat die vele stappen over een codebase iterereert, ligt DeepSWE dichter bij je realiteit dan een single-shot codingscore.
Op SWE-Bench Pro scoorde 3.8 Flash 61,6% tegenover 60,4% voor 3.7 Flash, en op SWE-Atlas bereikte het 51,9% versus 48,0%.
Dit zijn repository-niveau software-engineeringbenchmarks die het oplossen van echte issues in echte codebases meten.
De winst van iets meer dan 1 punt op SWE-Bench Pro is bescheiden, wat het vermelden waard is. De grootste sprongen zitten in Terminal-Bench, dus als je specifiek om terminal- en toolbetrouwbaarheid geeft, is dát waar 3.8 Flash zich onderscheidt van zijn voorganger.
3.8 Flash behaalt 54,9% op HLE-Verified, een test van meerstaps redeneren over bètavakken, geesteswetenschappen en professionele domeinen.
Op de bredere Humanity’s Last Exam-vergelijking in Google’s developerdocs bleef de score echter nagenoeg gelijk: 45,4% voor 3.8 Flash versus 45,7% voor 3.7 Flash.
Algemeen examengericht redeneren ging niet veel vooruit, dus als je use case zwaar open-ended redeneren vereist in plaats van coderen en toolgebruik, is de upgrade van 3.7 naar 3.8 Flash mogelijk de extra tokens niet waard.
Gemini 3.8 Flash Cyber noteert frontier-niveau resultaten op het ontdekken en patchen van kwetsbaarheden.
Op CyberGym, de standaard industriële benchmark voor autonome kwetsbaarheidsdetectie, overtreft het 3.5 Flash Cyber en aanzienlijk grotere frontiermodellen, en op Google’s interne benchmark over 20 programmeertalen haalt het meer dan 70% succes.
Op CWE-Bench, een externe patchingbenchmark van Collinear, staat Cyber op de Pareto-frontier met een pass@1 van 47,2% tegenover 47,8% voor een toonaangevend frontiermodel, tegen veel lagere kosten.
Google gaf bewust prioriteit aan het oplossen van kwetsbaarheden boven offensieve exploitatie, wat overeenkomt met hoe Anthropic Sonnet 5 levert met cyberbeperkingen standaard aan (0,0% op een Firefox exploit-development-evaluatie, zoals we opmerkten in onze Opus 5 vs Sonnet 5-review).
In de tabel hieronder zie je hoe het nieuwe model zich verhoudt tot zijn piepjonge voorganger:
| Benchmark | Gemini 3.8 Flash | Gemini 3.7 Flash |
|---|---|---|
| Terminal-Bench 2.1 | 90,8% | 81,6% |
| SWE-Bench Pro | 61,6% | 60,4% |
| SWE-Atlas | 51,9% | 48,0% |
| τ³-bench Banking | 38,1% | 30,9% |
| CharXiv (multimodaal) | 86,2% | 84,5% |
| Humanity's Last Exam | 45,4% | 45,7% |
Gemini 3.8 Flash is algemeen beschikbaar via Google AI Studio en het Gemini Enterprise Agent Platform, uitgebracht op 2 september 2026, met de API-model-ID gemini-3.8-flash.
De 3.8 Flash Cyber-variant is beperkt tot vertrouwde verdedigers via het Fairwind Program en is niet algemeen beschikbaar.
De prijzen behouden dezelfde introductietarieven als 3.7 Flash:
Ter vergelijking met rivalen per september 2026: GPT-5.6 Sol kost ongeveer $5 input en $30 output per 1M tokens, en de nieuwe Claude Fable 5.1 kost $10 input en $50 output.
Gemini 3.8 Flash is in beide gevallen ruimschoots goedkoper, en dat is precies het doel van de Flash-laag.
Gemini 3.8 Flash laat zien dat Google vol inzet op de value-kant van de markt voor codemodellen, met een duidelijke strategie: prestaties dicht bij frontier-niveau voor coderen tegen $0,75 input, terwijl er om de paar weken een nieuw Flash-model verschijnt.
De 90,8% op Terminal-Bench 2.1 en de prijs onder $1 maken het een serieuze default voor agentische codingworkloads.
Mijn indruk is dat de release ongelijk is, en Google is daar open over.
Terminal- en toolgebruik-scores sprongen omhoog, DeepSWE en de financiële en juridische benchmarks verbeterden, maar HLE bleef vlak en SWE-Bench Pro bewoog nauwelijks.
Als je codeeragents bouwt, is dit een zinvolle upgrade ten opzichte van 3.7 Flash.
Heb je zware open-ended redenering nodig, dan is de case dunner, en op 3.7 Flash blijven voor efficiency-first werk is een logische keuze.
De Cyber-variant is op langere termijn het interessanter. Een discovery rate van 70%+ in de echte wereld en patching op de Pareto-frontier, afgeschermd via het Fairwind Program en met een voorkeur voor defensie boven exploitatie, is een verdedigbare positie voor een bedrijf dat het al gebruikt om eigen code te beveiligen.
Ik zou onafhankelijke reproducties willen zien voordat ik de CyberGym- en CWE-Bench-cijfers op het eerste gezicht aanneem, omdat bijna alle data tot nu toe van Google zelf komt.
Wil je agents en codingworkflows rond dit soort modellen bouwen, dan is onze AI Agent Fundamentals-skill track een goed startpunt.
Topcursussen op DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min