Nu organisaties tijdens de COVID-19-pandemie versneld digitaliseren, is het belang van het benutten van data, machine learning en analytics groter dan ooit.
De McKinsey Global Survey 2020 over de stand van artificiële intelligentie meldde dat 50% van de bedrijven AI in minstens één bedrijfsfunctie heeft toegepast, en 22% van de organisaties schrijft minstens 5% van de winst vóór rente en belastingen toe aan AI-initiatieven.
Maar om de waarde van data en AI op schaal te ontsluiten, moeten organisaties hun data democratiseren en organisatiebrede datafluency realiseren. Een van de manieren om dit te doen, is door teams en vaardigheidsniveaus toegang te geven tot betrouwbare en bruikbare data, zodat iedereen datagedreven beslissingen kan nemen.
Datainfrastructuur als kern van datademocratisering
Voordat je datafluency bereikt, moet de basis op orde zijn. Dit begint met het begrijpen hoe data door een organisatie stromen en vervolgens toewerken naar een georganiseerde en uniforme datainfrastructuur.
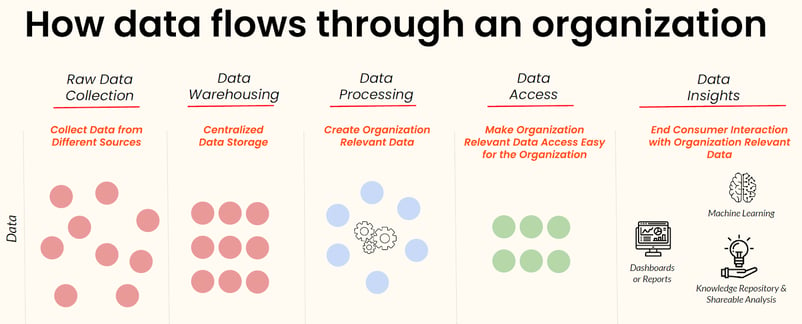
In een webinar over datatrends en voorspellingen voor 2021 beschreef Ramnath Vaidyanathan, Vice President Product Research bij DataCamp, hoe data doorgaans door een organisatie stroomt. Deze stroom vereist data-engineeringtools om ruwe data op te nemen, te verwerken en te transformeren, ze op te slaan op een centrale locatie en inzichten te produceren in de vorm van dashboards en rapporten, machinelearning-outputs en meer.
Toegang tot data op schaal binnen de organisatie hangt sterk af van de aanwezigheid van een solide architectuur voor datainfrastructuur en het gebruik van de nieuwste tooling, die organisaties in staat stelt ruwe data om te zetten in toegankelijke en waardevolle inzichten.
Het belang van datainfrastructuur en tooling blijkt uit de snelle groei en evolutie van deze markt. Veel oplossingen zijn bedoeld om het werken met een specifiek onderdeel van de datainfrastructuur van een organisatie te stroomlijnen, wat heeft geleid tot een steeds gefragmenteerder landschap van tools dat lastig te navigeren kan zijn.
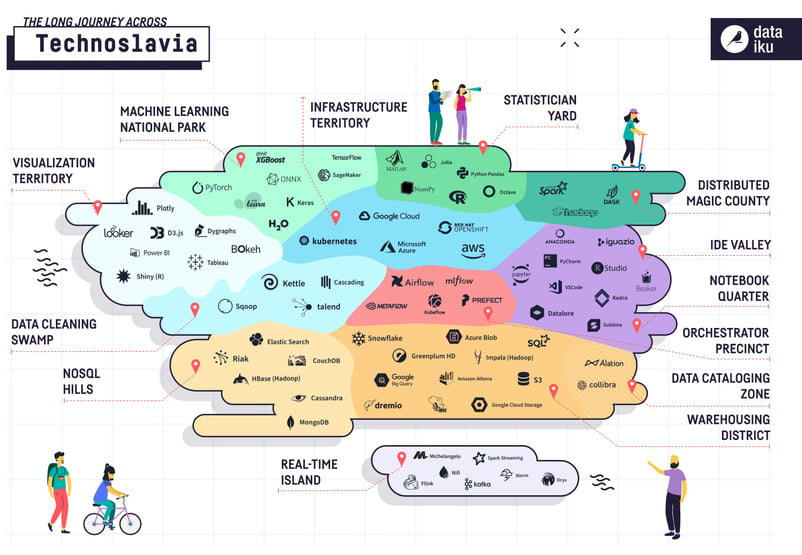
De volgende visual van Dataiku laat goed zien hoe de markt voor datainfrastructuur is opgedeeld in talloze fijnmazige categorieën, met binnen elk segment een groeiende lijst concurrerende oplossingen.
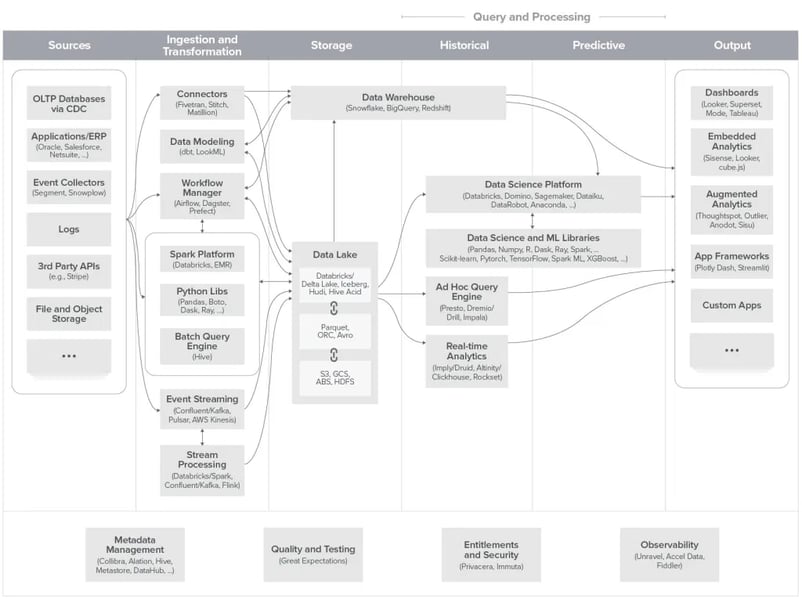
Laat vorig jaar probeerde Andreessen Horowitz meer duidelijkheid te scheppen in dit complexe landschap door een verenigd architectuurraamwerk te ontwikkelen. Met de groeiende noodzaak om met grote hoeveelheden data te werken en de overvloed aan beschikbare oplossingen biedt dit raamwerk een praktisch referentiepunt bij het moderniseren, in kaart brengen en bouwen van de datastack van een organisatie.
Naarmate dit domein en deze trend zich ontwikkelen, zullen we consolidatie en standaardisatie van diverse tools in de datainfrastructuurstack zien. Dit, samen met cloudadoptie, datadiscoverytools en gecentraliseerde datagovernanceplatformen, stelt organisaties in staat schaalbare toegang tot data te bieden over teams en functies heen.
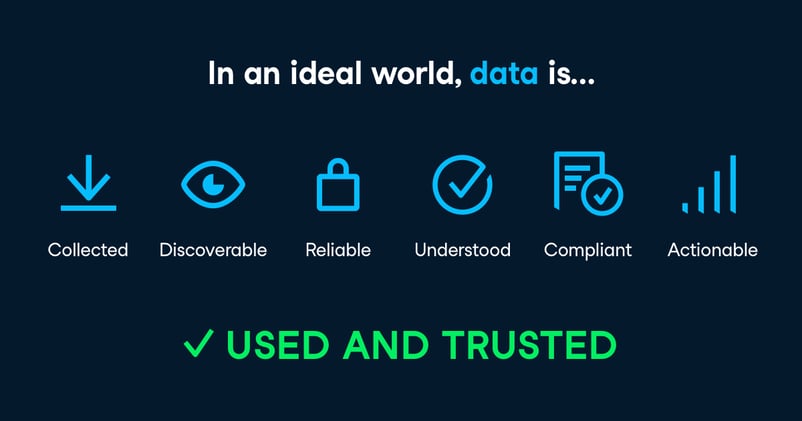
Wat levert een ideale toekomstige datainfrastructuur dan op? Volgens Maksim Pecherskiy, Data Engineer bij de Wereldbank en voormalig CDO van de stad San Diego, moeten data verzameld, vindbaar, betrouwbaar, begrepen, compliant en actiegericht zijn. Uiteindelijk is het doel data bruikbaar en betrouwbaar te maken, wat op zijn beurt organisatiebrede datafluency stimuleert.
Naarmate tooling rond datademocratisering in 2021 en daarna volwassener wordt, geldt dat ook voor de adoptie en groei van de volgende technologieën:
1. Cloudadoptie
Het gebruik van cloudtechnologieën wordt de norm, zeker na de versnelde data-gedreven digitale transformatie die we in 2020 hebben gezien.
Naast het verbeteren van dataopslag en -toegang bieden cloudoplossingen ook tal van gebruiksvriendelijke producten voor het verzamelen, inladen, transformeren, opslaan en creëren van inzichten uit data.
Er zijn talloze aanbieders van cloudplatforms, en een van de belangrijkste spelers is Amazon Web Services (AWS), dat meer dan 100 producten heeft waarmee ondernemingen hun data razendsnel, op schaal en tegen lage kosten optimaal kunnen benutten.
Het opschalen van datainfrastructuur wordt cruciaal naarmate datatabellen, rapporten en modellen worden toegevoegd aan het datalandschap van organisaties. Stakeholders moeten eenvoudig betrouwbare, begrepen, conforme en actiegerichte data en inzichten kunnen vinden om hun werk optimaal te doen.
Om deze uitdaging aan te pakken, kunnen (ook wel metadatamanagementtools of datacatalogi genoemd) fungeren als veelzijdige zoekmachines voor deze schatkamers aan data binnen de organisatie. Metadata verwijst in essentie naar een set gegevens die de betreffende data beschrijven en is nuttig voor het indexeren van de grote variëteit aan beschikbare data.
Lyft heeft zijn eigen datadiscoverytool Amundsen open source gemaakt, om metadata-engines te bieden die organisaties helpen de data die ze voor hun analyses gebruiken te ontdekken, begrijpen, delen en vertrouwen. Deze capaciteit is cruciaal voor elke organisatie die haar datacompetenties wil opschalen.
Zoals eerder vermeld, is het creëren van vertrouwen in data essentieel om datademocratisering te stimuleren. Hier speelt datagovernance een grote rol. Met het almaar groeiende volume en de variëteit van data is centrale controle op de datakwaliteit, consistentie en relevantie cruciaal.
Diensten voor gecentraliseerde datagovernance van bedrijven als Collibra en Alation helpen organisaties de beschikbaarheid, consistentie en integriteit van hun data effectief te beheren. Hierdoor kunnen alle stakeholders werken vanuit één betrouwbare bron van waarheid.
Een volwassen wordende datainfrastructuur is slechts een van de datatrends die we voor 2021 en daarna voorzien. Meer weten? Download onze whitepaper Data Trends and Predictions 2021: The Year of Data Fluency of bekijk ons webinar.



 Adel Nehme · 15 min
De stand van data-gedreven digitale transformatie
Nu organisaties tijdens de COVID-19-pandemie versneld digitaliseren, is het belang van het benutten van data, machine learning en analytics groter dan ooit.
De McKinsey Global Survey 2020 over de stand van artificiële intelligentie meldde dat 50% van de bedrijven AI in minstens één bedrijfsfunctie heeft toegepast, en 22% van de organisaties schrijft minstens 5% van de winst vóór rente en belastingen toe aan AI-initiatieven.
Maar om de waarde van data en AI op schaal te ontsluiten, moeten organisaties hun data democratiseren en organisatiebrede datafluency realiseren. Een van de manieren om dit te doen, is door teams en vaardigheidsniveaus toegang te geven tot betrouwbare en bruikbare data, zodat iedereen datagedreven beslissingen kan nemen.
Datainfrastructuur als kern van datademocratisering
Voordat je datafluency bereikt, moet de basis op orde zijn. Dit begint met het begrijpen hoe data door een organisatie stromen en vervolgens toewerken naar een georganiseerde en uniforme datainfrastructuur.
In een webinar over datatrends en voorspellingen voor 2021 beschreef Ramnath Vaidyanathan, Vice President Product Research bij DataCamp, hoe data doorgaans door een organisatie stroomt. Deze stroom vereist data-engineeringtools om ruwe data op te nemen, te verwerken en te transformeren, ze op te slaan op een centrale locatie en inzichten te produceren in de vorm van dashboards en rapporten, machinelearning-outputs en meer.
Toegang tot data op schaal binnen de organisatie hangt sterk af van de aanwezigheid van een solide architectuur voor datainfrastructuur en het gebruik van de nieuwste tooling, die organisaties in staat stelt ruwe data om te zetten in toegankelijke en waardevolle inzichten.
De stand van tooling voor datainfrastructuur
Het belang van datainfrastructuur en tooling blijkt uit de snelle groei en evolutie van deze markt. Veel oplossingen zijn bedoeld om het werken met een specifiek onderdeel van de datainfrastructuur van een organisatie te stroomlijnen, wat heeft geleid tot een steeds gefragmenteerder landschap van tools dat lastig te navigeren kan zijn.
De volgende visual van Dataiku laat goed zien hoe de markt voor datainfrastructuur is opgedeeld in talloze fijnmazige categorieën, met binnen elk segment een groeiende lijst concurrerende oplossingen.
Bron: Dataiku
De toekomst van tooling voor datainfrastructuur
Laat vorig jaar probeerde Andreessen Horowitz meer duidelijkheid te scheppen in dit complexe landschap door een verenigd architectuurraamwerk te ontwikkelen. Met de groeiende noodzaak om met grote hoeveelheden data te werken en de overvloed aan beschikbare oplossingen biedt dit raamwerk een praktisch referentiepunt bij het moderniseren, in kaart brengen en bouwen van de datastack van een organisatie.
Bron: Andreessen Horowitz
Naarmate dit domein en deze trend zich ontwikkelen, zullen we consolidatie en standaardisatie van diverse tools in de datainfrastructuurstack zien. Dit, samen met cloudadoptie, datadiscoverytools en gecentraliseerde datagovernanceplatformen, stelt organisaties in staat schaalbare toegang tot data te bieden over teams en functies heen.
Wat levert een ideale toekomstige datainfrastructuur dan op? Volgens Maksim Pecherskiy, Data Engineer bij de Wereldbank en voormalig CDO van de stad San Diego, moeten data verzameld, vindbaar, betrouwbaar, begrepen, compliant en actiegericht zijn. Uiteindelijk is het doel data bruikbaar en betrouwbaar te maken, wat op zijn beurt organisatiebrede datafluency stimuleert.
Volwassen datainfrastructuur omvat cloudadoptie, datadiscoverytools en gecentraliseerde datagovernanceplatformen
Naarmate tooling rond datademocratisering in 2021 en daarna volwassener wordt, geldt dat ook voor de adoptie en groei van de volgende technologieën:
1. Cloudadoptie
Het gebruik van cloudtechnologieën wordt de norm, zeker na de versnelde data-gedreven digitale transformatie die we in 2020 hebben gezien.
Naast het verbeteren van dataopslag en -toegang bieden cloudoplossingen ook tal van gebruiksvriendelijke producten voor het verzamelen, inladen, transformeren, opslaan en creëren van inzichten uit data.
Er zijn talloze aanbieders van cloudplatforms, en een van de belangrijkste spelers is Amazon Web Services (AWS), dat meer dan 100 producten heeft waarmee ondernemingen hun data razendsnel, op schaal en tegen lage kosten optimaal kunnen benutten.
2. Datadiscoverytools
Het opschalen van datainfrastructuur wordt cruciaal naarmate datatabellen, rapporten en modellen worden toegevoegd aan het datalandschap van organisaties. Stakeholders moeten eenvoudig betrouwbare, begrepen, conforme en actiegerichte data en inzichten kunnen vinden om hun werk optimaal te doen.
Om deze uitdaging aan te pakken, kunnen (ook wel metadatamanagementtools of datacatalogi genoemd) fungeren als veelzijdige zoekmachines voor deze schatkamers aan data binnen de organisatie. Metadata verwijst in essentie naar een set gegevens die de betreffende data beschrijven en is nuttig voor het indexeren van de grote variëteit aan beschikbare data.
Lyft heeft zijn eigen datadiscoverytool Amundsen open source gemaakt, om metadata-engines te bieden die organisaties helpen de data die ze voor hun analyses gebruiken te ontdekken, begrijpen, delen en vertrouwen. Deze capaciteit is cruciaal voor elke organisatie die haar datacompetenties wil opschalen.
3. Gecentraliseerde datagovernanceplatformen
Zoals eerder vermeld, is het creëren van vertrouwen in data essentieel om datademocratisering te stimuleren. Hier speelt datagovernance een grote rol. Met het almaar groeiende volume en de variëteit van data is centrale controle op de datakwaliteit, consistentie en relevantie cruciaal.
Diensten voor gecentraliseerde datagovernance van bedrijven als Collibra en Alation helpen organisaties de beschikbaarheid, consistentie en integriteit van hun data effectief te beheren. Hierdoor kunnen alle stakeholders werken vanuit één betrouwbare bron van waarheid.
Een volwassen wordende datainfrastructuur is slechts een van de datatrends die we voor 2021 en daarna voorzien. Meer weten? Download onze whitepaper Data Trends and Predictions 2021: The Year of Data Fluency of bekijk ons webinar.