COVID-19 महामारी के बीच जब संगठन तेज़ी से डिजिटल परिवर्तन से गुजर रहे हैं, डेटा, मशीन लर्निंग और एनालिटिक्स का लाभ उठाने की आवश्यकता पहले से कहीं अधिक महत्वपूर्ण हो गई है।
कृत्रिम बुद्धिमत्ता की स्थिति पर 2020 के McKinsey Global Survey ने बताया कि 50% व्यवसायों ने कम से कम एक व्यावसायिक कार्य में कृत्रिम बुद्धिमत्ता को अपनाया है, और 22% संगठन अपने ब्याज और कर से पहले की कमाई का कम से कम 5% एआई पहलों को श्रेय देते हैं।
हालांकि, बड़े पैमाने पर डेटा और एआई का मूल्य खोलने के लिए, संगठनों को अपने डेटा का लोकतंत्रीकरण करना होगा और पूरे संगठन में डेटा प्रवाहिता सक्षम करनी होगी। ऐसा करने के तरीकों में से एक है टीमों और कौशल स्तरों में विश्वसनीय और क्रियाशील डेटा तक पहुंच देना ताकि हर कोई डेटा-सूचित व्यावसायिक निर्णय ले सके।
डेटा लोकतंत्रीकरण के केंद्र में डेटा इन्फ्रास्ट्रक्चर
डेटा प्रवाहिता हासिल करने से पहले, संगठनों को अपनी नींव मजबूत करनी होती है। यह समझने से शुरू होता है कि डेटा संगठन के भीतर कैसे प्रवाहित होता है और फिर एक सुव्यवस्थित एवं एकीकृत डेटा इन्फ्रास्ट्रक्चर का निर्माण करना।
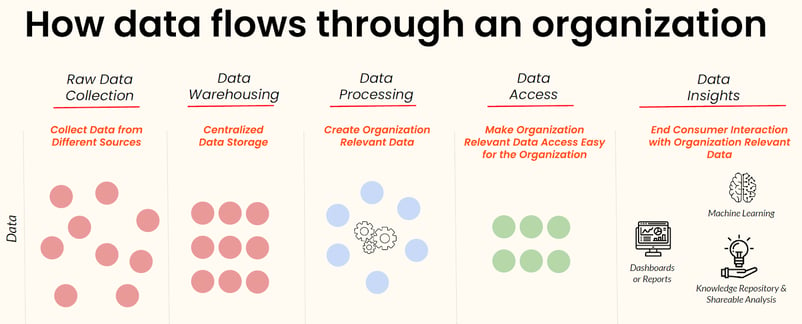
2021 के डेटा रुझानों और भविष्यवाणियों पर एक वेबिनार में, DataCamp के प्रोडक्ट रिसर्च के वाइस प्रेसिडेंट रमणाथ वैद्यनाथन ने बताया कि डेटा आमतौर पर किसी संगठन के भीतर कैसे प्रवाहित होता है। इस प्रवाह के लिए डेटा इंजीनियरिंग टूल्स की आवश्यकता होती है जो कच्चे डेटा को लें, उन्हें इनजेस्ट और ट्रांसफॉर्म करें, किसी केंद्रीकृत स्थान पर संग्रहित करें, और डैशबोर्ड व रिपोर्ट, मशीन लर्निंग आउटपुट्स आदि के रूप में डेटा इनसाइट्स उत्पन्न करें।
संगठन के भीतर डेटा तक पहुंच का स्केल बढ़ाना, एक ठोस डेटा इन्फ्रास्ट्रक्चर आर्किटेक्चर की मौजूदगी और नवीनतम डेटा इन्फ्रास्ट्रक्चर टूलिंग के उपयोग पर काफी हद तक निर्भर करता है, जो संगठनों को कच्चे डेटा को सुलभ और मूल्यवान डेटा इनसाइट्स में बदलने में सक्षम बनाता है।
डेटा इन्फ्रास्ट्रक्चर और टूलिंग का महत्व, डेटा इन्फ्रास्ट्रक्चर बाजार की तीव्र वृद्धि और विकास से स्पष्ट होता है। कई समाधान किसी संगठन के डेटा इन्फ्रास्ट्रक्चर के किसी विशेष घटक के साथ काम को सुव्यवस्थित करने के लिए बने हैं, जिसके परिणामस्वरूप टूलिंग का एक तेजी से खंडित परिदृश्य उभरा है, जिसे नेविगेट करना चुनौतीपूर्ण हो सकता है।
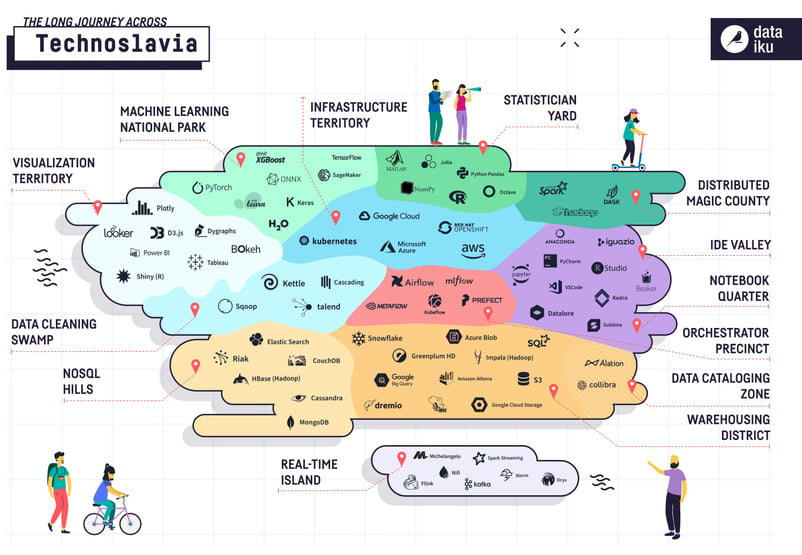
Dataiku द्वारा बनाया गया निम्नलिखित दृश्य यह उपयुक्त रूप से दर्शाता है कि डेटा इन्फ्रास्ट्रक्चर बाजार को कैसे अनेक सूक्ष्म श्रेणियों में विभाजित किया गया है, और प्रत्येक खंड में प्रतिस्पर्धी समाधानों की सूची कैसे लगातार बढ़ रही है।
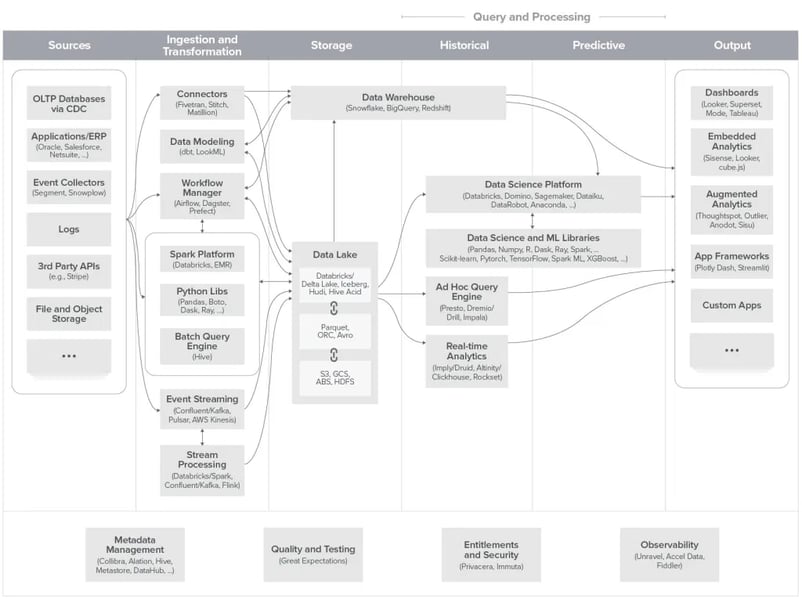
पिछले वर्ष के अंत में, Andreessen Horowitz ने इस उलझे हुए डेटा इन्फ्रास्ट्रक्चर परिदृश्य में कुछ स्पष्टता लाने के लिए एक एकीकृत आर्किटेक्चर फ्रेमवर्क विकसित किया। बड़े पैमाने के डेटा के साथ काम करने की बढ़ती आवश्यकता और उपलब्ध समाधानों की भरमार के बीच, यह फ्रेमवर्क किसी संगठन के डेटा स्टैक का आधुनिकीकरण, मानचित्रण और निर्माण करते समय एक व्यावहारिक संदर्भ प्रदान करता है।
जैसे-जैसे यह क्षेत्र और प्रवृत्ति विकसित होगी, हम डेटा इन्फ्रास्ट्रक्चर स्टैक के विभिन्न टूल्स के एकीकरण और मानकीकरण को देखेंगे। इसके साथ-साथ क्लाउड अपनाने, डेटा डिस्कवरी टूल्स और केंद्रीकृत डेटा गवर्नेंस प्लेटफ़ॉर्म्स संगठनों को टीमों और कार्यों में डेटा तक स्केलेबल पहुंच प्रदान करने में सक्षम बनाएंगे।
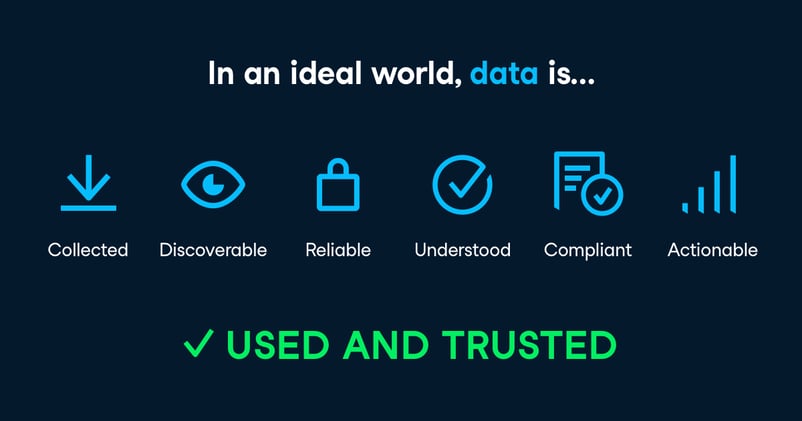
तो एक आदर्श भविष्य का डेटा इन्फ्रास्ट्रक्चर क्या प्रदान करता है? मक्सिम पेचर्स्की, वर्ल्ड बैंक में डेटा इंजीनियर और सैन डिएगो शहर के पूर्व CDO, के अनुसार, डेटा संग्रहित, खोजयोग्य, विश्वसनीय, समझा हुआ, अनुपालनयुक्त और क्रियाशील होना चाहिए। अंततः लक्ष्य है डेटा को उपयोगी और भरोसेमंद बनाना, जो बदले में पूरे संगठन में डेटा प्रवाहिता को आगे बढ़ाता है।
जैसे-जैसे 2021 और उसके बाद डेटा लोकतंत्रीकरण के इर्द-गिर्द डेटा इन्फ्रास्ट्रक्चर टूलिंग परिपक्व होगी, निम्नलिखित तकनीकों को अपनाना और उनका विकास भी बढ़ेगा:
1. क्लाउड अपनाना
क्लाउड तकनीकों का उपयोग सामान्य होता जा रहा है, खासकर 2020 में देखे गए तेज़ डेटा-चालित डिजिटल परिवर्तन के बाद।
डेटा स्टोरेज और एक्सेस में सुधार के अलावा, क्लाउड समाधान डेटा को इकट्ठा करने, इनजेस्ट करने, ट्रांसफॉर्म करने, संग्रहित करने और उनसे इनसाइट्स बनाने के लिए अनेक उपयोगकर्ता-अनुकूल उत्पाद भी पेश करते हैं।
क्लाउड प्लेटफ़ॉर्म क्षेत्र में कई प्रदाता हैं, और प्रमुख खिलाड़ियों में से एक है Amazon Web Services (AWS), जिसके पास 100 से अधिक उत्पाद हैं जो उद्यमों को उच्च गति, बड़े पैमाने और कम लागत पर अपने डेटा से अधिकतम लाभ लेने में सक्षम बनाते हैं।
जैसे-जैसे संगठनों के डेटा परिदृश्य में डेटा टेबल्स, रिपोर्ट्स और मॉडल जोड़े जाते हैं, डेटा इन्फ्रास्ट्रक्चर का स्केल बढ़ाना अहम होगा। हितधारकों को विश्वसनीय, समझे हुए, अनुपालनयुक्त और क्रियाशील डेटा व इनसाइट्स तुरंत खोज पाने में सक्षम होना चाहिए ताकि वे अपना सर्वश्रेष्ठ काम कर सकें।
इस चुनौती से निपटने के लिए, (जिन्हें मेटाडेटा मैनेजमेंट टूल्स या डेटा कैटलॉग भी कहा जाता है) संगठन के भीतर इन विशाल डेटा भंडारों के लिए बहुमुखी सर्च इंजन के रूप में काम कर सकते हैं। मेटाडेटा मूल रूप से उस विशेष डेटा का वर्णन करने वाले डेटा के सेट को संदर्भित करता है, और उपलब्ध विविध प्रकार के डेटा को इंडेक्स करने में उपयोगी होता है।
Lyft ने अपना डेटा डिस्कवरी टूल Amundsen ओपन-सोर्स किया, ताकि ऐसे मेटाडेटा इंजन समाधान पेश किए जा सकें जिनका उद्देश्य संगठनों को उस डेटा की खोज, समझ, साझा करने और उस पर भरोसा करने में मदद करना है जिसका वे अपने विश्लेषण के लिए उपयोग करते हैं। यह क्षमता किसी भी संगठन के लिए अत्यंत महत्वपूर्ण है जो अपनी डेटा क्षमताओं को स्केल करना चाहता है।
जैसा कि पहले उल्लेख किया गया, डेटा में विश्वास बनाना डेटा लोकतंत्रीकरण को आगे बढ़ाने के लिए आवश्यक है। यहीं डेटा गवर्नेंस बड़ी भूमिका निभाता है। डेटा की लगातार बढ़ती मात्रा और विविधता के साथ, डेटा की गुणवत्ता, स्थिरता और प्रासंगिकता की केंद्रीकृत निगरानी अत्यंत महत्वपूर्ण है।
Collibra और Alation जैसी कंपनियों द्वारा पेश किए गए केंद्रीकृत डेटा गवर्नेंस प्लेटफ़ॉर्म सेवाएं, संगठनों को अपने डेटा की उपलब्धता, स्थिरता और अखंडता का प्रभावी प्रबंधन करने में मदद करती हैं। इससे सभी हितधारक एक विश्वसनीय सिंगल सोर्स ऑफ ट्रुथ के आधार पर काम कर पाते हैं।
परिपक्व होता डेटा इन्फ्रास्ट्रक्चर 2021 और उसके बाद के लिए हमारी अपेक्षित डेटा प्रवृत्तियों में से केवल एक है। अधिक जानने के लिए हमारा श्वेतपत्र Data Trends and Predictions 2021: The Year of Data Fluency डाउनलोड करें या हमारा वेबिनार देखें।


डेटा-चालित डिजिटल परिवर्तन की स्थिति
COVID-19 महामारी के बीच जब संगठन तेज़ी से डिजिटल परिवर्तन से गुजर रहे हैं, डेटा, मशीन लर्निंग और एनालिटिक्स का लाभ उठाने की आवश्यकता पहले से कहीं अधिक महत्वपूर्ण हो गई है।
कृत्रिम बुद्धिमत्ता की स्थिति पर 2020 के McKinsey Global Survey ने बताया कि 50% व्यवसायों ने कम से कम एक व्यावसायिक कार्य में कृत्रिम बुद्धिमत्ता को अपनाया है, और 22% संगठन अपने ब्याज और कर से पहले की कमाई का कम से कम 5% एआई पहलों को श्रेय देते हैं।
हालांकि, बड़े पैमाने पर डेटा और एआई का मूल्य खोलने के लिए, संगठनों को अपने डेटा का लोकतंत्रीकरण करना होगा और पूरे संगठन में डेटा प्रवाहिता सक्षम करनी होगी। ऐसा करने के तरीकों में से एक है टीमों और कौशल स्तरों में विश्वसनीय और क्रियाशील डेटा तक पहुंच देना ताकि हर कोई डेटा-सूचित व्यावसायिक निर्णय ले सके।
डेटा लोकतंत्रीकरण के केंद्र में डेटा इन्फ्रास्ट्रक्चर
डेटा प्रवाहिता हासिल करने से पहले, संगठनों को अपनी नींव मजबूत करनी होती है। यह समझने से शुरू होता है कि डेटा संगठन के भीतर कैसे प्रवाहित होता है और फिर एक सुव्यवस्थित एवं एकीकृत डेटा इन्फ्रास्ट्रक्चर का निर्माण करना।
2021 के डेटा रुझानों और भविष्यवाणियों पर एक वेबिनार में, DataCamp के प्रोडक्ट रिसर्च के वाइस प्रेसिडेंट रमणाथ वैद्यनाथन ने बताया कि डेटा आमतौर पर किसी संगठन के भीतर कैसे प्रवाहित होता है। इस प्रवाह के लिए डेटा इंजीनियरिंग टूल्स की आवश्यकता होती है जो कच्चे डेटा को लें, उन्हें इनजेस्ट और ट्रांसफॉर्म करें, किसी केंद्रीकृत स्थान पर संग्रहित करें, और डैशबोर्ड व रिपोर्ट, मशीन लर्निंग आउटपुट्स आदि के रूप में डेटा इनसाइट्स उत्पन्न करें।
संगठन के भीतर डेटा तक पहुंच का स्केल बढ़ाना, एक ठोस डेटा इन्फ्रास्ट्रक्चर आर्किटेक्चर की मौजूदगी और नवीनतम डेटा इन्फ्रास्ट्रक्चर टूलिंग के उपयोग पर काफी हद तक निर्भर करता है, जो संगठनों को कच्चे डेटा को सुलभ और मूल्यवान डेटा इनसाइट्स में बदलने में सक्षम बनाता है।
डेटा इन्फ्रास्ट्रक्चर टूलिंग की स्थिति
डेटा इन्फ्रास्ट्रक्चर और टूलिंग का महत्व, डेटा इन्फ्रास्ट्रक्चर बाजार की तीव्र वृद्धि और विकास से स्पष्ट होता है। कई समाधान किसी संगठन के डेटा इन्फ्रास्ट्रक्चर के किसी विशेष घटक के साथ काम को सुव्यवस्थित करने के लिए बने हैं, जिसके परिणामस्वरूप टूलिंग का एक तेजी से खंडित परिदृश्य उभरा है, जिसे नेविगेट करना चुनौतीपूर्ण हो सकता है।
Dataiku द्वारा बनाया गया निम्नलिखित दृश्य यह उपयुक्त रूप से दर्शाता है कि डेटा इन्फ्रास्ट्रक्चर बाजार को कैसे अनेक सूक्ष्म श्रेणियों में विभाजित किया गया है, और प्रत्येक खंड में प्रतिस्पर्धी समाधानों की सूची कैसे लगातार बढ़ रही है।
स्रोत: Dataiku
डेटा इन्फ्रास्ट्रक्चर टूलिंग का भविष्य
पिछले वर्ष के अंत में, Andreessen Horowitz ने इस उलझे हुए डेटा इन्फ्रास्ट्रक्चर परिदृश्य में कुछ स्पष्टता लाने के लिए एक एकीकृत आर्किटेक्चर फ्रेमवर्क विकसित किया। बड़े पैमाने के डेटा के साथ काम करने की बढ़ती आवश्यकता और उपलब्ध समाधानों की भरमार के बीच, यह फ्रेमवर्क किसी संगठन के डेटा स्टैक का आधुनिकीकरण, मानचित्रण और निर्माण करते समय एक व्यावहारिक संदर्भ प्रदान करता है।
स्रोत: Andreessen Horowitz
जैसे-जैसे यह क्षेत्र और प्रवृत्ति विकसित होगी, हम डेटा इन्फ्रास्ट्रक्चर स्टैक के विभिन्न टूल्स के एकीकरण और मानकीकरण को देखेंगे। इसके साथ-साथ क्लाउड अपनाने, डेटा डिस्कवरी टूल्स और केंद्रीकृत डेटा गवर्नेंस प्लेटफ़ॉर्म्स संगठनों को टीमों और कार्यों में डेटा तक स्केलेबल पहुंच प्रदान करने में सक्षम बनाएंगे।
तो एक आदर्श भविष्य का डेटा इन्फ्रास्ट्रक्चर क्या प्रदान करता है? मक्सिम पेचर्स्की, वर्ल्ड बैंक में डेटा इंजीनियर और सैन डिएगो शहर के पूर्व CDO, के अनुसार, डेटा संग्रहित, खोजयोग्य, विश्वसनीय, समझा हुआ, अनुपालनयुक्त और क्रियाशील होना चाहिए। अंततः लक्ष्य है डेटा को उपयोगी और भरोसेमंद बनाना, जो बदले में पूरे संगठन में डेटा प्रवाहिता को आगे बढ़ाता है।
परिपक्व डेटा इन्फ्रास्ट्रक्चर में क्लाउड अपनाना, डेटा डिस्कवरी टूल्स और केंद्रीकृत डेटा गवर्नेंस प्लेटफ़ॉर्म्स शामिल होते हैं
जैसे-जैसे 2021 और उसके बाद डेटा लोकतंत्रीकरण के इर्द-गिर्द डेटा इन्फ्रास्ट्रक्चर टूलिंग परिपक्व होगी, निम्नलिखित तकनीकों को अपनाना और उनका विकास भी बढ़ेगा:
1. क्लाउड अपनाना
क्लाउड तकनीकों का उपयोग सामान्य होता जा रहा है, खासकर 2020 में देखे गए तेज़ डेटा-चालित डिजिटल परिवर्तन के बाद।
डेटा स्टोरेज और एक्सेस में सुधार के अलावा, क्लाउड समाधान डेटा को इकट्ठा करने, इनजेस्ट करने, ट्रांसफॉर्म करने, संग्रहित करने और उनसे इनसाइट्स बनाने के लिए अनेक उपयोगकर्ता-अनुकूल उत्पाद भी पेश करते हैं।
क्लाउड प्लेटफ़ॉर्म क्षेत्र में कई प्रदाता हैं, और प्रमुख खिलाड़ियों में से एक है Amazon Web Services (AWS), जिसके पास 100 से अधिक उत्पाद हैं जो उद्यमों को उच्च गति, बड़े पैमाने और कम लागत पर अपने डेटा से अधिकतम लाभ लेने में सक्षम बनाते हैं।
2. डेटा डिस्कवरी टूल्स
जैसे-जैसे संगठनों के डेटा परिदृश्य में डेटा टेबल्स, रिपोर्ट्स और मॉडल जोड़े जाते हैं, डेटा इन्फ्रास्ट्रक्चर का स्केल बढ़ाना अहम होगा। हितधारकों को विश्वसनीय, समझे हुए, अनुपालनयुक्त और क्रियाशील डेटा व इनसाइट्स तुरंत खोज पाने में सक्षम होना चाहिए ताकि वे अपना सर्वश्रेष्ठ काम कर सकें।
इस चुनौती से निपटने के लिए, (जिन्हें मेटाडेटा मैनेजमेंट टूल्स या डेटा कैटलॉग भी कहा जाता है) संगठन के भीतर इन विशाल डेटा भंडारों के लिए बहुमुखी सर्च इंजन के रूप में काम कर सकते हैं। मेटाडेटा मूल रूप से उस विशेष डेटा का वर्णन करने वाले डेटा के सेट को संदर्भित करता है, और उपलब्ध विविध प्रकार के डेटा को इंडेक्स करने में उपयोगी होता है।
Lyft ने अपना डेटा डिस्कवरी टूल Amundsen ओपन-सोर्स किया, ताकि ऐसे मेटाडेटा इंजन समाधान पेश किए जा सकें जिनका उद्देश्य संगठनों को उस डेटा की खोज, समझ, साझा करने और उस पर भरोसा करने में मदद करना है जिसका वे अपने विश्लेषण के लिए उपयोग करते हैं। यह क्षमता किसी भी संगठन के लिए अत्यंत महत्वपूर्ण है जो अपनी डेटा क्षमताओं को स्केल करना चाहता है।
3. केंद्रीकृत डेटा गवर्नेंस प्लेटफ़ॉर्म्स
जैसा कि पहले उल्लेख किया गया, डेटा में विश्वास बनाना डेटा लोकतंत्रीकरण को आगे बढ़ाने के लिए आवश्यक है। यहीं डेटा गवर्नेंस बड़ी भूमिका निभाता है। डेटा की लगातार बढ़ती मात्रा और विविधता के साथ, डेटा की गुणवत्ता, स्थिरता और प्रासंगिकता की केंद्रीकृत निगरानी अत्यंत महत्वपूर्ण है।
Collibra और Alation जैसी कंपनियों द्वारा पेश किए गए केंद्रीकृत डेटा गवर्नेंस प्लेटफ़ॉर्म सेवाएं, संगठनों को अपने डेटा की उपलब्धता, स्थिरता और अखंडता का प्रभावी प्रबंधन करने में मदद करती हैं। इससे सभी हितधारक एक विश्वसनीय सिंगल सोर्स ऑफ ट्रुथ के आधार पर काम कर पाते हैं।
परिपक्व होता डेटा इन्फ्रास्ट्रक्चर 2021 और उसके बाद के लिए हमारी अपेक्षित डेटा प्रवृत्तियों में से केवल एक है। अधिक जानने के लिए हमारा श्वेतपत्र Data Trends and Predictions 2021: The Year of Data Fluency डाउनलोड करें या हमारा वेबिनार देखें।