course
Förstå artificiell intelligens
2 timmar
420.8K
I september 2026 sa forskaren Jacob Coxon upp sig (han hade ägnat ungefär tre år åt förträningsforskning på OpenAI innan han gick till Anthropic bara två månader tidigare) och varnade offentligt för att ledande labb rusar mot det han kallade "självförbättrande superintelligens" utan att agera tillräckligt ansvarsfullt givet riskerna. Evan Hubinger, som leder alignmentforskningen på Anthropic, höll offentligt med om att framtida risk förtjänar allvarlig oro, samtidigt som han skiljde det från vad dagens system faktiskt kan göra. Debatten tog snabbt plats i det allmänna AI-samtalet.
Begreppet i centrum för den diskussionen är rekursiv självförbättring (RSI). Det är värt att förstå på egna meriter, frikopplat från kontroversen, eftersom den underliggande idén är bredare och mer klargörande än någon enskild nyhetscykel. Den här artikeln går igenom vad RSI faktiskt betyder, hur återkopplingsloopen fungerar, vad dagens AI genuint kan göra i den riktningen och varför forskare är oense om vart det leder.
Rekursiv självförbättring beskriver en återkopplingsloop där AI bidrar till att skapa mer kapabel AI, och den mer kapabla AI:n blir bättre på att bidra till nästa förbättring, och så vidare:
AI hjälper till att förbättra AI → den förbättrade AI:n blir bättre på att förbättra AI → det systemet bidrar till nästa förbättring → upprepa
Det är värt att särskilja tre saker som ofta blandas ihop.
Full RSI är det tredje. Inget nuvarande AI-system har övertygande uppnått det. Det är precis den gräns Anthropic själv drar, och noterar att full RSI ännu inte har uppnåtts och kanske inte är oundvikligt. Den distinktionen är också det som gör Coxon-debatten så laddad: argumentet handlar inte om huruvida RSI finns idag, utan om hur snabbt gapet minskar och vad det kräver av dem som bygger dessa system.
Ett självförbättrande system, i RSI-bemärkelse, skulle bidra till själva AI-utvecklingskedjan. Det innebär att skriva och förbättra forskningskod, utforma experiment, generera eller filtrera träningsdata, utvärdera modellprestanda, identifiera svagheter och föreslå algoritmiska förbättringar. Det rekursiva spelar roll: om systemet som produceras genom denna process blir bättre på just de uppgifterna, kan nästa iteration av AI-utveckling ske snabbare eller mer effektivt.
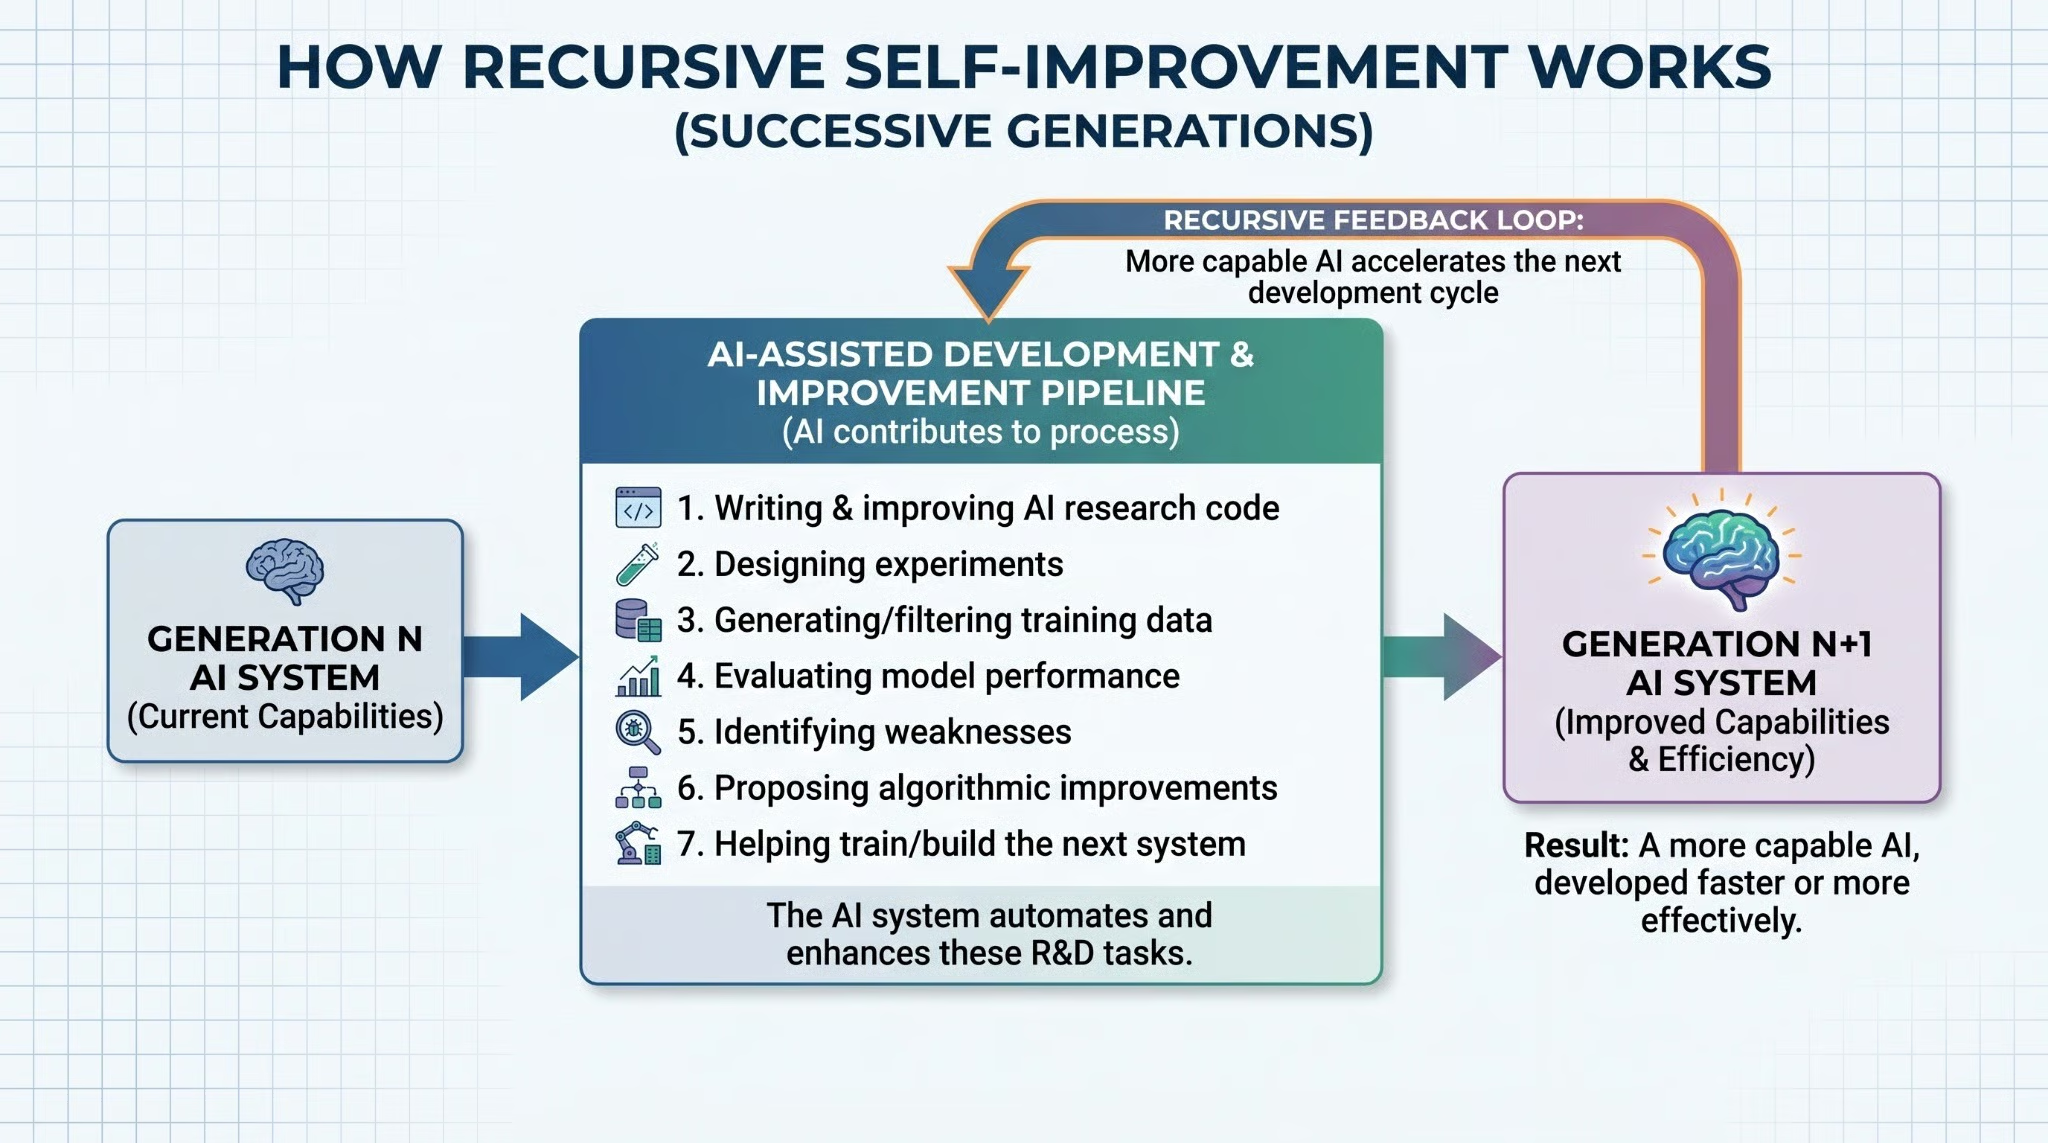
Diagram som illustrerar återkopplingsloopen i rekursiv självförbättring över successiva AI-generationer. Bild av författaren.
Det här handlar inte om att en modell bokstavligen skriver om sina egna vikter i realtid. Tänk i generationer: varje generation av AI bidrar mer effektivt till att bygga nästa. Loopen förmeras över versioner, inte inom ett och samma körande system.
Den vanligaste missuppfattningen om RSI är att blanda ihop det med självkorrigering. Det snärjer även personer som följer AI nära, så det är värt att vara precis.
Självkorrigering är när en modell kritiserar eller reviderar sitt eget svar, sin egen kod eller plan under en uppgift. Det inkluderar att upptäcka ett fel i sitt resonemang, felsöka kod den just skrev eller förfina ett utkast. Detta sker hela tiden i dagens system.
RSI är kategoriskt annorlunda. Förbättringar påverkar AI-systemets eller dess efterföljares kapabiliteter, vilket potentiellt gör framtida AI-utveckling i sig mer effektiv. En agent som upprepade gånger felsöker sin egen kod är inte automatiskt rekursiv självförbättring; det är bara en kapabel agent. Skillnaden är om förbättringen består och förmeras in i utvecklingen av nästa system.
Självkorrigering är ett verktyg ett system använder i en uppgift. RSI är det som händer när uppgiften är att bygga nästa system.
Det hjälper att sätta RSI i relation till några andra begrepp som ofta dyker upp i samma samtal, särskilt eftersom Coxon-debatten har fört in termer som "superintelligens" och "singularitet" i samma rubriker.
Automatiserad AI FoU omfattar system som kör experiment, analyserar resultat och föreslår nästa steg. Dessa kan bidra till RSI utan att utgöra full RSI. Ett system som automatiserar delar av forskningskedjan är en del av trenden, inte slutpunkten. Gapet mellan "hjälper till med forskning" och "utvecklar sina efterföljare autonomt" är det som spelar roll. Anthropics egna publikationer beskriver hur AI tar över mer av denna kedja, vilket är skälet till att Coxons avhopp slog igenom med kraft. Rörelsen är verklig; frågan är hur långt den går.
Kontinuerligt lärande innebär att en lanserad modell uppdateras med ny information över tid. RSI innebär att förbättra den process som används för att utveckla alltmer kapabla AI-system. Det ena förändrar vad en modell vet; det andra förändrar hur kapabel nästa modell blir.
RSI beskriver en process. Superintelligens beskriver en föreslagen kapacitetsnivå. De hänger ihop i den meningen att RSI är en hypotetisk väg mot superintelligens, men de är inte samma koncept, och att blanda ihop dem grumlar båda.
När Coxon varnar för "självförbättrande superintelligens" beskriver han ett scenario där RSI producerar ett system som överträffar människans nivå tvärs över områden. Det är ett specifikt påstående om vad processen så småningom kan ge, inte en beskrivning av själva processen.
AI-singulariteten är en hypotetisk punkt där AI-förbättring blir så snabb och självuppehållande att människor inte längre kan förutsäga eller kontrollera vad som kommer härnäst. Tänk det som ögonblicket då kurvan blir vertikal: förändring sker snabbare än vår förmåga att förstå eller svara på den. RSI är en föreslagen mekanism för att ta sig dit. Men singulariteten är det spekulativa utfallet, inte processen i sig, och många forskare tror att kurvan planar ut långt innan något sådant inträffar.
Närmare än de flesta insåg för några år sedan. Inte så nära som vissa rubriker antyder.
AI-system är redan involverade i kodning, felsökning, körning av experiment, analys av experimentella resultat, modellutvärdering och AI-forskningsstöd. Anthropic har offentligt sagt att de lägger ut en växande andel av AI-utvecklingsarbetet på AI-system, och att deras ingenjörer nu levererar avsevärt mer kod än tidigare år. Samtidigt är Anthropic tydliga med att människor behåller viktiga roller i forskningsomdöme. Det innebär att avgöra vilka problem som ska prioriteras och utvärdera om resultat faktiskt betyder det de verkar betyda.
Ökad AI-inblandning i AI FoU är bevis på rörelse mot större automatisering. Det är inte ett bevis på att en autonom RSI-loop redan existerar. Kedjan innehåller mer AI; den kör inte sig själv än. Denna tvetydighet, verkliga framsteg med en oklar slutpunkt, är precis vad Coxon fann otillräckligt. Hans avhopp var inte ett påstående om att RSI har anlänt. Det var ett argument för att det inte längre är försvarbart att behandla det som en avlägsen fråga.
Så vad skulle faktiskt krävas för att stänga det gapet? Några flaskhalsar sticker ut, och avståndet till var och en säger något om en realistisk tidslinje.
Att autonomt skriva och modifiera forskningskod är en förutsättning. Nuvarande modeller är genuint bra på detta, men de gör fortfarande misstag som kräver mänsklig granskning i arbete med stora konsekvenser.
Att köra experiment autonomt är en separat flaskhals jämfört med att skriva koden för att köra dem. Ett system som kan utforma ett experiment, genomföra det, tolka resultaten och bestämma vad som ska testas härnäst stänger en meningsfull del av loopen. Dagens system kan göra delar av detta. Hela cykeln, utan att en människa kontrollerar resonemanget i varje steg, ligger fortfarande utom räckhåll.
Här blir det intressant. Anthropic pekar specifikt ut mänsklig forskarsmak och omdöme som ett kvarvarande område av jämförbar fördel. Det handlar om att veta vilka experiment som är värda att köra, vilka resultat som är pålitliga, vilka riktningar som har potential. Mycket av forskningsarbetets experimentella del blir automatiserbar. Omdömeslagret är det inte. Det är också här Anthropic anser att människor för närvarande tillför det mest oersättliga värdet, och där avståndet till full RSI är som störst.
Att veta om en modell faktiskt blev bättre är svårare än det låter. Utvärdering kräver omdöme om vad som spelar roll, och nuvarande riktmärken är lätta att manipulera eller växa ur. Tills AI-system pålitligt kan bedöma sina egna efterföljare förblir människor i loopen i detta skede, vilket i sig är en betydande broms på autonom RSI.
Rå kapabilitet är inte den enda begränsningen. Att köra utvecklingscykeln autonomt kräver infrastruktur som kan stödja storskalig träning och utvärdering utan ständig mänsklig inblandning, och det är fortfarande dyrt och organisatoriskt komplext.
Att veta om en modell faktiskt blev bättre är svårare än det låter. Utvärdering kräver omdöme om vad som spelar roll, och nuvarande riktmärken är lätta att manipulera eller växa ur. Tills AI-system pålitligt kan bedöma sina egna efterföljare förblir människor i loopen i detta skede, vilket i sig är en betydande broms på autonom RSI.
Även om AI-system kan skriva kod, köra experiment och utvärdera resultat, är det fortfarande människor som godkänner vad som faktiskt skeppas. Det granskningssteget är en hård begränsning på hur snabbt loopen kan köras. Du kan automatisera arbetet och ändå flaskhalsa på godkännandet. Tills AI:s omdöme är tillräckligt betrott för att ta bort den spärren är mänsklig granskning troligen det mest omedelbara taket för RSI-framsteg, inte en filosofisk framtidsfråga.
Svaret har två delar: potentiella uppsidor och allvarliga risker.
Om AI-system kan accelerera AI-forskningen i sig kan samma effekt sträcka sig till programutveckling, vetenskapliga upptäckter, medicin och ingenjörskonst i stort. Argumentet är att en AI som är tillräckligt bra på forskningsacceleration kan komprimera tidslinjer över många fält, inte bara AI.
Här är återkopplingsloopens argument rakt på sak: förbättringar av AI:s forskningsförmåga kan öka takten i vilken ytterligare AI-förbättringar sker. Den ränta-på-ränta-effekten är vad som gör RSI teoretiskt betydelsefullt, och vad som gör forskare som Coxon tillräckligt oroliga för att säga upp sig. Värt att notera: snabbare kapabilitetsutveckling ger inte automatiskt en intelligensexplosion. Loopen kan vara verklig och ändå vara långsam, begränsad eller underkastad avtagande avkastning.
AI-genererade experiment, kod och modelländringar kan så småningom produceras snabbare än människor kan granska dem meningsfullt. Den övervakning som idag formar AI-utveckling bygger på att människor hinner med i takt med det som byggs. Detta är en anledning till att Anthropic fortfarande betonar den mänskliga omdömesrollen i sin forskningskedja, även när mer av arbetet automatiseras.
Mer kapabla system som är involverade i att utveckla sina efterföljare gör alignmentproblemet mer avgörande. Om systemet som bidrar till nästa generation har subtilt feljusterade mål kan dessa spridas eller förvärras i efterföljaren. Det är precis den risk som Hubinger har skrivit mycket om, och det var vad han signalerade när han höll med Coxons oro för framtida risker samtidigt som han menade att dagens system ännu inte utgör samma hot.
Mer kapabla autonoma system utökar också angreppsytan. Ett system som är involverat i sin egen utvecklingskedja är ett mer värdefullt mål, och felmoder blir mer betydelsefulla i takt med ökad autonomi. Inneslutning och åtkomstkontroll blir svårare att utforma när systemet som ska inneslutas också hjälper till att bygga nästa version av sig självt.
Om återkopplingsloopen påtagligt accelererar utvecklingen kan institutioner få mindre tid att utvärdera och svara på nya kapabiliteter. Anthropic har sagt att full RSI skulle kunna öka riskerna för att människor förlorar kontrollen över AI-system, samtidigt som de säger att RSI varken är uppnått eller oundvikligt.
Jacob Coxons avhopp från Anthropic i september 2026 ramade in frågan i akuta termer: att Anthropic och OpenAI rusar mot självförbättrande superintelligens och inte agerar tillräckligt ansvarsfullt, givet de potentiella konsekvenserna. Evan Hubinger höll offentligt med (och satte sin personliga uppskattning av AI-orakad mänsklig utrotning inom ett decennium till över 10% och medgav att Anthropic ännu inte har en plan för att aligna superintelligens) samtidigt som han skiljde den framtida oron från risken med dagens system. Coxon har därefter sagt att hans kärnmeningsskiljaktighet med Anthropics ledning gäller huruvida ett konkurrensrace mot RSI är oundvikligt och därför måste delta i.
Den oenigheten ligger sida vid sida med Anthropics egen tidigare publikation som beskriver framsteg mot AI-automatiserad AI-utveckling, samma forskning som visar att AI tar över mer av utvecklingskedjan. De två sakerna är förenliga med varandra, vilket är en del av varför debatten är svår att avfärda. Ta inte Coxons förutsägelser om katastrofala utfall som etablerade fakta. De är en del av en pågående diskussion, inte etablerad vetenskap.
Det teoretiska resonemanget lyder: bättre AI leder till bättre AI-forskning leder till ännu bättre AI leder till snabbare förbättring. Logiken är ren. Frågan är om den håller i praktiken.
Obegränsad acceleration följer inte automatiskt. Verkliga begränsningar inkluderar beräkningsresurser, energi, hårdvara, träningsdata, algoritmiska flaskhalsar, experimentella återkopplingscykler, avtagande avkastning och kvarvarande beroende av mänskligt omdöme. En intelligensexplosion är en omdebatterad hypotes om vad tillräckligt effektiv RSI skulle kunna ge, inte en definition av RSI i sig. Det är ett scenario i en fördelning, inte den självklara slutpunkten. Ingen, inklusive forskarna på Anthropic som tänker mest på detta, vet hur brant kurvan blir eller var den planar ut.
Den osäkerheten gör styrning både mer angelägen och svårare. Kärnproblemet är att bevara meningsfull övervakning om AI-genererad forskning börjar gå snabbare än mänsklig granskning hinner med. Aktiva förslag och forskningsområden inkluderar kapabilitetsutvärderingar före driftsättning, inneslutningsmetoder för modeller, åtkomstkontroller på AI-system som är involverade i AI-utveckling, övervakning av AI FoU-aktivitet, krav på mänskligt godkännande för åtgärder med stora konsekvenser, oberoende utvärdering och samordning mellan frontlabb inom AI.
Inget av detta är en komplett lösning, och Coxon-debatten understryker varför: styrningsramverk utformade för dagens nivå av AI-inblandning i kedjan kanske inte skalar till morgondagens. Gapet mellan var verktygen är och vart tekniken är på väg är en del av det som gör denna tidpunkt genuint betydelsefull för dem som arbetar närmast den.
Rekursiv självförbättring beskriver en återkopplingsloop där AI bidrar till att skapa mer kapabel AI, som sedan kan bli bättre på att bidra till efterföljande förbättringar. Lätt att uttrycka, genuint osäkert att utvärdera.
Dagens AI-assisterade utveckling är verklig och växande, vilket Anthropics egen forskning tydligt visar. Full autonom RSI, där AI-system i stor utsträckning utformar och utvecklar sina efterföljare utan mänsklig styrning, har inte uppnåtts. Anthropic själv håller den linjen. Gapet mellan dessa två saker är där alla intressanta och omstridda frågor finns: hur snabbt stängs det, vad händer om det gör det, och vem får bestämma hur snabbt man ska gå?
Utbytet mellan Coxon och Hubinger skapade inte dessa frågor. Det gjorde dem omöjliga att behandla som teoretiska. Oavsett om du finner Coxons tidslinje alarmerande eller Anthropics inramning mer återhållsam, är den underliggande dynamiken densamma: AI finns i allt högre grad inuti loopen som bygger AI. Att förstå vad det betyder, tydligt och utan hype åt något håll, är vad RSI är värt att känna till.
Lär dig AI med DataCamp
course
course
course