Cursus
Artificial Intelligence begrijpen
2 Hr
420.8K
In september 2026 nam onderzoeker Jacob Coxon (die ongeveer drie jaar aan pretrainingonderzoek bij OpenAI had gewerkt voordat hij twee maanden eerder bij Anthropic in dienst trad) ontslag. Hij waarschuwde publiekelijk dat toonaangevende labs op volle snelheid afstevenen op wat hij "zelfverbeterende superintelligentie" noemde, zonder daarbij voldoende verantwoordelijkheid te nemen gezien de risico’s. Evan Hubinger, die alignment science leidt bij Anthropic, was het publiekelijk eens dat het toekomstige risico serieuze aandacht verdient, terwijl hij het tegelijk onderscheidde van wat huidige systemen daadwerkelijk kunnen. Het debat belandde razendsnel in het mainstream AI-discours.
Het concept in het midden van die discussie is recursieve zelfverbetering (RSI). Het is de moeite waard om dit op zichzelf te begrijpen, los van de controverse, omdat het onderliggende idee breder en verhelderender is dan welke nieuwscyclus dan ook. Dit artikel behandelt wat RSI werkelijk betekent, hoe de feedbacklus werkt, wat AI vandaag er concreet aan kan bijdragen, en waarom onderzoekers het oneens zijn over waar het toe leidt.
Recursieve zelfverbetering beschrijft een feedbacklus waarin AI bijdraagt aan het creëren van capabelere AI, en die capabelere AI vervolgens beter wordt in het bijdragen aan de volgende verbetering, enzovoort:
AI helpt AI te verbeteren → de verbeterde AI wordt beter in het verbeteren van AI → dat systeem draagt bij aan de volgende verbetering → herhaal
Het is nuttig om drie dingen te scheiden die vaak op één hoop worden gegooid.
Volledige RSI is dat derde punt. Geen enkel huidig AI-systeem heeft dat overtuigend bereikt. Precies die lijn trekt Anthropic zelf ook: volledige RSI is nog niet bereikt en mogelijk niet onvermijdelijk. Dat onderscheid maakt het Coxon-debat zo beladen: de discussie gaat niet over of RSI vandaag bestaat, maar over hoe snel de kloof kleiner wordt en wat dat vraagt van de mensen die deze systemen bouwen.
Een zelfverbeterend systeem, in de RSI-betekenis, draagt bij aan de AI-ontwikkelingspijplijn zelf. Dat betekent: onderzoekscode schrijven en verbeteren, experimenten ontwerpen, trainingsdata genereren of filteren, modelprestaties evalueren, zwaktes identificeren en algoritmische verbeteringen voorstellen. Het recursieve deel is cruciaal: als het systeem dat via dit proces ontstaat beter wordt in diezelfde taken, kan de volgende iteratie van AI-ontwikkeling sneller of effectiever plaatsvinden.
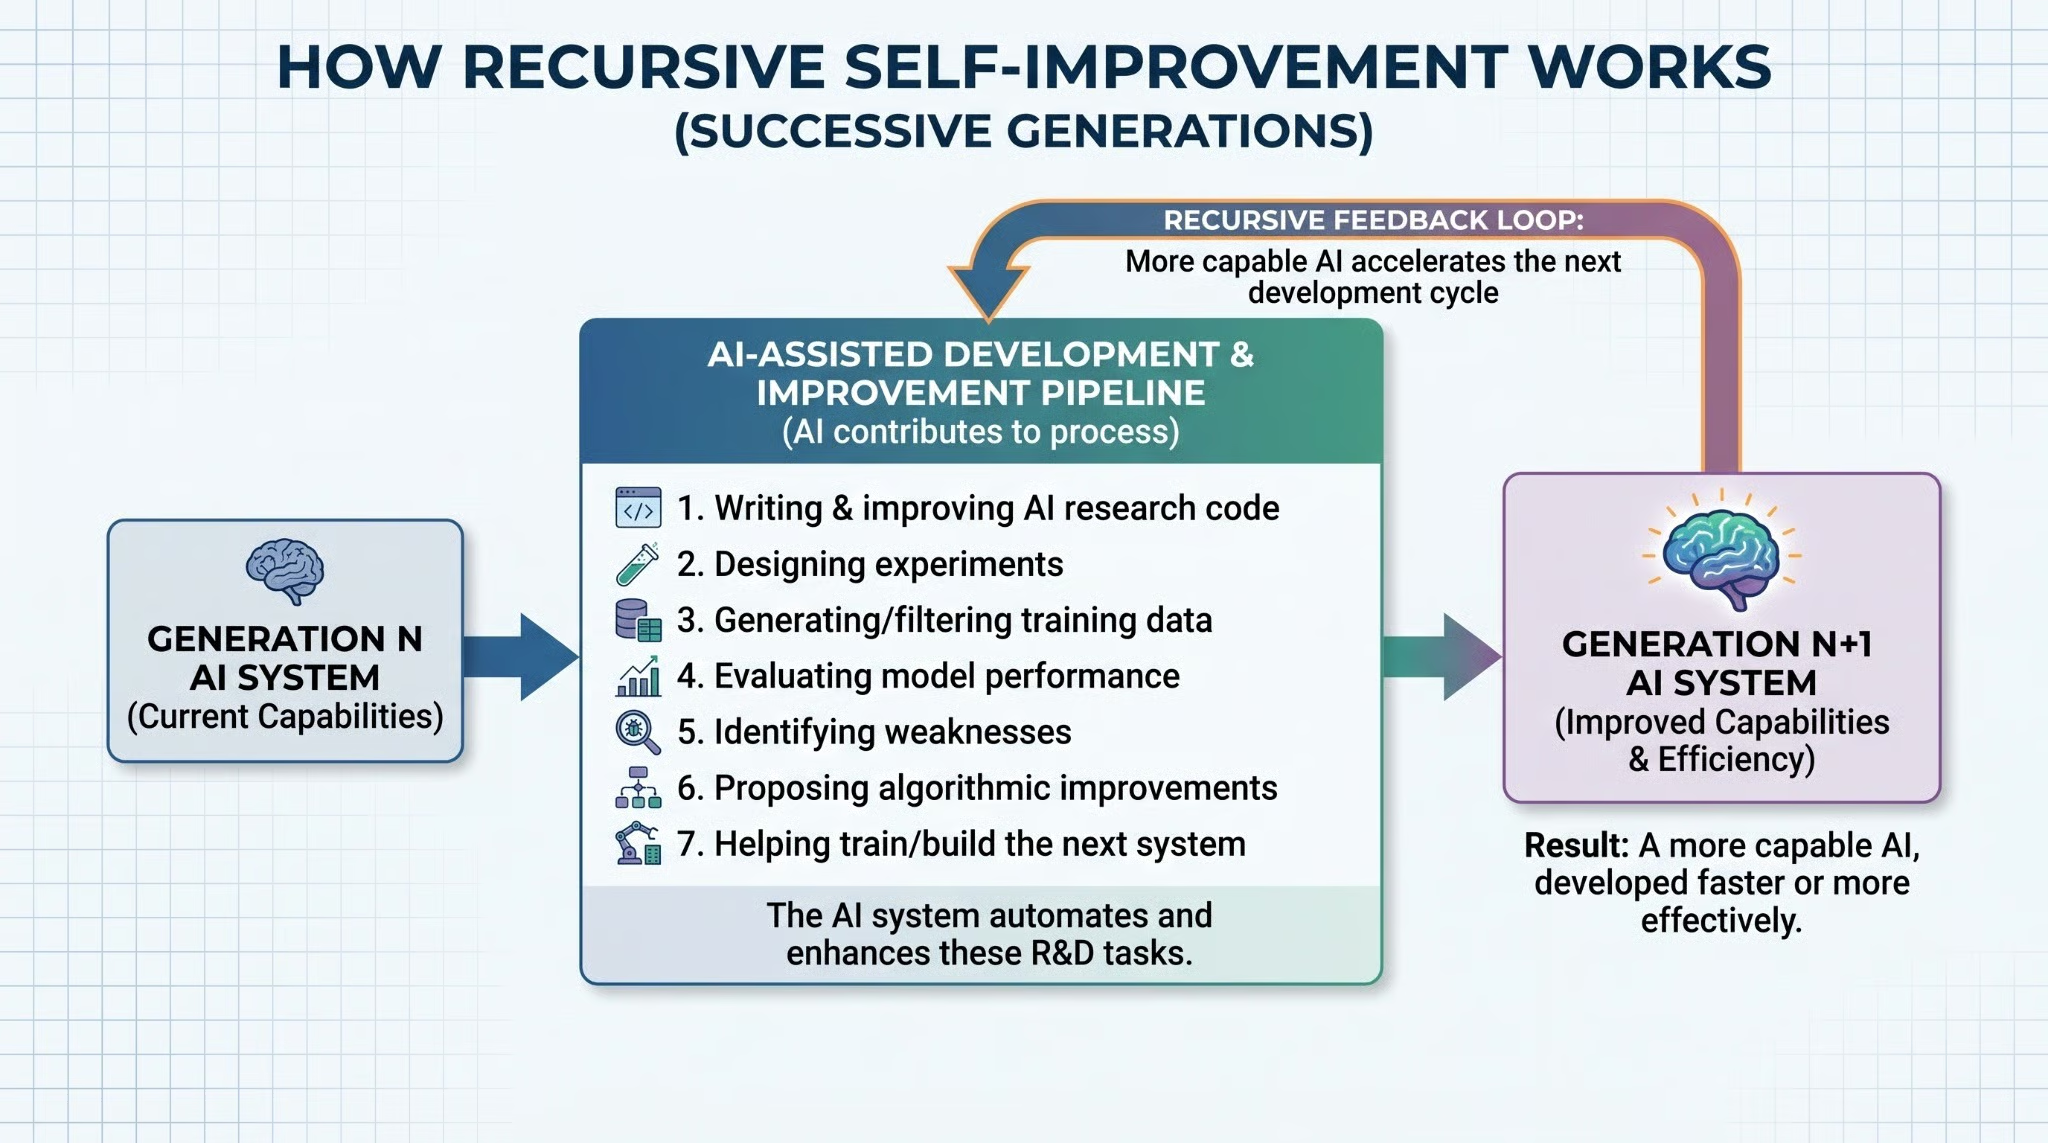
Diagram dat de feedbacklus van recursieve zelfverbetering laat zien over opeenvolgende AI-generaties. Afbeelding door auteur.
Dit is niet een model dat letterlijk in realtime zijn eigen gewichten herschrijft. Denk in generaties: elke generatie AI draagt effectiever bij aan het bouwen van de volgende. De lus stapelt zich op tussen versies, niet binnen één draaiend systeem.
De meest voorkomende misvatting over RSI is verwarring met zelfcorrectie. Dat overkomt zelfs mensen die AI goed volgen, dus precisie is belangrijk.
Zelfcorrectie is wanneer een model zijn eigen antwoord, code of plan bekritiseert of herziet tijdens een taak. Dat omvat het opsporen van een fout in zijn redenering, het debuggen van code die het zojuist schreef, of het verfijnen van een conceptversie. Dit gebeurt voortdurend in huidige systemen.
RSI is categorisch anders. Verbeteringen beïnvloeden de capaciteiten van het AI-systeem of diens opvolgers, waardoor AI-ontwikkeling zelf in de toekomst mogelijk effectiever wordt. Een agent die herhaaldelijk zijn eigen code debugt is niet automatisch recursieve zelfverbetering; het is gewoon een capabele agent. Het onderscheid is of de verbetering blijft bestaan en zich opstapelt in de ontwikkeling van het volgende systeem.
Zelfcorrectie is een hulpmiddel dat een systeem gebruikt bij een taak. RSI is wat er gebeurt wanneer de taak het bouwen van het volgende systeem is.
Het helpt om RSI te plaatsen naast een paar andere concepten die vaak in dezelfde gesprekken opduiken, zeker nu het Coxon-debat termen als "superintelligentie" en "singulariteit" in dezelfde koppen heeft gebracht.
Geautomatiseerde AI R&D omvat systemen die experimenten uitvoeren, resultaten analyseren en volgende stappen voorstellen. Deze kunnen bijdragen aan RSI zonder volledige RSI te vormen. Een systeem dat delen van de onderzoekspijplijn automatiseert, is onderdeel van de trend, niet het eindpunt. Het verschil tussen "helpt bij onderzoek" en "ontwikkelt autonoom zijn opvolgers" is wat telt. Anthropics eigen gepubliceerde werk beschrijft dat AI meer van deze pijplijn overneemt, wat verklaart waarom Coxons ontslag insloeg. De beweging is echt; de vraag is hoever het gaat.
Continu leren betekent dat een ingezet model zich bijwerkt met nieuwe informatie in de tijd. RSI betekent het verbeteren van het proces dat wordt gebruikt om steeds capabelere AI-systemen te ontwikkelen. Het één verandert wat een model weet; het ander verandert hoe capabel het volgende model wordt.
RSI beschrijft een proces. Superintelligentie beschrijft een voorgesteld capaciteitsniveau. Ze zijn verwant omdat RSI één verondersteld pad naar superintelligentie is, maar het zijn niet dezelfde concepten, en ze op één hoop gooien vertroebelt beide.
Wanneer Coxon waarschuwt voor "zelfverbeterende superintelligentie", beschrijft hij een scenario waarin RSI een systeem oplevert dat het menselijk niveau over domeinen heen overtreft. Dat is een specifieke claim over wat het proces uiteindelijk zou kunnen voortbrengen, niet een beschrijving van het proces zelf.
De AI-singulariteit is een hypothetisch punt waarop AI-verbetering zo snel en zelfvoorzienend wordt dat mensen niet langer kunnen voorspellen of beheersen wat er daarna komt. Zie het als het moment waarop de curve verticaal gaat: verandering die sneller gaat dan ons vermogen om haar te begrijpen of erop te reageren. RSI is één voorgesteld mechanisme om daar te komen. Maar de singulariteit is de speculatieve uitkomst, niet het proces zelf, en veel onderzoekers denken dat de curve ruim daarvoor afvlakt.
Dichterbij dan de meesten een paar jaar geleden beseften. Niet zo dichtbij als sommige koppen suggereren.
AI-systemen zijn nu al betrokken bij coderen, debuggen, experimenten uitvoeren, experimentele resultaten analyseren, modelevaluatie en AI-onderzoeksassistentie. Anthropic heeft publiekelijk gezegd dat het een groeiend deel van AI-ontwikkelingswerk delegeert aan AI-systemen, en dat engineers nu aanzienlijk meer code shippen dan in voorgaande jaren. Tegelijkertijd is Anthropic duidelijk dat mensen belangrijke rollen behouden in onderzoeksbeoordeling. Dat betekent beslissen welke problemen na te jagen en beoordelen of resultaten daadwerkelijk betekenen wat ze lijken te betekenen.
Toenemende AI-betrokkenheid in AI R&D is bewijs van beweging richting meer automatisering. Het is geen bewijs dat er al een autonome RSI-lus bestaat. De pijplijn bevat meer AI; hij draait zichzelf nog niet. Deze ambiguïteit — reële vooruitgang met een onduidelijk eindpunt — is precies wat Coxon onvoldoende vond. Zijn ontslag was geen bewering dat RSI al gearriveerd is. Het was een betoog dat het niet langer verdedigbaar is om het als een ver-van-ons-bed-show te behandelen.
Wat is er dus echt nodig om die kloof te dichten? Een paar knelpunten springen eruit, en de afstand tot elk zegt iets over de realistische timing.
Autonoom onderzoeksgrade code schrijven en aanpassen is een vereiste. Huidige modellen zijn hier oprecht goed in, al maken ze nog fouten die menselijk review vereisen bij werk met grote gevolgen.
Experimenten autonoom uitvoeren is een ander knelpunt dan de code schrijven om ze te draaien. Een systeem dat een experiment kan ontwerpen, uitvoeren, de resultaten interpreteren en besluiten wat de volgende stap is, sluit een wezenlijk deel van de lus. Huidige systemen kunnen delen hiervan. De volledige cyclus, zonder dat een mens bij elke stap de redenering checkt, is nog buiten bereik.
Hier wordt het interessant. Anthropic benoemt specifiek menselijk onderzoeksgevoel en oordeel als een overblijvend gebied van comparatief voordeel. Dat is weten welke experimenten de moeite waard zijn, welke resultaten je vertrouwt, welke richtingen kansrijk zijn. Veel van het experimentele werk van onderzoek wordt automatiseerbaar. De oordeellaag niet. Dit is ook waar Anthropic gelooft dat mensen momenteel de meest onvervangbare waarde toevoegen, en waar de afstand tot volledige RSI het grootst blijft.
Weten of een model echt beter is geworden, is lastiger dan het klinkt. Evaluatie vereist oordeel over wat ertoe doet, en huidige benchmarks zijn makkelijk te bespelen of te ontgroeien. Totdat AI-systemen hun eigen opvolgers betrouwbaar kunnen beoordelen, blijven mensen in de lus op dit stadium, wat op zichzelf een flinke rem is op autonome RSI.
Ruwe capaciteit is niet de enige beperking. De ontwikkelcyclus autonoom draaien vereist infrastructuur die grootschalige training en evaluatie kan ondersteunen zonder constante menselijke tussenkomst, en dat blijft duur en organisatorisch complex.
Weten of een model echt beter is geworden, is lastiger dan het klinkt. Evaluatie vereist oordeel over wat ertoe doet, en huidige benchmarks zijn makkelijk te bespelen of te ontgroeien. Totdat AI-systemen hun eigen opvolgers betrouwbaar kunnen beoordelen, blijven mensen in de lus op dit stadium, wat op zichzelf een flinke rem is op autonome RSI.
Zelfs als AI-systemen code kunnen schrijven, experimenten kunnen draaien en resultaten kunnen evalueren, geven mensen nog steeds het eindoordeel over wat er werkelijk wordt verscheept. Die reviewstap is een harde grens aan hoe snel de lus kan draaien. Je kunt het werk automatiseren en nog steeds vastlopen op de goedkeuring. Tot AI-oordeel genoeg wordt vertrouwd om die poort te verwijderen, is menselijke review waarschijnlijk het meest directe plafond op RSI-vooruitgang, niet een filosofische zorg over de toekomst.
Het antwoord heeft twee delen: potentieel voordeel en serieuze risico’s.
Als AI-systemen AI-onderzoek zelf kunnen versnellen, kan datzelfde effect zich uitstrekken naar softwareontwikkeling, wetenschappelijke ontdekking, geneeskunde en techniek in bredere zin. Het argument is dat een AI die goed is in onderzoeksversnelling tijdlijnen in veel velden kan verkorten, niet alleen in AI.
Hier is de feedbacklus helder verwoord: verbeteringen in AI-onderzoeksvermogen kunnen het tempo verhogen waarmee verdere AI-verbeteringen plaatsvinden. Dat samengestelde effect maakt RSI theoretisch significant, en het is waarom onderzoekers als Coxon er zo bezorgd over zijn dat ze ontslag nemen. Terzijde: snellere capaciteitsontwikkeling leidt niet automatisch tot een intelligentie-explosie. De lus kan echt zijn en toch langzaam, begrensd of onderhevig aan afnemende meeropbrengsten.
Door AI gegenereerde experimenten, code en modelwijzigingen zouden uiteindelijk sneller kunnen worden geproduceerd dan mensen ze zinvol kunnen beoordelen. Het toezicht dat AI-ontwikkeling nu vormgeeft, hangt ervan af dat mensen het tempo van wat gebouwd wordt kunnen bijbenen. Dit is één reden waarom Anthropic nog steeds de rol van menselijk oordeel benadrukt in zijn onderzoekspijplijn, ook al automatiseert het meer van het werk.
Capabelere systemen die betrokken zijn bij het ontwikkelen van hun opvolgers maken het alignment-probleem belangrijker. Als het systeem dat bijdraagt aan de volgende generatie subtiel mis-uitgelijnde doelen heeft, kunnen die zich voortplanten of verergeren in de opvolger. Precies hierover heeft Hubinger uitgebreid geschreven, en dit was wat hij signaleerde toen hij het eens was met Coxons zorg over toekomstige risico’s, terwijl hij volhield dat huidige systemen nog niet dezelfde dreiging vormen.
Capabelere autonome systemen vergroten ook het aanvalsoppervlak. Een systeem dat betrokken is bij zijn eigen ontwikkelpijplijn is een waardevoller doelwit, en de faalmodi worden ingrijpender naarmate de autonomie toeneemt. Containment en toegangsbeheer worden lastiger te ontwerpen wanneer het systeem dat je bevat ook helpt aan de volgende versie van zichzelf te bouwen.
Als de feedbacklus de ontwikkeling merkbaar versnelt, hebben instellingen mogelijk minder tijd om nieuwe capaciteiten te evalueren en erop te reageren. Anthropic heeft gezegd dat volledige RSI de risico’s kan vergroten dat mensen de controle over AI-systemen verliezen, terwijl het ook zegt dat RSI niet bereikt en niet onvermijdelijk is.
Jacob Coxons ontslag bij Anthropic in september 2026 zette de kwestie in urgente bewoordingen neer: dat Anthropic en OpenAI racen richting zelfverbeterende superintelligentie en, gezien de mogelijke gevolgen, niet voorzichtig genoeg handelen. Evan Hubinger was het publiekelijk eens (hij schatte persoonlijk de kans op door AI veroorzaakte menselijke extinctie binnen tien jaar op boven de 10% en erkende dat Anthropic nog geen plan heeft om superintelligentie uit te lijnen) terwijl hij die toekomstige zorg onderscheidde van het risico door huidige systemen. Coxon heeft sindsdien gezegd dat zijn kernmeningsverschil met de leiding van Anthropic draait om de vraag of een competitieve race richting RSI onvermijdelijk is en dus moet worden meegedaan.
Dat meningsverschil staat naast Anthropics eerdere publicatie die voortgang beschrijft richting AI-geautomatiseerde AI-ontwikkeling, hetzelfde onderzoek dat laat zien dat AI meer van de ontwikkelpijplijn overneemt. Die twee dingen zijn met elkaar in lijn, wat deel van de reden is waarom het debat moeilijk weg te wuiven is. Neem Coxons voorspellingen over catastrofale uitkomsten niet als vaststaande feiten. Ze maken deel uit van een lopende discussie, geen gevestigde wetenschap.
Het theoretische argument luidt: betere AI leidt tot beter AI-onderzoek leidt tot nog betere AI leidt tot sneller verbetering. De logica is zuiver. De vraag is of ze in de praktijk standhoudt.
Onbeperkte versnelling volgt niet automatisch. Reële beperkingen zijn onder meer rekenkracht, energie, hardware, trainingsdata, algoritmische knelpunten, experimentele feedbackcycli, afnemende meeropbrengsten en blijvende afhankelijkheid van menselijk oordeel. Een intelligentie-explosie is een bediscussieerde hypothese over wat voldoende effectieve RSI zou kunnen opleveren, niet een definitie van RSI zelf. Het is één scenario in een verdeling, niet het voor de hand liggende eindpunt. Niemand, inclusief de onderzoekers bij Anthropic die hier het hardst over nadenken, weet hoe steil de curve wordt of waar hij afvlakt.
Die onzekerheid maakt governance zowel urgenter als moeilijker. De kernuitdaging is betekenisvol toezicht behouden als door AI gegenereerd onderzoek sneller begint te gaan dan menselijke review kan bijhouden. Actieve voorstellen en onderzoeksgebieden omvatten capaciteitsbeoordelingen vóór uitrol, containmentbenaderingen voor modellen, toegangscontroles op AI-systemen die betrokken zijn bij AI-ontwikkeling, monitoring van AI R&D-activiteit, menselijke goedkeuringseisen voor ingrijpende acties, onafhankelijke evaluatie, en coördinatie tussen frontier AI-labs.
Geen van deze is een complete oplossing, en het Coxon-debat onderstreept waarom: governancekaders die zijn ontworpen voor het huidige niveau van AI-betrokkenheid in de pijplijn, schalen mogelijk niet mee naar dat van morgen. De kloof tussen waar de tools zijn en waar de technologie heen gaat, is deel van wat dit moment voor de mensen die er het dichtst op zitten werkelijk ingrijpend doet aanvoelen.
Recursieve zelfverbetering beschrijft een feedbacklus waarin AI bijdraagt aan het creëren van capabelere AI, die vervolgens beter kan worden in het bijdragen aan daaropvolgende verbeteringen. Simpel gesteld, maar echt onzeker om te beoordelen.
De AI-ondersteunde ontwikkeling van vandaag is echt en groeit, zoals Anthropics eigen onderzoek duidelijk maakt. Volledige autonome RSI, waarbij AI-systemen in grote mate hun opvolgers ontwerpen en ontwikkelen zonder menselijke sturing, is niet bereikt. Anthropic zelf trekt die lijn. De kloof tussen die twee dingen is waar alle interessante en betwiste vragen leven: hoe snel sluit ze, wat gebeurt er als dat gebeurt, en wie mag bepalen hoe snel we gaan?
De uitwisseling Coxon–Hubinger creëerde die vragen niet. Ze maakte het onmogelijk om ze als theoretisch te behandelen. Of je Coxons tijdlijn alarmerend vindt of Anthropics framing behoudener, de onderliggende dynamiek is dezelfde: AI zit in toenemende mate in de lus die AI bouwt. Begrijpen wat dat betekent, helder en zonder hype in welke richting dan ook, is waarom RSI het waard is om te kennen.
Leer AI met DataCamp
Cursus
Cursus
Cursus