course
Understanding Artificial Intelligence
2 घंटा
420.8K
सितंबर 2026 में, शोधकर्ता जैकब कॉक्सन (जिन्होंने OpenAI में प्रीट्रेनिंग रिसर्च पर लगभग तीन वर्ष बिताए थे और दो महीने पहले ही Anthropic जॉइन किया था) ने इस्तीफा दे दिया और सार्वजनिक रूप से चेतावनी दी कि अग्रणी लैब्स उस दिशा में दौड़ रही हैं जिसे उन्होंने "स्वयं-सुधार करने वाली सुपरइंटेलिजेंस" कहा, जबकि जोखिमों को देखते हुए उतनी जिम्मेदारी नहीं दिखा रहीं। Anthropic में एलाइंमेंट साइंस का नेतृत्व करने वाले इवान हबिंगर ने सार्वजनिक रूप से सहमति जताई कि भविष्य का जोखिम गंभीर चिंता का विषय है, साथ ही इसे वर्तमान प्रणालियों की वास्तविक क्षमताओं से अलग भी किया। यह बहस बहुत तेजी से मुख्यधारा की एआई चर्चा में आ गई।
उस तर्क के केंद्र में जो अवधारणा है, वह है recursive self-improvement (RSI)। इसे विवाद से अलग, अपने आप में समझना उपयोगी है, क्योंकि अंतर्निहित विचार किसी एक समाचार चक्र से व्यापक और ज़्यादा स्पष्टकारी है। यह लेख बताता है कि वास्तव में RSI का अर्थ क्या है, फीडबैक लूप कैसे काम करता है, आज की एआई इसके लिए सचमुच क्या कर सकती है, और शोधकर्ता इसके परिणामों पर असहमत क्यों होते हैं।
Recursive self-improvement एक फीडबैक लूप का वर्णन करता है जिसमें एआई अधिक सक्षम एआई बनाने में योगदान देता है, और वह अधिक सक्षम एआई अगली सुधार प्रक्रिया में योगदान देने में और बेहतर बनता जाता है, और यह क्रम चलता रहता है:
एआई एआई को बेहतर बनाने में मदद करता है → सुधरा हुआ एआई, एआई में सुधार करने में और बेहतर हो जाता है → वह सिस्टम अगले सुधार में योगदान देता है → दोहराएँ
अक्सर तीन चीज़ें आपस में गड्डमड्ड हो जाती हैं, इन्हें अलग-अलग समझना ज़रूरी है।
पूर्ण RSI तीसरी चीज़ है। किसी मौजूदा एआई सिस्टम ने इसे निर्णायक रूप से हासिल नहीं किया है। Anthropic भी यही रेखा खींचता है, यह बताते हुए कि पूर्ण RSI अभी हासिल नहीं हुआ है और यह अनिवार्य भी नहीं हो सकता। यही भेद कॉक्सन की बहस को इतना तीखा बनाता है: तर्क इस पर नहीं है कि आज RSI मौजूद है या नहीं, बल्कि इस पर है कि अंतर कितनी तेज़ी से घट रहा है और यह सिस्टम बनाने वालों से क्या अपेक्षा करता है।
RSI अर्थ में एक स्वयं-सुधार करने वाला सिस्टम स्वयं एआई डेवलपमेंट पाइपलाइन में योगदान देगा। इसका मतलब है रिसर्च कोड लिखना और सुधारना, प्रयोगों को डिज़ाइन करना, प्रशिक्षण डेटा बनाना या फ़िल्टर करना, मॉडल के प्रदर्शन का मूल्यांकन करना, कमजोरियों की पहचान करना और एल्गोरिदमिक सुधार सुझाना। recursive हिस्सा महत्वपूर्ण है: यदि इस प्रक्रिया से उत्पन्न सिस्टम उन्हीं कार्यों में बेहतर हो जाता है, तो एआई विकास की अगली कड़ी तेज़ या अधिक प्रभावी हो सकती है।
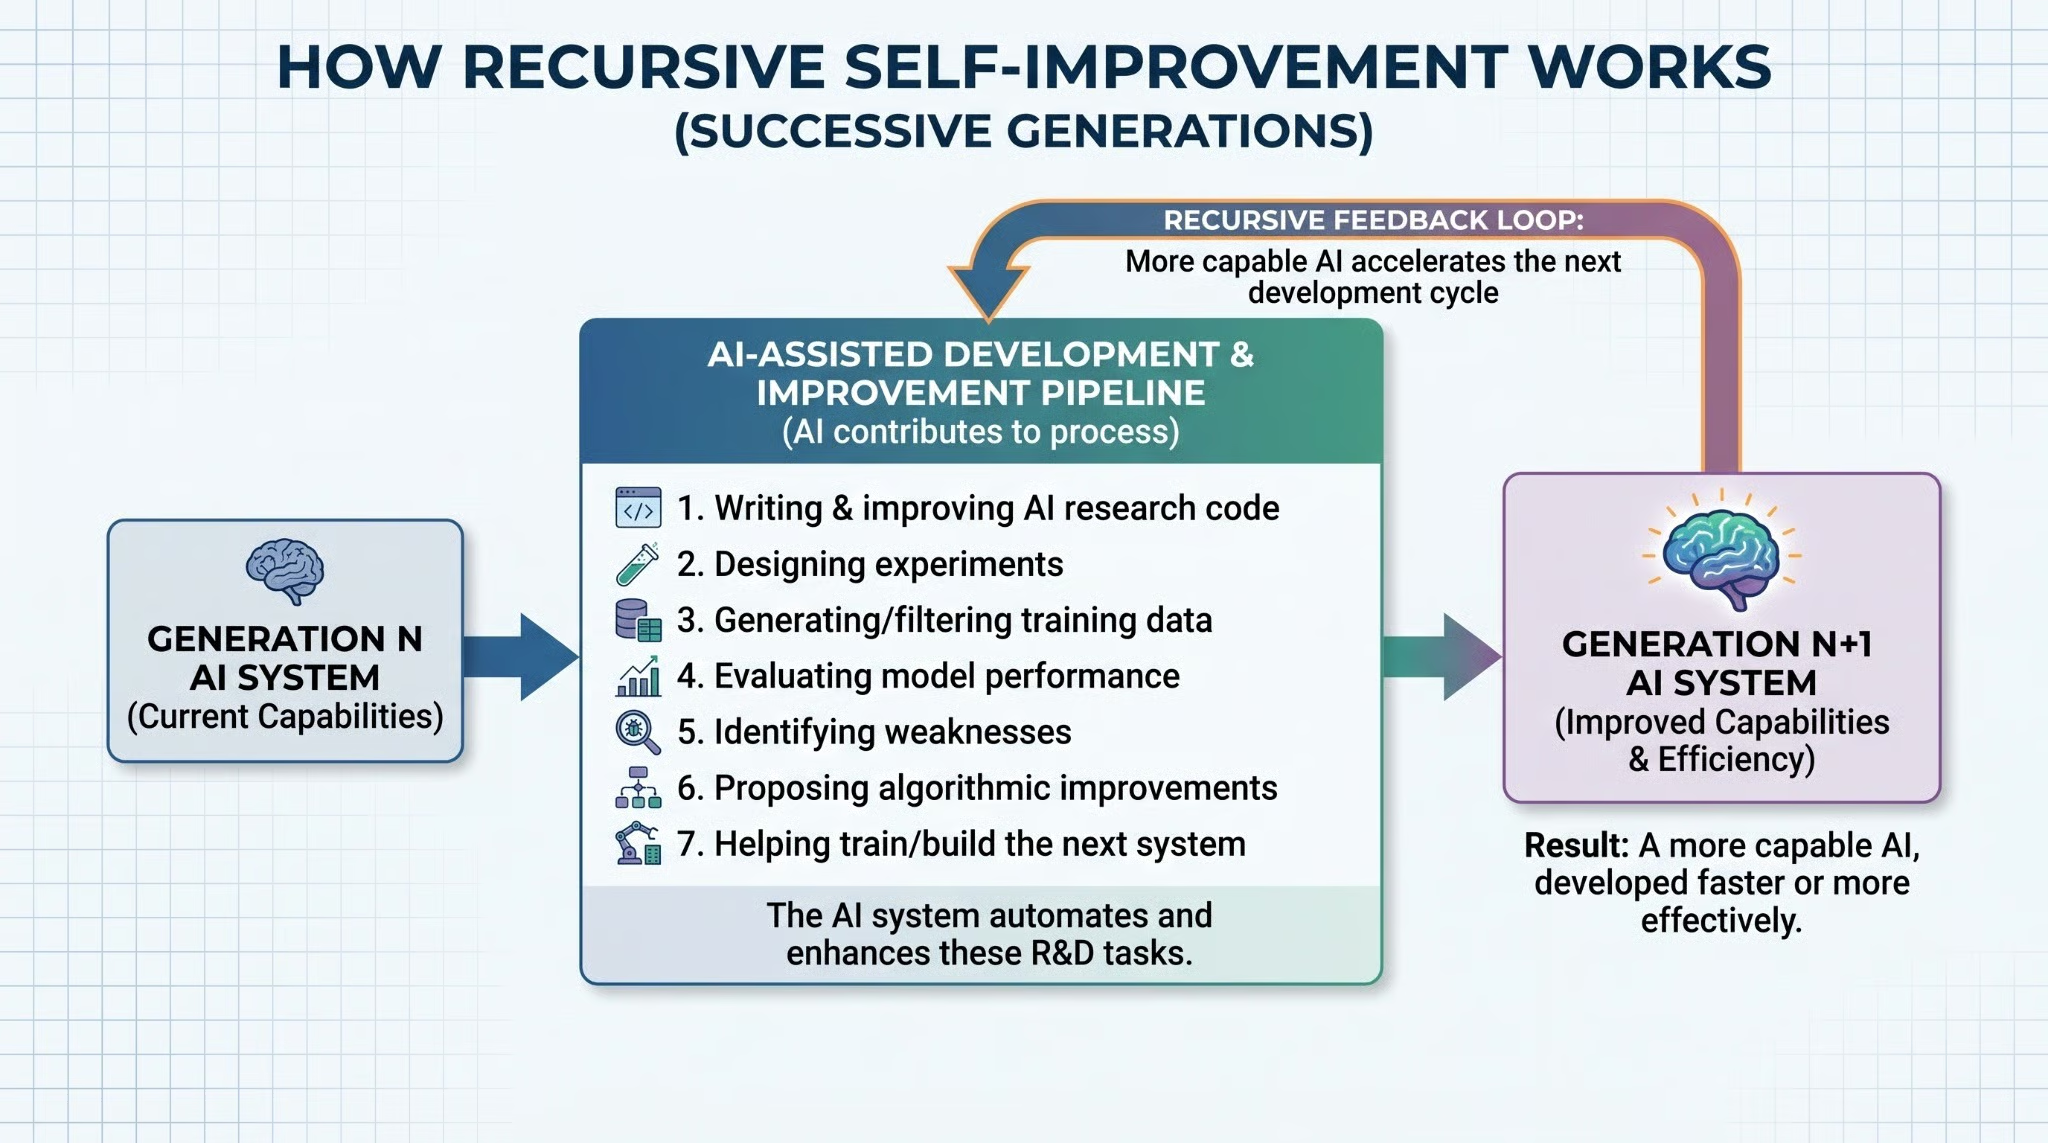
क्रमिक एआई पीढ़ियों में recursive self-improvement फीडबैक लूप को दर्शाता आरेख। चित्र: लेखक द्वारा।
यह कोई मॉडल नहीं है जो रियल-टाइम में अपने वेट्स खुद फिर से लिख रहा हो। इसे क्रमिक पीढ़ियों के रूप में सोचें: एआई की हर पीढ़ी अगली पीढ़ी के निर्माण में अधिक प्रभावी ढंग से योगदान देती है। यह लूप एक चलती हुई एकल प्रणाली के भीतर नहीं, बल्कि संस्करणों के पार चक्रवृद्धि होता है।
RSI के बारे में सबसे आम गलतफहमी इसे self-correction से गड़बड़ा देना है। यह एआई को नज़दीक से फॉलो करने वालों को भी उलझा देता है, इसलिए सटीक होना ज़रूरी है।
Self-correction तब होती है जब कोई मॉडल किसी कार्य के दौरान अपने ही उत्तर, कोड या योजना की समीक्षा या आलोचना करता है। इसमें अपनी तर्क-शृंखला में त्रुटि पकड़ना, अभी-अभी लिखा कोड डिबग करना, या किसी ड्राफ्ट को परिष्कृत करना शामिल है। आज की प्रणालियों में यह लगातार होता है।
RSI श्रेणीगत रूप से भिन्न है। सुधार एआई प्रणाली या उसके उत्तराधिकारियों की क्षमताओं को प्रभावित करते हैं, जिससे भविष्य का एआई विकास स्वयं अधिक प्रभावी हो सकता है। कोई एजेंट बार-बार अपना कोड डिबग करता है तो वह स्वचालित रूप से recursive self-improvement नहीं है; वह केवल एक सक्षम एजेंट है। भेद यह है कि क्या सुधार बना रहता है और अगली प्रणाली के विकास में चक्रवृद्धि होता है।
Self-correction एक उपकरण है जिसे सिस्टम किसी कार्य पर उपयोग करता है। RSI तब होता है जब कार्य ही अगली प्रणाली का निर्माण होता है।
RSI को कुछ अन्य अवधारणाओं के संदर्भ में मानचित्रित करना उपयोगी है जो अक्सर इन्हीं चर्चाओं में आते हैं, खासकर जब कॉक्सन की बहस ने "सुपरइंटेलिजेंस" और "सिंगुलैरिटी" जैसे शब्दों को एक ही सुर्खियों में ला दिया है।
स्वचालित एआई R&D उन प्रणालियों को समाहित करता है जो प्रयोग चलाती हैं, परिणामों का विश्लेषण करती हैं और अगली कार्रवाइयों का प्रस्ताव रखती हैं। ये पूर्ण RSI हुए बिना भी RSI में योगदान दे सकती हैं। कोई प्रणाली जो रिसर्च पाइपलाइन के हिस्सों को स्वचालित करती है, वह प्रवृत्ति का हिस्सा है, अंतिम बिंदु नहीं। "रिसर्च में मदद करती है" और "अपने उत्तराधिकारियों को स्वायत्त रूप से विकसित करती है" के बीच का अंतर मायने रखता है। Anthropic के खुद के प्रकाशित कार्य में एआई द्वारा इस पाइपलाइन के और हिस्से संभालने का वर्णन है, इसी कारण कॉक्सन का इस्तीफा प्रभावी लगा। आंदोलन वास्तविक है; सवाल यह है कि यह कितना दूर जाता है।
सतत अधिगम का अर्थ है कि तैनात मॉडल समय के साथ नई जानकारी से अपडेट होता रहता है। RSI का अर्थ है उन प्रक्रियाओं में सुधार करना जिनसे क्रमशः अधिक सक्षम एआई प्रणालियाँ विकसित होती हैं। एक मॉडल का ज्ञान बदलता है; दूसरा, अगले मॉडल की क्षमता कैसे बढ़ती है उसे बदलता है।
RSI एक प्रक्रिया का वर्णन करता है। सुपरइंटेलिजेंस क्षमता के एक प्रस्तावित स्तर का। वे इस अर्थ में संबंधित हैं कि RSI सुपरइंटेलिजेंस की ओर एक परिकल्पित राह है, पर दोनों एक ही अवधारणा नहीं हैं, और उन्हें मिलाने से दोनों धुंधले हो जाते हैं।
जब कॉक्सन "स्वयं-सुधार करने वाली सुपरइंटेलिजेंस" की चेतावनी देते हैं, तो वे एक ऐसे परिदृश्य का वर्णन करते हैं जहाँ RSI एक ऐसी प्रणाली उत्पन्न करता है जो अनेक क्षेत्रों में मानव-स्तरीय क्षमता से आगे निकल जाती है। यह इस बारे में एक विशिष्ट दावा है कि प्रक्रिया अंततः क्या दे सकती है, न कि स्वयं प्रक्रिया का वर्णन।
एआई सिंगुलैरिटी एक काल्पनिक बिंदु है जहाँ एआई सुधार इतने तेज़ और आत्म-समर्थित हो जाते हैं कि मनुष्य यह अनुमान या नियंत्रण नहीं कर पाते कि आगे क्या होगा। इसे उस क्षण की तरह सोचें जब वक्र लंबवत हो जाता है: बदलाव हमारी समझने या प्रतिक्रिया देने की क्षमता से भी तेज़। RSI वहाँ तक पहुँचने की एक प्रस्तावित प्रणाली है। पर सिंगुलैरिटी संभावित परिणाम है, प्रक्रिया नहीं, और बहुत से शोधकर्ता मानते हैं कि वक्र उससे बहुत पहले समतल हो जाता है।
कुछ साल पहले ज्यादातर लोगों की अपेक्षा से ज्यादा करीब। उतने करीब नहीं जितना कुछ सुर्खियाँ सुझाती हैं।
एआई प्रणालियाँ पहले से ही कोडिंग, डिबगिंग, प्रयोग चलाने, प्रायोगिक परिणामों के विश्लेषण, मॉडल मूल्यांकन और एआई रिसर्च सहायता में शामिल हैं। Anthropic ने सार्वजनिक रूप से कहा है कि वह एआई विकास कार्य का बढ़ता हिस्सा एआई प्रणालियों को सौंप रहा है, और उसके इंजीनियर अब पिछले वर्षों की तुलना में काफी अधिक कोड शिप करते हैं। साथ ही Anthropic स्पष्ट है कि शोध संबंधी निर्णयों में मानवों की महत्वपूर्ण भूमिका बनी हुई है। यानी किन समस्याओं का पीछा करना है और क्या परिणाम सच में वही अर्थ रखते हैं जो वे दिखते हैं—यह तय करना।
एआई R&D में बढ़ती एआई भागीदारी अधिक स्वचालन की दिशा में गति का प्रमाण है। यह इस बात का सबूत नहीं कि स्वायत्त RSI लूप पहले से मौजूद है। पाइपलाइन में एआई अधिक है; यह अभी खुद नहीं चलती। यही द्विविधा—वास्तविक प्रगति, पर अस्पष्ट अंतिम बिंदु—कॉक्सन को असंतोषजनक लगी। उनका इस्तीफा यह दावा नहीं था कि RSI आ गया है। यह तर्क था कि इसे दूर की चिंता मानना अब बचाव योग्य नहीं है।
तो वास्तव में उस अंतर को पाटने के लिए क्या चाहिए होगा? कुछ बाधाएं स्पष्ट हैं, और प्रत्येक तक की दूरी संभावित समय-सीमा के बारे में संकेत देती है।
रिसर्च कोड को स्वायत्त रूप से लिखना और संशोधित करना एक पूर्वापेक्षा है। मौजूदा मॉडल इसमें वाकई अच्छे हैं, हालांकि वे अब भी ऐसी गलतियाँ करते हैं जिनके लिए महत्वपूर्ण कार्यों पर मानवीय समीक्षा चाहिए।
प्रयोगों को स्वायत्त रूप से चलाना, उन्हें चलाने के कोड लिखने से अलग बाधा है। कोई प्रणाली जो प्रयोग डिज़ाइन कर सके, उसे निष्पादित करे, परिणामों की व्याख्या करे, और अगला कदम क्या होना चाहिए यह तय करे—वह लूप का एक बड़ा हिस्सा बंद कर देती है। वर्तमान प्रणालियाँ इसका कुछ हिस्सा कर सकती हैं। पूरा चक्र, हर चरण पर तर्क की मानवीय जाँच के बिना, अभी दूर है।
यहीं चीजें दिलचस्प हो जाती हैं। Anthropic विशेष रूप से मानवीय रिसर्च टेस्ट और निर्णय को शेष तुलनात्मक लाभ के क्षेत्र के रूप में पहचानता है। यानी कौन से प्रयोग चलाने लायक हैं, किन परिणामों पर भरोसा करना है, किन दिशाओं में संभावना है—यह जानना। शोध का बहुत सा प्रायोगिक काम स्वचालित होने योग्य बन रहा है। निर्णय की परत नहीं। Anthropic का मानना है कि फिलहाल मानव यहीं सबसे अपूरणीय मूल्य जोड़ते हैं, और यही वह दूरी है जहाँ पूर्ण RSI से अंतर सबसे बड़ा है।
यह जानना कि कोई मॉडल सच में बेहतर हुआ है, सुनने में जितना सरल लगता है, उससे कठिन है। मूल्यांकन के लिए इस पर निर्णय चाहिए कि क्या मायने रखता है, और मौजूदा बेंचमार्क्स को खेलना या पार करना आसान है। जब तक एआई प्रणालियाँ अपने उत्तराधिकारियों का विश्वसनीय आकलन नहीं कर सकतीं, तब तक इस चरण में मानव शामिल रहेंगे, जो स्वायत्त RSI पर एक महत्वपूर्ण ब्रेक है।
कच्ची क्षमता अकेली बाधा नहीं है। विकास चक्र को स्वायत्त रूप से चलाने के लिए ऐसे इन्फ्रास्ट्रक्चर की जरूरत होती है जो बड़े पैमाने पर ट्रेनिंग और मूल्यांकन को बिना लगातार मानवीय हस्तक्षेप के संभाल सके, और यह अब भी महंगा और संगठनात्मक रूप से जटिल है।
यह जानना कि कोई मॉडल सच में बेहतर हुआ है, सुनने में जितना सरल लगता है, उससे कठिन है। मूल्यांकन के लिए इस पर निर्णय चाहिए कि क्या मायने रखता है, और मौजूदा बेंचमार्क्स को खेलना या पार करना आसान है। जब तक एआई प्रणालियाँ अपने उत्तराधिकारियों का विश्वसनीय आकलन नहीं कर सकतीं, तब तक इस चरण में मानव शामिल रहेंगे, जो स्वायत्त RSI पर एक महत्वपूर्ण ब्रेक है।
भले ही एआई प्रणालियाँ कोड लिख सकें, प्रयोग चला सकें, और परिणामों का मूल्यांकन कर सकें, लेकिन अंत में क्या शिप होता है उस पर मुहर मानव ही लगाते हैं। यह समीक्षा चरण लूप की गति पर सख्त सीमा है। आप काम को स्वचालित कर सकते हैं फिर भी स्वीकृति पर अटक सकते हैं। जब तक एआई के निर्णय पर इतना भरोसा न हो जाए कि वह गेट हटाया जा सके, तब तक मानवीय समीक्षा निकट भविष्य में RSI प्रगति की सबसे तात्कालिक छतरी बनी रहेगी—यह भविष्य पर दार्शनिक चिंता से ज़्यादा व्यावहारिक बाधा है।
उत्तर दो हिस्सों में है: संभावित फायदा और गंभीर जोखिम।
यदि एआई प्रणालियाँ स्वयं एआई रिसर्च में तेजी ला सकती हैं, तो वही प्रभाव सॉफ़्टवेयर विकास, वैज्ञानिक खोज, चिकित्सा और व्यापक रूप से इंजीनियरिंग तक फैल सकता है। तर्क यह है कि रिसर्च त्वरक के रूप में पर्याप्त सक्षम एआई कई क्षेत्रों—सिर्फ एआई नहीं—में समयसीमाएँ संकुचित कर सकता है।
फीडबैक-लूप का तर्क सीधा-सीधा: एआई रिसर्च क्षमता में सुधार, आगे के एआई सुधारों की दर बढ़ा सकता है। यही चक्रवृद्धि RSI को सैद्धांतिक रूप से महत्वपूर्ण बनाती है—और यही कारण है कि कॉक्सन जैसे शोधकर्ता इसके चलते इस्तीफा देने जितने चिंतित हैं। ध्यातव्य: क्षमताओं का तेज़ विकास अपने आप इंटेलिजेंस एक्सप्लोजन नहीं बना देता। लूप वास्तविक हो सकता है, फिर भी धीमा, सीमित, या घटती प्रतिफल का शिकार।
एआई-जनित प्रयोग, कोड, और मॉडल बदलाव अंततः इतनी तेज़ी से उत्पन्न हो सकते हैं कि मनुष्य उन्हें सार्थक रूप से समीक्षा न कर पाएं। जो पर्यवेक्षण वर्तमान में एआई विकास को आकार देता है, वह इस पर निर्भर है कि मनुष्य निर्माण की रफ्तार के साथ कदम मिला सकें। यही एक कारण है कि Anthropic अपने शोध पाइपलाइन में बढ़ते स्वचालन के बावजूद मानवीय निर्णय की भूमिका पर जोर देता है।
अपने उत्तराधिकारियों के विकास में शामिल अधिक सक्षम प्रणालियाँ एलाइंमेंट समस्या को अधिक नाजुक बनाती हैं। यदि अगली पीढ़ी में योगदान देने वाली प्रणाली के लक्ष्य सूक्ष्म रूप से असंगत हैं, तो वे उत्तराधिकारी में प्रसारित या बदतर हो सकते हैं। यही वह जोखिम है जिसके बारे में हबिंगर ने विस्तार से लिखा है, और यही वे संकेत दे रहे थे जब उन्होंने भविष्य के जोखिमों पर कॉक्सन की चिंता से सहमति जताई, जबकि यह भी माना कि वर्तमान प्रणालियाँ अभी वैसा खतरा पैदा नहीं करतीं।
अधिक सक्षम स्वायत्त प्रणालियाँ हमले की सतह भी बढ़ाती हैं। जो प्रणाली अपनी ही विकास पाइपलाइन में शामिल है, वह उच्च-मूल्य लक्ष्य बन जाती है, और जैसे-जैसे स्वायत्तता बढ़ती है, विफलता के तौर-तरीके अधिक परिणामकारी हो जाते हैं। कंटेनमेंट और एक्सेस कंट्रोल को डिज़ाइन करना तब कठिन हो जाता है जब जिसे सीमाबद्ध करना है वही प्रणाली अपने अगले संस्करण के निर्माण में मदद कर रही हो।
यदि फीडबैक लूप विकास को अर्थपूर्ण रूप से तेज़ करता है, तो संस्थाओं के पास नई क्षमताओं का मूल्यांकन और प्रतिक्रिया देने के लिए कम समय हो सकता है। Anthropic ने कहा है कि पूर्ण RSI मनुष्यों के एआई प्रणालियों पर नियंत्रण खोने के जोखिम को बढ़ा सकता है, साथ ही यह भी कहा है कि RSI न तो हासिल हुआ है और न ही अनिवार्य है।
सितंबर 2026 में Anthropic से जैकब कॉक्सन के इस्तीफे ने मुद्दे को तात्कालिक शब्दों में पेश किया: कि Anthropic और OpenAI स्वयं-सुधार करने वाली सुपरइंटेलिजेंस की ओर दौड़ रहे हैं और संभावित परिणामों को देखते हुए पर्याप्त जिम्मेदारी नहीं निभा रहे। इवान हबिंगर ने सार्वजनिक रूप से सहमति जताई (मानव विलुप्ति के एआई-जनित जोखिम को इस दशक में 10% से अधिक आँकते हुए और स्वीकारते हुए कि Anthropic के पास सुपरइंटेलिजेंस को संरेखित करने की योजना अभी नहीं है) जबकि भविष्य की उस चिंता को वर्तमान प्रणालियों के जोखिम से अलग भी किया। कॉक्सन ने बाद में कहा कि उनकी मूल असहमति Anthropic नेतृत्व से इस बात पर है कि क्या RSI की ओर प्रतिस्पर्धी दौड़ अपरिहार्य है और इसलिए उसमें भाग लेना ही होगा।
यह असहमति Anthropic के पहले के उसी प्रकाशन के साथ बैठती है जो एआई-स्वचालित एआई विकास की दिशा में प्रगति का वर्णन करता है—वही शोध जो दिखाता है कि एआई विकास पाइपलाइन का ज़्यादा हिस्सा एआई संभाल रहा है। दोनों बातें एक-दूसरे के अनुरूप हैं, इसलिए इस बहस को नज़रअंदाज़ करना आसान नहीं। कॉक्सन की विनाशकारी परिणामों वाली भविष्यवाणियों को स्थापित तथ्य न मानें। वे एक चलती हुई बहस का हिस्सा हैं, न कि तयशुदा विज्ञान।
सैद्धांतिक तर्क यह है: बेहतर एआई से बेहतर एआई रिसर्च, उससे और भी बेहतर एआई, और उससे तेज़ सुधार। तर्क साफ़-सुथरा है। सवाल है कि क्या यह व्यवहार में कायम रहता है।
अनिश्चितकालीन त्वरण अपने आप नहीं आता। वास्तविक बाधाओं में कंप्यूट, ऊर्जा, हार्डवेयर, प्रशिक्षण डेटा, एल्गोरिदमिक bottlenecks, प्रायोगिक फीडबैक चक्र, घटते प्रतिफल, और मानवीय निर्णय पर बनी निर्भरता शामिल हैं। इंटेलिजेंस एक्सप्लोजन इस बात पर विवादित परिकल्पना है कि पर्याप्त रूप से प्रभावी RSI क्या उत्पन्न कर सकती है, न कि RSI की परिभाषा। यह संभावनाओं के वितरण में एक परिदृश्य है, स्पष्ट अंत नहीं। किसी को भी—Anthropic के उन शोधकर्ताओं सहित जो इस पर सबसे कठिन सोचते हैं—यह पता नहीं कि वक्र कितना खड़ा होगा या कहाँ समतल होगा।
यह अनिश्चितता शासन को एक साथ अधिक जरूरी और अधिक कठिन बना देती है। मुख्य चुनौती है सार्थक पर्यवेक्षण को बनाए रखना यदि एआई-जनित शोध मानवीय समीक्षा से तेज़ होने लगे। सक्रिय प्रस्तावों और शोध क्षेत्रों में परिनियोजन से पहले क्षमताओं का मूल्यांकन, मॉडल कंटेनमेंट दृष्टिकोण, एआई विकास में शामिल प्रणालियों पर एक्सेस कंट्रोल, एआई R&D गतिविधि की निगरानी, परिणामकारी कार्रवाइयों के लिए मानवीय मंजूरी आवश्यकताएँ, स्वतंत्र मूल्यांकन, और फ्रंटियर एआई लैब्स के बीच समन्वय शामिल हैं।
इनमें से कोई भी पूर्ण समाधान नहीं है, और कॉक्सन बहस यही रेखांकित करती है: आज की एआई-भागीदारी के स्तर के लिए बनाए गए शासन ढाँचे संभव है कि कल के लिए स्केल न हों। जहाँ औज़ार हैं और जहाँ तकनीक जा रही है—इनके बीच का अंतर ही इस क्षण को उनके लिए वास्तविक रूप से निर्णायक महसूस कराता है जो इसके सबसे करीब काम कर रहे हैं।
Recursive self-improvement एक ऐसे फीडबैक लूप का वर्णन करता है जिसमें एआई अधिक सक्षम एआई बनाने में योगदान देता है, जो फिर बाद के सुधारों में योगदान देने में और बेहतर हो सकता है। कहना सरल, आकलन करना सचमुच अनिश्चित।
आज का एआई-सहायता प्राप्त विकास वास्तविक है और बढ़ रहा है, जैसा कि Anthropic का अपना शोध स्पष्ट करता है। पूर्ण स्वायत्त RSI, जिसमें एआई प्रणालियाँ बिना मानवीय निर्देशन के अपने उत्तराधिकारियों को बड़े पैमाने पर डिज़ाइन और विकसित करती हैं, हासिल नहीं हुआ है। Anthropic खुद यही रेखा मानता है। इन दोनों के बीच का अंतर ही वह जगह है जहाँ सभी रोचक और विवादित प्रश्न हैं: यह कितनी जल्दी घट रहा है, यदि घटता है तो क्या होता है, और गति तय करने का अधिकार किसके पास है?
कॉक्सन-हबिंगर का आदान-प्रदान इन सवालों को पैदा नहीं करता। इसने इन्हें काल्पनिक मानना असंभव कर दिया। चाहे आपको कॉक्सन की समय-रेखा चिंताजनक लगे या Anthropic का फ्रेमिंग अधिक संतुलित, अंतर्निहित गतिशीलता एक ही है: एआई, एआई बनाने वाले लूप के भीतर तेजी से आ रहा है। इसका अर्थ क्या है—स्पष्टता से और किसी भी दिशा में अतिशयोक्ति के बिना—यही वजह है कि RSI के बारे में जानना सार्थक है।
DataCamp के साथ एआई सीखें
course
course
course