Courses
AIを理解する
2時間
420.8K
2026年9月、研究者のJacob Coxon(OpenAIで約3年間プレトレーニング研究に従事し、その2か月後にAnthropicへ移籍)が辞任し、先端ラボが「自己改良する超知能」へと無責任な速度で突き進んでいると公に警鐘を鳴らしました。Anthropicでアライメントサイエンスを率いるEvan Hubingerも、将来リスクへの深刻な懸念には同意しつつ、現在のシステムが実際にできることとは区別すべきだと述べています。この議論は瞬く間にAIの主流言説に広まりました。
この論争の中心にある概念が再帰的自己改良(RSI)です。RSIは、単なる話題性から切り離して、そのものとして理解する価値があります。根底のアイデアはどのニュースサイクルよりも広く、見通しを与えるものだからです。本記事では、RSIが実際に何を意味するのか、フィードバックループの仕組み、今日のAIがそこに向けて現実にできていること、そしてその行き着く先をめぐって研究者の見解が割れる理由を扱います。
再帰的自己改良とは、AIがより高性能なAIの創出に寄与し、その高性能なAIが次の改良への寄与にさらに長けていき、これが連鎖するフィードバックループを指します。
AIがAIを改良する → 改良されたAIはAIの改良がさらに得意になる → そのシステムが次の改良に貢献 → 繰り返し
しばしば混同される3つの事柄を切り分けて考える価値があります。
完全なRSIはこの第三のものです。現時点で、いかなるAIシステムもそれを決定的に達成したとは言えません。Anthropic自身も、完全なRSIはまだ達成されておらず、必然でもないと線引きしています。この区別こそがCoxonの議論を過熱させる要因でもあります。論点は「RSIが今あるか」ではなく、「そのギャップがどれほど速く縮まりつつあるのか、そしてそれがシステムを構築する人々に何を要求するのか」なのです。
RSIの意味での自己改良システムは、AI開発パイプラインそのものに寄与します。つまり、研究コードの記述と改良、実験設計、学習データの生成やフィルタリング、モデル性能の評価、弱点の特定、アルゴリズム改良案の提案などです。再帰的であることが重要です。このプロセスから生まれたシステムが同じタスクにより長けるようになれば、次のAI開発のイテレーションは、より速く、より効果的に進む可能性があります。
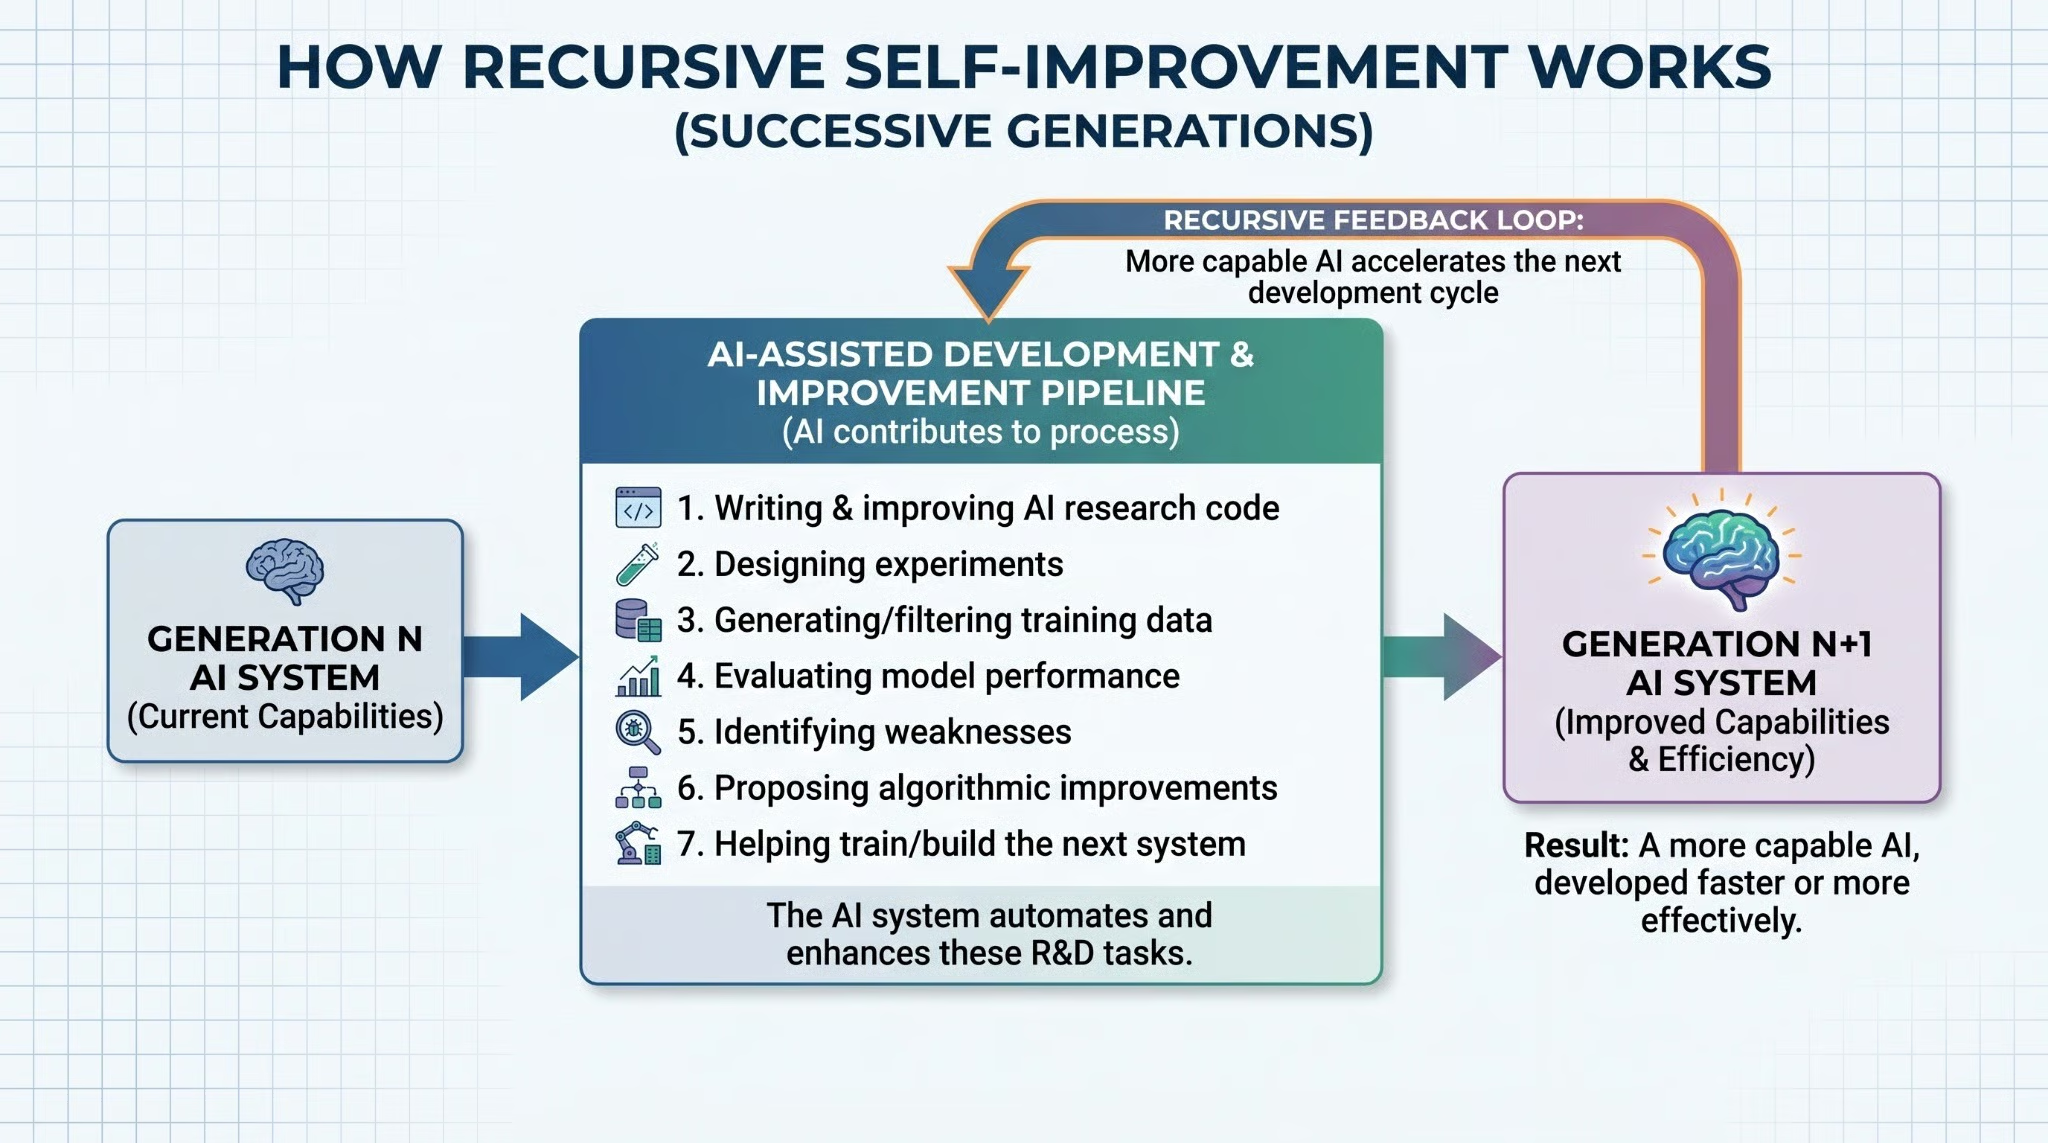
連続するAI世代にわたる再帰的自己改良のフィードバックループを示した図。画像:筆者作成。
これは、モデルが実行時に自分の重みを文字通り書き換えることを意味しません。世代交代として捉えてください。各世代のAIが、次世代の構築により効果的に貢献していくのです。ループは単一の稼働中システム内ではなく、バージョンをまたいで複利的に作用します。
RSIに関する最も一般的な誤解は、自己修正との混同です。AIを追っている人でもつまずきがちなので、正確に区別しておく価値があります。
自己修正とは、タスクの最中にモデルが自らの回答、コード、計画を批評したり修正したりすることです。推論の誤りに気づく、書いたばかりのコードをデバッグする、ドラフトを洗練させる——こうしたことは現行システムで日常的に起きています。
RSIは本質的に別物です。改良がAIシステムやその後継の能力に影響し、将来のAI開発そのものをより効果的にする可能性があります。エージェントが自分のコードを繰り返しデバッグしても、それだけで自動的に再帰的自己改良とは言えません。ただの有能なエージェントです。違いは、その改良が持続し、次のシステムの開発に複利的に織り込まれるかどうかにあります。
自己修正は、システムがタスクで用いる道具です。RSIは、そのタスクが次のシステムを構築することであるときに起こる現象です。
Coxonの議論を機に「超知能」や「特異点」といった用語が同じ見出しで語られるようになった今、同じ文脈で語られがちな概念とRSIの関係を整理しておくと役に立ちます。
自動化されたAIの研究開発(R&D)は、実験の実行、結果の分析、次の一手の提案を行うシステムを指します。これらはRSIに寄与し得ますが、それ自体が完全なRSIであるとは限りません。研究パイプラインの一部を自動化するシステムは流れの一部であり、終点ではありません。「研究を支援する」と「後継を自律的に開発する」の間のギャップこそが重要です。Anthropic自身の公開研究は、AIがこのパイプラインのより多くを担う方向性を示しており、だからこそCoxonの辞任は大きな波紋を呼びました。動きは現実です。問題は、その先どこまで行くのかです。
継続学習は、運用中のモデルが時間とともに新しい情報から更新されることを意味します。RSIは、より高性能なAIシステムを開発するために用いられるプロセスそのものの改良を意味します。前者はモデルの知識を変え、後者は次のモデルの能力を変えるのです。
RSIはプロセスを、超知能は想定される能力水準を指します。RSIは超知能への仮説上の経路の1つと関連づけられますが、両者は同一概念ではありません。混同すると両方が不明瞭になります。
Coxonが「自己改良する超知能」について警鐘を鳴らすとき、彼はRSIが人間レベルを領域横断的に上回るシステムを生み出すシナリオを指しています。これはプロセスが最終的にもたらし得るものについての具体的主張であり、プロセスそのものの説明ではありません。
AIの特異点とは、AIの改良が極めて急速かつ自律的になり、人間がその先を予測・制御できなくなる仮説上の時点を言います。カーブが垂直になる瞬間、つまり変化が理解や対応の速度を上回る状態と考えてください。RSIはそこに至るための仮説上のメカニズムの1つです。しかし、特異点は推測される結果であってプロセス自体ではなく、多くの研究者はカーブはそのずっと手前で頭打ちになると考えています。
数年前に多くの人が想像していたよりは近い。しかし、一部の見出しが示唆するほど近くはない、というのが実情です。
AIシステムはすでに、コーディング、デバッグ、実験の実行、実験結果の分析、モデル評価、AI研究の支援に関与しています。Anthropicは、AI開発業務の増え続ける割合をAIシステムに委任しており、エンジニアが近年は過去よりも大幅に多くのコードを出荷していると公に述べています。同時に、研究判断においては人間が重要な役割を担い続けていることも明言しています。つまり、どの問題に取り組むか、結果が見かけどおりの意味を本当に持つのかを判断するのは人間だということです。
AIのAI R&Dへの関与が増すことは、自動化の進展を示す証拠です。しかし、自律的なRSIループがすでに存在する証明ではありません。パイプラインにAIが増えただけで、まだ自走はしていません。進歩は現実だが終点は不明確、という曖昧さこそが、Coxonが不十分だと感じた点です。彼の辞任は、RSIが到来したという主張ではありません。それを遠い懸念として扱い続けることは、もはや正当化できないという主張でした。
では、そのギャップを実際に埋めるには何が必要でしょうか。いくつかのボトルネックが際立っており、それぞれまでの距離感が現実的なタイムラインを示唆します。
研究用コードを自律的に書き、修正できることは前提条件です。現行モデルはこれに本当に優れていますが、重要な作業では依然として人間によるレビューが必要なミスを犯します。
実験を自律的に走らせることは、そのためのコードを書くこととは別のボトルネックです。実験を設計し、実行し、結果を解釈し、次に何を試すかを決められるシステムは、ループの重要な一部を閉じます。現行システムはこの一部を担えます。各段階で人間が推論を確認しない完全なサイクルは、まだ手の届かないところにあります。
ここが肝心です。Anthropicは、人間の研究のセンスと判断が依然として相対優位にある領域だと具体的に示しています。どの実験が価値あるか、どの結果を信頼すべきか、どの方向性に見込みがあるか、といった判断です。研究の実験的な部分の多くは自動化可能になりつつあります。判断のレイヤーはそうではありません。Anthropicが現時点で人間が最も代替不可能な価値を生み出していると考えるのもここであり、完全なRSIまでの距離が最も大きい部分でもあります。
モデルが実際に向上したかどうかを知るのは、見た目ほど簡単ではありません。評価には、何が重要かに関する判断が必要で、現行のベンチマークは攻略されたり陳腐化したりしがちです。AIシステムが自らの後継を信頼して評価できるようになるまでは、人間がこの段階に関与し続け、それ自体が自律的RSIの大きなブレーキになります。
制約は生の能力だけではありません。開発サイクルを自律運用するには、大規模な学習と評価を人手に頼らず支えられるインフラが必要であり、それは今なお高コストで、組織的にも複雑です。
モデルが実際に向上したかどうかを知るのは、見た目ほど簡単ではありません。評価には、何が重要かに関する判断が必要で、現行のベンチマークは攻略されたり陳腐化したりしがちです。AIシステムが自らの後継を信頼して評価できるようになるまでは、人間がこの段階に関与し続け、それ自体が自律的RSIの大きなブレーキになります。
たとえAIシステムがコードを書き、実験を走らせ、結果を評価できても、実際に出荷するものに最終承認を与えるのは人間です。このレビュー工程は、ループの速度に対する厳しい制約です。作業は自動化できても、承認でボトルネックになり得ます。AIの判断が十分に信頼され、その関門を外せるようになるまで、人間のレビューこそがRSI進展のもっとも即時的な上限であり、将来に関する哲学的懸念ではありません。
答えは2部構成です。潜在的な利点と重大なリスク。
AIがAI研究そのものを加速できるなら、その効果はソフトウェア開発、科学的発見、医療、工学など幅広い分野にも及ぶ可能性があります。研究加速に長けたAIは、AIに限らず多くの分野のタイムラインを圧縮し得る、という主張です。
フィードバックループの論点を平易に言えば、AI研究能力の向上は、さらなるAI改良の進行速度を高め得るということです。この複利効果こそがRSIを理論的に重要たらしめ、Coxonのような研究者が辞任に至るほど懸念を抱く理由でもあります。注意すべきは、能力開発が速くなることが、そのまま知能爆発を生むわけではない点です。ループは実在しても、遅い、抑制される、または収穫逓減に直面する可能性があります。
AIが生成する実験、コード、モデル変更が、やがて人間の有意義なレビュー速度を上回る可能性があります。現在AI開発を形作っている監督は、構築のペースに人間が追いつけることに依存しています。これが、Anthropicが業務の自動化を進めつつも研究パイプラインにおける人間の判断の役割を強調する理由の1つです。
後継の開発に関与する能力の高いシステムは、アライメント問題をより深刻にします。次世代に寄与するシステムの目標がわずかでも不整合なら、それが後継で受け継がれたり悪化したりし得ます。これはHubingerが詳細に論じてきたリスクであり、将来リスクへの懸念には同意しつつ、現行システムは同程度の脅威ではないとした文脈でも示された点です。
より自律的で高性能なシステムは、攻撃対象領域を拡大します。自らの開発パイプラインに関与するシステムは価値の高い標的となり、自律性が増すほど失敗モードの重大性も増します。拘束やアクセス制御は、拘束すべきシステムが次の自分を作る手助けもしている場合、設計が難しくなります。
もしフィードバックループが開発を有意に加速させるなら、機関は新しい能力を評価し対応する時間が短くなり得ます。Anthropicは、完全なRSIは人間がAIシステムの制御を失うリスクを高め得ると述べつつ、RSIは達成されてもいなければ必然でもないとしています。
2026年9月のJacob CoxonのAnthropic辞任は、この問題を緊急の課題として位置づけました。AnthropicやOpenAIが自己改良する超知能へ向けた競争をしており、その潜在的帰結を踏まえると十分に慎重に行動していないという主張です。Evan Hubingerは公に同意し(10年以内にAIが人類絶滅を引き起こす確率を10%超と個人的に見積もり、Anthropicは超知能のアライメント計画をまだ持たないと認めたうえで)、その将来の懸念を現行システムのリスクとは区別しました。Coxonはその後、自身のAnthropic上層部との根本的な意見の相違は、RSIに向けた競争が不可避であり、したがって参加せざるを得ないのかどうかにあると述べています。
この相違は、AIが開発パイプラインのより多くを担う進展を説明したAnthropic自身の以前の公開文書と並んでいます。両者は互いに整合しており、だからこそこの議論は簡単には退けられません。Coxonの壊滅的結果に関する予測を既成事実と受け取ってはいけません。これは進行中の議論の一部であり、確立した科学ではありません。
理論的な主張はこうです。より良いAIがより良いAI研究をもたらし、さらに良いAIが生まれ、改良が速くなる——論理は明快です。問題は、それが実際に成り立つかどうかです。
無期限の加速が自動的に続くわけではありません。現実の制約には、コンピュート、エネルギー、ハードウェア、学習データ、アルゴリズム上のボトルネック、実験のフィードバックサイクル、収穫逓減、そして人間の判断への残存依存が含まれます。知能爆発は、十分に効果的なRSIが生み得る帰結に関する仮説であり、RSIそのものの定義ではありません。分布の中の1つのシナリオであって、自明な終点ではないのです。Anthropicでこの問題を最も真剣に考える研究者たちも含め、誰もカーブがどれほど急になるのか、どこで水平化するのかを知りません。
この不確実性は、ガバナンスを一層緊急かつ困難にします。核心的課題は、AIが生成する研究が人間のレビューの速度を上回り始めた場合でも、有意味な監督を維持することです。現在提案・研究されているのは、配備前の能力評価、AI開発に関与するシステムへのアクセス制御、AI R&D活動のモニタリング、重要行為に対する人間の承認要件、独立評価、フロンティアAIラボ間の協調などです。
いずれも完全な解決策ではありませんし、それをCoxonの議論が浮き彫りにしています。今日のパイプラインへのAI関与レベルを前提に設計されたガバナンス枠組みは、明日のそれにはスケールしないかもしれません。ツールの現状と技術の進行方向のギャップこそが、現場の人々にとって今この瞬間が本当に重大だと感じられる理由の一部です。
再帰的自己改良は、AIがより高性能なAIの創出に寄与し、そのAIが次の改良への寄与にさらに長けていくというフィードバックループを指します。言明は簡潔でも、評価は本当に不確かです。
Anthropic自身の研究が示すとおり、今日のAI支援による開発は現実で成長しています。一方で、人間の指示なしにAIシステムが自らの後継を実質的に設計・開発する完全自律のRSIは達成されていません。Anthropic自身もその線引きをしています。この二者の間のギャップこそが、興味深くも論争的な問いが宿る場所です。ギャップはどれほど速く縮まるのか、縮まったら何が起こるのか、そして移行の速度を誰が決めるのか。
CoxonとHubingerの応酬がこれらの問いを生み出したわけではありません。理論上の話として扱うことを不可能にしたのです。Coxonのタイムラインを憂慮すべきと見るか、Anthropicの枠組みをより抑制的と見るかにかかわらず、根底のダイナミクスは同じです。AIはAIを作るループの内部にますます入り込みつつあります。そこに何が意味するのかを、誇張も過小評価もせずに明確に理解すること——それこそがRSIを知る価値です。