

1. เปิด RunPod Jupyter Notebook
สร้างพ็อด RunPod ใหม่ด้วย GPU NVIDIA H100 และเลือกเทมเพลต PyTorch/Jupyter กำหนดค่า พื้นที่จัดเก็บถาวรอย่างน้อย 100 GB เพื่อป้องกันไม่ให้ไฟล์โมเดลและผลลัพธ์การฝึกหายไปเมื่อพ็อดหยุดทำงาน
เพิ่มโทเค็นเข้าถึง Hugging Face เป็นตัวแปรสภาพแวดล้อม:
HF_TOKEN=your_hugging_face_token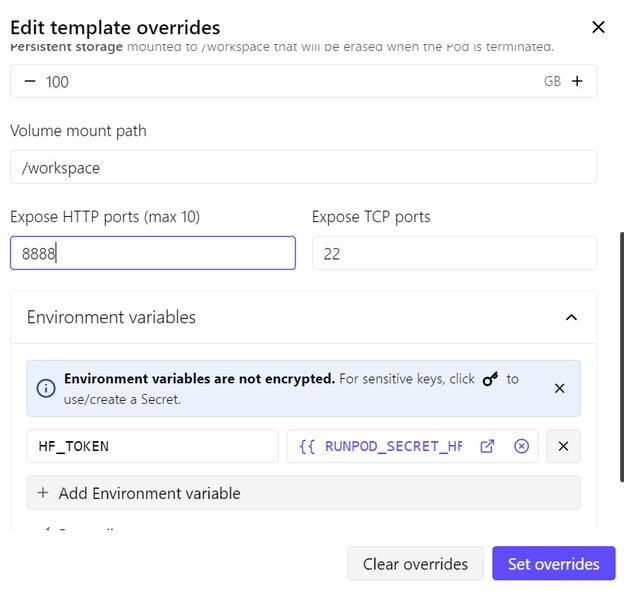
วิธีนี้ช่วยให้ดาวน์โหลดโมเดลและชุดข้อมูลได้เร็วขึ้น และให้อัปโหลดตัวปรับ LoRA ที่บันทึกไว้ไปยัง Hugging Face ได้โดยไม่ต้องเข้าสู่ระบบจากโน้ตบุ๊กด้วยตนเอง
พ็อดที่กำหนดค่าควรมีค่าใช้จ่ายประมาณ 3 ดอลลาร์ต่อชั่วโมง ทั้งนี้ราคาสุดท้ายอาจแตกต่างกันตามความพร้อมใช้งานของ GPU และประเภทพ็อดที่เลือก
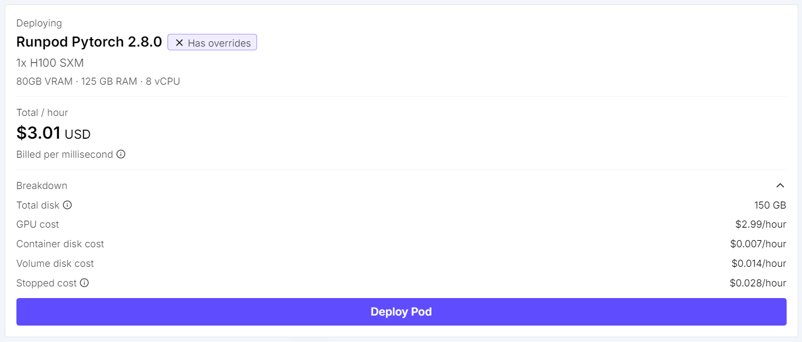
เมื่อพ็อดทำงานแล้ว ให้เปิด JupyterLab หรือ Jupyter Notebook จากอินเทอร์เฟซ RunPod และสร้างโน้ตบุ๊กใหม่ชื่อ diffusiongemma_pubmedqa.ipynb
2. ติดตั้งแพ็กเกจที่จำเป็น
รันคำสั่งต่อไปนี้ในเซลล์แรกของโน้ตบุ๊กเพื่อติดตั้ง Unsloth และไลบรารีที่ต้องใช้สำหรับโหลด ปรับแต่ง และบันทึก DiffusionGemma
%%capture
%pip install --upgrade pip wheel setuptools packaging ninja
%pip install unsloth
%pip install --no-deps --upgrade --force-reinstall git+https://github.com/unslothai/unsloth-zoo.git git+https://github.com/unslothai/unsloth.git
%pip install sentencepiece protobuf "datasets==4.3.0" "huggingface_hub>=0.34.0" hf_transfer
%pip install --no-deps bitsandbytes accelerate peft trl triton
%pip install --no-deps --upgrade "torchao>=0.16.0"
%pip install --no-deps transformers==5.11.0 "tokenizers>=0.22.0,<=0.23.0"คำสั่ง %%capture จะซ่อนเอาต์พุตการติดตั้งที่ยาว แพ็กเกจถูกตรึงเวอร์ชันเพื่อหลีกเลี่ยงปัญหาความเข้ากันได้ระหว่าง DiffusionGemma, Transformers, Unsloth และไลบรารีการฝึก
เมื่อการติดตั้งเสร็จสิ้น ให้รีสตาร์ตเคอร์เนลของโน้ตบุ๊กก่อนดำเนินการต่อ
3. นำเข้าไลบรารี
นำเข้าไลบรารีที่ต้องใช้สำหรับการเตรียมชุดข้อมูล การโหลดโมเดล การฝึก และการประเมินผล
import copy
import os
import random
import time
import torch
from datasets import load_dataset
from unsloth import FastModel
os.environ["HF_HUB_ENABLE_HF_TRANSFER"] = "1"
torch._dynamo.config.recompile_limit = 64
print("Torch:", torch.__version__)
print("CUDA available:", torch.cuda.is_available())
print(
"GPU:",
torch.cuda.get_device_name(0)
if torch.cuda.is_available()
else "None",
)HF_HUB_ENABLE_HF_TRANSFER ช่วยให้ดาวน์โหลดจาก Hugging Face Hub ได้เร็วขึ้น ขณะที่การเพิ่มขีดจำกัดการคอมไพล์ซ้ำของ Dynamo ช่วยป้องกันการหยุดชะงักระหว่างทำงานกับโมเดล
เมื่อเซลล์รันสำเร็จ Unsloth จะปรับสภาพแวดล้อมการฝึก และเอาต์พุตควรยืนยันว่า CUDA พร้อมใช้งานและตรวจพบ GPU H100 แล้ว
🦥 Unsloth: Will patch your computer to enable 2x faster free fine-tuning.
🦥 Unsloth Zoo will now patch everything to make training faster!
Torch: 2.10.0+cu128
CUDA available: True
GPU: NVIDIA H100 80GB HBM34. ตั้งค่าคอนฟิก
กำหนดค่าโมเดล ชุดข้อมูล พารามิเตอร์การฝึก การตั้งค่าการประเมินผล และไดเรกทอรีเอาต์พุตไว้ในที่เดียว
MODEL_NAME = "unsloth/diffusiongemma-26B-A4B-it"
DATASET_NAME = "qiaojin/PubMedQA"
TRAIN_SUBSET = "pqa_artificial"
EVAL_SUBSET = "pqa_labeled"
N_TRAIN = 3000
N_EVAL = 200
MAX_CONTEXT_CHARS = 2500
STEPS = 60
GRAD_ACCUM = 4
LR = 1e-4
T_LO = 0.1
EVAL_TOTAL = 50
EVAL_DENOISING_STEPS = 16
OUTPUT_DIR = "diffusiongemma_pubmedqa_lora"เราจะใช้ตัวอย่างแบบประดิษฐ์ 3,000 ตัวอย่างสำหรับการฝึก และตัวอย่างที่ติดฉลากด้วยมือ 200 ตัวอย่างสำหรับการประเมินผล เพื่อให้การทดลองเร็วขึ้น โมเดลจะฝึก 60 สเต็ป และประเมิน 50 ตัวอย่างโดยใช้ 16 ขั้นตอนการลบสัญญาณรบกวน
การทำงานของ DiffusionGemma
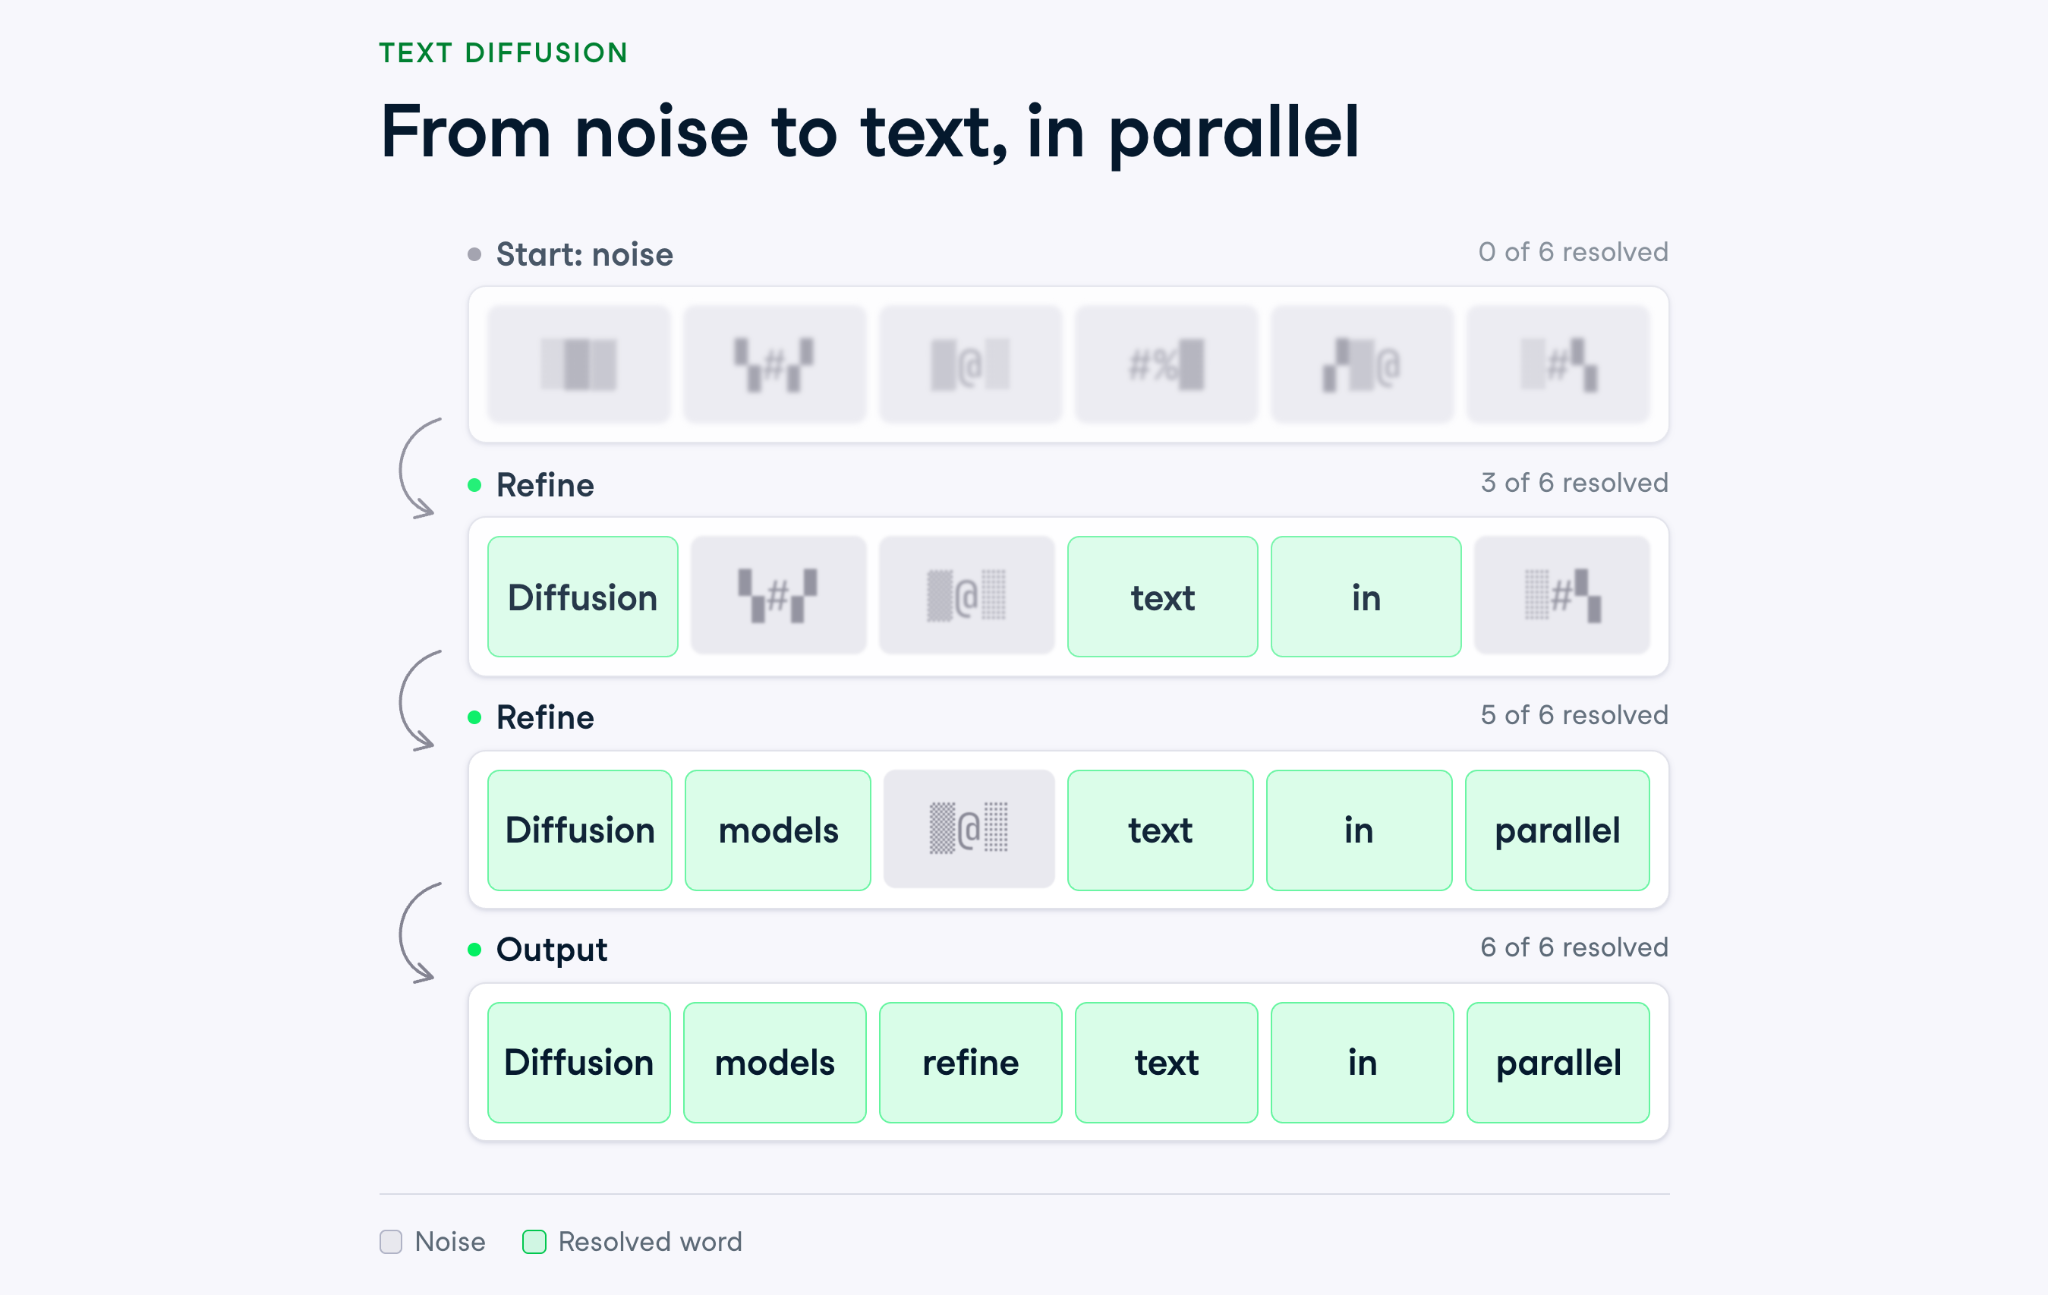
ก่อนโหลดโมเดล ควรจินตนาการว่าจริง ๆ แล้ว DiffusionGemma สร้างคำตอบอย่างไร แทนที่จะเขียนโทเค็นต่อเนื่องกันทีละตัว มันจะเริ่มจากผืนผ้าใบโทเค็นความยาวคงที่และค่อย ๆ ปรับให้ดีขึ้นผ่านหลายขั้นตอนการลบสัญญาณรบกวน โดยอัปเดตหลายตำแหน่งพร้อมกันจนข้อความกลายเป็นคำตอบที่สอดคล้องกัน
โค้ดด้านล่างรายงานความยาวผืนผ้าใบเป็น 256 ซึ่งเป็นขนาดของหนึ่งบล็อก สำหรับคำตอบสั้น ๆ แบบ yes/no/maybe ผืนผ้าใบเดียวก็เพียงพอ ส่วนผลลัพธ์ที่ยาวกว่าจะถูกสร้างโดยเชื่อมผืนผ้าใบเข้าด้วยกันทีละบล็อก ไดอะแกรมด้านล่างแสดงกระบวนการปรับละเอียดนี้ในภาพรวม:
5. โหลด DiffusionGemma
โหลดโมเดล DiffusionGemma ที่ปรับจูนด้วยคำสั่ง (instruction-tuned) ในความแม่นยำ bfloat16 เราจะไม่ใช้การควอนไทซ์ 4 บิต เพราะ GPU H100 มีหน่วยความจำมากพอที่จะโหลดโมเดลด้วยความแม่นยำที่สูงกว่า
model, tokenizer = FastModel.from_pretrained(
model_name=MODEL_NAME,
dtype=torch.bfloat16,
load_in_4bit=False,
)
processor = tokenizer
tok = processor.tokenizer if hasattr(processor, "tokenizer") else processor
vocab = model.config.text_config.vocab_size
canvas_len = model.config.canvas_length
dev = next(
(p.device for p in model.parameters() if p.device.type != "meta"),
torch.device("cuda"),
)
print("Vocab size:", vocab)
print("Canvas length:", canvas_len)
print("Model device:", dev)ขนาดคลังคำจะใช้ตอนเพิ่มสัญญาณรบกวนแบบสุ่มระหว่างการฝึกแบบ diffusion ส่วนความยาวผืนผ้าใบกำหนดจำนวนโทเค็นสูงสุดที่โมเดลสามารถปรับให้ดีขึ้นได้ในหนึ่งบล็อกของการสร้างผลลัพธ์
ควรเห็นเอาต์พุตประมาณนี้:
Vocab size: 262144
Canvas length: 256
Model device: cuda:06. เพิ่มตัวปรับ LoRA
เพิ่มตัวปรับ LoRA เพื่อให้ฝึกเฉพาะพารามิเตอร์ส่วนเล็ก ๆ ที่เพิ่มเข้ามา แทนการอัปเดตโมเดลฐาน 26 พันล้านพารามิเตอร์ทั้งหมด
model = FastModel.get_peft_model(
model,
r=64,
lora_alpha=128,
use_gradient_checkpointing=False,
)วิธีนี้ช่วยลดหน่วยความจำและการคำนวณที่ต้องใช้ในการปรับแต่งได้มาก ปิดการใช้งาน gradient checkpointing เพราะ H100 มีหน่วยความจำ GPU เพียงพอสำหรับการทดลองนี้
7. โหลด PubMedQA
โหลดชุดย่อย PubMedQA แบบประดิษฐ์สำหรับการฝึก และชุดย่อยที่ติดฉลากด้วยมือสำหรับการประเมินผล
train_data = load_dataset(
DATASET_NAME,
TRAIN_SUBSET,
split="train",
)
eval_data = load_dataset(
DATASET_NAME,
EVAL_SUBSET,
split="train",
)
print("Train size:", len(train_data))
print("Eval size:", len(eval_data))
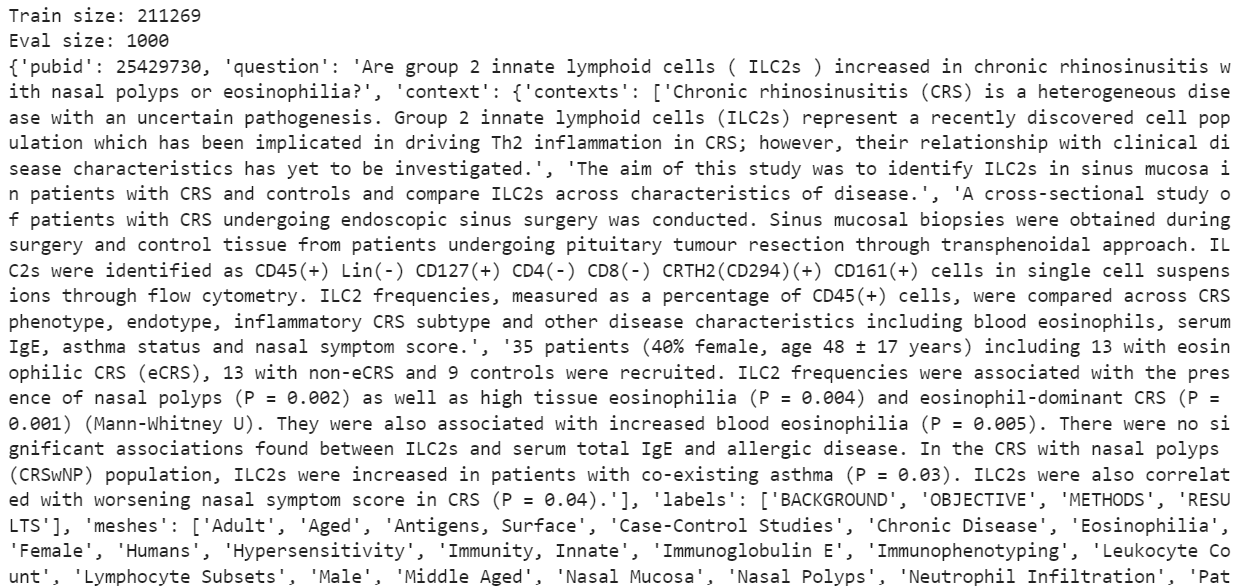
print(train_data[0])ชุดย่อยสำหรับฝึกมีตัวอย่างที่สร้างขึ้นโดยอัตโนมัติ ขณะที่ชุดย่อยสำหรับประเมินมีคำถามด้านชีวการแพทย์ที่ผู้เชี่ยวชาญติดฉลากไว้
การพิมพ์แถวแรกช่วยให้ตรวจสอบคำถาม บริบทจากบทคัดย่อ และคำตัดสินสุดท้ายก่อนจัดรูปแบบข้อมูล
ควรเห็นว่า:
Train size: 211269
Eval size: 1000แต่ละตัวอย่างประกอบด้วยคำถามด้านชีวการแพทย์ หนึ่งหรือหลายย่อหน้าบริบทจากบทคัดย่อ และคำตอบสุดท้ายเป็น yes, no หรือ maybe
8. แปลงชุดข้อมูล
แปลงแต่ละตัวอย่าง PubMedQA ให้อยู่ในรูปแบบสไตล์แชตที่มีพรอมต์จากผู้ใช้และคำตอบของผู้ช่วย
def make_prompt(row):
context = " ".join(row["context"]["contexts"])
context = context[:MAX_CONTEXT_CHARS]
question = row["question"]
return f"""Answer the biomedical research question using only the context.
Context:
{context}
Question:
{question}
Answer with only one word: yes, no, or maybe."""
def make_answer(row):
return row["final_decision"].strip().lower()
def convert_row(row):
answer = make_answer(row)
if answer not in ["yes", "no", "maybe"]:
return None
return {
"messages": [
{"role": "user", "content": make_prompt(row)},
{"role": "assistant", "content": answer},
]
}
train_rows = []
for row in train_data.select(range(N_TRAIN)):
item = convert_row(row)
if item is not None:
train_rows.append(item)
eval_rows = []
for row in eval_data.select(range(N_EVAL)):
item = convert_row(row)
if item is not None:
eval_rows.append(item)
print("Prepared train examples:", len(train_rows))
print("Prepared eval examples:", len(eval_rows))
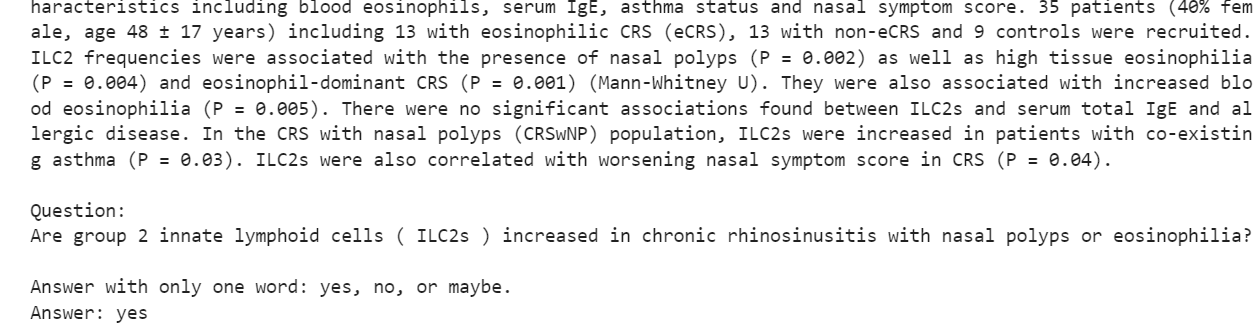
print(train_rows[0]["messages"][0]["content"])
print("Answer:", train_rows[0]["messages"][1]["content"])ย่อหน้าบริบทจะถูกผสานเป็นสตริงเดียวและจำกัดไว้ที่ 2,500 อักขระเพื่อให้ควบคุมอินพุตได้ง่ายขึ้น แต่ละคำตอบถูกแปลงเป็นตัวพิมพ์เล็ก และตัวอย่างที่มีฉลากนอกเหนือจาก yes, no หรือ maybe จะถูกลบออก
การพิมพ์ตัวอย่างแรกที่แปลงแล้วช่วยยืนยันว่าบริบท คำถาม และคำตอบถูกจัดรูปแบบถูกต้องก่อนการฝึก
9. สร้างตัวอย่างการฝึกแบบ Diffusion
DiffusionGemma ต้องการให้วางคำตอบเป้าหมายไว้ภายในผืนผ้าใบความยาวคงที่ ฟังก์ชันนี้จะโทเคไนซ์พรอมต์ แปลงคำตอบเป็น ID ของโทเค็น เติมให้ครบตามความยาวผืนผ้าใบของโมเดล และสร้างมาสก์ที่แสดงว่าโทเค็นใดควรร่วมคำนวณค่า loss
eos = model.generation_config.eos_token_id or [1]
eos = eos[0] if isinstance(eos, (list, tuple)) else eos
pad = tok.pad_token_id if tok.pad_token_id is not None else eos
def build_examples(rows):
examples = []
for row in rows:
user_message = row["messages"][0]
assistant_message = row["messages"][1]
prompt_ids = processor.apply_chat_template(
[user_message],
tokenize=True,
add_generation_prompt=True,
return_tensors="pt",
)[0]
answer_ids = tok.encode(
assistant_message["content"],
add_special_tokens=False,
)
content = answer_ids + [eos]
n = len(content)
if n > canvas_len:
continue
x0 = torch.tensor(
content + [pad] * (canvas_len - n),
dtype=torch.long,
)
loss_mask = torch.zeros(canvas_len, dtype=torch.bool)
loss_mask[:n] = True
examples.append((prompt_ids, x0, loss_mask))
return examples
examples = build_examples(train_rows)โทเค็นจบลำดับจะถูกเพิ่มหลังแต่ละคำตอบ ส่วนตำแหน่งที่เหลือของผืนผ้าใบจะเติมด้วยโทเค็น padding มาสก์ loss รับประกันว่าการฝึกจะโฟกัสเฉพาะโทเค็นคำตอบและโทเค็นจบลำดับ ไม่ใช่ตำแหน่งที่ถูกเติม
10. สร้างฟังก์ชันทำอนุมานและประเมินผล
ถัดไป กำหนดฟังก์ชันที่ใช้ในการสร้างคำตอบ ทำความสะอาดเอาต์พุตของโมเดล และคำนวณความแม่นยำในการประเมิน
สร้างคำตอบ
ฟังก์ชัน answer_question() จะจัดรูปแบบพรอมต์ สร้างคำตอบผ่านหลายขั้นตอนการลบสัญญาณรบกวน และถอดรหัสโทเค็นที่สร้างเป็นข้อความ
def answer_question(prompt, steps=64):
input_ids = processor.apply_chat_template(
[{"role": "user", "content": prompt}],
tokenize=True,
add_generation_prompt=True,
return_tensors="pt",
).to(dev)
gen_config = copy.deepcopy(model.generation_config)
gen_config.max_denoising_steps = steps
gen_config.max_new_tokens = canvas_len
model.eval()
with torch.no_grad():
output = model.generate(
input_ids=input_ids,
generation_config=gen_config,
)
generated = output.sequences[0, input_ids.shape[1]:]
text = tok.decode(
generated.tolist(),
skip_special_tokens=True,
)
return text.strip().lower()สกัดการทำนาย
แม้พรอมต์จะขอคำตอบแบบคำเดียว แต่บางครั้งโมเดลอาจสร้างข้อความเพิ่มเติม ฟังก์ชันนี้จะดึงเอาการทำนาย yes, no หรือ maybe ที่ถูกต้องคำแรกออกมา
def clean_prediction(text):
text = text.lower().strip()
if text.startswith("yes"):
return "yes"
if text.startswith("no"):
return "no"
if text.startswith("maybe"):
return "maybe"
words = text.replace(".", " ").replace(",", " ").split()
for word in words:
if word in ["yes", "no", "maybe"]:
return word
return "unknown"ประเมินความแม่นยำ
ฟังก์ชันประเมินผลจะเปรียบเทียบการทำนายที่ทำความสะอาดแล้วกับคำตอบที่ถูกต้อง พิมพ์ผลลัพธ์ของแต่ละตัวอย่าง และคืนค่าความแม่นยำโดยรวมพร้อมการทำนายรายตัวอย่าง
def evaluate_model(
rows,
total=50,
steps=64,
title="Evaluation",
):
correct = 0
results = []
total = min(total, len(rows))
print(title)
print("-" * len(title))
for i, row in enumerate(rows[:total], start=1):
prompt = row["messages"][0]["content"]
gold = row["messages"][1]["content"]
raw_pred = answer_question(prompt, steps=steps)
pred = clean_prediction(raw_pred)
is_correct = pred == gold
correct += int(is_correct)
results.append({
"index": i,
"gold": gold,
"prediction": pred,
"raw_prediction": raw_pred,
"correct": is_correct,
})
print(
f"{i:02d}. Gold: {gold} | "
f"Pred: {pred} | Correct: {is_correct}"
)
accuracy = correct / total if total else 0
print()
print("Accuracy:", accuracy)
print()
return {
"accuracy": accuracy,
"correct": correct,
"total": total,
"results": results,
}11. ประเมินโมเดลก่อนการปรับแต่ง
รันการประเมินก่อนการฝึกเพื่อกำหนดค่าพื้นฐาน
before_eval = evaluate_model(
eval_rows,
total=EVAL_TOTAL,
steps=EVAL_DENOISING_STEPS,
title="Before Fine-Tuning Evaluation",
)การประเมินนี้ใช้ 50 ตัวอย่าง โดยคำตอบแต่ละข้อใช้ 16 ขั้นตอนการลบสัญญาณรบกวน ในการทดลองนี้ โมเดลฐานตอบถูก 30 จาก 50 คำถาม
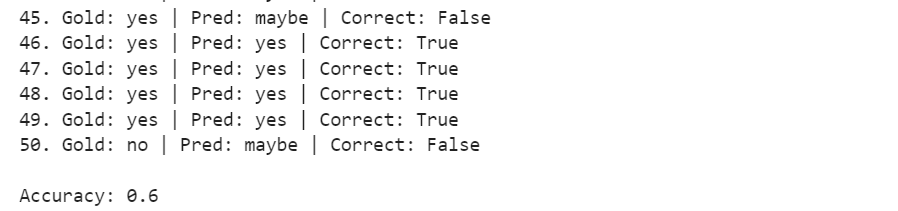
ต่อมาจะนำค่าพื้นฐานนี้ไปเปรียบเทียบกับความแม่นยำหลังการปรับแต่ง
12. ตั้งค่าการฝึก
สลับโมเดลเป็นโหมดฝึก สร้างออปติไมเซอร์และตัวกำหนดตารางอัตราการเรียนรู้ และกำหนดว่าจะแทรกสัญญาณรบกวนเข้าในโทเค็นคำตอบที่สะอาดอย่างไรระหว่างการฝึกแบบ diffusion
model.config.use_cache = True
model.train()
opt = torch.optim.AdamW(
[p for p in model.parameters() if p.requires_grad],
lr=LR,
betas=(0.9, 0.95),
weight_decay=0.0,
)
sched = torch.optim.lr_scheduler.OneCycleLR(
opt,
max_lr=LR,
total_steps=STEPS,
pct_start=0.03,
anneal_strategy="cos",
)ส่งเฉพาะพารามิเตอร์ที่มี requires_grad=True ไปยังออปติไมเซอร์ ซึ่งหมายความว่ากระบวนการฝึกจะอัปเดตตัวปรับ LoRA ไม่ใช่โมเดลเต็ม
ถัดไป สร้างฟังก์ชันการทำให้เสียหายที่สุ่มแทนที่สัดส่วนหนึ่งของผืนผ้าใบคำตอบด้วยโทเค็นแบบสุ่ม
def corrupt(x0):
noise_level = random.uniform(T_LO, 1.0)
xt = x0.to(dev).clone()
noise_mask = (
torch.rand(canvas_len, device=dev) < noise_level
)
xt[noise_mask] = torch.randint(
0,
vocab,
(canvas_len,),
device=dev,
)[noise_mask]
return xt.unsqueeze(0)ระดับสัญญาณรบกวนจะเปลี่ยนไปในแต่ละตัวอย่าง ระหว่างการฝึก โมเดลจะเรียนรู้การกู้คืนคำตอบต้นฉบับจากโทเค็นบนผืนผ้าใบที่ถูกทำให้เสียหายเหล่านี้
13. ฝึกโมเดล
ลูปต่อไปนี้จะฝึกตัวปรับ LoRA เป็นเวลา 60 สเต็ป โดยใช้การสะสมกราเดียนต์
order = list(range(len(examples)))
ptr = 0
start_time = time.time()
opt.zero_grad(set_to_none=True)
for step in range(1, STEPS + 1):
step_loss = 0.0
for _ in range(GRAD_ACCUM):
if ptr >= len(order):
random.shuffle(order)
ptr = 0
prompt_ids, x0, loss_mask = examples[order[ptr]]
ptr += 1
output = model(
input_ids=prompt_ids.unsqueeze(0).to(dev),
canvas_ids=corrupt(x0),
self_conditioning_logits=None,
)
logits = output.logits[0].float()
mask = loss_mask.to(dev)
loss = torch.nn.functional.cross_entropy(
logits[mask],
x0.to(dev)[mask],
)
(loss / GRAD_ACCUM).backward()
step_loss += loss.item() / GRAD_ACCUM
torch.nn.utils.clip_grad_norm_(
[
p
for p in model.parameters()
if p.requires_grad
],
1.0,
)
opt.step()
sched.step()
opt.zero_grad(set_to_none=True)
if step % 20 == 0:
elapsed = time.time() - start_time
print(
f"step {step}/{STEPS} | "
f"loss {step_loss:.4f} | "
f"{elapsed:.0f}s"
)ในแต่ละตัวอย่างฝึก โมเดลจะได้รับพรอมต์ด้านชีวการแพทย์และผืนผ้าใบคำตอบที่ถูกทำให้เสียหาย จะคำนวณ ค่า loss แบบ cross-entropy เฉพาะโทเค็นคำตอบจริงที่เลือกด้วยมาสก์ loss
การสะสมกราเดียนต์จะรวมสี่ตัวอย่างก่อนอัปเดตโมเดล และมีการใช้การตัดกราเดียนต์เพื่อให้การฝึกมีเสถียรภาพ
ในการทดลองนี้ การฝึกเสร็จในเวลาประมาณสองนาที:
step 20/60 | loss 0.0019 | 43s
step 40/60 | loss 0.0003 | 85s
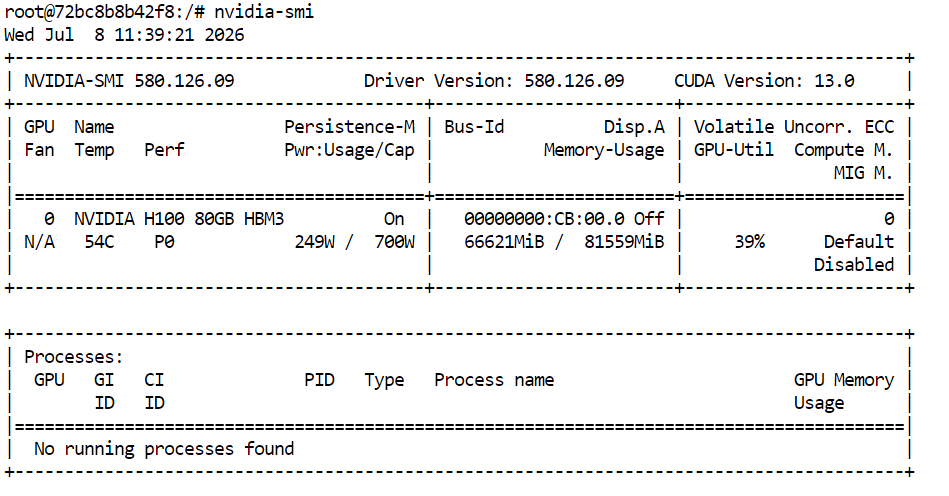
step 60/60 | loss 0.0001 | 126sค่า loss ที่ลดลงอย่างต่อเนื่องบ่งชี้ว่าตัวปรับกำลังเรียนรู้ที่จะกู้คืนคำตอบที่คาดหวังจากผืนผ้าใบที่มีสัญญาณรบกวน ระหว่างการฝึก ยังสามารถรัน nvidia-smi ในเทอร์มินัลของ RunPod เพื่อติดตามการใช้หน่วยความจำและการใช้งาน GPU ได้
14. ประเมินโมเดลที่ปรับแต่งแล้ว
รันการประเมินแบบเดียวกันอีกครั้งหลังการฝึกเพื่อวัดว่าการปรับแต่งทำให้ประสิทธิภาพของโมเดลดีขึ้นหรือไม่
after_eval = evaluate_model(
eval_rows,
total=EVAL_TOTAL,
steps=EVAL_DENOISING_STEPS,
title="After Fine-Tuning Evaluation",
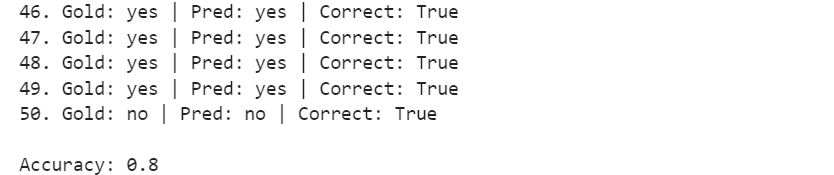
)โมเดลที่ปรับแต่งแล้วจะถูกประเมินบนตัวอย่าง 50 ตัวอย่างเดิม โดยใช้ 16 ขั้นตอนการลบสัญญาณรบกวนเช่นเดียวกับการประเมินค่าพื้นฐาน
จากนั้น เปรียบเทียบความแม่นยำก่อนและหลังการปรับแต่ง
before_accuracy = before_eval["accuracy"]
after_accuracy = after_eval["accuracy"]
improvement = after_accuracy - before_accuracy
print("Before fine-tuning accuracy:", before_accuracy)
print("After fine-tuning accuracy:", after_accuracy)
print("Improvement:", improvement)Before fine-tuning accuracy: 0.6
After fine-tuning accuracy: 0.8
Improvement: 0.2ในการทดลองนี้ ความแม่นยำของโมเดลเพิ่มจาก 0.60 เป็น 0.80
คิดเป็นการเพิ่มขึ้น 20 จุดเปอร์เซ็นต์ โดยโมเดลตอบถูก 40 จาก 50 คำถามหลังการปรับแต่ง เทียบกับ 30 จาก 50 ก่อนการฝึก
15. บันทึกและอัปโหลดตัวปรับที่ปรับแต่งแล้ว
บันทึกตัวปรับ LoRA ที่ฝึกแล้วและไฟล์โปรเซสเซอร์ไปยังไดเรกทอรีเอาต์พุตที่กำหนดไว้ก่อนหน้า
model.save_pretrained(OUTPUT_DIR)
processor.save_pretrained(OUTPUT_DIR)
print(f"Saved LoRA adapter to: {OUTPUT_DIR}")ควรเห็นว่า:
Saved LoRA adapter to: diffusiongemma_pubmedqa_loraการบันทึกนี้จะเก็บเฉพาะตัวปรับ LoRA ที่มีน้ำหนักเบา ไม่ใช่สำเนาโมเดลฐาน 26 พันล้านพารามิเตอร์ทั้งก้อนอีกรอบ
ถัดไป อัปโหลดตัวปรับและไฟล์โปรเซสเซอร์ไปยัง Hugging Face Hub:
REPO_ID = "kingabzpro/diffusiongemma_pubmedqa"
model.push_to_hub(REPO_ID)
processor.push_to_hub(REPO_ID)เนื่องจากตัวแปรสภาพแวดล้อม HF_TOKEN ถูกเพิ่มไว้ตอนกำหนดค่าพ็อด RunPod แล้ว Hugging Face จึงควรยืนยันตัวตนให้โดยอัตโนมัติ ต้องรัน notebook_login() เฉพาะเมื่อยังไม่ได้กำหนดค่าโทเค็นไว้เท่านั้น
from huggingface_hub import notebook_login
notebook_login()หลังการอัปโหลดเสร็จสิ้น ที่เก็บจะมีตัวปรับ LoRA และคอนฟิกของโปรเซสเซอร์ที่จำเป็นต่อการโหลดโมเดลที่ปรับแต่งภายหลัง
แหล่งที่มา: kingabzpro/diffusiongemma_pubmedqa · Hugging Face
บทส่งท้าย
การปรับแต่ง DiffusionGemma ด้วย Unsloth นั้นง่ายเกินคาด ส่วนที่ใช้เวลามากที่สุดคือการติดตั้งไลบรารีที่ถูกต้องและทำความเข้าใจกระบวนการฝึกที่เฉพาะทางของ diffusion เมื่อจัดสภาพแวดล้อมพร้อมแล้ว การโหลดโมเดล ฝึกตัวปรับ LoRA ประเมินผล และอัปโหลดผลลัพธ์ไปยัง Hugging Face ล้วนเป็นไปอย่างราบรื่น
ฉันพบว่า DiffusionGemma น่าสนใจเป็นพิเศษเพราะมันไม่ได้สร้างข้อความทีละโทเค็นแบบโมเดลภาษาดั้งเดิม แต่ทำงานกับผืนผ้าใบคงที่และค่อย ๆ ปรับโทเค็นที่มีสัญญาณรบกวนผ่านขั้นตอนการลบสัญญาณรบกวน การทำความเข้าใจขั้นตอนการสร้างที่ต่างออกไปนี้ และการปรับแต่งมันกับงานตอบคำถามด้านชีวการแพทย์ ทำให้การทดลองครั้งนี้มีคุณค่าเป็นพิเศษสำหรับฉัน
แม้ตั้งค่าขนาดเล็ก ความแม่นยำบนตัวอย่าง 50 ข้อเพิ่มจาก 0.60 เป็น 0.80 — แต่ด้วยขนาดตัวอย่างเท่านี้ ค่าคลาดเคลื่อนยังสูง และฐาน "ตอบว่า yes ตลอด" ก็ทำได้ราว 55% บนชุดประเมินนี้อยู่แล้ว
นอกจากนี้ควรสังเกตว่าชุดฝึกแบบประดิษฐ์แทบไม่มีฉลาก "maybe" เลย ทำให้โมเดลมีโอกาสเรียนรู้คลาสนี้น้อย แม้ว่าจะปรากฏในข้อมูลประเมินก็ตาม จงมองว่านี่เป็นการทดลองอย่างรวดเร็วเพื่อดูว่ากระบวนการปรับแต่งทำงานอย่างไร ไม่ใช่หลักฐานว่าโมเดลพร้อมใช้ทางการแพทย์จริง
พร้อมจะก้าวข้ามการปรับแต่งครั้งเดียวหรือยัง? แทร็กDeveloping Large Language Models ของเราจะพาจากพื้นฐาน PyTorch และ transformers ไปสู่การสร้างและดีพลอย LLM ของตนเอง
DiffusionGemma คือโมเดลภาษาทดลองจาก Google DeepMind ที่สร้างข้อความต่างจากโมเดลภาษาแบบดั้งเดิม แทนที่จะทำนายทีละโทเค็นจากซ้ายไปขวา โมเดลจะเริ่มจาก ผืนผ้าใบของโทเค็นที่มีสัญญาณรบกวนคงที่ และค่อย ๆ ปรับให้ดีขึ้นผ่านขั้นตอนการลบสัญญาณรบกวนหลายครั้ง วิธีนี้ช่วยให้โมเดลอัปเดตหลายตำแหน่งของโทเค็นแบบขนาน และแก้ไขบางส่วนของคำตอบระหว่างการสร้างได้
ในคู่มือนี้ เราจะทำการปรับแต่ง diffusiongemma-26B-A4B-it บนชุดข้อมูล PubMedQA โดยใช้ GPU NVIDIA H100 โมเดลจะได้รับคำถามด้านชีวการแพทย์พร้อมบริบทที่เกี่ยวข้อง แล้วทำนายคำตอบว่า yes, no หรือ maybe เราจะเตรียมข้อมูล ฝึกตัวปรับ LoRA ประเมินโมเดลก่อนและหลังการปรับแต่ง และอัปโหลดตัวปรับขั้นสุดท้ายไปยัง Hugging Face
ฉันได้เผยแพร่โน้ตบุ๊กฉบับเต็มแล้ว เพื่อให้ตรวจสอบโค้ดต้นฉบับ ติดตามไปพร้อมกัน และรันการทดลองได้ด้วยตนเอง
หมายเหตุ: โครงการนี้มีไว้เพื่อการเรียนรู้และทดลองเท่านั้น ไม่ควรใช้เพื่อการตัดสินใจทางการแพทย์จริง