现代大语言模型越来越深、越来越宽、计算开销也越来越大,但简单堆叠更多 Transformer 层并不总能带来成比例的收益。一个原因在于标准的残差连接以固定的单位权重聚合各层输出,因此每一层都继承了此前所有内容的均匀求和。这会稀释早期表示、放大隐藏状态的幅度,并使网络更难有选择地复用最有用的中间特征。
注意力残差(Attention Residuals)并不把深度当作固定的加性递归处理,而是让每一层用可学习的 softmax 权重对更早的层输出进行注意力聚合,详见Kimi 团队的论文。本文将解释为什么标准的残差聚合会成为瓶颈、注意力残差如何工作、为什么块式变体重要,以及实验对更深语言模型的可扩展性有何启示。
如果您希望进一步了解现代 Transformer 架构背后的思想,推荐学习 DataCamp 课程PyTorch 中的 Transformer 模型教程。
问题:被淹没的信号
残差连接多年来一直是深度学习的基石。在 Transformer 中,标准的残差更新为:
hl=hl−1+fl−1(hl−1)
这有助于梯度在超深网络中流动。但残差不仅是梯度技巧,它们也决定了信息如何在深度维度上聚合。将该递推展开可得:
hl=h1+∑i=1l−1fi(hi)
这意味着第 l 层的隐藏状态等于初始嵌入加上此前所有层输出的均匀加权和。因此每一项贡献实际上都被赋予相同的权重。
在大规模下,这会成为问题。论文显示,在PreNorm 架构中,未加权的残差累加会使隐藏状态幅度随深度增长,约为 O(L)。
随着残差流增大,早期层的输出在更大的累加和中被不断稀释。一旦早期信号被掺入该累积,后续更深的层就无法有选择地将其取回,只能在聚合后的状态上操作。
这导致论文所称的“信号淹没”效应。分层剪枝研究提供了这种低效性的强有力经验证据:训练后的模型中,往往可以删除相当比例的层而对性能影响很小。这表明,尽管我们不断增加深度,模型却缺乏充分利用深度的有效机制。网络没有形成层级化的推理链,而更像是冗余的接力,早期信号被逐步稀释。
在前向传播中还存在折衷。随着残差流增大,后续层可能需要产生更高幅度的输出,才能对累积状态产生有意义的影响。论文将此与 PreNorm 行为关联起来:在标准残差聚合下,隐藏状态幅度会随深度单调增大。
残差连接有助于梯度流动,对某个中间隐藏状态的梯度可写为:
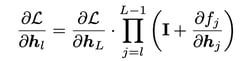
其中的恒等项保留了直接的梯度路径。但残差仍迫使前向聚合路径以固定的 1.0 权重对待所有早期层。这正是 AttnRes 试图修复的结构性限制。
从加性残差到深度维注意力
论文中一个最有趣的概念转变是时间—深度二象性。残差连接在深度上压缩信息,正如循环网络在时间上压缩信息。在序列建模中,注意力用选择性地访问早期位置替代了循环。AttnRes 将同样的转变应用到网络深度上:不再将下一个隐藏状态定义为对早期层的固定求和,而是让每一层对先前层的输出进行注意力:
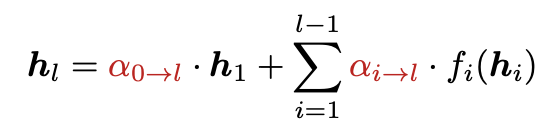
其中权重 αi→l 是深度维上的 softmax 注意力权重,且和为 1。权重计算为:
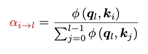
论文中采用:
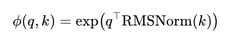
每一层都有一个可学习的伪查询向量 wl,该查询对由早期层输出构建的键和值进行注意力。对键应用 RMSNorm,使得那些自然幅度更大的层不会仅因尺度更大而主导 softmax。
论文的关键转变在于:将标准残差视为一种深度维的线性注意力,而 AttnRes 将其升级为深度维的 softmax 注意力。我们从均匀累加转向跨深度的选择性检索。
一个小而重要的实现细节是初始化。作者建议把所有伪查询向量初始化为零,以确保初始注意力权重为均匀分布,让模型以等权平均而非随机偏置的注意力机制开始训练。
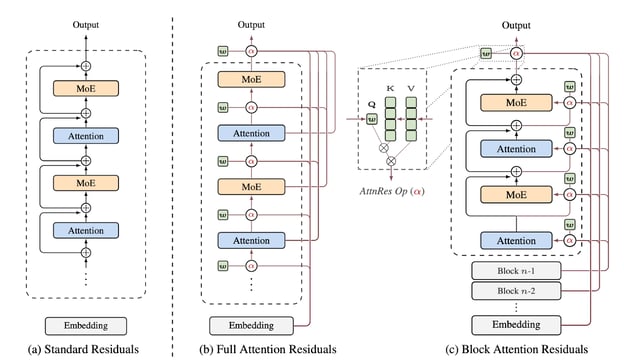
图 1:注意力残差概览(Attention Residuals 论文)
完全注意力残差
在完全注意力残差(Full Attention Residuals)中,每一层都对所有先前层的输出进行注意力,从而可以选择性地聚合跨深度的信息。这为模型提供了最大灵活性:更深层既可以强调其紧邻的前一层、初始嵌入,也可以强调任何更早层,只要那里存在最有用的信号。
在标准训练中,Full AttnRes 的显存开销比乍看要小,因为很多层的输出本就会为反向传播而保留。但在大规模训练时情况不同。一旦引入激活重计算和流水线并行,早期输出必须被显式保存并在后续层间通信,以便后面的层能对其进行注意力,这会变得昂贵。
因此,Full AttnRes 是理解核心思想的最佳方式,但并非大规模部署时多数团队会选择的版本。
块式注意力残差
论文提出了块式注意力残差(Block Attention Residuals),以降低内存和通信开销。将模型层划分为若干块:块内用标准加性残差进行聚合,块间则对块级摘要而非每个单独早期层进行注意力。
若 Bn 为第 n 个块内的层集合,则该块的表示为:
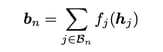
随后,模型将对嵌入 b0=h1 、较早的块摘要以及计算过程中产生的当前块的部分和进行注意力。这样将内存和通信从 O(Ld) 降到 O(Nd),其中 N 为块的数量。
论文报告称,使用约 8 个块即可恢复大部分完整版本的收益,且随着规模增大,Full AttnRes 与 Block AttnRes 之间的性能差距会缩小。S=2、4、8 等块大小与完整版本表现接近,而更粗的分组则会逐步回归基线行为。
最实用的结论是:无需对每一层都进行完整的深度维注意力,也能获得大部分收益。尽管 Block AttnRes 让深度维注意力在计算上可行,但要在大规模上高效部署仍需要精心的系统设计。论文还提出了多项优化,使 AttnRes 在真实世界的训练与推理中切实可用。
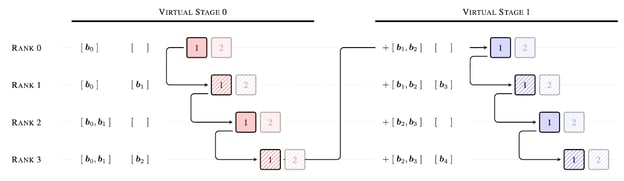
图 2:基于缓存的流水线通信示例,具有 4 个物理 rank 和每个 rank 2 个虚拟 stage,阴影方框表示 AttnRes 块的结束(Attention Residuals 论文)
以下三项关键系统优化,使 AttnRes 能作为标准残差的即插即用替代:
- 两阶段计算: 通过将伪查询与隐藏状态解耦,我们可以对一个块内所有层的查询进行批处理。第一阶段并行计算跨块注意力,第二阶段利用在线 Softmax 合并处理块内的顺序依赖。与 mHC 等以往多流方法相比,这显著降低了每层的 I/O。
- 跨阶段缓存: 在流水线并行中,通过在本地缓存先前接收的块来消除冗余数据传输。这在峰值单次传输成本上带来 V 倍改进(V 为图 2 所示的虚拟 stage 数量),使通信可以与计算完全重叠。
- 内存高效的预填充: 通过在张量并行设备间对块表示进行切分,对于长上下文(128K+)序列,内存占用降低了数量级(例如每台设备从 15GB 降至 0.3GB)。
结果与性能分析
论文从多层面验证了 AttnRes,包括缩放律、消融、训练动态以及下游基准测试。
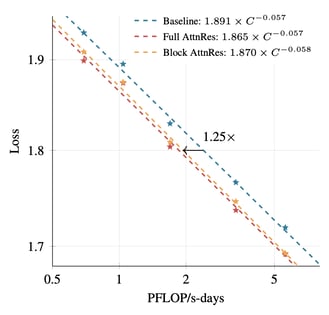
图 3: 注意力残差的缩放律曲线。(Attention Residuals 论文)
不过,最亮眼的结果来自缩放律实验。在五个模型规模上,Full AttnRes 与 Block AttnRes 的验证损失均稳定低于基线。基于拟合曲线,Block AttnRes 在约 1.25× 更少的计算量下即可达到与基线相同的损失。这表明 AttnRes 不仅理论更优,也更加算力高效。
在下游任务上,AttnRes 在所有评测基准上均优于基线。最大的一些提升出现在需要强推理能力的任务上,如表 1 所示:
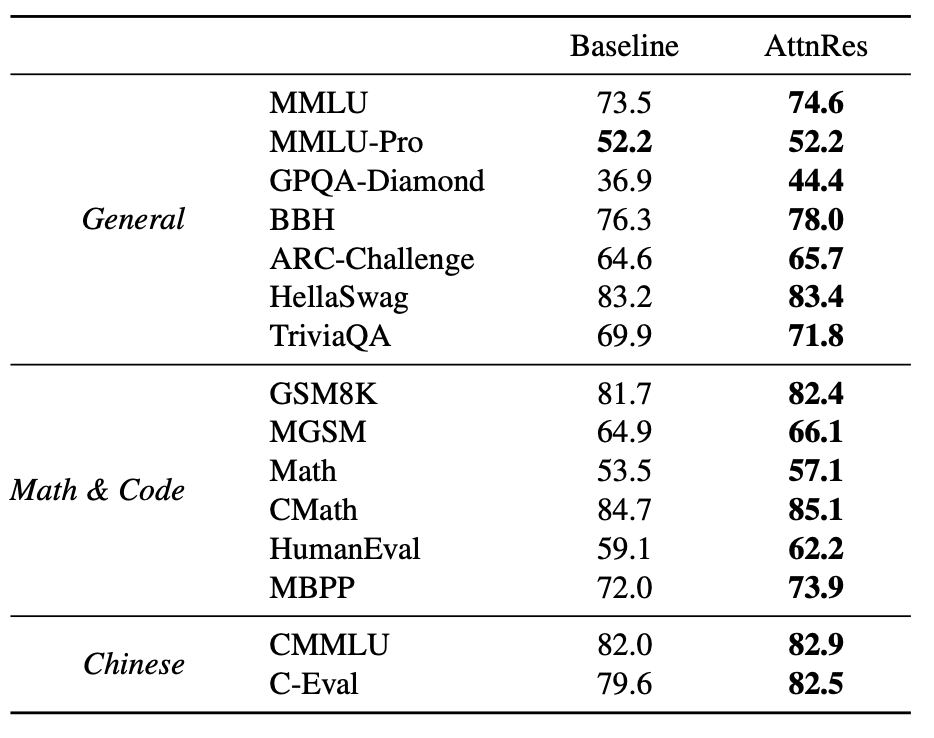
表 1: AttnRes 与基线的性能比较,两者均采用相同的预训练流程(Attention Residuals 论文)
收益在多步推理、数学与代码任务上尤为显著,这与论文的核心假设相吻合:若后续层能够选择性地检索早期表示,而非继承模糊的聚合体,组合式推理应当得到提升。
与基线相比,AttnRes 在整个训练过程中表现出更低的验证损失、在深度维度上更受控的输出幅度,以及跨层更均匀的梯度幅度。基线受到典型的 PreNorm 稀释模式影响,隐藏状态幅度随深度单调增大;而 Block AttnRes 借助在块边界的选择性聚合,产生了更受控、受限的模式。
更广泛的架构层面发现是:在固定算力与固定参数的搜索中,AttnRes 的最优配置相较基线会偏向“更深、更窄”。这表明,相较于标准残差聚合,AttnRes 可能让额外的深度更加有用。
结语
残差常被视为一种必要的训练技巧,即保持梯度存活的恒等捷径。AttnRes 指出这种看法过于狭隘。残差路径同样是信息跨深度路由的机制,而固定的加性累加可能对超深模型而言过于原始。
注意力残差并非在修补一个已知问题,而是在升级一个被忽视的设计选择。正如序列建模从循环进化到注意力,因为固定的循环过于受限;AttnRes 认为,深度现在也准备好迎接同样的转变。
模型仍表现出强烈的局部性:各层往往最关注临近的前驱层,但也会学习到非平凡的跳跃模式、对嵌入保持持久权重,并在自注意力前与 MLP 前的层之间维持差异化行为。
务实之道并非所有模型都要用完整的深度维注意力替换残差,而是将残差聚合重新框定为一个核心的架构设计空间。


现代大语言模型越来越深、越来越宽、计算开销也越来越大,但简单堆叠更多 Transformer 层并不总能带来成比例的收益。一个原因在于标准的残差连接以固定的单位权重聚合各层输出,因此每一层都继承了此前所有内容的均匀求和。这会稀释早期表示、放大隐藏状态的幅度,并使网络更难有选择地复用最有用的中间特征。
注意力残差(Attention Residuals)并不把深度当作固定的加性递归处理,而是让每一层用可学习的 softmax 权重对更早的层输出进行注意力聚合,详见Kimi 团队的论文。本文将解释为什么标准的残差聚合会成为瓶颈、注意力残差如何工作、为什么块式变体重要,以及实验对更深语言模型的可扩展性有何启示。
如果您希望进一步了解现代 Transformer 架构背后的思想,推荐学习 DataCamp 课程PyTorch 中的 Transformer 模型教程。
问题:被淹没的信号
残差连接多年来一直是深度学习的基石。在 Transformer 中,标准的残差更新为:
hl=hl−1+fl−1(hl−1)
这有助于梯度在超深网络中流动。但残差不仅是梯度技巧,它们也决定了信息如何在深度维度上聚合。将该递推展开可得:
hl=h1+∑i=1l−1fi(hi)
这意味着第 l 层的隐藏状态等于初始嵌入加上此前所有层输出的均匀加权和。因此每一项贡献实际上都被赋予相同的权重。
在大规模下,这会成为问题。论文显示,在PreNorm 架构中,未加权的残差累加会使隐藏状态幅度随深度增长,约为 O(L)。
随着残差流增大,早期层的输出在更大的累加和中被不断稀释。一旦早期信号被掺入该累积,后续更深的层就无法有选择地将其取回,只能在聚合后的状态上操作。
这导致论文所称的“信号淹没”效应。分层剪枝研究提供了这种低效性的强有力经验证据:训练后的模型中,往往可以删除相当比例的层而对性能影响很小。这表明,尽管我们不断增加深度,模型却缺乏充分利用深度的有效机制。网络没有形成层级化的推理链,而更像是冗余的接力,早期信号被逐步稀释。
在前向传播中还存在折衷。随着残差流增大,后续层可能需要产生更高幅度的输出,才能对累积状态产生有意义的影响。论文将此与 PreNorm 行为关联起来:在标准残差聚合下,隐藏状态幅度会随深度单调增大。
残差连接有助于梯度流动,对某个中间隐藏状态的梯度可写为:
其中的恒等项保留了直接的梯度路径。但残差仍迫使前向聚合路径以固定的 1.0 权重对待所有早期层。这正是 AttnRes 试图修复的结构性限制。
从加性残差到深度维注意力
论文中一个最有趣的概念转变是时间—深度二象性。残差连接在深度上压缩信息,正如循环网络在时间上压缩信息。在序列建模中,注意力用选择性地访问早期位置替代了循环。AttnRes 将同样的转变应用到网络深度上:不再将下一个隐藏状态定义为对早期层的固定求和,而是让每一层对先前层的输出进行注意力:
其中权重 αi→l 是深度维上的 softmax 注意力权重,且和为 1。权重计算为:
论文中采用:
每一层都有一个可学习的伪查询向量 wl,该查询对由早期层输出构建的键和值进行注意力。对键应用 RMSNorm,使得那些自然幅度更大的层不会仅因尺度更大而主导 softmax。
论文的关键转变在于:将标准残差视为一种深度维的线性注意力,而 AttnRes 将其升级为深度维的 softmax 注意力。我们从均匀累加转向跨深度的选择性检索。
一个小而重要的实现细节是初始化。作者建议把所有伪查询向量初始化为零,以确保初始注意力权重为均匀分布,让模型以等权平均而非随机偏置的注意力机制开始训练。
图 1:注意力残差概览(Attention Residuals 论文)
完全注意力残差
在完全注意力残差(Full Attention Residuals)中,每一层都对所有先前层的输出进行注意力,从而可以选择性地聚合跨深度的信息。这为模型提供了最大灵活性:更深层既可以强调其紧邻的前一层、初始嵌入,也可以强调任何更早层,只要那里存在最有用的信号。
在标准训练中,Full AttnRes 的显存开销比乍看要小,因为很多层的输出本就会为反向传播而保留。但在大规模训练时情况不同。一旦引入激活重计算和流水线并行,早期输出必须被显式保存并在后续层间通信,以便后面的层能对其进行注意力,这会变得昂贵。
因此,Full AttnRes 是理解核心思想的最佳方式,但并非大规模部署时多数团队会选择的版本。
块式注意力残差
论文提出了块式注意力残差(Block Attention Residuals),以降低内存和通信开销。将模型层划分为若干块:块内用标准加性残差进行聚合,块间则对块级摘要而非每个单独早期层进行注意力。
若 Bn 为第 n 个块内的层集合,则该块的表示为:
随后,模型将对嵌入 b0=h1 、较早的块摘要以及计算过程中产生的当前块的部分和进行注意力。这样将内存和通信从 O(Ld) 降到 O(Nd),其中 N 为块的数量。
论文报告称,使用约 8 个块即可恢复大部分完整版本的收益,且随着规模增大,Full AttnRes 与 Block AttnRes 之间的性能差距会缩小。S=2、4、8 等块大小与完整版本表现接近,而更粗的分组则会逐步回归基线行为。
最实用的结论是:无需对每一层都进行完整的深度维注意力,也能获得大部分收益。尽管 Block AttnRes 让深度维注意力在计算上可行,但要在大规模上高效部署仍需要精心的系统设计。论文还提出了多项优化,使 AttnRes 在真实世界的训练与推理中切实可用。
图 2:基于缓存的流水线通信示例,具有 4 个物理 rank 和每个 rank 2 个虚拟 stage,阴影方框表示 AttnRes 块的结束(Attention Residuals 论文)
以下三项关键系统优化,使 AttnRes 能作为标准残差的即插即用替代:
结果与性能分析
论文从多层面验证了 AttnRes,包括缩放律、消融、训练动态以及下游基准测试。
图 3: 注意力残差的缩放律曲线。(Attention Residuals 论文)
不过,最亮眼的结果来自缩放律实验。在五个模型规模上,Full AttnRes 与 Block AttnRes 的验证损失均稳定低于基线。基于拟合曲线,Block AttnRes 在约 1.25× 更少的计算量下即可达到与基线相同的损失。这表明 AttnRes 不仅理论更优,也更加算力高效。
在下游任务上,AttnRes 在所有评测基准上均优于基线。最大的一些提升出现在需要强推理能力的任务上,如表 1 所示:
表 1: AttnRes 与基线的性能比较,两者均采用相同的预训练流程(Attention Residuals 论文)
收益在多步推理、数学与代码任务上尤为显著,这与论文的核心假设相吻合:若后续层能够选择性地检索早期表示,而非继承模糊的聚合体,组合式推理应当得到提升。
与基线相比,AttnRes 在整个训练过程中表现出更低的验证损失、在深度维度上更受控的输出幅度,以及跨层更均匀的梯度幅度。基线受到典型的 PreNorm 稀释模式影响,隐藏状态幅度随深度单调增大;而 Block AttnRes 借助在块边界的选择性聚合,产生了更受控、受限的模式。
更广泛的架构层面发现是:在固定算力与固定参数的搜索中,AttnRes 的最优配置相较基线会偏向“更深、更窄”。这表明,相较于标准残差聚合,AttnRes 可能让额外的深度更加有用。
结语
残差常被视为一种必要的训练技巧,即保持梯度存活的恒等捷径。AttnRes 指出这种看法过于狭隘。残差路径同样是信息跨深度路由的机制,而固定的加性累加可能对超深模型而言过于原始。
注意力残差并非在修补一个已知问题,而是在升级一个被忽视的设计选择。正如序列建模从循环进化到注意力,因为固定的循环过于受限;AttnRes 认为,深度现在也准备好迎接同样的转变。
模型仍表现出强烈的局部性:各层往往最关注临近的前驱层,但也会学习到非平凡的跳跃模式、对嵌入保持持久权重,并在自注意力前与 MLP 前的层之间维持差异化行为。
务实之道并非所有模型都要用完整的深度维注意力替换残差,而是将残差聚合重新框定为一个核心的架构设计空间。