Curso
Modelos Transformer com PyTorch
2 h
9K
Os LLMs modernos ficaram mais profundos, mais largos e mais exigentes em computação, mas empilhar mais camadas de Transformer nem sempre traz ganhos proporcionais. Um dos motivos é que as conexões residuais padrão agregam as saídas das camadas com pesos unitários fixos, fazendo com que cada camada herde uma soma uniforme de tudo o que veio antes. Isso pode diluir representações anteriores, amplificar a magnitude do estado oculto e dificultar que a rede reutilize seletivamente os recursos intermediários mais úteis.
Em vez de tratar a profundidade como uma recorrência aditiva fixa, o paper do time Kimi sobre Attention Residuals permite que cada camada faça atenção sobre as saídas das camadas anteriores usando pesos softmax aprendidos. Neste artigo, vamos entender por que a agregação residual padrão vira gargalo, como Attention Residuals funciona, por que a variante em blocos importa e o que os resultados realmente sugerem sobre escalar modelos de linguagem mais profundos.
Se você quer se aprofundar nas ideias por trás das arquiteturas Transformer modernas, recomendo conferir o curso da DataCamp Transformer Models Tutorial em PyTorch.
Conexões residuais são fundamentais no deep learning há anos. Em Transformers, a atualização residual padrão é:
hl=hl−1+fl−1(hl−1)
Isso ajuda o gradiente a fluir por redes muito profundas. Mas os residuais não são só um truque de gradiente. Eles também definem como a informação é agregada ao longo da profundidade. Se desenrolarmos a recorrência, temos:
hl=h1+∑i=1l−1fi(hi)
Isso significa que o estado oculto na camada l é basicamente o embedding e uma soma uniformemente ponderada de todas as saídas anteriores. Ou seja, cada contribuição recebe efetivamente o mesmo peso.
Isso vira problema em escala. O paper mostra que em arquiteturas PreNorm, a acumulação residual sem pesos faz as magnitudes do estado oculto crescerem com a profundidade, aproximadamente como O(L).
À medida que o fluxo residual cresce, as saídas das camadas iniciais ficam cada vez mais diluídas dentro de uma soma crescente. Uma vez que um sinal das primeiras camadas é misturado nessa acumulação, camadas mais profundas não conseguem recuperá-lo seletivamente. Elas passam a operar apenas sobre o estado agregado.
Isso leva ao que o paper chama de efeito de “sinal que se afoga”. Uma evidência empírica forte dessa ineficiência vem de estudos de podas de camadas: muitas camadas de modelos treinados podem ser removidas com impacto mínimo no desempenho. Isso sugere que, mesmo aumentando a profundidade, os modelos carecem de um mecanismo eficaz para aproveitá-la por completo. Em vez de formar uma cadeia hierárquica de raciocínio, a rede se comporta mais como um revezamento redundante, em que sinais iniciais são progressivamente diluídos.
Há também um trade-off no forward pass. Conforme o fluxo residual cresce, camadas posteriores podem precisar gerar saídas de maior magnitude para influenciar de forma significativa o estado acumulado. O paper conecta isso ao comportamento PreNorm, em que as magnitudes do estado oculto aumentam monotonamente com a profundidade sob a agregação residual padrão.
Conexões residuais ajudam o gradiente a fluir, e o gradiente em relação a um estado oculto intermediário pode ser escrito como:
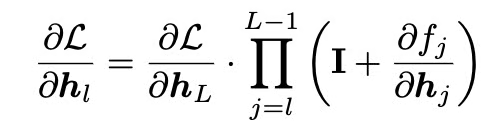
O termo identidade aqui preserva um caminho de gradiente direto. Mas os residuais ainda forçam o caminho de agregação no forward a tratar todas as camadas anteriores com peso fixo de 1,0. Essa é a limitação estrutural que o AttnRes tenta corrigir.
O movimento conceitual mais interessante do paper é a dualidade tempo–profundidade. Conexões residuais comprimem informação ao longo da profundidade, assim como redes recorrentes comprimem informação ao longo do tempo. Em modelagem de sequência, a atenção substituiu a recorrência ao permitir que cada posição acessasse seletivamente posições anteriores. O AttnRes aplica a mesma transição à profundidade da rede. Em vez de definir o próximo estado oculto como uma soma fixa sobre camadas anteriores, o AttnRes permite que cada camada faça atenção às saídas das camadas passadas:
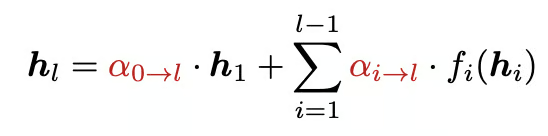
em que os pesos αi→l são pesos de atenção softmax ao longo da profundidade e somam 1. Esses pesos são calculados como:
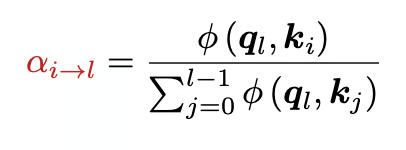
com o paper usando:
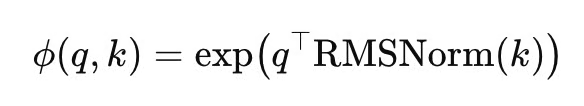
Cada camada recebe um pseudo-query aprendido wl, e esse query faz atenção sobre chaves e valores construídos a partir das saídas das camadas anteriores. Aplica-se RMSNorm às chaves para que camadas com saídas naturalmente maiores não dominem o softmax apenas por causa da escala.
A mudança-chave do paper é tratar os residuais padrão como uma espécie de atenção linear ao longo da profundidade, enquanto o AttnRes eleva isso a uma atenção softmax ao longo da profundidade. Em vez de acumulação uniforme, passamos a ter recuperação seletiva através da profundidade.
Um detalhe de implementação pequeno, mas importante, é a inicialização. Os autores sugerem inicializar todos os pseudo-queries com zero, garantindo pesos de atenção iniciais uniformes, para que o modelo comece o treinamento como uma média de pesos iguais em vez de um mecanismo de atenção enviesado aleatoriamente.
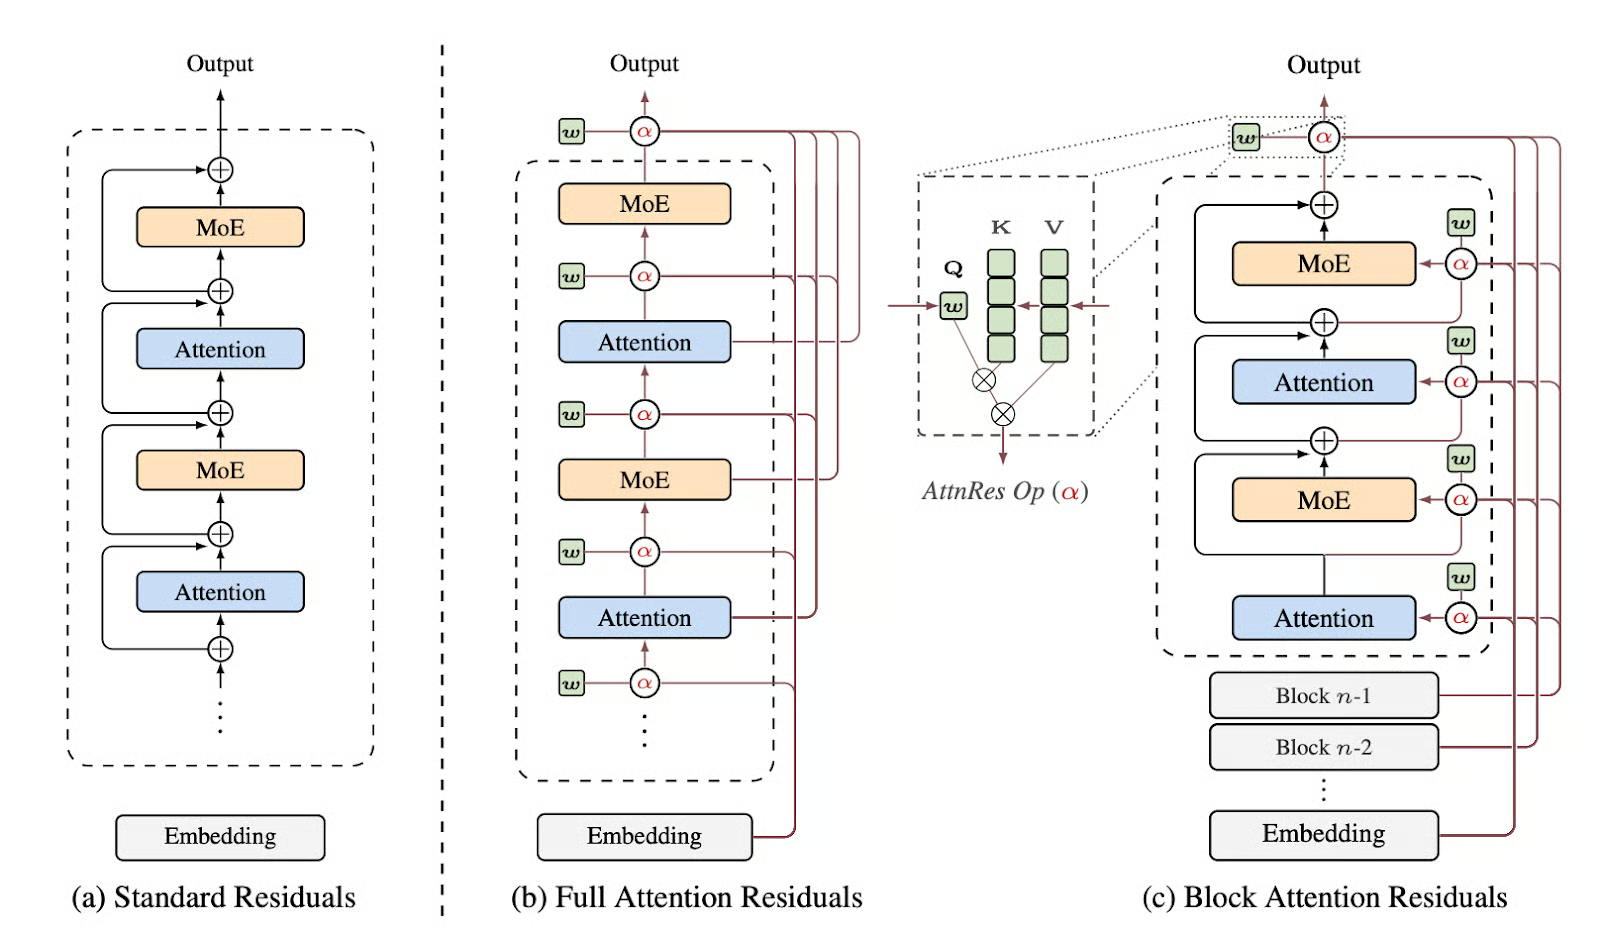
Figura 1: visão geral de Attention Residuals (paper Attention Residuals)
Em Full Attention Residuals, cada camada faz atenção a todas as saídas anteriores, permitindo agregar seletivamente informação ao longo da profundidade. Isso dá máxima flexibilidade ao modelo, para que uma camada mais profunda possa enfatizar sua predecessora imediata, o embedding original ou qualquer camada anterior de onde venha o sinal mais útil.
No treinamento padrão, a sobrecarga de memória do Full AttnRes é menor do que parece, porque muitas saídas de camadas já são mantidas para backprop. Mas em treinamento em larga escala o cenário muda. Ao introduzir recomputação de ativações e paralelismo em pipeline, essas saídas anteriores precisam ser explicitamente preservadas e comunicadas para que camadas posteriores façam atenção a elas, o que sai caro.
Portanto, o Full AttnRes é a melhor forma de entender a ideia central, mas não é a versão que a maioria dos times vai querer adotar em escala.
O paper introduz a ideia de Block Attention Residuals para reduzir a sobrecarga de memória e comunicação. As camadas do modelo são particionadas em blocos de forma que, dentro de cada bloco, as saídas são combinadas usando acumulação residual aditiva padrão; mas, entre blocos, o modelo faz atenção sobre resumos em nível de bloco em vez de cada camada anterior individualmente.
Se Bn é o conjunto de camadas no bloco n, então a representação do bloco é dada por:
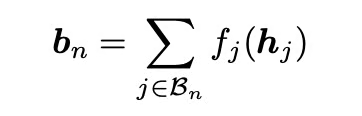
O modelo então faz atenção sobre o embedding b0=h1 , os resumos dos blocos anteriores e a soma parcial do bloco atual conforme o cálculo avança. Isso reduz memória e comunicação de O(Ld) para O(Nd), onde N é o número de blocos.
O paper relata que usar cerca de oito blocos recupera a maior parte do ganho da versão completa, e a diferença de desempenho entre Full AttnRes e Block AttnRes diminui à medida que a escala aumenta. Tamanhos de bloco como S=2,4,8 ficam próximos da versão completa, enquanto agrupamentos muito mais amplos voltam a se aproximar do comportamento básico.
A principal lição do paper é que você não precisa de atenção completa ao longo da profundidade em todas as camadas para capturar a maior parte do ganho. Embora o Block AttnRes torne a atenção por profundidade viável computacionalmente, implantá-la de forma eficiente em escala ainda requer um projeto de sistemas cuidadoso. O paper também apresenta várias otimizações que tornam o AttnRes prático para treinamento e inferência no mundo real.
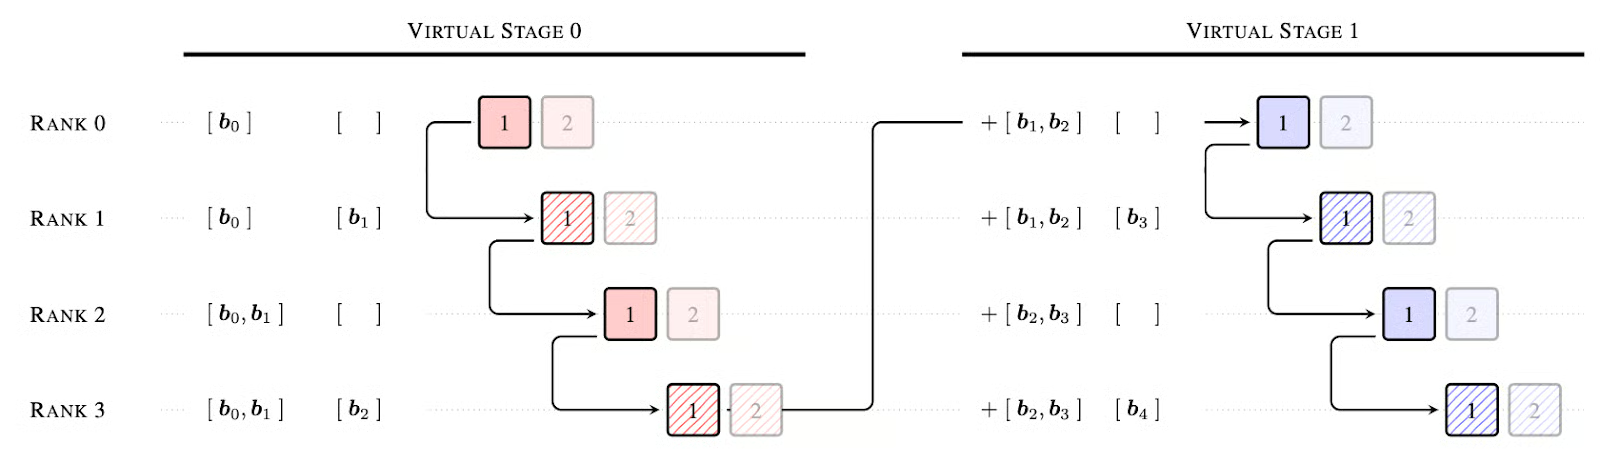
Figura 2: exemplo de comunicação em pipeline com cache usando 4 ranks físicos e 2 estágios virtuais por rank, em que os blocos tracejados denotam o fim dos blocos AttnRes (paper Attention Residuals)
Aqui estão três otimizações de sistema essenciais que fazem do AttnRes um substituto direto para residuais padrão:
O paper valida o AttnRes em vários níveis, como leis de escala, ablações, dinâmica de treinamento e benchmarks downstream.
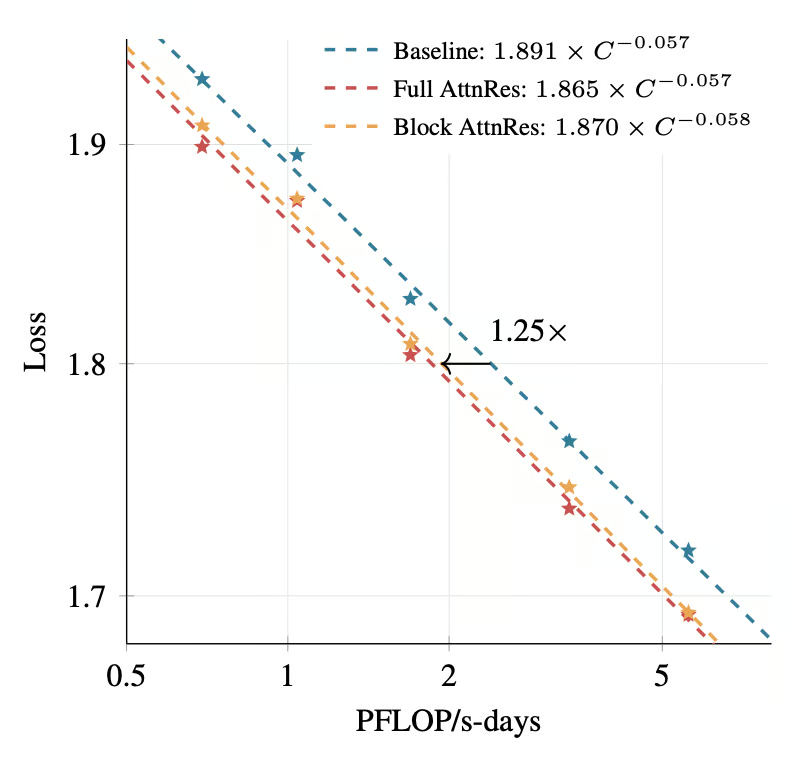
Figura 3: curvas de lei de escala para Attention Residuals. (paper Attention Residuals)
No entanto, o principal resultado vem dos experimentos de leis de escala. Em cinco tamanhos de modelo, tanto o Full AttnRes quanto o Block AttnRes atingem consistentemente menor loss de validação que a baseline. Com base nas curvas ajustadas, o Block AttnRes chega ao mesmo loss que uma baseline treinada com cerca de 1,25× mais computação. Isso sugere que o AttnRes não é só melhor em teoria, mas também mais eficiente em termos de compute.
Em tarefas downstream, o AttnRes melhora em relação à baseline em todos os benchmarks avaliados. Alguns dos maiores ganhos estão em tarefas intensivas de raciocínio, como mostrado na Tabela 1:
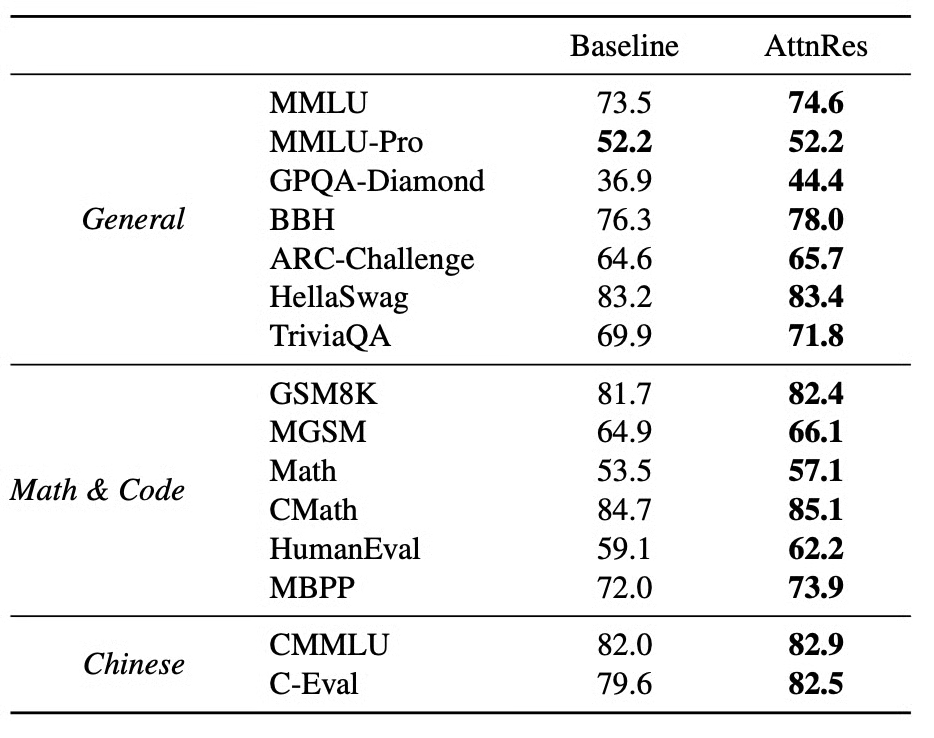
Tabela 1: comparação de desempenho do AttnRes com a baseline, ambos após a mesma receita de pré-treinamento (paper Attention Residuals)
Os ganhos são especialmente fortes em raciocínio multi-etapas, matemática e código, o que se alinha à hipótese central do paper: se camadas posteriores podem recuperar seletivamente representações anteriores, em vez de herdar um agregado borrado, o raciocínio composicional tende a melhorar.
Comparado à baseline, o AttnRes mostra menor loss de validação ao longo do treinamento, magnitudes de saída mais controladas com a profundidade e magnitudes de gradiente mais uniformes entre camadas. A baseline sofre do padrão de diluição típico do PreNorm, em que as magnitudes do estado oculto crescem monotonamente com a profundidade, enquanto o Block AttnRes produz um padrão mais controlado e limitado graças à agregação seletiva nas fronteiras dos blocos.
Há também um achado mais amplo no nível de arquitetura: em um sweep de compute e parâmetros fixos, a configuração ideal para o AttnRes tende a um modelo mais profundo e mais estreito em comparação à baseline. Isso sugere que o AttnRes pode tornar profundidade adicional mais útil do que sob a agregação residual padrão.
Residuais costumam ser tratados como um truque necessário de treinamento, isto é, um atalho de identidade que mantém os gradientes vivos. O AttnRes sugere que essa visão é estreita demais. Os caminhos residuais também são o mecanismo pelo qual a informação é roteada ao longo da profundidade, e a acumulação aditiva fixa pode ser simples demais para modelos muito profundos.
Attention Residuals não é tanto sobre corrigir um problema conhecido, e sim sobre aprimorar uma escolha de design negligenciada. A modelagem de sequências evoluiu da recorrência para a atenção porque a recorrência fixa era restritiva demais. O AttnRes argumenta que a profundidade pode estar pronta para a mesma transição.
O modelo ainda mostra forte localidade, com camadas frequentemente prestando mais atenção às predecessoras próximas, mas também aprende padrões de salto não triviais, preserva peso persistente no embedding e mantém comportamentos distintos entre camadas pré-atenção e pré-MLP.
A lição prática não é que todos os modelos devem substituir residuais por atenção completa ao longo da profundidade. Em vez disso, é reenquadrar a agregação residual como um espaço central de design arquitetural.
Principais cursos da DataCamp
Curso
Curso
Curso
blog
Nisha Arya Ahmed
12 min
Tutorial
Arjun Sarkar
15 min
Tutorial
Zoumana Keita
14 min
Tutorial
Bharath K
13 min
Tutorial
Zoumana Keita
12 min
Tutorial
Kurtis Pykes
14 min