
Azure Synapse 与 Databricks:主要差异
比较 Azure Synapse 和 Databricks 时,需要认识到尽管二者在能力上有重叠,但其面向的使用场景与组织需求并不相同。
目的与使用场景
Azure Synapse 主要面向综合性数据分析与数据仓库。对于需要统一平台来管理海量数据、整合多种数据源,并以商业智能为重点开展广泛数据分析的企业而言,这是极佳选择。
相较之下,Databricks 在大数据处理、数据科学与机器学习方面更为出色。对于需要运行复杂数据管道、执行实时分析并大规模构建机器学习模型的组织而言,它是首选平台。
数据集成与 ETL 能力
Azure Synapse 与 Azure Data Factory 无缝集成,提供强大的ETL能力,允许用户编排跨多种来源的数据工作流。这使其非常适合需要将多源数据整合到集中式存储库以供分析的企业。
Databricks 擅长借助 Apache Spark 处理复杂数据管道,非常适合对强大数据转换与集成能力有需求的组织,尤其是大数据环境。
分析与机器学习
Azure Synapse 与 Power BI 集成,使其在商业分析与报告方面具有竞争力。它还提供用于执行基于 SQL 的分析的内置工具,对业务分析师而言更为友好。
Databricks 更偏向高级数据科学与机器学习。它对 Python、R 与 Scala 提供强力支持,并配备如 MLflow 等用于管理机器学习工作流的功能,因此更受数据科学家与工程师青睐。
性能与可扩展性
两者都具备强大的性能与可扩展性,但侧重点不同。Azure Synapse 针对大规模数据仓库进行了优化,能在海量数据集上提供高效查询性能。
而 Databricks 在实时数据处理方面优势明显,并可轻松扩展以满足大数据工作负载的高计算需求。
与其他 Azure 服务的集成
Azure Synapse 与 Azure Data Lake Storage 和 Power BI 的集成尤为紧密,非常适合已深度投入 Azure 生态的组织。
Databricks 虽同样可在 Azure 内集成,但在连接多种数据源(包括 Azure 之外)方面更具灵活性。对于采用混合或多云战略的组织,这是显著优势。
用户体验与易用性
Azure Synapse 提供更为直观的用户体验,尤其适合熟悉 SQL 与传统数据仓库的用户。其集成工作区旨在简化整个数据工作流,即便是技术背景较弱的用户也可轻松上手。
Databricks 功能强大,但学习曲线更陡峭,尤其是对不熟悉 Apache Spark 或大数据处理细节的用户而言。然而,对于数据科学家与工程师而言,其协作环境与强大功能使之极具效率。
成本考量
在 Azure Synapse 与 Databricks 之间做出选择时,成本是重要因素。
Azure Synapse 通过其预配计算资源提供更可预测的定价,适合工作负载稳定的组织。不过,其无服务器选项可为按需使用提供灵活性,可能降低间歇性工作负载的成本。
另一方面,Databricks 按计算用量计费,对于波动性或高强度工作负载,尤其是在利用其实时处理能力时,可能更具成本效益。但对于大规模、持续的数据处理,成本可能迅速上升,因此组织必须优化其计算使用。
Azure Synapse 与 Databricks:对比总结
下表从多个方面比较了 Azure Synapse Analytics 与 Databricks:
|
类别 |
Azure Synapse Analytics |
Databricks |
|
概述 |
面向大数据与数据仓库的一体化分析服务。 |
面向大数据与机器学习的统一分析平台。 |
|
主要用例 |
数据仓库、大数据分析、数据集成。 |
大数据处理、数据科学与机器学习。 |
|
数据集成 |
通过 Synapse Pipelines(类似 ADF)内置数据集成。 |
数据管道需与 Azure Data Factory 集成。 |
|
数据存储 |
与 SQL Data Warehouse、Azure Data Lake 和 Cosmos DB 集成。 |
针对 Delta Lake 优化,并可与 S3、ADLS 等多种数据存储集成。 |
|
计算引擎 |
基于 SQL 的计算引擎用于查询数据(专用与无服务器)。 |
基于 Apache Spark 的计算引擎,针对大数据处理优化。 |
|
可扩展性 |
高度可扩展,支持按需与预配两种模式。 |
高度可扩展,支持用于大数据处理的自动伸缩集群。 |
|
数据处理 |
通过无服务器与专用池支持批处理与实时处理。 |
借助 Apache Spark 的高级批处理与实时数据处理。 |
|
机器学习 |
与 Azure Machine Learning 集成;支持 T-SQL。 |
内置对机器学习的支持,配备 MLflow 与 Spark MLlib。 |
|
笔记本 |
集成笔记本,支持 T-SQL、Python、Spark SQL、Scala 与 R。 |
高级笔记本,支持 Python、Scala、SQL 与 R。 |
|
成本模型 |
无服务器与预配模型均按量计费。存储与计算分别计费。 |
存储与计算按量计费;针对高性价比大数据处理进行优化。 |
|
安全 |
内置数据加密、基于角色的访问控制与专用终结点。 |
数据加密、访问控制,并可与 Azure Active Directory(AAD)集成。 |
|
协作 |
与 Azure DevOps 与 GitHub 集成以实现版本控制。 |
通过 GitHub 与 Databricks Repos 提供广泛的协作功能。 |
|
开发者体验 |
借助 Synapse Studio 简化操作,支持拖拽式数据管道,并与 SQL 与 Spark 池集成。 |
通过 Databricks Workspace 提供高级体验,内置笔记本、数据探索与协作功能。 |
|
互操作性 |
与 Power BI、Azure ML、Logic Apps 等其他 Azure 服务深度集成。 |
可在 Azure 中集成,同时支持多云环境。 |
|
数据治理 |
与 Azure Purview 集成以进行数据治理与血缘追踪。 |
数据治理通常由外部管理,例如使用 Azure Purview。 |
|
查询性能 |
针对结构化数据具备高性能,在专用池中进行分布式查询处理。 |
针对结构化与非结构化数据进行优化,尤其在基于 Spark 的大规模数据处理中表现出色。 |
|
对 BI 工具的支持 |
与 Power BI 及其他 Azure 原生工具直接集成。 |
可与 Power BI、Tableau、Qlik 等 BI 工具集成。 |
|
易用性 |
提供带拖拽功能的友好界面,适合业务用户与数据工程师。 |
技术性更强,面向数据科学家、数据工程师与开发者。 |
|
多云支持 |
以 Azure 为中心,与 Azure 生态深度集成。 |
支持 Azure、AWS 与 GCP,具备多云灵活性。 |
|
实时分析 |
通过集成 Azure Stream Analytics 支持实时分析。 |
借助 Spark Streaming 提供强大的实时分析能力。 |
|
与 AI 的集成 |
与 Azure 认知服务与 Azure Machine Learning 无缝集成。 |
内置 AI/ML 工具,支持深度学习与 AI 模型训练。 |
|
合规与认证 |
符合多种行业标准,包括 ISO、HIPAA 与 GDPR 等。 |
同样符合多种行业标准,并支持 GDPR、HIPAA 等合规要求。 |
|
社区与生态 |
庞大的 Azure 社区与丰富的文档和支持。 |
强大的社区支持,提供多种插件、工具与库。 |
|
部署 |
全托管服务,自动更新与维护。 |
托管服务,可控制集群配置、自动伸缩等。 |
|
监控与管理 |
通过 Azure Monitor、Synapse Studio 与 Log Analytics 实现集成监控。 |
提供广泛监控工具,包括 Databricks REST API,并可与 Azure Monitor 集成。 |
何时使用 Azure Synapse
Azure Synapse 优先适用于:
- 需要统一数据平台以进行分析与数据仓库的企业。
- 以商业智能与数据可视化为重点的组织。
- 寻求集成 ETL、数据仓库与分析的一体化解决方案的团队。
何时使用 Databricks
Databricks 非常适合:
- 具有大量数据处理与大数据分析需求的组织。
- 专注于机器学习与人工智能的数据科学团队。
- 需要实时数据处理与复杂数据管道的公司。
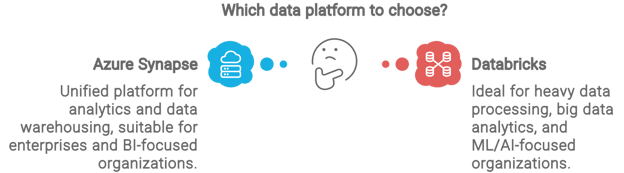
在 Azure Synapse 与 Databricks 之间的选择。使用 napkin.ai 创建
结论
Azure Synapse 与 Databricks 都是功能强大的平台,拥有各自独特的优势,适配不同组织需求。
若企业需要在 Azure 生态内集成的一体化数据分析与数据仓库平台,Azure Synapse 是首选。
Databricks 则以其强大的大数据处理、机器学习与实时分析能力,更适合专注于数据科学与工程的数据密集型组织。
归根结底,您的具体用例、现有基础设施以及长期数据战略应当引导您在 Azure Synapse 与 Databricks 之间做出选择。
如需进一步了解,您可通过以下资源深入探索这些平台:
这些资源将帮助您更好地理解各个平台的能力,以及它们如何融入您的数据战略!
常见问题
Azure Synapse 与 Databricks 的主要差异是什么?
Azure Synapse 侧重于与 Azure 集成的数据仓库与分析;Databricks 则在大数据处理、机器学习与实时分析方面表现卓越。
哪个平台更适合机器学习与 AI 项目?
得益于其高级分析、协作式笔记本以及对 Apache Spark 的强力支持,Databricks 更适合机器学习与 AI 项目。
Azure Synapse 如何与其他 Azure 服务集成?
Azure Synapse 与 Azure Data Lake Storage 与 Power BI 等服务深度集成,为数据管理、分析与可视化提供统一体验。
Databricks 是否比 Azure Synapse 更灵活?
是的。Databricks 更具灵活性,支持在包括 AWS、Google Cloud 与 Azure 在内的多云环境中部署,这让其成为多云战略组织的多面手之选。
在 Azure Synapse 与 Databricks 之间进行选择时有哪些成本考量?
对于稳定的工作负载,Azure Synapse 提供可预测的定价;而 Databricks 按计算用量计费,对于波动或高强度的数据处理任务更具成本效益。

首席 BI 顾问 - Power BI 认证 | Azure 认证 | 前 Microsoft | 前 Tableau | 前 Salesforce - 作者
任何希望保持竞争力的公司都必须能够高效地处理、分析并从数据中提炼洞见,因此选择合适的数据平台至关重要。
在 Azure 生态系统中,Azure Synapse Analytics 与 Databricks 是这一领域的两大代表。本文将探讨各自的功能、优势和理想使用场景,并分享我对何时应选择其一的看法。
什么是 Azure Synapse?
Azure Synapse Analytics 是一项综合分析服务,将大数据与数据仓库整合为统一体验。
作为微软 Azure 生态的一部分,它旨在满足企业在同一平台下整合数据集成、管理与分析的需求。
如果您是 Azure Synapse 新手并希望上手,可查看 DataCamp 的Azure Synapse 初学者指南。
Azure Synapse 的功能
不出所料,Azure Synapse 提供了广泛的功能。以下是最重要的几项:
Azure Synapse Analytics 生态系统。图片来源:Microsoft
什么是 Databricks?
Databricks 是基于 Apache Spark 构建的统一数据分析平台,面向大数据处理、机器学习与人工智能。尽管它也运行于 Azure 生态之内,但 Databricks 尤其适合具有复杂数据科学与工程需求的组织。
开始上手的最佳方式是查看 DataCamp 的Databricks 入门课程。
Databricks 的功能
作为一体化平台,Databricks 提供了多项令人兴奋的功能。以下是其中最突出的:
Databricks 数据湖仓架构要素。图片来源:Databricks