Cours
Comprendre la gestion et la gouvernance de Microsoft Azure
2 h
15.4K
Pour rester compétitive, toute entreprise doit pouvoir traiter, analyser et tirer des enseignements de ses données avec efficacité. Le choix de la bonne plateforme data devient donc une décision stratégique.
Deux plateformes phares de l’écosystème Azure — Azure Synapse Analytics et Databricks — s’imposent sur ce terrain. Dans cet article, nous passons en revue les fonctionnalités, atouts et cas d’usage idéaux de chacune, avec des recommandations pour savoir quand privilégier l’une ou l’autre.
Azure Synapse Analytics est un service d’analytique complet qui réunit big data et data warehousing au sein d’une expérience unifiée.
Intégré à l’écosystème Azure de Microsoft, il répond aux besoins des entreprises souhaitant centraliser l’intégration, la gestion et l’analyse des données sur une plateforme unique.
Si vous débutez avec Azure Synapse, consultez le guide pour bien commencer sur Azure Synapse de DataCamp.
Comme vous pouvez l’imaginer, Azure Synapse propose un large éventail de fonctionnalités. Voici les plus importantes :
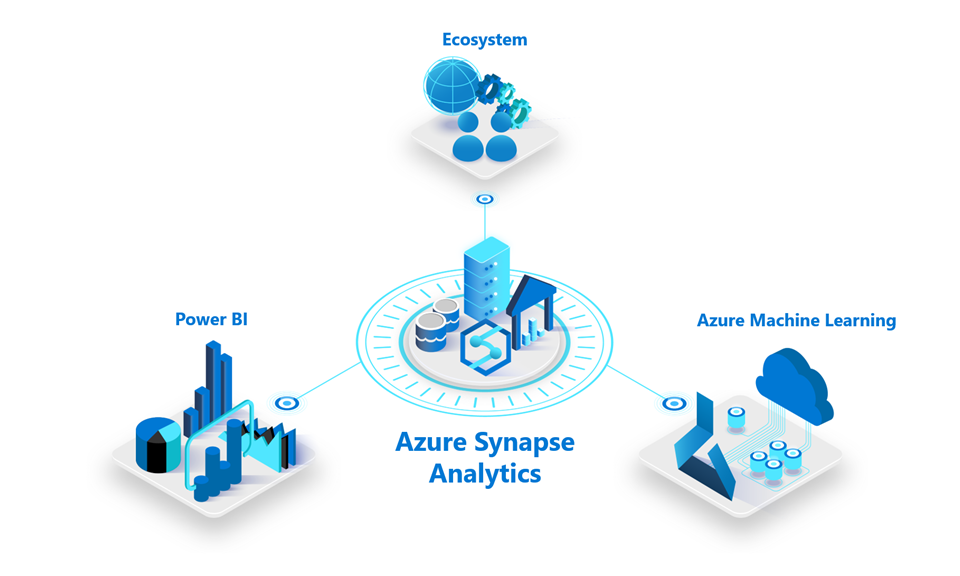
Écosystème Azure Synapse Analytics. Source : Microsoft
Databricks est une plateforme unifiée d’analytique des données, construite sur Apache Spark, conçue pour le traitement big data, le machine learning et l’IA. Également disponible dans l’écosystème Azure, Databricks convient particulièrement aux organisations ayant des besoins avancés en data science et en ingénierie des données.
Le meilleur moyen de démarrer est de suivre le cours Introduction to Databricks de DataCamp.
Plateforme complète, Databricks propose plusieurs fonctionnalités clés. Voici les principales :
Éléments d’architecture du Databricks Data Lakehouse. Source : Databricks
Lorsque l’on compare Azure Synapse et Databricks, il est essentiel de comprendre que, malgré des capacités qui se recoupent, ils répondent à des cas d’usage et à des besoins organisationnels distincts.
Azure Synapse est avant tout pensé pour l’analytique complète et le data warehousing. C’est un excellent choix pour les entreprises qui souhaitent une plateforme unifiée pour gérer de grands volumes de données, intégrer diverses sources et réaliser des analyses poussées avec un fort accent sur la business intelligence.
Databricks, de son côté, excelle dans le traitement big data, la data science et le machine learning. C’est la plateforme de référence pour exécuter des pipelines complexes, réaliser de l’analytique en temps réel et développer des modèles de machine learning à l’échelle.
Azure Synapse s’intègre nativement avec Azure Data Factory et offre de solides capacités ETL pour orchestrer des workflows de données multi-sources. C’est particulièrement efficace pour consolider des données hétérogènes dans un référentiel central pour analyse.
Databricks brille dans la gestion de pipelines complexes via Apache Spark, ce qui en fait un excellent choix pour des transformations et intégrations puissantes, notamment en environnement big data.
Azure Synapse s’intègre à Power BI, ce qui en fait un sérieux atout pour l’analytique métier et le reporting. Il propose aussi des outils intégrés pour l’analytique SQL, accessibles aux analystes business.
Databricks est plus orienté vers la data science avancée et le machine learning. Il offre un support robuste pour Python, R et Scala, ainsi que des fonctionnalités comme MLflow pour gérer les workflows ML, ce qui en fait le choix privilégié des data scientists et des ingénieurs.
Les deux plateformes offrent de bonnes performances et une forte scalabilité, mais pas forcément sur les mêmes terrains. Azure Synapse est optimisé pour le data warehousing à grande échelle, avec des requêtes efficaces sur des volumes massifs.
Databricks est inégalé pour le traitement en temps réel et s’adapte aisément aux lourdes exigences de calcul des charges big data.
L’intégration d’Azure Synapse avec Azure Data Lake Storage et Power BI est particulièrement étroite, ce qui en fait un excellent choix pour les organisations déjà fortement investies dans Azure.
Databricks, bien que intégré à Azure, offre une plus grande flexibilité de connexion à diverses sources, y compris hors Azure. Un avantage de taille pour les stratégies hybrides ou multi-cloud.
Azure Synapse propose une expérience plus intuitive, notamment pour les profils familiers de SQL et des entrepôts de données. Son espace de travail intégré simplifie l’ensemble du cycle de vie des données, y compris pour des utilisateurs moins techniques.
Databricks, extrêmement puissant, présente une courbe d’apprentissage plus marquée, surtout pour ceux qui ne maîtrisent pas Apache Spark ou les rouages du big data. Pour les data scientists et ingénieurs, son environnement collaboratif et ses fonctionnalités en font toutefois une plateforme redoutablement efficace.
Le coût est un critère déterminant dans le choix entre Azure Synapse et Databricks.
Azure Synapse propose une tarification plus prévisible via des ressources de calcul provisionnées, avantageuse pour des charges régulières. Ses options serverless offrent toutefois la flexibilité de l’usage à la demande, potentiellement moins coûteuse pour des charges intermittentes.
Databricks, de son côté, facture à l’usage du calcul, ce qui peut être économique pour des charges variables ou intenses, notamment en tirant parti du traitement en temps réel. En revanche, pour des traitements continus et massifs, la facture peut grimper rapidement : il est donc crucial d’optimiser l’usage des ressources.
Voici un tableau comparatif entre Azure Synapse Analytics et Databricks sur un large éventail de critères :
|
Catégorie |
Azure Synapse Analytics |
Databricks |
|
Vue d’ensemble |
Service d’analytique intégré pour le big data et le data warehousing. |
Plateforme d’analytique unifiée pour le big data et le machine learning. |
|
Cas d’usage principal |
Data warehousing, analytique big data, intégration de données. |
Traitement big data, data science et machine learning. |
|
Intégration des données |
Intégration native avec Synapse Pipelines (similaire à ADF). |
Nécessite l’intégration avec Azure Data Factory pour les pipelines. |
|
Stockage des données |
Intégration avec SQL Data Warehouse, Azure Data Lake et Cosmos DB. |
Optimisé pour Delta Lake et compatible avec S3, ADLS et d’autres stockages. |
|
Moteur de calcul |
Moteur de calcul basé sur SQL pour l’interrogation (dédié et serverless). |
Moteur de calcul basé sur Apache Spark, optimisé pour le big data. |
|
Scalabilité |
Hautement scalable, avec options à la demande et provisionnées. |
Hautement scalable avec clusters auto-scalés pour le big data. |
|
Traitement des données |
Prise en charge du batch et du temps réel via pools serverless et dédiés. |
Batch et temps réel avancés avec Apache Spark. |
|
Machine learning |
Intégration avec Azure Machine Learning ; support de T-SQL. |
Support natif du machine learning avec MLflow et Spark MLlib. |
|
Notebooks |
Notebooks intégrés prenant en charge T-SQL, Python, Spark SQL, Scala et R. |
Notebooks avancés avec support de Python, Scala, SQL et R. |
|
Modèle de coût |
Paiement à l’usage pour serverless et provisionné. Stockage et calcul facturés séparément. |
Paiement à l’usage pour stockage et calcul ; optimisé pour un traitement big data économique. |
|
Sécurité |
Chiffrement natif, contrôle d’accès par rôles, endpoints privés. |
Chiffrement, contrôles d’accès et intégration à Azure Active Directory (AAD). |
|
Collaboration |
Intégration avec Azure DevOps et GitHub pour le versioning. |
Fonctionnalités de collaboration étendues avec GitHub et Databricks Repos. |
|
Expérience développeur |
Simplifiée avec Synapse Studio, pipelines en glisser-déposer et intégration avec pools SQL et Spark. |
Avancée avec Databricks Workspace : notebooks intégrés, exploration de données et collaboration. |
|
Interopérabilité |
Intégration profonde avec Power BI, Azure ML, Logic Apps et autres services Azure. |
Intégré à Azure, mais prend aussi en charge le multi-cloud. |
|
Gouvernance des données |
Intégration avec Azure Purview pour la gouvernance et la traçabilité. |
Gouvernance généralement gérée en externe, par ex. avec Azure Purview. |
|
Performance des requêtes |
Haute performance sur données structurées, avec traitement distribué en pools dédiés. |
Optimisé pour données structurées et non structurées, notamment à grande échelle avec Spark. |
|
Support des outils BI |
Intégration directe avec Power BI et d’autres outils natifs Azure. |
S’intègre à Power BI, Tableau, Qlik et autres outils BI. |
|
Facilité d’utilisation |
Interface conviviale avec glisser-déposer, adaptée aux utilisateurs métier et aux data engineers. |
Plus technique, pensé pour data scientists, data engineers et développeurs. |
|
Support multi-cloud |
Principalement centré sur Azure, avec une intégration profonde à l’écosystème. |
Compatible Azure, AWS et GCP, pour une flexibilité multi-cloud. |
|
Analytique temps réel |
Prise en charge du temps réel avec Azure Stream Analytics intégré. |
Excellentes capacités temps réel via Spark Streaming. |
|
Intégration avec l’IA |
Intégration fluide avec Azure Cognitive Services et Azure Machine Learning. |
Outils IA/ML intégrés, y compris l’apprentissage profond et l’entraînement de modèles. |
|
Conformité et certifications |
Respect de nombreux standards (ISO, HIPAA, RGPD, etc.). |
Respecte également divers standards, dont RGPD, HIPAA, etc. |
|
Communauté et écosystème |
Large communauté Azure, documentation et support riches. |
Forte communauté, avec de nombreux plugins, outils et bibliothèques. |
|
Déploiement |
Service entièrement managé, mises à jour et maintenance automatiques. |
Service managé avec contrôle des configurations de cluster, auto-scaling, etc. |
|
Supervision et gestion |
Supervision intégrée via Azure Monitor, Synapse Studio et Log Analytics. |
Outils de supervision étendus, dont l’API REST Databricks et l’intégration avec Azure Monitor. |
Azure Synapse est à privilégier pour :
Databricks est idéal pour :
Choisir entre Azure Synapse et Databricks. Réalisé avec napkin.ai
Azure Synapse et Databricks sont deux plateformes puissantes, avec des atouts distincts selon les besoins des organisations.
Azure Synapse est le choix naturel pour les entreprises qui veulent une plateforme unifiée d’analytique et d’entrepôt de données, pleinement intégrée à l’écosystème Azure.
Databricks, grâce à son traitement big data, ses capacités de machine learning et d’analytique en temps réel, convient mieux aux organisations data-intensives axées sur la data science et l’ingénierie.
Au final, vos cas d’usage, votre infrastructure existante et votre stratégie data à long terme doivent guider le choix entre Azure Synapse et Databricks.
Pour aller plus loin, explorez ces ressources :
Elles vous aideront à mieux cerner les capacités de chaque plateforme et à les positionner dans votre stratégie data.
Approfondissez Azure et Databricks avec ces cours !
Cours
Cours
Cours