Kurs
Verstehen von Microsoft Azure Management und Governance
2 Std.
16.1K
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleUnternehmen, die wettbewerbsfähig bleiben wollen, müssen Daten effizient verarbeiten, analysieren und Erkenntnisse daraus gewinnen. Die Wahl der richtigen Datenplattform ist dabei eine zentrale Entscheidung.
Zwei prominente Plattformen im Azure-Ökosystem—Azure Synapse Analytics und Databricks—gehören hier zu den führenden Lösungen. In diesem Artikel beleuchten wir Funktionen, Stärken und typische Einsatzszenarien beider Produkte und geben Empfehlungen, wann welche Plattform die bessere Wahl ist.
Azure Synapse Analytics ist ein umfassender Analytics-Dienst, der Big Data und Data Warehousing in einer einheitlichen Umgebung zusammenführt.
Als Teil des Microsoft-Azure-Ökosystems ist er darauf ausgelegt, die Anforderungen von Unternehmen zu erfüllen, die Datenintegration, -verwaltung und -analyse auf einer Plattform bündeln möchten.
Wenn du neu bei Azure Synapse bist und loslegen möchtest, wirf einen Blick in DataCamps Azure Synapse Einsteiger-Guide.
Wie zu erwarten, bietet Azure Synapse eine breite Palette an Funktionen. Die wichtigsten sind:
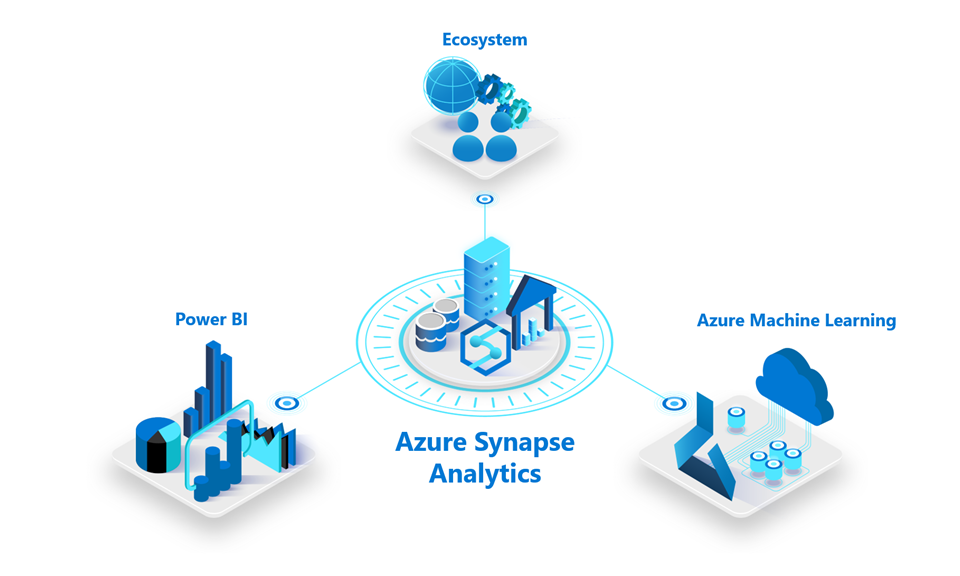
Azure Synapse Analytics Ökosystem. Bildquelle: Microsoft
Databricks ist eine einheitliche Datenanalyseplattform auf Basis von Apache Spark, entwickelt für Big-Data-Verarbeitung, Machine Learning und KI. Obwohl sie ebenfalls im Azure-Ökosystem läuft, eignet sich Databricks besonders für Organisationen mit komplexen Anforderungen in Data Science und Data Engineering.
Der beste Einstieg gelingt dir mit dem DataCamp-Kurs Introduction to Databricks.
Als umfassende Plattform bringt Databricks zahlreiche starke Features mit. Die wichtigsten sind:
Architekturelemente des Databricks Data Lakehouse. Bildquelle: Databricks
Beim Vergleich von Azure Synapse und Databricks ist wichtig zu verstehen: Obwohl sich die Fähigkeiten überschneiden, adressieren beide unterschiedliche Anwendungsfälle und Anforderungen.
Azure Synapse ist primär für umfassende Datenanalysen und Data Warehousing konzipiert. Es ist eine ausgezeichnete Wahl für Unternehmen, die eine einheitliche Plattform benötigen, um große Datenmengen zu managen, unterschiedliche Datenquellen zu integrieren und umfangreiche Analysen mit starker Business-Intelligence-Ausrichtung durchzuführen.
Databricks hingegen spielt seine Stärken bei Big-Data-Verarbeitung, Data Science und Machine Learning aus. Die Plattform ist erste Wahl, wenn komplexe Datenpipelines, Echtzeitanalysen und das Training von Machine-Learning-Modellen im großen Stil gefragt sind.
Azure Synapse arbeitet nahtlos mit Azure Data Factory zusammen und bietet robuste ETL-Funktionen, um Datenworkflows über zahlreiche Quellen zu orchestrieren. Das ist ideal, wenn Daten aus vielen Quellen für Analysen in einem zentralen Repository zusammengeführt werden sollen.
Databricks überzeugt bei komplexen Datenpipelines auf Basis von Apache Spark und ist damit ideal für Organisationen, die in Big-Data-Umgebungen starke Transformations- und Integrationsfähigkeiten benötigen.
Azure Synapse integriert sich mit Power BI und ist damit stark für Business Analytics und Reporting. Zudem stehen integrierte Tools für SQL-basierte Analysen bereit, was die Nutzung für Business-Analysten erleichtert.
Databricks ist stärker auf fortgeschrittene Data-Science- und Machine-Learning-Szenarien ausgerichtet. Es bietet umfassende Unterstützung für Python, R und Scala sowie Funktionen wie MLflow für das Management von ML-Workflows und ist daher die bevorzugte Wahl für Data Scientists und Engineers.
Beide Plattformen punkten bei Performance und Skalierbarkeit, jedoch in unterschiedlichen Bereichen. Azure Synapse ist für großskalige Data-Warehousing-Szenarien optimiert und liefert effiziente Abfrageleistung über sehr große Datensätze.
Databricks ist unschlagbar in der Echtzeitdatenverarbeitung und skaliert mühelos, um die hohen Rechenanforderungen von Big-Data-Workloads zu erfüllen.
Die Integration von Azure Synapse mit Azure Data Lake Storage und Power BI ist besonders eng. Das macht die Plattform zur hervorragenden Wahl für Unternehmen, die bereits stark im Azure-Ökosystem verankert sind.
Databricks ist ebenfalls in Azure integriert, bietet aber mehr Flexibilität beim Anschluss verschiedenster Datenquellen, auch außerhalb von Azure. Das ist ein großer Vorteil für Unternehmen mit Hybrid- oder Multi-Cloud-Strategien.
Azure Synapse bietet eine einfachere Nutzererfahrung, besonders für SQL-affine Anwender und klassisches Data Warehousing. Der integrierte Arbeitsbereich vereinfacht den gesamten Datenworkflow und ist auch für weniger technikaffine Nutzer zugänglich.
Databricks ist extrem leistungsfähig, hat aber eine steilere Lernkurve—insbesondere, wenn Apache Spark oder Big-Data-Konzepte neu sind. Für Data Scientists und Engineers macht die kollaborative Umgebung mit starken Features die Plattform jedoch hoch effektiv.
Kosten spielen bei der Wahl zwischen Azure Synapse und Databricks eine wichtige Rolle.
Azure Synapse bietet besser planbare Preise über bereitgestellte Compute-Ressourcen, was für gleichmäßige Workloads vorteilhaft ist. Die serverlosen Optionen sorgen zugleich für Flexibilität bei bedarfsorientierter Nutzung und können Kosten bei intermittierenden Lasten senken.
Databricks berechnet die Nutzung auf Basis der Compute-Ressourcen. Das kann für schwankende oder intensive Workloads kosteneffizient sein, insbesondere bei Echtzeitverarbeitung. Bei kontinuierlicher, großskaliger Datenverarbeitung können die Kosten jedoch schnell steigen—eine sorgfältige Optimierung der Compute-Nutzung ist hier entscheidend.
Die folgende Tabelle vergleicht Azure Synapse Analytics und Databricks in vielen Aspekten:
|
Kategorie |
Azure Synapse Analytics |
Databricks |
|
Überblick |
Ein integrierter Analytics-Dienst für Big Data und Data Warehousing. |
Eine einheitliche Analytics-Plattform für Big Data und Machine Learning. |
|
Primärer Use Case |
Data Warehousing, Big-Data-Analytics, Datenintegration. |
Big-Data-Verarbeitung, Data Science und Machine Learning. |
|
Datenintegration |
Integrierte Datenintegration mit Synapse Pipelines (ähnlich ADF). |
Erfordert Integration mit Azure Data Factory für Datenpipelines. |
|
Datenspeicherung |
SQL Data Warehouse, Azure Data Lake und Cosmos DB Integration. |
Optimiert für Delta Lake und integrierbar mit diversen Datenspeichern wie S3 und ADLS. |
|
Compute-Engine |
SQL-basierte Compute-Engine für Abfragen (dediziert und serverlos). |
Apache-Spark-basierte Compute-Engine, optimiert für Big-Data-Verarbeitung. |
|
Skalierbarkeit |
Hoch skalierbar mit On-Demand- und bereitgestellten Optionen. |
Hoch skalierbar mit Auto-Scaling-Clustern für Big-Data-Verarbeitung. |
|
Datenverarbeitung |
Unterstützt Batch- und Echtzeitverarbeitung über serverlose und dedizierte Pools. |
Erweiterte Batch- und Echtzeitverarbeitung mit Apache Spark. |
|
Machine Learning |
Integration mit Azure Machine Learning; Unterstützung für T-SQL. |
Integrierte ML-Unterstützung mit MLflow und Spark MLlib. |
|
Notebooks |
Integrierte Notebooks für T-SQL, Python, Spark SQL, Scala und R. |
Erweiterte Notebooks mit Unterstützung für Python, Scala, SQL und R. |
|
Kostenmodell |
Pay-as-you-go für serverlose und bereitgestellte Modelle. Datenspeicher und Compute getrennt berechnet. |
Pay-as-you-go für Speicher und Compute; optimiert für kosteneffiziente Big-Data-Verarbeitung. |
|
Sicherheit |
Integrierte Datenverschlüsselung, rollenbasierte Zugriffskontrolle und private Endpunkte. |
Datenverschlüsselung, Zugriffskontrollen und Integration mit Azure Active Directory (AAD). |
|
Zusammenarbeit |
Integration mit Azure DevOps und GitHub für Versionskontrolle. |
Umfassende Kollaborationsfunktionen mit GitHub und Databricks Repos. |
|
Developer Experience |
Vereinfacht durch Synapse Studio: Drag-and-Drop-Pipelines und Integration mit SQL- und Spark-Pools. |
Fortgeschritten mit Databricks Workspace: integrierte Notebooks, Datenexploration und Kollaboration. |
|
Interoperabilität |
Tiefe Integration mit Azure-Diensten wie Power BI, Azure ML und Logic Apps. |
In Azure integriert, unterstützt aber auch Multi-Cloud-Umgebungen. |
|
Data Governance |
Integration mit Azure Purview für Data Governance und Lineage-Tracking. |
Data Governance meist extern gemanagt, z. B. mit Azure Purview. |
|
Abfrageperformance |
Hohe Leistung für strukturierte Daten mit verteilter Abfrageverarbeitung in dedizierten Pools. |
Optimiert für strukturierte und unstrukturierte Daten, besonders bei großskaliger Spark-Verarbeitung. |
|
Unterstützung für BI-Tools |
Direkte Integration mit Power BI und anderen Azure-nativen Tools. |
Integrationen mit Power BI, Tableau, Qlik und weiteren BI-Tools. |
|
Benutzerfreundlichkeit |
Intuitive Oberfläche mit Drag-and-Drop, geeignet für Business-User und Data Engineers. |
Technischer ausgerichtet für Data Scientists, Data Engineers und Developer. |
|
Multi-Cloud-Support |
Primär Azure-zentriert mit tiefer Integration ins Azure-Ökosystem. |
Unterstützt Azure, AWS und GCP und ermöglicht Multi-Cloud-Flexibilität. |
|
Echtzeitanalysen |
Unterstützt Echtzeitanalysen über integriertes Azure Stream Analytics. |
Starke Echtzeitfähigkeiten mit Spark Streaming. |
|
Integration mit KI |
Nahtlose Integration mit Azure Cognitive Services und Azure Machine Learning. |
Integrierte KI/ML-Tools mit Support für Deep Learning und KI-Training. |
|
Compliance und Zertifizierungen |
Erfüllt diverse Industriestandards, inkl. ISO, HIPAA und DSGVO. |
Erfüllt ebenfalls verschiedene Standards und unterstützt DSGVO, HIPAA etc. |
|
Community und Ökosystem |
Große Azure-Community mit umfangreicher Doku und Support. |
Starke Community mit vielen Plugins, Tools und Bibliotheken. |
|
Bereitstellung |
Voll verwalteter Dienst mit automatischen Updates und Wartung. |
Verwalteter Dienst mit Kontrolle über Cluster-Konfigurationen, Auto-Scaling u. v. m. |
|
Monitoring und Management |
Integriertes Monitoring via Azure Monitor, Synapse Studio und Log Analytics. |
Umfangreiche Monitoring-Tools inkl. Databricks REST API und Integration mit Azure Monitor. |
Azure Synapse ist die bevorzugte Wahl für:
Databricks eignet sich ideal für:
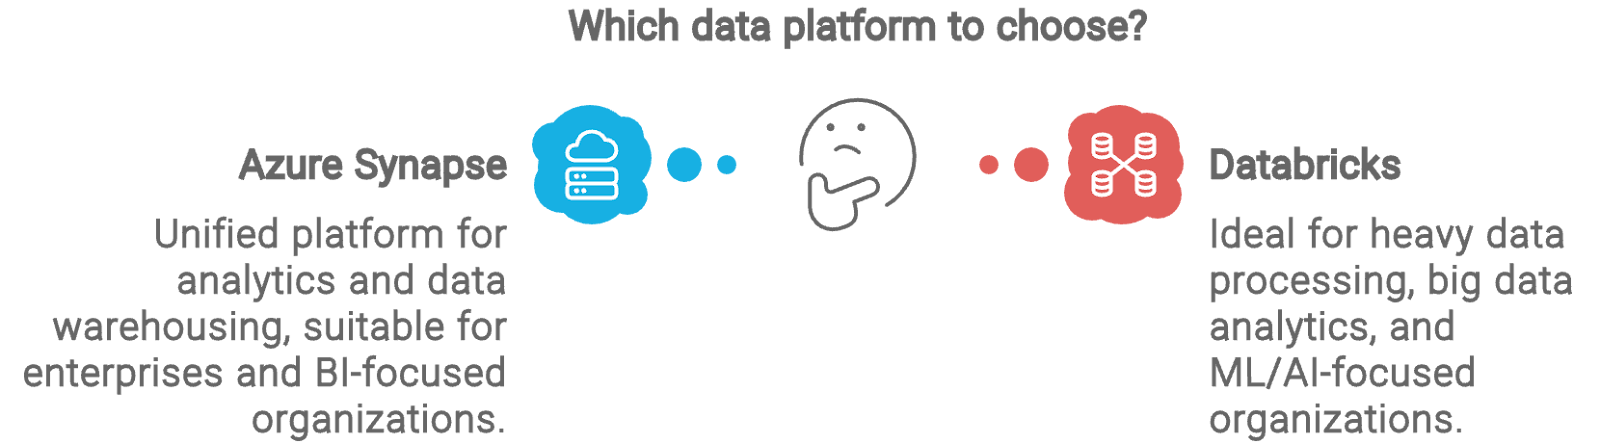
Die Wahl zwischen Azure Synapse und Databricks. Erstellt mit napkin.ai
Azure Synapse und Databricks sind beides leistungsstarke Plattformen mit individuellen Stärken für unterschiedliche Anforderungen.
Azure Synapse ist die bevorzugte Lösung für Unternehmen, die eine einheitliche Analytics- und Warehousing-Plattform im Azure-Ökosystem suchen.
Databricks punktet mit starker Big-Data-Verarbeitung, Machine Learning und Echtzeitanalysen und ist damit besser für datenintensive Organisationen mit Fokus auf Data Science und Engineering geeignet.
Am Ende sollten deine konkreten Use Cases, die bestehende Infrastruktur und deine langfristige Datenstrategie die Entscheidung zwischen Azure Synapse und Databricks leiten.
Für weitere Einblicke empfiehlt sich ein Blick in diese Ressourcen:
So verstehst du die Fähigkeiten beider Plattformen besser und findest heraus, wie sie in deine Datenstrategie passen!
Lerne mehr über Azure und Databricks mit diesen Kursen!
Kurs
Kurs
Üben und Lernpfad deinen Fortschritt.
Weiter Mit GoogleBlog
Nisha Arya Ahmed
15 Min.
Blog
Blog
Nathaniel Taylor-Leach
4 Min.
Tutorial
Matt Crabtree
5 Min.
Tutorial
Sejal Jaiswal
24 Min.
Tutorial
Mark Pedigo
10 Min.