欢迎来到为期一个月的数据解密系列的收官之作。作为数据素养月的一部分,本系列旨在厘清数据领域中的关键概念,并尝试回答那些您可能不敢开口的问题。若想从头开始,请阅读本系列首篇文章:什么是数据集?
在本文中,我们将延续上篇数据解密文章的主题,探讨 AI 的潜在有害影响、它如何加剧对特定人群的偏见,以及每个人都应了解的各种 AI 偏见类型。
AI 偏见的问题何在
当今大多数 AI 系统都利用机器学习。按照定义,机器学习运用先进的统计技术,从历史数据中学习规律,并对未来事件进行预测。
机器学习的广泛采用,带来了偏见性预测案例的急剧增加。存在偏见的 AI 算法一直是 AI 社群的严重关切,其根源在于用于训练模型的数据。偏见可以以多种形式呈现——它可能是社会性的或结构性的,且可能针对特定的性别、肤色、宗教或国籍。
因此,AI 算法在模仿人类判断的过程中,会从训练数据中学到偏见。让我们回顾几个既往案例,这些带有偏见的 AI 预测曾对社会乃至整个人类造成负面影响:
性别偏见:Amazon 的招聘引擎
Amazon 开发了一套招聘引擎,用于自动筛选应聘者简历以安排后续面试。然而,该算法从历史数据中学习到的偏见被反映出来,最终只选择了男性候选人的资料。
种族偏见:PredPol 算法
PredPol(预测性警务)绘制了高犯罪活动区域的热力图,并将少数族裔聚集的地点标记为“热点”。该算法训练所用的输入数据本身就存在偏见,其中包含了这些地区大量被报告的刑事案件。
种族偏见:COMPAS 算法
替代性制裁的罪犯矫正管理画像(COMPAS)软件被用于评估罪犯再犯的可能性。然而,2016 年的一项调查发现该算法存在偏见。该软件将黑人罪犯标记为比白人罪犯更可能再犯。
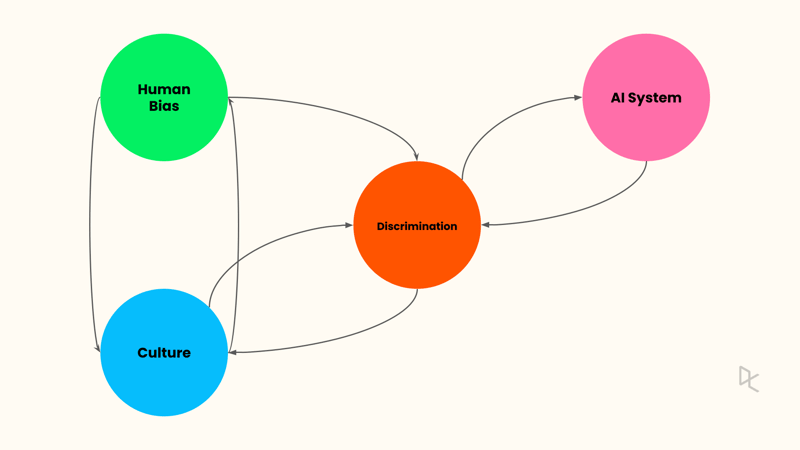
从上述案例可见,机器学习算法除了学习数据中的一般规律外,也会学习其中的偏见。若不从源头加以处理,偏见会在 AI/ML 流水线中以多种形式显现。随着 AI 在组织与社会中的普及,人人都应了解 AI 系统的不同偏见类型。以下是 AI 中最常见的三类偏见。
三种常见的 AI 偏见
成见偏见(Prejudice bias)
当训练数据反映了现存的成见、刻板印象与社会假设,这些偏见就会嵌入到学得的模型中;这类偏见被称为成见偏见。例如,当您搜索“doctor(医生)”时,搜索结果多为男性医生的图片;而搜索“nurse(护士)”时,结果多为女性护士的图片。这充分体现了基于性别的社会刻板印象。
样本选择偏差(Sample Selection Bias)
当训练数据不能代表所研究的总体时,就会出现样本选择偏差。一个例子是训练用于检测皮肤癌的 AI 系统。如果原始数据集不能代表更广泛的人群,该系统在数据集中代表性不足的人群中表现就会不佳。
测量偏差(Measurement Bias)
测量偏差源于数据收集或测量过程中的错误。例如,若为图像识别系统提供数据的相机成像质量较差,就可能导致针对特定人群的偏倚结果。另一种情况来自人的判断。例如,一个医学诊断算法若基于就诊次数等代理指标而非实际症状来训练预测患病可能性,也会引入偏差。
培养数据素养,迈向负责任的 AI
整整一个月里,我们都在强调个人与组织的数据素养之重要。数据素养使非技术相关方能够与数据与 AI 专家对话,并理解 AI 系统的局限。更重要的是,它促成领域专家与 AI 专家的双向交流,从而就某个 AI 系统的潜在危害展开审慎讨论。
为帮助您掌握参与这类对话所需的知识,请学习我们的《人人都能懂的机器学习》课程,开启您的数据素养之旅。若想获取更多数据素养与数据解密内容,欢迎查阅以下资源:

欢迎来到为期一个月的数据解密系列的收官之作。作为数据素养月的一部分,本系列旨在厘清数据领域中的关键概念,并尝试回答那些您可能不敢开口的问题。若想从头开始,请阅读本系列首篇文章:什么是数据集?
在本文中,我们将延续上篇数据解密文章的主题,探讨 AI 的潜在有害影响、它如何加剧对特定人群的偏见,以及每个人都应了解的各种 AI 偏见类型。
AI 偏见的问题何在
当今大多数 AI 系统都利用机器学习。按照定义,机器学习运用先进的统计技术,从历史数据中学习规律,并对未来事件进行预测。
机器学习的广泛采用,带来了偏见性预测案例的急剧增加。存在偏见的 AI 算法一直是 AI 社群的严重关切,其根源在于用于训练模型的数据。偏见可以以多种形式呈现——它可能是社会性的或结构性的,且可能针对特定的性别、肤色、宗教或国籍。
因此,AI 算法在模仿人类判断的过程中,会从训练数据中学到偏见。让我们回顾几个既往案例,这些带有偏见的 AI 预测曾对社会乃至整个人类造成负面影响:
性别偏见:Amazon 的招聘引擎
Amazon 开发了一套招聘引擎,用于自动筛选应聘者简历以安排后续面试。然而,该算法从历史数据中学习到的偏见被反映出来,最终只选择了男性候选人的资料。
种族偏见:PredPol 算法
PredPol(预测性警务)绘制了高犯罪活动区域的热力图,并将少数族裔聚集的地点标记为“热点”。该算法训练所用的输入数据本身就存在偏见,其中包含了这些地区大量被报告的刑事案件。
种族偏见:COMPAS 算法
替代性制裁的罪犯矫正管理画像(COMPAS)软件被用于评估罪犯再犯的可能性。然而,2016 年的一项调查发现该算法存在偏见。该软件将黑人罪犯标记为比白人罪犯更可能再犯。
从上述案例可见,机器学习算法除了学习数据中的一般规律外,也会学习其中的偏见。若不从源头加以处理,偏见会在 AI/ML 流水线中以多种形式显现。随着 AI 在组织与社会中的普及,人人都应了解 AI 系统的不同偏见类型。以下是 AI 中最常见的三类偏见。
三种常见的 AI 偏见
成见偏见(Prejudice bias)
当训练数据反映了现存的成见、刻板印象与社会假设,这些偏见就会嵌入到学得的模型中;这类偏见被称为成见偏见。例如,当您搜索“doctor(医生)”时,搜索结果多为男性医生的图片;而搜索“nurse(护士)”时,结果多为女性护士的图片。这充分体现了基于性别的社会刻板印象。
样本选择偏差(Sample Selection Bias)
当训练数据不能代表所研究的总体时,就会出现样本选择偏差。一个例子是训练用于检测皮肤癌的 AI 系统。如果原始数据集不能代表更广泛的人群,该系统在数据集中代表性不足的人群中表现就会不佳。
测量偏差(Measurement Bias)
测量偏差源于数据收集或测量过程中的错误。例如,若为图像识别系统提供数据的相机成像质量较差,就可能导致针对特定人群的偏倚结果。另一种情况来自人的判断。例如,一个医学诊断算法若基于就诊次数等代理指标而非实际症状来训练预测患病可能性,也会引入偏差。
培养数据素养,迈向负责任的 AI
整整一个月里,我们都在强调个人与组织的数据素养之重要。数据素养使非技术相关方能够与数据与 AI 专家对话,并理解 AI 系统的局限。更重要的是,它促成领域专家与 AI 专家的双向交流,从而就某个 AI 系统的潜在危害展开审慎讨论。
为帮助您掌握参与这类对话所需的知识,请学习我们的《人人都能懂的机器学习》课程,开启您的数据素养之旅。若想获取更多数据素养与数据解密内容,欢迎查阅以下资源: