Welkom bij het laatste deel van onze maandlange serie Data ontrafeld. Als onderdeel van Data Literacy Month heeft deze serie kernbegrippen uit de wereld van data verduidelijkt en geprobeerd vragen te beantwoorden die je misschien niet durfde te stellen. Wil je bij het begin beginnen? Lees dan onze eerste bijdrage in de serie: Wat is een dataset?
In deze bijdrage gaan we verder op het thema uit de vorige aflevering van Data ontrafeld en bespreken we de mogelijk schadelijke effecten van AI, hoe het vooroordelen tegen bepaalde groepen kan bestendigen en de verschillende soorten AI-bias waar iedereen zich bewust van zou moeten zijn.
Het probleem met AI-bias
De meeste AI-systemen van vandaag maken gebruik van machine learning. Machine learning past, volgens de definitie, geavanceerde statistische technieken toe om patronen uit historische data te leren en voorspellingen te doen voor toekomstige gebeurtenissen.
De brede adoptie van machine learning heeft geleid tot een sterke toename van gevallen waarin een bevooroordeelde voorspelling is gedaan. Bevooroordeelde AI-algoritmen zijn een serieuze zorg binnen de AI-gemeenschap en zijn een product van de data die gebruikt wordt om modellen te trainen. Bias kan zich in vele vormen uiten—het kan maatschappelijk of structureel zijn en gericht zijn op een bepaald gender, huidskleur, religie of nationaliteit.
Als gevolg daarvan nemen AI-algoritmen vooroordelen over uit de trainingsdata, omdat ze menselijk oordeel proberen na te bootsen. Laten we een paar voorbeelden uit het verleden bekijken waarin bevooroordeelde AI-voorspellingen de samenleving en mensheid als geheel negatief hebben beïnvloed:
Gendervooroordeel: de wervingsengine van Amazon
Amazon ontwikkelde een wervingsengine om cv's van sollicitanten automatisch te screenen voor vervolggesprekken. Het algoritme weerspiegelde echter de bias die het uit historische data had geleerd en koos uiteindelijk alleen profielen van mannelijke kandidaten.
Raciaal vooroordeel: PredPol-algoritme
PredPol, of Predictive Policing, maakte een heatmap van gebieden met veel criminele activiteit en bestempelde locaties met minderheden als hotspots. Het algoritme was getraind op bevooroordeelde invoergegevens die bestonden uit verschillende gemelde incidenten uit dergelijke gebieden.
Raciaal vooroordeel: COMPAS-algoritme
Correctional Offender Management Profiling for Alternative Sanctions (COMPAS)-software werd gebruikt om de kans op recidive bij een dader in te schatten. Tijdens een onderzoek in 2016 bleek het algoritme bevooroordeeld. De software bestempelde zwarte verdachten als waarschijnlijker om opnieuw in de fout te gaan dan witte verdachten.
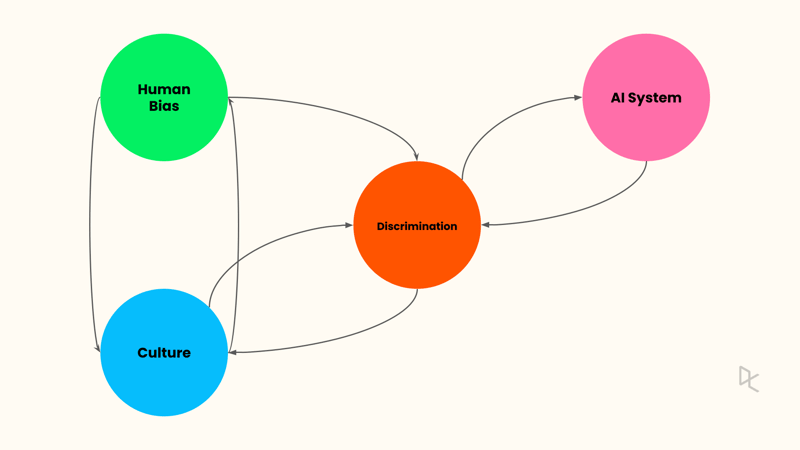
Zoals uit bovenstaande voorbeelden blijkt, leren machinelearning-algoritmen naast andere patronen ook vooroordelen uit de trainingsdata. Tenzij bij de bron aangepakt, kan bias zich op meerdere manieren manifesteren in AI/ML-pijplijnen. Nu AI steeds breder wordt ingezet in organisaties en de samenleving, is het belangrijk dat iedereen de verschillende soorten bias in AI-systemen kent. Hieronder staan drie van de meest voorkomende vormen van AI-bias.
Drie veelvoorkomende soorten AI-bias
Vooringenomenheid door vooroordelen
Wanneer de trainingsdata bestaande vooroordelen, stereotypen en maatschappelijke aannames weerspiegelen, worden deze biases ingebed in het geleerde model; zo'n bias wordt vooringenomenheid door vooroordelen genoemd. Zoek je bijvoorbeeld op “doctor”, dan bestaat het zoekresultaat uit veel afbeeldingen van mannelijke artsen. Terwijl een soortgelijke zoekopdracht naar “nurse” juist veel vrouwelijke verpleegkundigen oplevert. Dit zegt veel over maatschappelijke, gendergebonden stereotypen.
Steekproefselectiebias
Steekproefselectiebias treedt op wanneer de trainingsdata niet representatief zijn voor de onderzochte populatie. Een voorbeeld zijn AI-systemen die getraind zijn om huidkanker te detecteren. Als de oorspronkelijke dataset niet representatief is voor de bredere bevolking, zal dit systeem slechter presteren voor leden van een ondervertegenwoordigde groep in de dataset.
Meetsysteem-bias
Meetsysteem-bias ontstaat door een fout in het proces van dataverzameling of -meting. Als bijvoorbeeld de beelden van een camera die data aanlevert voor een beeldherkenningssysteem van slechte kwaliteit zijn, kan dit leiden tot bevooroordeelde resultaten tegen specifieke populaties. Een ander voorbeeld kan voortkomen uit menselijk oordeel. Zo kan een medisch diagnose-algoritme getraind worden om de kans op ziekte te voorspellen op basis van proxymetingen, zoals doktersbezoeken, in plaats van daadwerkelijke symptomen.
Datawijsheid ontwikkelen voor verantwoorde AI
Deze maand hebben we het belang van datawijsheid voor individuen en organisaties benadrukt. Datawijsheid stelt niet-technische stakeholders in staat om met data- en AI-experts in gesprek te gaan en de beperkingen van AI-systemen te begrijpen. Belangrijker nog, het bevordert een tweerichtingsgesprek tussen inhoudsexperts en AI-experts, waardoor er doordacht kan worden gesproken over de mogelijke schade van een AI-systeem.
Wil je jezelf uitrusten met de kennis om deze gesprekken te voeren? Volg dan onze cursus Understanding Machine Learning en start je datawijsheidstraject. Voor meer content over datawijsheid en Data ontrafeld, bekijk de volgende bronnen:


 Adel Nehme · 15 min
Welkom bij het laatste deel van onze maandlange serie Data ontrafeld. Als onderdeel van Data Literacy Month heeft deze serie kernbegrippen uit de wereld van data verduidelijkt en geprobeerd vragen te beantwoorden die je misschien niet durfde te stellen. Wil je bij het begin beginnen? Lees dan onze eerste bijdrage in de serie: Wat is een dataset?
In deze bijdrage gaan we verder op het thema uit de vorige aflevering van Data ontrafeld en bespreken we de mogelijk schadelijke effecten van AI, hoe het vooroordelen tegen bepaalde groepen kan bestendigen en de verschillende soorten AI-bias waar iedereen zich bewust van zou moeten zijn.
Het probleem met AI-bias
De meeste AI-systemen van vandaag maken gebruik van machine learning. Machine learning past, volgens de definitie, geavanceerde statistische technieken toe om patronen uit historische data te leren en voorspellingen te doen voor toekomstige gebeurtenissen.
De brede adoptie van machine learning heeft geleid tot een sterke toename van gevallen waarin een bevooroordeelde voorspelling is gedaan. Bevooroordeelde AI-algoritmen zijn een serieuze zorg binnen de AI-gemeenschap en zijn een product van de data die gebruikt wordt om modellen te trainen. Bias kan zich in vele vormen uiten—het kan maatschappelijk of structureel zijn en gericht zijn op een bepaald gender, huidskleur, religie of nationaliteit.
Als gevolg daarvan nemen AI-algoritmen vooroordelen over uit de trainingsdata, omdat ze menselijk oordeel proberen na te bootsen. Laten we een paar voorbeelden uit het verleden bekijken waarin bevooroordeelde AI-voorspellingen de samenleving en mensheid als geheel negatief hebben beïnvloed:
Gendervooroordeel: de wervingsengine van Amazon
Amazon ontwikkelde een wervingsengine om cv's van sollicitanten automatisch te screenen voor vervolggesprekken. Het algoritme weerspiegelde echter de bias die het uit historische data had geleerd en koos uiteindelijk alleen profielen van mannelijke kandidaten.
Raciaal vooroordeel: PredPol-algoritme
PredPol, of Predictive Policing, maakte een heatmap van gebieden met veel criminele activiteit en bestempelde locaties met minderheden als hotspots. Het algoritme was getraind op bevooroordeelde invoergegevens die bestonden uit verschillende gemelde incidenten uit dergelijke gebieden.
Raciaal vooroordeel: COMPAS-algoritme
Correctional Offender Management Profiling for Alternative Sanctions (COMPAS)-software werd gebruikt om de kans op recidive bij een dader in te schatten. Tijdens een onderzoek in 2016 bleek het algoritme bevooroordeeld. De software bestempelde zwarte verdachten als waarschijnlijker om opnieuw in de fout te gaan dan witte verdachten.
Zoals uit bovenstaande voorbeelden blijkt, leren machinelearning-algoritmen naast andere patronen ook vooroordelen uit de trainingsdata. Tenzij bij de bron aangepakt, kan bias zich op meerdere manieren manifesteren in AI/ML-pijplijnen. Nu AI steeds breder wordt ingezet in organisaties en de samenleving, is het belangrijk dat iedereen de verschillende soorten bias in AI-systemen kent. Hieronder staan drie van de meest voorkomende vormen van AI-bias.
Drie veelvoorkomende soorten AI-bias
Vooringenomenheid door vooroordelen
Wanneer de trainingsdata bestaande vooroordelen, stereotypen en maatschappelijke aannames weerspiegelen, worden deze biases ingebed in het geleerde model; zo'n bias wordt vooringenomenheid door vooroordelen genoemd. Zoek je bijvoorbeeld op “doctor”, dan bestaat het zoekresultaat uit veel afbeeldingen van mannelijke artsen. Terwijl een soortgelijke zoekopdracht naar “nurse” juist veel vrouwelijke verpleegkundigen oplevert. Dit zegt veel over maatschappelijke, gendergebonden stereotypen.
Steekproefselectiebias
Steekproefselectiebias treedt op wanneer de trainingsdata niet representatief zijn voor de onderzochte populatie. Een voorbeeld zijn AI-systemen die getraind zijn om huidkanker te detecteren. Als de oorspronkelijke dataset niet representatief is voor de bredere bevolking, zal dit systeem slechter presteren voor leden van een ondervertegenwoordigde groep in de dataset.
Meetsysteem-bias
Meetsysteem-bias ontstaat door een fout in het proces van dataverzameling of -meting. Als bijvoorbeeld de beelden van een camera die data aanlevert voor een beeldherkenningssysteem van slechte kwaliteit zijn, kan dit leiden tot bevooroordeelde resultaten tegen specifieke populaties. Een ander voorbeeld kan voortkomen uit menselijk oordeel. Zo kan een medisch diagnose-algoritme getraind worden om de kans op ziekte te voorspellen op basis van proxymetingen, zoals doktersbezoeken, in plaats van daadwerkelijke symptomen.
Datawijsheid ontwikkelen voor verantwoorde AI
Deze maand hebben we het belang van datawijsheid voor individuen en organisaties benadrukt. Datawijsheid stelt niet-technische stakeholders in staat om met data- en AI-experts in gesprek te gaan en de beperkingen van AI-systemen te begrijpen. Belangrijker nog, het bevordert een tweerichtingsgesprek tussen inhoudsexperts en AI-experts, waardoor er doordacht kan worden gesproken over de mogelijke schade van een AI-systeem.
Wil je jezelf uitrusten met de kennis om deze gesprekken te voeren? Volg dan onze cursus Understanding Machine Learning en start je datawijsheidstraject. Voor meer content over datawijsheid en Data ontrafeld, bekijk de volgende bronnen: