DataCamp 如何打造一流的数据科学课程体系
在 DataCamp,我们以拥有学习数据科学的最佳平台与最佳课程体系为傲。为此,我们投入大量精力,确保每一道练习既高效易学,又富有乐趣。课程上线后,我们并不认为工作就此完成:上线只是数据收集的开始。每当学员在课程中尝试一道练习时,我们都会记录一些数据点,例如他们解出题目所需的尝试次数,以及是否通过查看提示或答案来获得帮助。通过汇总所有学员的数据,我们可以判断一项练习的难度。此外,学员还能为练习打分(一星到五星)并提供反馈,让我们了解这道练习的受欢迎程度。
我们的内容质量团队会与授课讲师合作,基于这些数据改进课程。由于练习中可能出现的问题各不相同,改进的形式也多种多样。
1. 修正缺失数据
有时,小问题也会让很多学员困扰。在 Data Science Toolbox(第 1 部分)中,学员使用基于 J.R.R. 托尔金《魔戒》三部曲之《护戒同盟》的数据集来学习编写 Python 的 lambda 函数。不巧的是,数据集中缺少了甘道夫和皮聘。我们的学员理所当然地提出了意见,于是我们倾听并修复了这个问题。

2. 规避 DataCamp 学员的误解与困惑
对大量练习的反馈进行分析,能揭示学员常见的认知误区。许多数据分析会将数据保持为“矩形”形式,即每一行代表一条记录,每一列是该记录的一个取值。例如,每一行可对应一个人,而列则是姓名、身高和最喜欢的颜色。
一个非常常见的数据处理操作是对这类“矩形数据”的行进行筛选。讲师可能会写出这样的指令:
筛选数据集,移除身高低于 170cm 的人对应的行。
这并非不可以,但大多数统计软件(包括 R 的 dplyr 包和 Python 的 Pandas 包)都要求您通过指定“要保留的内容”来筛选数据集。如果将指令改写为:
筛选数据集,保留身高高于 170cm 的人对应的行。
那么该表述就与代码的工作方式一致,能避免学员产生困惑。对于要求学员已熟悉数据处理的进阶课程,这种表述差异的问题会小一些。在我们的 Pandas Foundations 课程中,我们发现许多学员在这一点上遇到了困难,于是调整了用语。
3. 通过更全面与更细化的反馈打造顺畅的学习路径
所有 DataCamp 练习都由我们的内容工程团队构建的软件自动评分。这使得当学员答错时,可以即时获得智能化反馈。这或许是我们平台最大的特色。最难之处在于预判学员可能犯的错误,从而为他们下次“如何改进”提供有效建议。这也意味着偶尔会出现“正确解答被判错”的情况。一旦发生这种事,学员会非常反感。曾有学员如此抱怨:
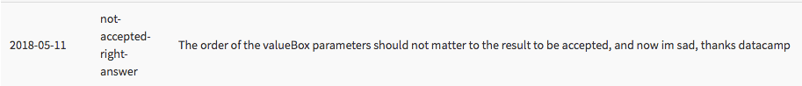
在我们的 Cluster Analysis in R 课程中,很多学员发现,虽然练习的参考答案用的是众所周知的 min() 函数来计算最小值,但还有一个更简单优雅的方案:使用较少人了解的并行最小值函数 pmin()。

最初,这道练习只允许一种解法,但基于学员的巧思,现在两种解法都可被接受。内容工程团队在开发 DataCamp 反馈系统时的目标之一,就是提升评分的灵活性,让学员能够以自己的方式解决问题。
学员在使用我们的自动化反馈时,另一种可能的挫败感是:在同一道练习中反复看到同一条反馈。下图展示了这一现象的原理:学员被要求创建一个包含三个元素的 Python 数组。
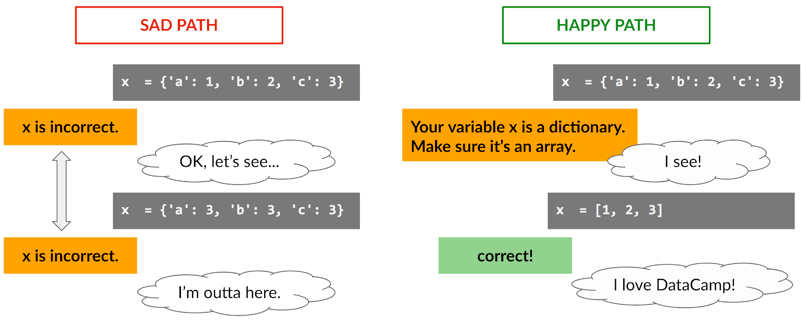
通过提供更细化的反馈,针对学员答案中的具体问题逐一指出,我们可以带来更积极的学习体验。改进反馈的效果令人鼓舞。在我们的 Intermediate Python for Data Science 课程中的一道练习里,切换到细化反馈后,重复看到同一条反馈信息的学员比例从约 65% 降至不足 10%。
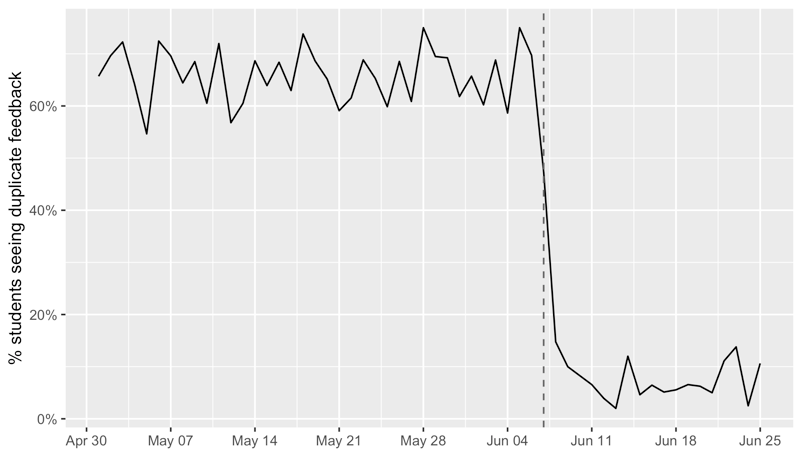
“重复看到同一条反馈信息的用户比例”是我们对所有练习与课程都会监测的指标。结合课程的受欢迎程度,我们建立了一套数据驱动的方法,以最具影响力的方式持续改进学习体验。
结语
我们今年的目标是:对于最受欢迎的一半课程,每门课程所有练习的“重复反馈比例”平均值降至 30% 以下。
我们将把这些改进持续推广到 DataCamp 所覆盖的全部技术之中。内部我们也在改进用于生成反馈和分析学员提交的工具,确保持续优化所有现有与未来内容的学习体验。
练习中可能出问题的地方还有很多,但希望这些内容能让您相信:DataCamp 重视学员反馈,并在不断努力提升大家对我们课程的满意度。

DataCamp 如何打造一流的数据科学课程体系
在 DataCamp,我们以拥有学习数据科学的最佳平台与最佳课程体系为傲。为此,我们投入大量精力,确保每一道练习既高效易学,又富有乐趣。课程上线后,我们并不认为工作就此完成:上线只是数据收集的开始。每当学员在课程中尝试一道练习时,我们都会记录一些数据点,例如他们解出题目所需的尝试次数,以及是否通过查看提示或答案来获得帮助。通过汇总所有学员的数据,我们可以判断一项练习的难度。此外,学员还能为练习打分(一星到五星)并提供反馈,让我们了解这道练习的受欢迎程度。
我们的内容质量团队会与授课讲师合作,基于这些数据改进课程。由于练习中可能出现的问题各不相同,改进的形式也多种多样。
1. 修正缺失数据
有时,小问题也会让很多学员困扰。在 Data Science Toolbox(第 1 部分)中,学员使用基于 J.R.R. 托尔金《魔戒》三部曲之《护戒同盟》的数据集来学习编写 Python 的 lambda 函数。不巧的是,数据集中缺少了甘道夫和皮聘。我们的学员理所当然地提出了意见,于是我们倾听并修复了这个问题。
2. 规避 DataCamp 学员的误解与困惑
对大量练习的反馈进行分析,能揭示学员常见的认知误区。许多数据分析会将数据保持为“矩形”形式,即每一行代表一条记录,每一列是该记录的一个取值。例如,每一行可对应一个人,而列则是姓名、身高和最喜欢的颜色。
一个非常常见的数据处理操作是对这类“矩形数据”的行进行筛选。讲师可能会写出这样的指令:
筛选数据集,移除身高低于 170cm 的人对应的行。
这并非不可以,但大多数统计软件(包括 R 的 dplyr 包和 Python 的 Pandas 包)都要求您通过指定“要保留的内容”来筛选数据集。如果将指令改写为:
筛选数据集,保留身高高于 170cm 的人对应的行。
那么该表述就与代码的工作方式一致,能避免学员产生困惑。对于要求学员已熟悉数据处理的进阶课程,这种表述差异的问题会小一些。在我们的 Pandas Foundations 课程中,我们发现许多学员在这一点上遇到了困难,于是调整了用语。
3. 通过更全面与更细化的反馈打造顺畅的学习路径
所有 DataCamp 练习都由我们的内容工程团队构建的软件自动评分。这使得当学员答错时,可以即时获得智能化反馈。这或许是我们平台最大的特色。最难之处在于预判学员可能犯的错误,从而为他们下次“如何改进”提供有效建议。这也意味着偶尔会出现“正确解答被判错”的情况。一旦发生这种事,学员会非常反感。曾有学员如此抱怨:
在我们的 Cluster Analysis in R 课程中,很多学员发现,虽然练习的参考答案用的是众所周知的 min() 函数来计算最小值,但还有一个更简单优雅的方案:使用较少人了解的并行最小值函数 pmin()。
最初,这道练习只允许一种解法,但基于学员的巧思,现在两种解法都可被接受。内容工程团队在开发 DataCamp 反馈系统时的目标之一,就是提升评分的灵活性,让学员能够以自己的方式解决问题。
学员在使用我们的自动化反馈时,另一种可能的挫败感是:在同一道练习中反复看到同一条反馈。下图展示了这一现象的原理:学员被要求创建一个包含三个元素的 Python 数组。
通过提供更细化的反馈,针对学员答案中的具体问题逐一指出,我们可以带来更积极的学习体验。改进反馈的效果令人鼓舞。在我们的 Intermediate Python for Data Science 课程中的一道练习里,切换到细化反馈后,重复看到同一条反馈信息的学员比例从约 65% 降至不足 10%。
“重复看到同一条反馈信息的用户比例”是我们对所有练习与课程都会监测的指标。结合课程的受欢迎程度,我们建立了一套数据驱动的方法,以最具影响力的方式持续改进学习体验。
结语
我们今年的目标是:对于最受欢迎的一半课程,每门课程所有练习的“重复反馈比例”平均值降至 30% 以下。
我们将把这些改进持续推广到 DataCamp 所覆盖的全部技术之中。内部我们也在改进用于生成反馈和分析学员提交的工具,确保持续优化所有现有与未来内容的学习体验。
练习中可能出问题的地方还有很多,但希望这些内容能让您相信:DataCamp 重视学员反馈,并在不断努力提升大家对我们课程的满意度。