DataCamp सर्वश्रेष्ठ डेटा साइंस पाठ्यक्रम कैसे बनाता है
DataCamp में, हमें इस बात पर गर्व है कि हमारे पास डेटा साइंस सीखने के लिए सबसे अच्छा प्लेटफ़ॉर्म और सर्वश्रेष्ठ पाठ्यक्रम-संग्रह है। इसी उद्देश्य से, हम यह सुनिश्चित करने में बहुत मेहनत करते हैं कि हर अभ्यास शिक्षण के लिए प्रभावी और करने में आनंददायक हो। कोई कोर्स लॉन्च होने के बाद भी हम उसे अंतिम नहीं मानते: लॉन्च तो डेटा संग्रह की बस शुरुआत है। जब भी कोई छात्र किसी अभ्यास को हल करने की कोशिश करता है, हम ऐसे डेटा पॉइंट्स जुटाते हैं जैसे उसे हल करने में कितने प्रयास लगे, और क्या उसे संकेत या समाधान मांगकर सहायता की आवश्यकता पड़ी। अपने सभी छात्रों के बीच इस डेटा को एकत्रित करके, हम समझ पाते हैं कि कोई अभ्यास कितना कठिन है। इसके अतिरिक्त, छात्र अभ्यासों को एक से पाँच सितारों तक रेट कर सकते हैं और हमें प्रतिक्रिया दे सकते हैं, जिससे हमें पता चलता है कि कोई अभ्यास छात्रों को कितना पसंद आया।
हमारी कंटेंट क्वालिटी टीम इस डेटा के आधार पर कोर्स बेहतर बनाने के लिए प्रशिक्षकों के साथ काम करती है। यह कई रूपों में होता है, क्योंकि किसी अभ्यास में कई तरह की बातें गलत हो सकती हैं।
1. गायब डेटा को ठीक करना
कभी-कभी छोटी-सी बात भी बहुत से छात्रों को परेशान कर देती है। Data Science Toolbox (Part 1) में, छात्र J.R.R. Tolkien की Lord of the Rings त्रयी की किताबों के Fellowship of the Ring पर आधारित डेटासेट से Python lambda फ़ंक्शन लिखना सीखते हैं। दुर्भाग्य से, उस डेटासेट में Gandalf और Pippin गायब थे। हमारे छात्रों ने उचित रूप से शिकायत की, तो हमने सुना और समस्या को ठीक कर दिया।

2. DataCamp सीखने वालों के लिए गलतफहमियों और उलझनों से बचना
कई अभ्यासों पर मिली प्रतिक्रिया का विश्लेषण करने से छात्रों में पाई जाने वाली गलतफहमियों के पैटर्न सामने आते हैं। बहुत-सी डेटा विश्लेषण प्रक्रियाएँ अपने डेटा को आयताकार रूप में रखती हैं, जहाँ हर पंक्ति एक रिकॉर्ड होती है और हर स्तम्भ उस रिकॉर्ड का कोई मान। उदाहरण के लिए, हर पंक्ति किसी व्यक्ति से मेल खा सकती है, और स्तम्भों में उसका नाम, कद, और पसंदीदा रंग हो सकते हैं।
डेटा हेरफेर की एक बहुत आम प्रक्रिया उस आयताकार डेटा की पंक्तियों को फ़िल्टर करना है। कोई प्रशिक्षक इस तरह का निर्देश लिख सकता है:
डेटासेट को फ़िल्टर करें ताकि 170 सेमी से छोटे लोगों वाली पंक्तियाँ हट जाएँ।
यह ठीक है, लेकिन अधिकांश सांख्यिकीय सॉफ़्टवेयर, जिनमें R का dplyr पैकेज और Python का Pandas पैकेज शामिल हैं, आपसे उन चीज़ों को निर्दिष्ट करके फ़िल्टर करने को कहते हैं जिन्हें आप रखना चाहते हैं। यदि निर्देश को इस प्रकार लिखा जाए:
डेटासेट को फ़िल्टर करें ताकि 170 सेमी से लंबे लोगों वाली पंक्तियाँ बनी रहें।
तो निर्देश कोड के काम करने के तरीके से मेल खाता है, और छात्रों के लिए भ्रम का एक बिंदु समाप्त हो जाता है। उन्नत कोर्सों में, जहाँ छात्रों से डेटा हेरफेर की जानकारी होने की अपेक्षा होती है, यह वाक्य-रचना उतनी बड़ी समस्या नहीं रहती। अपने Pandas Foundations कोर्स में, हमने देखा कि कई छात्र इस समस्या से जूझ रहे थे, और हमने भाषा बदल दी।
3. अधिक व्यापक और सूक्ष्म प्रतिक्रिया से सुखद सीखने का मार्ग बनाना
सभी DataCamp अभ्यास हमारे कंटेंट इंजीनियरिंग टीम द्वारा बनाए गए सॉफ़्टवेयर से स्वचालित रूप से ग्रेड होते हैं। इससे छात्रों को यदि उत्तर गलत हो तो तुरंत बुद्धिमानी से प्रतिक्रिया मिलती है। यह शायद हमारे प्लेटफ़ॉर्म की सबसे बड़ी विशेषता है। इसमें सबसे कठिन बात यह अंदाजा लगाना है कि छात्र क्या गलत करेंगे ताकि उन्हें अगली बार अलग क्या करना है, इस पर अच्छी सलाह दी जा सके। इसका मतलब यह भी है कि कभी-कभी कोई सही समाधान गलत के रूप में चिह्नित हो जाता है। जब ऐसा होता है, तो छात्रों को यह बिल्कुल पसंद नहीं आता। एक मामले में, एक छात्र ने शिकायत की:
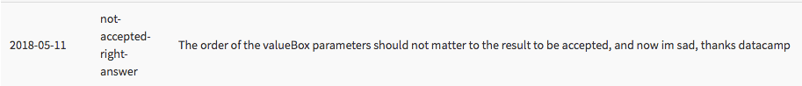
अपने Cluster Analysis in R कोर्स में, कई छात्रों ने देखा कि भले ही किसी अभ्यास के सुझाए गए समाधान में न्यूनतम मान निकालने के लिए प्रसिद्ध min() फ़ंक्शन का उपयोग किया गया था, लेकिन कम-प्रचलित समानांतर न्यूनतम फ़ंक्शन pmin() का उपयोग करके एक और सरल और सुरुचिपूर्ण समाधान मौजूद था।

शुरुआत में, अभ्यास केवल एक ही समाधान स्वीकार करता था, लेकिन छात्रों के चतुर विचार के आधार पर अब दोनों समाधान स्वीकार किए जाते हैं। DataCamp की प्रतिक्रिया प्रणाली विकसित करते समय कंटेंट इंजीनियरिंग टीम के लक्ष्यों में से एक ग्रेडिंग की लचीलापन बढ़ाना है, ताकि छात्र अपनी तरह से समस्याएँ हल कर सकें।
हमारी स्वचालित प्रतिक्रिया के साथ छात्रों की एक और झुंझलाहट यह है कि अभ्यास करते समय उन्हें बार-बार वही संदेश दिखता है। इसका सिद्धांत नीचे दिए गए चित्र में दिखाया गया है, जहाँ किसी छात्र से तीन तत्वों वाली एक Python array बनाने को कहा जाता है।
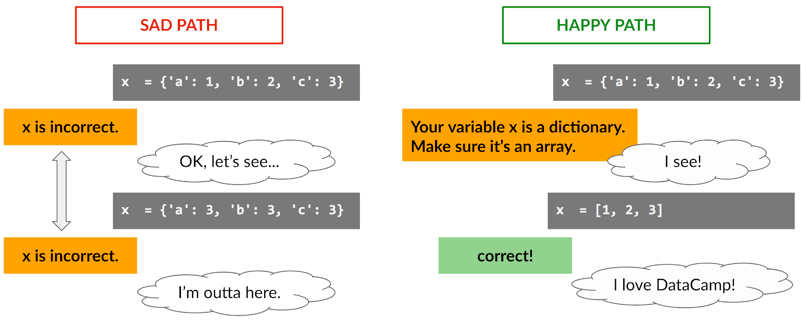
और अधिक सूक्ष्म प्रतिक्रिया देकर, जो छात्र के उत्तर की विशिष्ट समस्याओं को संबोधित करती है, हम एक अधिक सकारात्मक सीखने का अनुभव दे सकते हैं। बेहतर प्रतिक्रिया के नतीजे उत्साहजनक हैं। हमारे Intermediate Python for Data Science कोर्स के एक अभ्यास में, सूक्ष्म प्रतिक्रिया अपनाने से, एक से अधिक बार वही संदेश देखने वाले छात्रों का प्रतिशत लगभग 65% से घटकर 10% से कम हो गया।
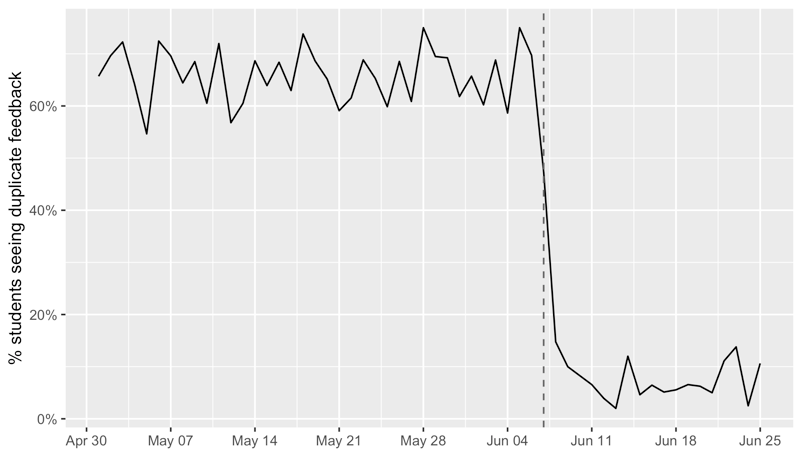
एक से अधिक बार वही प्रतिक्रिया संदेश देखने वाले उपयोगकर्ताओं का प्रतिशत वह मीट्रिक है जिसे हम सभी अभ्यासों और कोर्सों के लिए मॉनिटर करते हैं। कोर्सों की लोकप्रियता के साथ मिलाकर, हमने सबसे अधिक प्रभाव डालने वाले तरीके से सीखने के अनुभव को लगातार बेहतर बनाने का एक डेटा-चालित तरीका बनाया है।
निष्कर्ष
साल के अंत तक हमारा लक्ष्य है कि सभी कोर्सों के लोकप्रिय आधे हिस्से में, हर कोर्स के लिए सभी अभ्यासों पर दोहराई गई प्रतिक्रिया का औसत प्रतिशत 30% से कम हो।
हम DataCamp पर छात्र जिन-जिन तकनीकों को सीख सकते हैं, उन सभी में ये सुधार जोड़ते रहेंगे। आंतरिक रूप से भी हम उन टूल्स में सुधार करते हैं जिनसे हम प्रतिक्रिया बनाते हैं और छात्र-सबमिशन का विश्लेषण करते हैं, ताकि वर्तमान और भविष्य की सारी सामग्री के लिए सीखने का अनुभव बेहतर होता रहे।
किसी अभ्यास में और भी कई बातें गलत हो सकती हैं, लेकिन उम्मीद है कि इससे आपको यह भरोसा मिलेगा कि DataCamp छात्र-प्रतिक्रिया को सुनता है और हमारे कोर्सों के प्रति छात्र-संतुष्टि बढ़ाने के लिए लगातार काम करता रहता है।

DataCamp सर्वश्रेष्ठ डेटा साइंस पाठ्यक्रम कैसे बनाता है
DataCamp में, हमें इस बात पर गर्व है कि हमारे पास डेटा साइंस सीखने के लिए सबसे अच्छा प्लेटफ़ॉर्म और सर्वश्रेष्ठ पाठ्यक्रम-संग्रह है। इसी उद्देश्य से, हम यह सुनिश्चित करने में बहुत मेहनत करते हैं कि हर अभ्यास शिक्षण के लिए प्रभावी और करने में आनंददायक हो। कोई कोर्स लॉन्च होने के बाद भी हम उसे अंतिम नहीं मानते: लॉन्च तो डेटा संग्रह की बस शुरुआत है। जब भी कोई छात्र किसी अभ्यास को हल करने की कोशिश करता है, हम ऐसे डेटा पॉइंट्स जुटाते हैं जैसे उसे हल करने में कितने प्रयास लगे, और क्या उसे संकेत या समाधान मांगकर सहायता की आवश्यकता पड़ी। अपने सभी छात्रों के बीच इस डेटा को एकत्रित करके, हम समझ पाते हैं कि कोई अभ्यास कितना कठिन है। इसके अतिरिक्त, छात्र अभ्यासों को एक से पाँच सितारों तक रेट कर सकते हैं और हमें प्रतिक्रिया दे सकते हैं, जिससे हमें पता चलता है कि कोई अभ्यास छात्रों को कितना पसंद आया।
हमारी कंटेंट क्वालिटी टीम इस डेटा के आधार पर कोर्स बेहतर बनाने के लिए प्रशिक्षकों के साथ काम करती है। यह कई रूपों में होता है, क्योंकि किसी अभ्यास में कई तरह की बातें गलत हो सकती हैं।
1. गायब डेटा को ठीक करना
कभी-कभी छोटी-सी बात भी बहुत से छात्रों को परेशान कर देती है। Data Science Toolbox (Part 1) में, छात्र J.R.R. Tolkien की Lord of the Rings त्रयी की किताबों के Fellowship of the Ring पर आधारित डेटासेट से Python lambda फ़ंक्शन लिखना सीखते हैं। दुर्भाग्य से, उस डेटासेट में Gandalf और Pippin गायब थे। हमारे छात्रों ने उचित रूप से शिकायत की, तो हमने सुना और समस्या को ठीक कर दिया।
2. DataCamp सीखने वालों के लिए गलतफहमियों और उलझनों से बचना
कई अभ्यासों पर मिली प्रतिक्रिया का विश्लेषण करने से छात्रों में पाई जाने वाली गलतफहमियों के पैटर्न सामने आते हैं। बहुत-सी डेटा विश्लेषण प्रक्रियाएँ अपने डेटा को आयताकार रूप में रखती हैं, जहाँ हर पंक्ति एक रिकॉर्ड होती है और हर स्तम्भ उस रिकॉर्ड का कोई मान। उदाहरण के लिए, हर पंक्ति किसी व्यक्ति से मेल खा सकती है, और स्तम्भों में उसका नाम, कद, और पसंदीदा रंग हो सकते हैं।
डेटा हेरफेर की एक बहुत आम प्रक्रिया उस आयताकार डेटा की पंक्तियों को फ़िल्टर करना है। कोई प्रशिक्षक इस तरह का निर्देश लिख सकता है:
डेटासेट को फ़िल्टर करें ताकि 170 सेमी से छोटे लोगों वाली पंक्तियाँ हट जाएँ।
यह ठीक है, लेकिन अधिकांश सांख्यिकीय सॉफ़्टवेयर, जिनमें R का dplyr पैकेज और Python का Pandas पैकेज शामिल हैं, आपसे उन चीज़ों को निर्दिष्ट करके फ़िल्टर करने को कहते हैं जिन्हें आप रखना चाहते हैं। यदि निर्देश को इस प्रकार लिखा जाए:
डेटासेट को फ़िल्टर करें ताकि 170 सेमी से लंबे लोगों वाली पंक्तियाँ बनी रहें।
तो निर्देश कोड के काम करने के तरीके से मेल खाता है, और छात्रों के लिए भ्रम का एक बिंदु समाप्त हो जाता है। उन्नत कोर्सों में, जहाँ छात्रों से डेटा हेरफेर की जानकारी होने की अपेक्षा होती है, यह वाक्य-रचना उतनी बड़ी समस्या नहीं रहती। अपने Pandas Foundations कोर्स में, हमने देखा कि कई छात्र इस समस्या से जूझ रहे थे, और हमने भाषा बदल दी।
3. अधिक व्यापक और सूक्ष्म प्रतिक्रिया से सुखद सीखने का मार्ग बनाना
सभी DataCamp अभ्यास हमारे कंटेंट इंजीनियरिंग टीम द्वारा बनाए गए सॉफ़्टवेयर से स्वचालित रूप से ग्रेड होते हैं। इससे छात्रों को यदि उत्तर गलत हो तो तुरंत बुद्धिमानी से प्रतिक्रिया मिलती है। यह शायद हमारे प्लेटफ़ॉर्म की सबसे बड़ी विशेषता है। इसमें सबसे कठिन बात यह अंदाजा लगाना है कि छात्र क्या गलत करेंगे ताकि उन्हें अगली बार अलग क्या करना है, इस पर अच्छी सलाह दी जा सके। इसका मतलब यह भी है कि कभी-कभी कोई सही समाधान गलत के रूप में चिह्नित हो जाता है। जब ऐसा होता है, तो छात्रों को यह बिल्कुल पसंद नहीं आता। एक मामले में, एक छात्र ने शिकायत की:
अपने Cluster Analysis in R कोर्स में, कई छात्रों ने देखा कि भले ही किसी अभ्यास के सुझाए गए समाधान में न्यूनतम मान निकालने के लिए प्रसिद्ध min() फ़ंक्शन का उपयोग किया गया था, लेकिन कम-प्रचलित समानांतर न्यूनतम फ़ंक्शन pmin() का उपयोग करके एक और सरल और सुरुचिपूर्ण समाधान मौजूद था।
शुरुआत में, अभ्यास केवल एक ही समाधान स्वीकार करता था, लेकिन छात्रों के चतुर विचार के आधार पर अब दोनों समाधान स्वीकार किए जाते हैं। DataCamp की प्रतिक्रिया प्रणाली विकसित करते समय कंटेंट इंजीनियरिंग टीम के लक्ष्यों में से एक ग्रेडिंग की लचीलापन बढ़ाना है, ताकि छात्र अपनी तरह से समस्याएँ हल कर सकें।
हमारी स्वचालित प्रतिक्रिया के साथ छात्रों की एक और झुंझलाहट यह है कि अभ्यास करते समय उन्हें बार-बार वही संदेश दिखता है। इसका सिद्धांत नीचे दिए गए चित्र में दिखाया गया है, जहाँ किसी छात्र से तीन तत्वों वाली एक Python array बनाने को कहा जाता है।
और अधिक सूक्ष्म प्रतिक्रिया देकर, जो छात्र के उत्तर की विशिष्ट समस्याओं को संबोधित करती है, हम एक अधिक सकारात्मक सीखने का अनुभव दे सकते हैं। बेहतर प्रतिक्रिया के नतीजे उत्साहजनक हैं। हमारे Intermediate Python for Data Science कोर्स के एक अभ्यास में, सूक्ष्म प्रतिक्रिया अपनाने से, एक से अधिक बार वही संदेश देखने वाले छात्रों का प्रतिशत लगभग 65% से घटकर 10% से कम हो गया।
एक से अधिक बार वही प्रतिक्रिया संदेश देखने वाले उपयोगकर्ताओं का प्रतिशत वह मीट्रिक है जिसे हम सभी अभ्यासों और कोर्सों के लिए मॉनिटर करते हैं। कोर्सों की लोकप्रियता के साथ मिलाकर, हमने सबसे अधिक प्रभाव डालने वाले तरीके से सीखने के अनुभव को लगातार बेहतर बनाने का एक डेटा-चालित तरीका बनाया है।
निष्कर्ष
साल के अंत तक हमारा लक्ष्य है कि सभी कोर्सों के लोकप्रिय आधे हिस्से में, हर कोर्स के लिए सभी अभ्यासों पर दोहराई गई प्रतिक्रिया का औसत प्रतिशत 30% से कम हो।
हम DataCamp पर छात्र जिन-जिन तकनीकों को सीख सकते हैं, उन सभी में ये सुधार जोड़ते रहेंगे। आंतरिक रूप से भी हम उन टूल्स में सुधार करते हैं जिनसे हम प्रतिक्रिया बनाते हैं और छात्र-सबमिशन का विश्लेषण करते हैं, ताकि वर्तमान और भविष्य की सारी सामग्री के लिए सीखने का अनुभव बेहतर होता रहे।
किसी अभ्यास में और भी कई बातें गलत हो सकती हैं, लेकिन उम्मीद है कि इससे आपको यह भरोसा मिलेगा कि DataCamp छात्र-प्रतिक्रिया को सुनता है और हमारे कोर्सों के प्रति छात्र-संतुष्टि बढ़ाने के लिए लगातार काम करता रहता है।