一个数据科学项目包含许多组件,需要协作才能成功部署。面对这些相互关联的部分,开发与部署流程都需要采用敏捷方法。这种方法让组织能够快速学习并快速迭代。在一次近期的 DataCamp 网络研讨会中,Lucid Software 内部工程团队工程经理 Brian Campbell 讨论了成功部署数据科学项目的最佳实践。
支持敏捷开发的前期步骤
Brian 指出,在项目早期可以采取两个关键步骤,使模型的开发与部署能够并行推进:使用基线模型和创建原型。尽管这些方法会让时间线更复杂,但能带来显著更快且更优的结果。
使用基线模型
成功交付机器学习项目的一个有用步骤是创建基线模型。基线模型的输出与最终模型相同,但它在大部分开发开始前构建,可能基于启发式或随机数据。这个基线为后续迭代提供了需要超越的目标。
随着团队开发新模型,可以将新结果与基线进行比较,从而获得启发。基线与期望状态之间的差距有助于明确项目需求,并帮助团队识别对问题最有价值的数据和解决方案。
使用原型
原型是指与最终模型摄取相同输入并提供相同输出格式的模型。该模型可以参考基线模型来设计。一旦原型就绪,负责部署的人员就可以开始将模型集成到其预期用途中。原型使模型工作能够并行推进:数据科学家改进模型的同时,实施团队研究如何将模型打包给客户或嵌入业务流程。
只有当最终模型与原型的行为一致时,原型方法才奏效。因此,在创建原型之前,需要理解可用数据和预期的输出格式。这要求对初始问题表述之外的项目情况有所了解,并与问题领域专家密切合作。
基线与原型的真实用例
Brian 介绍了他在 Lucid 的团队如何利用基线和原型,加速为一款便签产品开发聚类模型。该产品被产品、设计和工程团队使用。这些团队经常开展设计思维会议,主持人需要将相似类型的便签在某一类别下手动聚类。该系统的目标是通过自动将想法聚类到类别并去重,缩短从头脑风暴到讨论之间的时间。
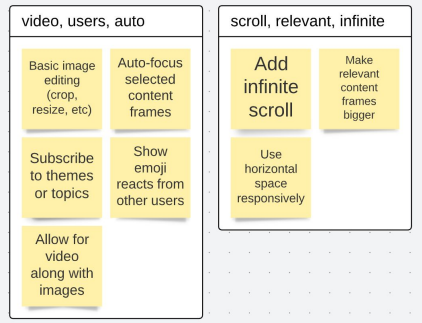
基线模型接受随机想法并为其生成随机类别。随后,他们基于该模型创建了原型,使实施专家能够在开发早期就开始工作。随着时间推移,他们利用自然语言处理和机器学习,将相似便签聚在一起,从而改进了基线模型。
沟通对这些模型至关重要
该项目的第一轮迭代遇到了一些问题,原因在于部署团队与负责模型的数据科学家之间缺乏持续协作。这种缺乏团队合作导致模型性能问题、测试不准确以及糟糕的产品体验。他们未能实现模型并行开发所带来的协同效应。
当他们重启项目并有效协作后,这些问题得到解决,预期也更加现实。通过为部署团队提供可与数据科学团队并行工作的原型模型,协作成为可能。
若想了解该项目的经验教训,以及如何高效推进复杂的数据科学项目,请观看点播研讨会。

一个数据科学项目包含许多组件,需要协作才能成功部署。面对这些相互关联的部分,开发与部署流程都需要采用敏捷方法。这种方法让组织能够快速学习并快速迭代。在一次近期的 DataCamp 网络研讨会中,Lucid Software 内部工程团队工程经理 Brian Campbell 讨论了成功部署数据科学项目的最佳实践。
支持敏捷开发的前期步骤
Brian 指出,在项目早期可以采取两个关键步骤,使模型的开发与部署能够并行推进:使用基线模型和创建原型。尽管这些方法会让时间线更复杂,但能带来显著更快且更优的结果。
使用基线模型
成功交付机器学习项目的一个有用步骤是创建基线模型。基线模型的输出与最终模型相同,但它在大部分开发开始前构建,可能基于启发式或随机数据。这个基线为后续迭代提供了需要超越的目标。
随着团队开发新模型,可以将新结果与基线进行比较,从而获得启发。基线与期望状态之间的差距有助于明确项目需求,并帮助团队识别对问题最有价值的数据和解决方案。
使用原型
原型是指与最终模型摄取相同输入并提供相同输出格式的模型。该模型可以参考基线模型来设计。一旦原型就绪,负责部署的人员就可以开始将模型集成到其预期用途中。原型使模型工作能够并行推进:数据科学家改进模型的同时,实施团队研究如何将模型打包给客户或嵌入业务流程。
只有当最终模型与原型的行为一致时,原型方法才奏效。因此,在创建原型之前,需要理解可用数据和预期的输出格式。这要求对初始问题表述之外的项目情况有所了解,并与问题领域专家密切合作。
基线与原型的真实用例
Brian 介绍了他在 Lucid 的团队如何利用基线和原型,加速为一款便签产品开发聚类模型。该产品被产品、设计和工程团队使用。这些团队经常开展设计思维会议,主持人需要将相似类型的便签在某一类别下手动聚类。该系统的目标是通过自动将想法聚类到类别并去重,缩短从头脑风暴到讨论之间的时间。
基线模型接受随机想法并为其生成随机类别。随后,他们基于该模型创建了原型,使实施专家能够在开发早期就开始工作。随着时间推移,他们利用自然语言处理和机器学习,将相似便签聚在一起,从而改进了基线模型。
沟通对这些模型至关重要
该项目的第一轮迭代遇到了一些问题,原因在于部署团队与负责模型的数据科学家之间缺乏持续协作。这种缺乏团队合作导致模型性能问题、测试不准确以及糟糕的产品体验。他们未能实现模型并行开发所带来的协同效应。
当他们重启项目并有效协作后,这些问题得到解决,预期也更加现实。通过为部署团队提供可与数据科学团队并行工作的原型模型,协作成为可能。
若想了解该项目的经验教训,以及如何高效推进复杂的数据科学项目,请观看点播研讨会。