डेटा साइंस प्रोजेक्ट में कई घटक होते हैं, जिनकी सफल डिप्लॉयमेंट के लिए सहयोग आवश्यक होता है। इन परस्पर जुड़े हिस्सों के साथ, विकास और डिप्लॉयमेंट प्रक्रियाओं के लिए एक एजल दृष्टिकोण जरूरी है। यह तरीका संगठनों को तेजी से सीखने और जल्दी-जल्दी इटरेट करने में सक्षम बनाता है। हाल ही के एक DataCamp वेबिनार में, ब्रायन कैंपबेल, इंजीनियरिंग मैनेजर, इंटरनल इंजीनियरिंग, Lucid Software, ने डेटा साइंस प्रोजेक्ट्स को सफलतापूर्वक डिप्लॉय करने के सर्वोत्तम तरीकों पर चर्चा की।
एजल डेवलपमेंट को संभव बनाने के शुरुआती चरण
ब्रायन बताते हैं कि किसी प्रोजेक्ट की शुरुआत में दो प्रमुख कदम उठाए जा सकते हैं, ताकि मॉडल के विकास और डिप्लॉयमेंट पर समानांतर प्रगति हो सके: बेसलाइन मॉडल्स के साथ काम करना और एक प्रोटोटाइप बनाना। यद्यपि ये तरीक़े टाइमलाइन को जटिल बनाते हैं, लेकिन ये परिणामों को काफी तेज़ और बेहतर बनाते हैं।
बेसलाइन मॉडल्स के साथ काम करें
मशीन लर्निंग प्रोजेक्ट्स को सफलतापूर्वक शिप करने का एक उपयोगी कदम है बेसलाइन मॉडल बनाना। एक बेसलाइन मॉडल अंतिम मॉडल की तरह ही आउटपुट देता है। हालांकि, इसे ज्यादातर विकास प्रक्रिया से पहले बनाया जाता है और यह हीयूरिस्टिक्स या रैंडम डेटा पर आधारित हो सकता है। यह बेसलाइन भविष्य की इटरेशंस के लिए एक लक्ष्य तय करती है, जिसे पार करना होता है।
जैसे-जैसे टीम नए मॉडल विकसित करती है, नए परिणामों की तुलना बेसलाइन से की जा सकती है और उनसे सीख हासिल की जा सकती है। बेसलाइन और वांछित अवस्था के बीच का अंतर प्रोजेक्ट आवश्यकताओं को स्पष्ट करता है और टीमों को समस्या के लिए सबसे मूल्यवान डेटा और समाधानों की पहचान करने में मदद करता है।
प्रोटोटाइप्स के साथ काम करें
प्रोटोटाइप ऐसे मॉडल होते हैं जो वही इनपुट लेते हैं और वही आउटपुट प्रारूप प्रदान करते हैं जो अंतिम मॉडल देगा। यह मॉडल बेसलाइन मॉडल से सूचित हो सकता है। जैसे ही प्रोटोटाइप तैयार हो जाता है, डिप्लॉयमेंट के प्रभारी लोग मॉडल को उसके निर्धारित उपयोग में इंटिग्रेट करने का काम शुरू कर सकते हैं। प्रोटोटाइप मॉडल पर समानांतर प्रगति को सक्षम करता है; डेटा साइंटिस्ट्स मॉडल को बेहतर बनाते रहते हैं, वहीं इम्प्लीमेंटेशन टीम यह तय करती है कि मॉडल को ग्राहकों तक या किसी बिज़नेस प्रोसेस में कैसे पैकेज किया जाएगा।
प्रोटोटाइप तभी काम करते हैं जब अंतिम मॉडल का व्यवहार प्रोटोटाइप जैसा ही हो। इसलिए, प्रोटोटाइप बनाने से पहले उपलब्ध डेटा और इच्छित आउटपुट प्रारूप को समझना आवश्यक है। इसके लिए आरंभिक समस्या निर्माण से आगे जाकर प्रोजेक्ट के बारे में कुछ जानकारी, और समस्या विशेषज्ञों के साथ सशक्त सहयोग की आवश्यकता होती है।
बेसलाइन और प्रोटोटाइप का वास्तविक उपयोग-प्रकरण
ब्रायन बताते हैं कि कैसे उनकी टीम ने Lucid में एक स्टिकी नोट प्रोडक्ट के लिए क्लस्टरिंग मॉडल के विकास में तेजी लाने हेतु बेसलाइन और प्रोटोटाइप का उपयोग किया, जिसे प्रोडक्ट, डिज़ाइन, और इंजीनियरिंग टीमें इस्तेमाल करती हैं। ये टीमें अक्सर डिज़ाइन थिंकिंग सत्र चलाती हैं, जहाँ एक फ़ैसिलिटेटर को समान प्रकार के स्टिकी नोट्स को किसी दिए गए श्रेणी के अंतर्गत मैन्युअल रूप से क्लस्टर करना पड़ता है। सिस्टम का लक्ष्य था ब्रेनस्टॉर्मिंग और चर्चा के बीच के समय को कम करना—विचारों को स्वचालित रूप से श्रेणियों में क्लस्टर करके और डुप्लिकेट्स हटाकर।
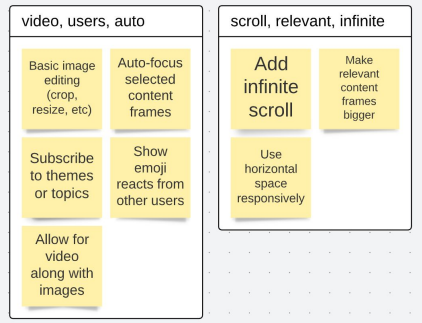
बेसलाइन मॉडल ने रैंडम विचार लिए और उनके लिए रैंडम श्रेणियाँ बनाई। फिर, उन्होंने इस मॉडल का एक प्रोटोटाइप बनाया ताकि इम्प्लीमेंटेशन विशेषज्ञ विकास प्रक्रिया के शुरुआती चरण में ही काम शुरू कर सकें। समय के साथ, उन्होंने नैचरल लैंग्वेज प्रोसेसिंग और मशीन लर्निंग का लाभ उठाकर समान स्टिकी नोट्स को एक साथ क्लस्टर करके बेसलाइन मॉडल में सुधार किया।
इन मॉडलों के साथ संवाद महत्त्वपूर्ण है
इस प्रोजेक्ट के पहले इटरेशन में कुछ समस्याएँ आईं क्योंकि डिप्लॉयमेंट टीम और मॉडल पर काम कर रहे डेटा साइंटिस्ट्स के बीच निरंतर सहयोग की कमी थी। इस टीमवर्क की कमी से मॉडल प्रदर्शन संबंधी समस्याएँ, गलत परीक्षण, और कमजोर प्रोडक्ट अनुभव हुए। वे मॉडल को समानांतर में विकसित करने के समन्वय का लाभ नहीं उठा पाए।
जब उन्होंने प्रोजेक्ट को फिर से लॉन्च किया और प्रभावी ढंग से सहयोग किया, तो उन्होंने इन समस्याओं का समाधान किया और यथार्थवादी अपेक्षाएँ तय कीं। सहयोग संभव हुआ क्योंकि डिप्लॉयमेंट टीम के पास काम करने के लिए एक प्रोटोटाइप मॉडल था, जिससे वे मॉडल विकसित कर रही डेटा साइंस टीम के साथ समानांतर चल सके।
प्रोजेक्ट से मिली सीख को समझने और जटिल डेटा साइंस प्रोजेक्ट्स को प्रभावी ढंग से संचालित करने के तरीके जानने के लिए, अवश्य देखें यह ऑन-डिमांड वेबिनार।

डेटा साइंस प्रोजेक्ट में कई घटक होते हैं, जिनकी सफल डिप्लॉयमेंट के लिए सहयोग आवश्यक होता है। इन परस्पर जुड़े हिस्सों के साथ, विकास और डिप्लॉयमेंट प्रक्रियाओं के लिए एक एजल दृष्टिकोण जरूरी है। यह तरीका संगठनों को तेजी से सीखने और जल्दी-जल्दी इटरेट करने में सक्षम बनाता है। हाल ही के एक DataCamp वेबिनार में, ब्रायन कैंपबेल, इंजीनियरिंग मैनेजर, इंटरनल इंजीनियरिंग, Lucid Software, ने डेटा साइंस प्रोजेक्ट्स को सफलतापूर्वक डिप्लॉय करने के सर्वोत्तम तरीकों पर चर्चा की।
एजल डेवलपमेंट को संभव बनाने के शुरुआती चरण
ब्रायन बताते हैं कि किसी प्रोजेक्ट की शुरुआत में दो प्रमुख कदम उठाए जा सकते हैं, ताकि मॉडल के विकास और डिप्लॉयमेंट पर समानांतर प्रगति हो सके: बेसलाइन मॉडल्स के साथ काम करना और एक प्रोटोटाइप बनाना। यद्यपि ये तरीक़े टाइमलाइन को जटिल बनाते हैं, लेकिन ये परिणामों को काफी तेज़ और बेहतर बनाते हैं।
बेसलाइन मॉडल्स के साथ काम करें
मशीन लर्निंग प्रोजेक्ट्स को सफलतापूर्वक शिप करने का एक उपयोगी कदम है बेसलाइन मॉडल बनाना। एक बेसलाइन मॉडल अंतिम मॉडल की तरह ही आउटपुट देता है। हालांकि, इसे ज्यादातर विकास प्रक्रिया से पहले बनाया जाता है और यह हीयूरिस्टिक्स या रैंडम डेटा पर आधारित हो सकता है। यह बेसलाइन भविष्य की इटरेशंस के लिए एक लक्ष्य तय करती है, जिसे पार करना होता है।
जैसे-जैसे टीम नए मॉडल विकसित करती है, नए परिणामों की तुलना बेसलाइन से की जा सकती है और उनसे सीख हासिल की जा सकती है। बेसलाइन और वांछित अवस्था के बीच का अंतर प्रोजेक्ट आवश्यकताओं को स्पष्ट करता है और टीमों को समस्या के लिए सबसे मूल्यवान डेटा और समाधानों की पहचान करने में मदद करता है।
प्रोटोटाइप्स के साथ काम करें
प्रोटोटाइप ऐसे मॉडल होते हैं जो वही इनपुट लेते हैं और वही आउटपुट प्रारूप प्रदान करते हैं जो अंतिम मॉडल देगा। यह मॉडल बेसलाइन मॉडल से सूचित हो सकता है। जैसे ही प्रोटोटाइप तैयार हो जाता है, डिप्लॉयमेंट के प्रभारी लोग मॉडल को उसके निर्धारित उपयोग में इंटिग्रेट करने का काम शुरू कर सकते हैं। प्रोटोटाइप मॉडल पर समानांतर प्रगति को सक्षम करता है; डेटा साइंटिस्ट्स मॉडल को बेहतर बनाते रहते हैं, वहीं इम्प्लीमेंटेशन टीम यह तय करती है कि मॉडल को ग्राहकों तक या किसी बिज़नेस प्रोसेस में कैसे पैकेज किया जाएगा।
प्रोटोटाइप तभी काम करते हैं जब अंतिम मॉडल का व्यवहार प्रोटोटाइप जैसा ही हो। इसलिए, प्रोटोटाइप बनाने से पहले उपलब्ध डेटा और इच्छित आउटपुट प्रारूप को समझना आवश्यक है। इसके लिए आरंभिक समस्या निर्माण से आगे जाकर प्रोजेक्ट के बारे में कुछ जानकारी, और समस्या विशेषज्ञों के साथ सशक्त सहयोग की आवश्यकता होती है।
बेसलाइन और प्रोटोटाइप का वास्तविक उपयोग-प्रकरण
ब्रायन बताते हैं कि कैसे उनकी टीम ने Lucid में एक स्टिकी नोट प्रोडक्ट के लिए क्लस्टरिंग मॉडल के विकास में तेजी लाने हेतु बेसलाइन और प्रोटोटाइप का उपयोग किया, जिसे प्रोडक्ट, डिज़ाइन, और इंजीनियरिंग टीमें इस्तेमाल करती हैं। ये टीमें अक्सर डिज़ाइन थिंकिंग सत्र चलाती हैं, जहाँ एक फ़ैसिलिटेटर को समान प्रकार के स्टिकी नोट्स को किसी दिए गए श्रेणी के अंतर्गत मैन्युअल रूप से क्लस्टर करना पड़ता है। सिस्टम का लक्ष्य था ब्रेनस्टॉर्मिंग और चर्चा के बीच के समय को कम करना—विचारों को स्वचालित रूप से श्रेणियों में क्लस्टर करके और डुप्लिकेट्स हटाकर।
बेसलाइन मॉडल ने रैंडम विचार लिए और उनके लिए रैंडम श्रेणियाँ बनाई। फिर, उन्होंने इस मॉडल का एक प्रोटोटाइप बनाया ताकि इम्प्लीमेंटेशन विशेषज्ञ विकास प्रक्रिया के शुरुआती चरण में ही काम शुरू कर सकें। समय के साथ, उन्होंने नैचरल लैंग्वेज प्रोसेसिंग और मशीन लर्निंग का लाभ उठाकर समान स्टिकी नोट्स को एक साथ क्लस्टर करके बेसलाइन मॉडल में सुधार किया।
इन मॉडलों के साथ संवाद महत्त्वपूर्ण है
इस प्रोजेक्ट के पहले इटरेशन में कुछ समस्याएँ आईं क्योंकि डिप्लॉयमेंट टीम और मॉडल पर काम कर रहे डेटा साइंटिस्ट्स के बीच निरंतर सहयोग की कमी थी। इस टीमवर्क की कमी से मॉडल प्रदर्शन संबंधी समस्याएँ, गलत परीक्षण, और कमजोर प्रोडक्ट अनुभव हुए। वे मॉडल को समानांतर में विकसित करने के समन्वय का लाभ नहीं उठा पाए।
जब उन्होंने प्रोजेक्ट को फिर से लॉन्च किया और प्रभावी ढंग से सहयोग किया, तो उन्होंने इन समस्याओं का समाधान किया और यथार्थवादी अपेक्षाएँ तय कीं। सहयोग संभव हुआ क्योंकि डिप्लॉयमेंट टीम के पास काम करने के लिए एक प्रोटोटाइप मॉडल था, जिससे वे मॉडल विकसित कर रही डेटा साइंस टीम के साथ समानांतर चल सके।
प्रोजेक्ट से मिली सीख को समझने और जटिल डेटा साइंस प्रोजेक्ट्स को प्रभावी ढंग से संचालित करने के तरीके जानने के लिए, अवश्य देखें यह ऑन-डिमांड वेबिनार।