Un progetto di data science comprende molti elementi che richiedono collaborazione per arrivare a un deployment di successo. Con queste parti collegate tra loro, per lo sviluppo e la messa in produzione serve un approccio agile. Questo approccio permette alle organizzazioni di imparare in fretta e iterare rapidamente. In un recente webinar di DataCamp, Brian Campbell, Engineering Manager, Internal Engineering presso Lucid Software, ha illustrato le best practice per distribuire con successo progetti di data science.
Passi iniziali per abilitare lo sviluppo agile
Brian spiega che, all’inizio di un progetto, si possono adottare due passaggi chiave per consentire progressi in parallelo sia sullo sviluppo sia sul deployment di un modello: lavorare con modelli di base e creare un prototipo. Sebbene questi approcci complichino le timeline, portano a risultati sensibilmente più rapidi e migliori.
Lavora con modelli di base
Un passo utile per spedire con successo progetti di machine learning è creare un modello di base. Un modello di base fornisce gli stessi output del modello finale. Tuttavia, viene costruito prima della maggior parte del processo di sviluppo e può basarsi su euristiche o dati casuali. Questo baseline offre un bersaglio da superare nelle iterazioni successive.
Man mano che il team sviluppa nuovi modelli, i nuovi risultati possono essere confrontati con il baseline e orientare l’apprendimento. Il divario tra il baseline e lo stato desiderato informa i requisiti del progetto e aiuta i team a identificare i dati e le soluzioni più preziosi per il problema.
Lavora con prototipi
I prototipi sono modelli che ingeriscono gli stessi input e forniscono lo stesso formato di output del modello finale. Questo modello può essere guidato dal modello di base. Una volta pronto il prototipo, chi si occupa del deployment può iniziare a lavorare sull’integrazione del modello nel suo scopo previsto. Il prototipo consente progressi in parallelo sul modello: i data scientist migliorano il modello mentre il team di implementazione lavora su come confezionarlo per i clienti o all’interno di un processo aziendale.
I prototipi funzionano solo quando il modello finale si comporta come il prototipo. È quindi necessario comprendere i dati disponibili e il formato di output previsto prima di creare il prototipo. Questo richiede una certa conoscenza del progetto oltre alla formulazione iniziale del problema e una stretta collaborazione con gli esperti di dominio.
Caso d’uso reale di baseline e prototipi
Brian racconta come il suo team in Lucid abbia utilizzato baseline e prototipi per accelerare lo sviluppo di un modello di clustering per un prodotto di note adesive usato dai team di prodotto, design ed engineering. Questi team spesso svolgono sessioni di design thinking in cui un facilitatore deve raggruppare manualmente le note adesive simili sotto una data categoria. L’obiettivo del sistema era ridurre il tempo tra brainstorming e discussione raggruppando automaticamente le idee in categorie ed eliminando i duplicati.
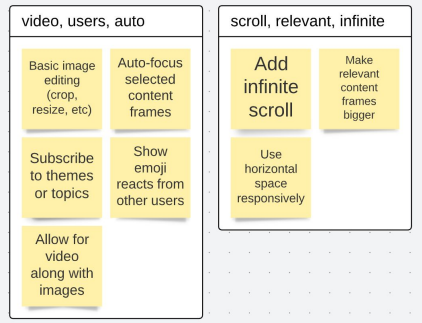
Il modello di base prendeva idee casuali e generava categorie casuali per esse. Poi hanno creato un prototipo di questo modello per consentire agli esperti di implementazione di iniziare a lavorare nelle prime fasi del processo di sviluppo. Nel tempo, hanno migliorato il modello di base sfruttando il natural language processing e il machine learning per raggruppare insieme note adesive simili.
Con questi modelli la comunicazione è fondamentale
La prima iterazione di questo progetto ha incontrato alcuni problemi a causa della mancanza di collaborazione costante tra il team di deployment e i data scientist che lavoravano sul modello. Questa carenza di lavoro di squadra ha portato a problemi di prestazioni del modello, test imprecisi e un’esperienza di prodotto scadente. Non sono riusciti a cogliere le sinergie dello sviluppo del modello in parallelo.
Quando hanno rilanciato il progetto e collaborato in modo efficace, hanno risolto questi problemi e impostato aspettative realistiche. La collaborazione è stata resa possibile dall’avere un modello prototipale su cui il team di deployment potesse lavorare in parallelo con il team di data science che sviluppava il modello.
Per capire le lezioni apprese dal progetto e come gestire con efficacia progetti di data science complessi, non perderti il webinar on-demand.


 Tim Lu · 12 min

 Abid Ali Awan · 15 min

Un progetto di data science comprende molti elementi che richiedono collaborazione per arrivare a un deployment di successo. Con queste parti collegate tra loro, per lo sviluppo e la messa in produzione serve un approccio agile. Questo approccio permette alle organizzazioni di imparare in fretta e iterare rapidamente. In un recente webinar di DataCamp, Brian Campbell, Engineering Manager, Internal Engineering presso Lucid Software, ha illustrato le best practice per distribuire con successo progetti di data science.
Passi iniziali per abilitare lo sviluppo agile
Brian spiega che, all’inizio di un progetto, si possono adottare due passaggi chiave per consentire progressi in parallelo sia sullo sviluppo sia sul deployment di un modello: lavorare con modelli di base e creare un prototipo. Sebbene questi approcci complichino le timeline, portano a risultati sensibilmente più rapidi e migliori.
Lavora con modelli di base
Un passo utile per spedire con successo progetti di machine learning è creare un modello di base. Un modello di base fornisce gli stessi output del modello finale. Tuttavia, viene costruito prima della maggior parte del processo di sviluppo e può basarsi su euristiche o dati casuali. Questo baseline offre un bersaglio da superare nelle iterazioni successive.
Man mano che il team sviluppa nuovi modelli, i nuovi risultati possono essere confrontati con il baseline e orientare l’apprendimento. Il divario tra il baseline e lo stato desiderato informa i requisiti del progetto e aiuta i team a identificare i dati e le soluzioni più preziosi per il problema.
Lavora con prototipi
I prototipi sono modelli che ingeriscono gli stessi input e forniscono lo stesso formato di output del modello finale. Questo modello può essere guidato dal modello di base. Una volta pronto il prototipo, chi si occupa del deployment può iniziare a lavorare sull’integrazione del modello nel suo scopo previsto. Il prototipo consente progressi in parallelo sul modello: i data scientist migliorano il modello mentre il team di implementazione lavora su come confezionarlo per i clienti o all’interno di un processo aziendale.
I prototipi funzionano solo quando il modello finale si comporta come il prototipo. È quindi necessario comprendere i dati disponibili e il formato di output previsto prima di creare il prototipo. Questo richiede una certa conoscenza del progetto oltre alla formulazione iniziale del problema e una stretta collaborazione con gli esperti di dominio.
Caso d’uso reale di baseline e prototipi
Brian racconta come il suo team in Lucid abbia utilizzato baseline e prototipi per accelerare lo sviluppo di un modello di clustering per un prodotto di note adesive usato dai team di prodotto, design ed engineering. Questi team spesso svolgono sessioni di design thinking in cui un facilitatore deve raggruppare manualmente le note adesive simili sotto una data categoria. L’obiettivo del sistema era ridurre il tempo tra brainstorming e discussione raggruppando automaticamente le idee in categorie ed eliminando i duplicati.
Il modello di base prendeva idee casuali e generava categorie casuali per esse. Poi hanno creato un prototipo di questo modello per consentire agli esperti di implementazione di iniziare a lavorare nelle prime fasi del processo di sviluppo. Nel tempo, hanno migliorato il modello di base sfruttando il natural language processing e il machine learning per raggruppare insieme note adesive simili.
Con questi modelli la comunicazione è fondamentale
La prima iterazione di questo progetto ha incontrato alcuni problemi a causa della mancanza di collaborazione costante tra il team di deployment e i data scientist che lavoravano sul modello. Questa carenza di lavoro di squadra ha portato a problemi di prestazioni del modello, test imprecisi e un’esperienza di prodotto scadente. Non sono riusciti a cogliere le sinergie dello sviluppo del modello in parallelo.
Quando hanno rilanciato il progetto e collaborato in modo efficace, hanno risolto questi problemi e impostato aspettative realistiche. La collaborazione è stata resa possibile dall’avere un modello prototipale su cui il team di deployment potesse lavorare in parallelo con il team di data science che sviluppava il modello.
Per capire le lezioni apprese dal progetto e come gestire con efficacia progetti di data science complessi, non perderti il webinar on-demand.