什么是 Julia?
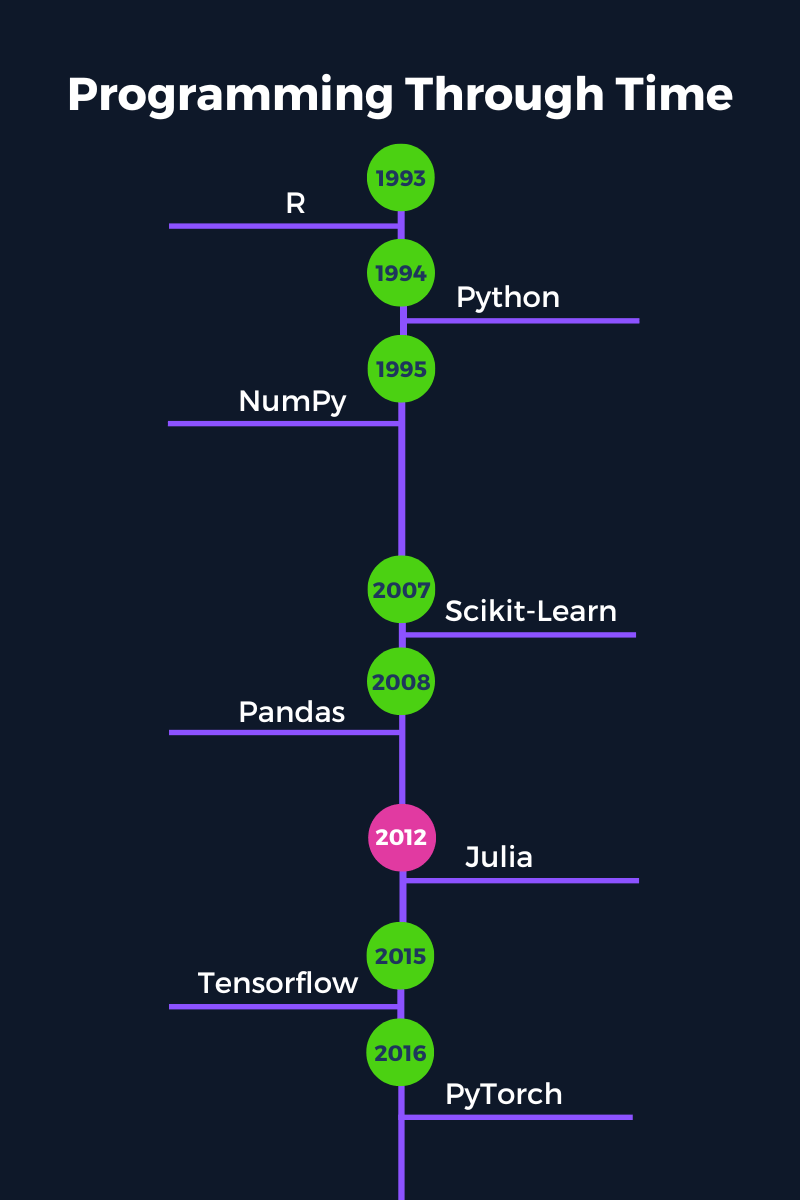
Julia 是一种相对较新的编程语言,首次发布于 2012 年。尽管 Julia 只有十来年的历史,但发展迅速,根据 2022 年 10 月的 TIOBE 指数,它现已跻身前 30 大编程语言之列。
Julia 的一大亮点是为科学计算而生。这意味着 Julia 既易用又高速,同时还能以惊人的速度处理海量数据和复杂计算。Julia 的一句著名标语是“跑得像 C,读起来像 Python”。
Julia 是一种编译型语言,却拥有解释型语言的可读性。大多数其他能够解决高强度计算问题的传统编译型语言(如 C 或 C++)在执行前必须先编译为机器可读的格式。
而 Julia 则能以解释型语言(如 Python)的简洁性实现同等性能,但无需在执行前完成预编译。相反,Julia 采用即时编译(JIT),在运行时进行编译。
为何选择 Julia 做机器学习?
长期以来,Python 一直主导数据科学和机器学习领域,这是有充分理由的:它是一门极其强大且灵活的编程语言。然而,Python 的一些劣势在 Julia 中并不存在。
与 Julia 相比,Python 的一些不足包括:
- Python 是较慢的解释型语言,提升速度的手段有限。这会让大数据机器学习项目相较于 Julia 显得低效。
- Python 使用单分派机制,对函数与库之间可使用与共享的类型有较大限制。
- 并行计算与多线程并非 Python 语言设计的内建特性。虽然存在一些支持线程的库,但并不理想。
本节将介绍多个选择 Julia 进行机器学习的原因。
您还可以在另一篇博文中进一步了解该语言的崛起以及2022 年是否值得学习 Julia。
1. 简洁易用
Julia 的语法非常友好,贴近英语。这让它更易上手学习,代码往往直观、易于理解。
Julia 的安装和上手也十分迅速便捷。无需安装语言的特殊发行版(如 Python 的 Anaconda),也不必遵循繁琐的安装流程(如 C 与 C++)。
对机器学习从业者而言,越早消除编程层面的阻力,您就能越早投入所长:分析数据与构建模型。
2. 速度
速度是 Julia 最显著的标签之一。正如上文所述,Julia 是编译型语言,相比解释型语言具备显著的速度优势。
Julia 与 C、C++、Fortran 一起,属于“拍级浮点(petaflop)俱乐部”。没错,这个小圈子只有四名成员,唯一的入场标准是:峰值性能达到每秒一拍(即一千万亿次)运算。
在机器学习中,遇到海量数据并不罕见,因此使用高速语言能显著缩短训练时间,并在将模型投入生产时降低成本。
3. 去向量化代码也很快
在 Julia 中,无需通过向量化来提升性能。以循环与原生函数形式编写的“去向量化”代码已经很快。尽管在 Julia 中进行向量化可能略有提速,但并非必要。
在构建机器学习模型时,编写与使用去向量化代码能为您节省大量时间,因为您无需为提速而重构代码。
4. 代码复用与多重分派
Julia 使用鸭子类型(duck-typing)来“猜测”函数的合适类型。其含义是:如果它走起来像鸭子、叫起来像鸭子,那它很可能就是鸭子。因此,凡是满足函数隐式规范的对象都受支持——无需显式声明。
不过,鸭子类型并不总适用于特殊情形,这时多重分派就派上用场了。借助多重分派,您可以为一个函数定义多种特殊情况,并在运行时根据满足的条件选择最合适的实现。
多重分派对机器学习很有用,因为您不必穷举函数允许接收的所有可能类型。Julia 的软件包既能保持高度灵活,又能在不同包之间共享代码与类型。
以日期格式为例:一些生态会有多种各自定制的日期与日期/时间格式。例如,Python 有内置的 datetime 格式,以及 Pandas 的 datetime64[ns] 格式。在 Julia 中,所有软件包都共享来自内置 dates 模块的单一日期相关格式。
5. 内建包管理
Julia 通过 Pkg 自动管理软件包。Pkg 之于 Julia,如同 Pip 之于 Python,但体验更好。Julia 通过两个文件来管理环境:Project.toml 和 Manifest.toml。这些文件告知 Julia 项目使用了哪些包及其版本。无需在外部定义特殊环境,包含 Project 与 Manifest 文件的 Julia 项目文件夹本身就是环境。
这种内建且简化的包管理方式,有助于更轻松地共享与复现实验与机器学习项目。
6. “两种语言”问题
您是否知道,只有 20%-30% 的 Python 软件包真正由 Python 代码构成?
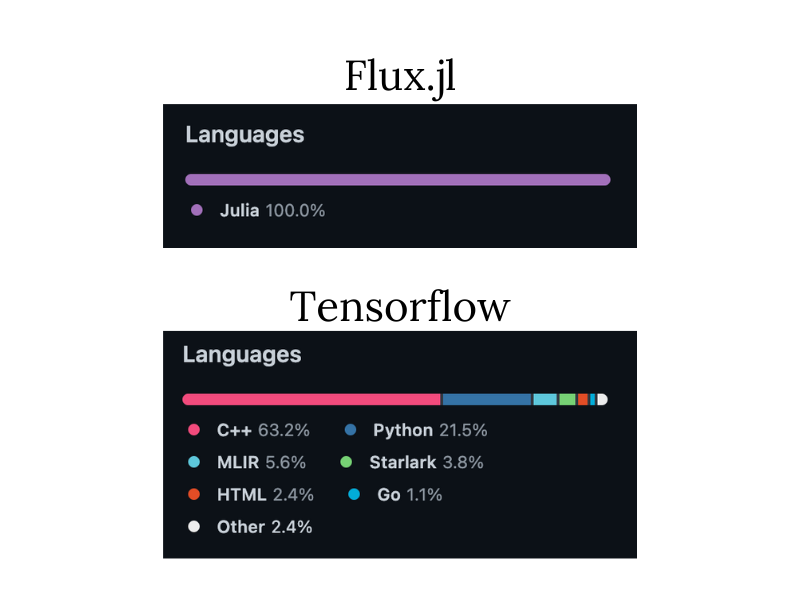
之所以依赖其他语言,是因为要开发高效、可靠的软件包,通常需要使用 C、C++ 这类低层语言。
在科学计算中,开发解决方案与软件包往往涉及两种语言:先用易于原型开发的语言(如 Python)快速实现初版方案,再将全部代码改写到高速语言(如 C++)中,作为最终版本。
可想而知,这不仅让初期开发缓慢低效,也会拖累长期维护与新功能开发。
而在 Julia 中,软件包可以直接用 Julia 进行原型、开发与维护。由此,整个开发周期将被大幅缩短。
Julia 机器学习软件包
Julia 的通用注册表中现已有超过 7,400 个软件包。虽然与 Python(超过 200,000 个)相距甚远,但要找到能解决特定问题的合适软件包仍然不易。
本节将介绍用于数据分析与构建机器学习模型的主要软件包。
不过,如果您刚开始在 Julia 中做机器学习,建议先试试工具箱式的软件包:MLJ。该包专为将最流行的机器学习包汇聚到一个易于访问的入口而设计,免去您为项目挑选最佳包所耗费的时间。MLJ 目前支持 20 多个不同的机器学习包。
下面列出的是机器学习项目中最常见的一些软件包——涵盖数据导入、清洗、可视化到建模:
- Notebook:Pluto、IJulia、Jupyter
- 包/环境管理:Pkg
- 数据导入与处理:CSV、DataFrames
- 绘图与输出:Plots、StatsPlots、LaTeXStrings、Measures、Makie
- 统计与数学:Random、Statistics、LinearAlgebra、StatsBase、Distributions、HypothesisTests、KernelDensity、Lasso、Combinatorics、SpecialFunctions、Roots
- 各类机器学习包:
- 广义线性模型(如线性回归、逻辑回归):GLM
- 深度学习:Flux、Knet
- 支持向量机:LIBSVM
- 决策树、随机森林、AdaBoost:DecisionTree
- K 近邻:NearestNeighbors
- K-means 聚类:Clustering
- 主成分分析:MultivariateStats
此外,还有许多针对流行 Python 软件包(如 Scikit-Learn 与 Tensorflow)的实现与封装。不过,您不一定需要使用这些包,因为这可能会让您失去使用 Julia 的诸多优势(如速度与多重分派)。
用 Julia 开始机器学习之旅
入门 Julia 的最佳方式之一是使用 Pluto 笔记本环境。本节将讨论使用 Pluto 的优势,特别是在您刚开始数据科学之旅、学习如何用 Julia 构建机器学习项目的阶段。我们也会介绍一些学习 Julia 与机器学习的优质资源。
Pluto
Pluto 是一个易用的交互式 Notebook 环境,拥有友好的界面。其简洁性使其非常适合 Julia 初学者。Pluto 还带有许多附加特性,让您几乎不费力就能构建更具吸引力的机器学习方案:
响应式
在评估某个单元格时,Pluto 也会考虑需要运行哪些其他单元格。该特性确保在当前单元格求值前,所有依赖的单元格都已更新。
Pluto 的妙处在于,它足够智能,准确知道除当前单元格外还需要运行哪些单元格,这样当您在笔记本中某处做出更改时,就不会遇到需要“全表更新”的问题。
Pluto 还会清理旧的或已删除的代码,并更新所有依赖单元格的输出以反映该操作。如果您在某个单元格中定义了变量,之后删除了该单元格,Pluto 也会从其命名空间中删除该变量。此外,所有依赖该变量的代码单元格会显示错误信息,提示所需的变量已被删除。
交互性
响应式会在单元格之间自动产生交互。这对于快速创建交互式图表或对象特别有用,当变量发生变化时,它们会自动更新。
Pluto 的妙处在于,该变量可以是笔记本中的交互式组件,例如内置滑块或文本框。如果您懂 Javascript,还可以自定义组件。
响应式与交互性让您能够基于机器学习模型和数据分析产出动态报告与仪表板。机器学习项目成功的关键在于沟通,而 Pluto 让展示与解释您的项目变得更加容易。
自动包管理
Pluto 与 Pkg 无缝集成,可在笔记本中自动管理软件包。不仅如此,您甚至无需在 Pluto 之外安装软件包。Pluto(与 Julia)运行与复现您的笔记本所需的全部信息,都保存在笔记本本身中!
这意味着您可以将笔记本分享给同事或同学,并确信运行该笔记本所需的全部正确软件包都会随之打包。
版本控制
所有 Pluto 笔记本都会以可执行的 .jl 文件存储。如果您在文本编辑器中打开一个笔记本,它看起来会与浏览器中的笔记本略有不同。该文件包含笔记本所需的全部信息,如代码、单元依赖关系与执行顺序。不过,这些文件不包含任何输出。所有这些都让使用 Git 与 GitHub 进行版本控制变得更加容易。
导出与分享
Pluto 笔记本可以导出为 .jl 可执行文件、静态 PDF 或静态 HTML 文件。如果导出为 HTML,接收者即便未在其机器上安装 Julia,也能选择下载并编辑原始笔记本文件。
Pluto 通过与 Binder 合作实现这一点——一个可在线托管 Pluto 笔记本的免费平台(也支持 Python 与 R 等其他语言)。
这一特性构成了机器学习工作流的最后一步:首先完成分析,然后在笔记本中构建交互式报告以展示结果,最后将笔记本分享给技术同事(他们可以复现并编辑分析)以及非技术受众。
学习 Julia 的资源
以下是学习 Julia 编程语言,以及在数据科学与机器学习中如何使用它的强力推荐资源:

什么是 Julia?
Julia 是一种相对较新的编程语言,首次发布于 2012 年。尽管 Julia 只有十来年的历史,但发展迅速,根据 2022 年 10 月的 TIOBE 指数,它现已跻身前 30 大编程语言之列。
Julia 的一大亮点是为科学计算而生。这意味着 Julia 既易用又高速,同时还能以惊人的速度处理海量数据和复杂计算。Julia 的一句著名标语是“跑得像 C,读起来像 Python”。
Julia 是一种编译型语言,却拥有解释型语言的可读性。大多数其他能够解决高强度计算问题的传统编译型语言(如 C 或 C++)在执行前必须先编译为机器可读的格式。
而 Julia 则能以解释型语言(如 Python)的简洁性实现同等性能,但无需在执行前完成预编译。相反,Julia 采用即时编译(JIT),在运行时进行编译。
为何选择 Julia 做机器学习?
长期以来,Python 一直主导数据科学和机器学习领域,这是有充分理由的:它是一门极其强大且灵活的编程语言。然而,Python 的一些劣势在 Julia 中并不存在。
与 Julia 相比,Python 的一些不足包括:
本节将介绍多个选择 Julia 进行机器学习的原因。
您还可以在另一篇博文中进一步了解该语言的崛起以及2022 年是否值得学习 Julia。
1. 简洁易用
Julia 的语法非常友好,贴近英语。这让它更易上手学习,代码往往直观、易于理解。
Julia 的安装和上手也十分迅速便捷。无需安装语言的特殊发行版(如 Python 的 Anaconda),也不必遵循繁琐的安装流程(如 C 与 C++)。
对机器学习从业者而言,越早消除编程层面的阻力,您就能越早投入所长:分析数据与构建模型。
2. 速度
速度是 Julia 最显著的标签之一。正如上文所述,Julia 是编译型语言,相比解释型语言具备显著的速度优势。
Julia 与 C、C++、Fortran 一起,属于“拍级浮点(petaflop)俱乐部”。没错,这个小圈子只有四名成员,唯一的入场标准是:峰值性能达到每秒一拍(即一千万亿次)运算。
在机器学习中,遇到海量数据并不罕见,因此使用高速语言能显著缩短训练时间,并在将模型投入生产时降低成本。
3. 去向量化代码也很快
在 Julia 中,无需通过向量化来提升性能。以循环与原生函数形式编写的“去向量化”代码已经很快。尽管在 Julia 中进行向量化可能略有提速,但并非必要。
在构建机器学习模型时,编写与使用去向量化代码能为您节省大量时间,因为您无需为提速而重构代码。
4. 代码复用与多重分派
Julia 使用鸭子类型(duck-typing)来“猜测”函数的合适类型。其含义是:如果它走起来像鸭子、叫起来像鸭子,那它很可能就是鸭子。因此,凡是满足函数隐式规范的对象都受支持——无需显式声明。
不过,鸭子类型并不总适用于特殊情形,这时多重分派就派上用场了。借助多重分派,您可以为一个函数定义多种特殊情况,并在运行时根据满足的条件选择最合适的实现。
多重分派对机器学习很有用,因为您不必穷举函数允许接收的所有可能类型。Julia 的软件包既能保持高度灵活,又能在不同包之间共享代码与类型。
以日期格式为例:一些生态会有多种各自定制的日期与日期/时间格式。例如,Python 有内置的 datetime 格式,以及 Pandas 的 datetime64[ns] 格式。在 Julia 中,所有软件包都共享来自内置 dates 模块的单一日期相关格式。
5. 内建包管理
Julia 通过 Pkg 自动管理软件包。Pkg 之于 Julia,如同 Pip 之于 Python,但体验更好。Julia 通过两个文件来管理环境:Project.toml 和 Manifest.toml。这些文件告知 Julia 项目使用了哪些包及其版本。无需在外部定义特殊环境,包含 Project 与 Manifest 文件的 Julia 项目文件夹本身就是环境。
这种内建且简化的包管理方式,有助于更轻松地共享与复现实验与机器学习项目。
6. “两种语言”问题
您是否知道,只有 20%-30% 的 Python 软件包真正由 Python 代码构成?
之所以依赖其他语言,是因为要开发高效、可靠的软件包,通常需要使用 C、C++ 这类低层语言。
在科学计算中,开发解决方案与软件包往往涉及两种语言:先用易于原型开发的语言(如 Python)快速实现初版方案,再将全部代码改写到高速语言(如 C++)中,作为最终版本。
可想而知,这不仅让初期开发缓慢低效,也会拖累长期维护与新功能开发。
而在 Julia 中,软件包可以直接用 Julia 进行原型、开发与维护。由此,整个开发周期将被大幅缩短。
Julia 机器学习软件包
Julia 的通用注册表中现已有超过 7,400 个软件包。虽然与 Python(超过 200,000 个)相距甚远,但要找到能解决特定问题的合适软件包仍然不易。
本节将介绍用于数据分析与构建机器学习模型的主要软件包。
不过,如果您刚开始在 Julia 中做机器学习,建议先试试工具箱式的软件包:MLJ。该包专为将最流行的机器学习包汇聚到一个易于访问的入口而设计,免去您为项目挑选最佳包所耗费的时间。MLJ 目前支持 20 多个不同的机器学习包。
下面列出的是机器学习项目中最常见的一些软件包——涵盖数据导入、清洗、可视化到建模:
此外,还有许多针对流行 Python 软件包(如 Scikit-Learn 与 Tensorflow)的实现与封装。不过,您不一定需要使用这些包,因为这可能会让您失去使用 Julia 的诸多优势(如速度与多重分派)。
用 Julia 开始机器学习之旅
入门 Julia 的最佳方式之一是使用 Pluto 笔记本环境。本节将讨论使用 Pluto 的优势,特别是在您刚开始数据科学之旅、学习如何用 Julia 构建机器学习项目的阶段。我们也会介绍一些学习 Julia 与机器学习的优质资源。
Pluto
Pluto 是一个易用的交互式 Notebook 环境,拥有友好的界面。其简洁性使其非常适合 Julia 初学者。Pluto 还带有许多附加特性,让您几乎不费力就能构建更具吸引力的机器学习方案:
响应式
在评估某个单元格时,Pluto 也会考虑需要运行哪些其他单元格。该特性确保在当前单元格求值前,所有依赖的单元格都已更新。
Pluto 的妙处在于,它足够智能,准确知道除当前单元格外还需要运行哪些单元格,这样当您在笔记本中某处做出更改时,就不会遇到需要“全表更新”的问题。
Pluto 还会清理旧的或已删除的代码,并更新所有依赖单元格的输出以反映该操作。如果您在某个单元格中定义了变量,之后删除了该单元格,Pluto 也会从其命名空间中删除该变量。此外,所有依赖该变量的代码单元格会显示错误信息,提示所需的变量已被删除。
交互性
响应式会在单元格之间自动产生交互。这对于快速创建交互式图表或对象特别有用,当变量发生变化时,它们会自动更新。
Pluto 的妙处在于,该变量可以是笔记本中的交互式组件,例如内置滑块或文本框。如果您懂 Javascript,还可以自定义组件。
响应式与交互性让您能够基于机器学习模型和数据分析产出动态报告与仪表板。机器学习项目成功的关键在于沟通,而 Pluto 让展示与解释您的项目变得更加容易。
自动包管理
Pluto 与 Pkg 无缝集成,可在笔记本中自动管理软件包。不仅如此,您甚至无需在 Pluto 之外安装软件包。Pluto(与 Julia)运行与复现您的笔记本所需的全部信息,都保存在笔记本本身中!
这意味着您可以将笔记本分享给同事或同学,并确信运行该笔记本所需的全部正确软件包都会随之打包。
版本控制
所有 Pluto 笔记本都会以可执行的 .jl 文件存储。如果您在文本编辑器中打开一个笔记本,它看起来会与浏览器中的笔记本略有不同。该文件包含笔记本所需的全部信息,如代码、单元依赖关系与执行顺序。不过,这些文件不包含任何输出。所有这些都让使用 Git 与 GitHub 进行版本控制变得更加容易。
导出与分享
Pluto 笔记本可以导出为 .jl 可执行文件、静态 PDF 或静态 HTML 文件。如果导出为 HTML,接收者即便未在其机器上安装 Julia,也能选择下载并编辑原始笔记本文件。
Pluto 通过与 Binder 合作实现这一点——一个可在线托管 Pluto 笔记本的免费平台(也支持 Python 与 R 等其他语言)。
这一特性构成了机器学习工作流的最后一步:首先完成分析,然后在笔记本中构建交互式报告以展示结果,最后将笔记本分享给技术同事(他们可以复现并编辑分析)以及非技术受众。
学习 Julia 的资源
以下是学习 Julia 编程语言,以及在数据科学与机器学习中如何使用它的强力推荐资源: