Qu'est-ce que Julia ?
Julia est un langage de programmation relativement récent, publié pour la première fois en 2012. Bien que Julia n'existe que depuis une dizaine d'années, sa croissance est rapide et il fait désormais partie du top 30 des langages de programmation selon l'index TIOBE d'octobre 2022.
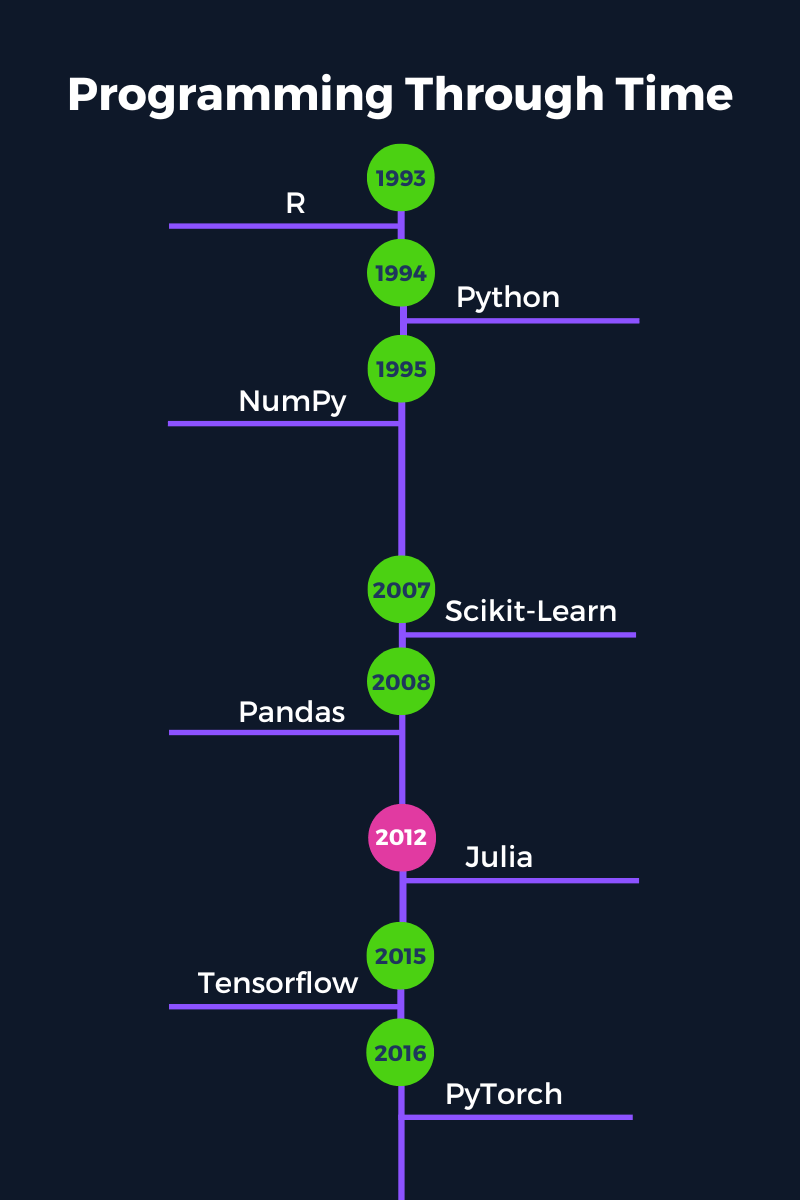
La force de Julia, c'est d'avoir été conçu pour le calcul scientifique. Résultat : un langage à la fois simple d'utilisation et rapide, capable de traiter de gros volumes de données et des calculs complexes à des vitesses impressionnantes. Un slogan bien connu résume Julia ainsi : il "s'exécute comme C et se lit comme Python".
Julia est un langage compilé qui se lit comme un langage interprété. La plupart des langages compilés traditionnels (comme C ou C++) capables de résoudre des problèmes très intensifs en calcul doivent d'abord être compilés en code machine avant exécution.
À l'inverse, Julia atteint des performances similaires avec la simplicité d'un langage interprété (comme Python), sans compilation préalable. Julia utilise un compilateur Just-In-Time (JIT) qui compile à l'exécution.
Pourquoi choisir Julia pour le machine learning ?
Python domine depuis longtemps le paysage de la data science et du machine learning, et à juste titre. C'est un langage extrêmement puissant et flexible. Cependant, certains inconvénients de Python disparaissent avec Julia.
Par rapport à Julia, Python présente notamment :
- une exécution plus lente (langage interprété) et peu d'options pour accélérer significativement. Sur des projets de machine learning à grande échelle, cela peut être moins efficace que Julia ;
- un modèle de simple dispatch, qui limite fortement les types utilisables et partageables entre fonctions et bibliothèques ;
- un parallélisme et un multithreading qui ne font pas partie de la conception même du langage. Des bibliothèques existent, mais ce n'est pas optimal.
Dans cette section, nous passons en revue plusieurs raisons qui font de Julia un excellent choix pour le machine learning.
Vous pouvez aussi explorer la montée en puissance du langage et voir s'il vaut la peine d'apprendre Julia en 2022 dans un autre article.
1. Simplicité et prise en main
Julia propose une syntaxe très accessible, proche de l'anglais. L'apprentissage est plus rapide : le code est souvent intuitif et facile à lire.
L'installation de Julia est également rapide et simple. Pas besoin d'installer des distributions spécifiques (comme Python avec Anaconda) ni de suivre des procédures d'installation complexes (comme avec C et C++).
Pour les praticiens du machine learning, moins vous avez de frictions côté programmation, plus vite vous pouvez vous concentrer sur l'essentiel : analyser les données et construire des modèles.
2. Vitesse
L'une des signatures de Julia, c'est sa vitesse. Comme indiqué plus haut, Julia est un langage compilé, ce qui apporte des gains substantiels face aux langages interprétés.
Julia appartient au "club du pétaflop" aux côtés de C, C++ et Fortran. Autrement dit, cet aréopage très restreint ne compte que quatre membres, et une seule condition d'entrée : atteindre un pétaflop (soit mille milliards d'opérations) par seconde en pic de performance.
En machine learning, traiter de très grands volumes de données est courant. Utiliser un langage rapide peut donc réduire fortement les temps d'entraînement et les coûts de mise en production.
3. Le code dévectorisé est rapide
Avec Julia, pas besoin de vectoriser le code pour gagner en performance. Les boucles et fonctions natives, donc du code dévectorisé, sont déjà rapides. La vectorisation peut apporter un léger surcroît de vitesse, mais elle n'est pas nécessaire.
Écrire et utiliser du code dévectorisé vous fera gagner du temps lors de la construction de modèles, car vous n'aurez pas à refactoriser pour optimiser la vitesse.
4. Réutilisation du code et multiple dispatch
Julia utilise le duck typing pour "deviner" le type approprié d'une fonction. En clair : si ça marche comme un canard et que ça cancane comme un canard, c'est probablement un canard. Tout objet qui respecte les spécifications implicites d'une fonction est accepté : pas besoin de le préciser explicitement.
Le duck typing n'est toutefois pas toujours idéal pour les cas particuliers : c'est là qu'intervient le multiple dispatch. Vous pouvez définir plusieurs variantes spécialisées d'une fonction et, selon les conditions, Julia choisira au moment de l'exécution l'option la plus adaptée.
Le multiple dispatch est précieux en machine learning : vous n'avez pas à anticiper tous les types possibles autorisés à passer à une fonction. Les packages restent très flexibles, tout en pouvant partager code et types entre différentes bibliothèques.
Prenez le format de date : de nombreux écosystèmes proposent leurs propres formats date et date/heure. Par exemple, Python a le type datetime natif et Pandas le format datetime64[ns]. En Julia, un format unique basé sur les dates, issu du module Dates intégré, est partagé entre tous les packages.
5. Gestion de packages intégrée
Julia gère automatiquement les packages avec Pkg. Pkg pour Julia, c'est l'équivalent de Pip pour Python, en plus abouti. Les environnements sont gérés via deux fichiers : Project.toml et Manifest.toml. Ils indiquent les packages utilisés par le projet et leurs versions. Inutile de définir des environnements externes : le dossier qui contient vos fichiers Julia (avec les fichiers Project et Manifest) fait office d'environnement.
Cette gestion intégrée et simplifiée facilite le partage et la reproductibilité de vos projets et analyses de machine learning.
6. Le problème des deux langages
Saviez-vous que seuls 20 à 30 % des packages Python sont réellement écrits en Python ?
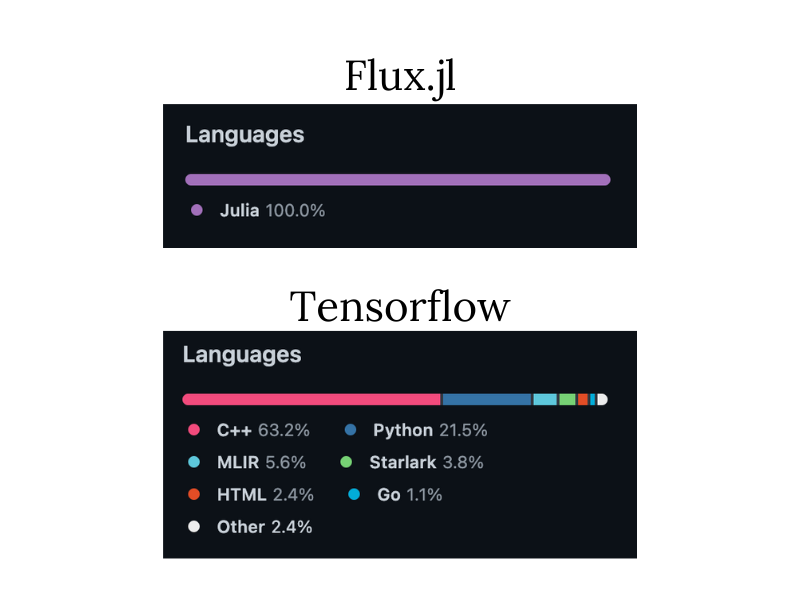
Cette dépendance à d'autres langages s'explique par la nécessité, pour créer des packages performants, de s'appuyer sur des langages bas niveau comme C et C++.
En calcul scientifique, on utilise souvent deux langages : un langage simple pour prototyper (comme Python) afin d'obtenir rapidement une première version, puis un langage rapide (comme C++) dans lequel on réécrit tout le code pour la version finale.
Vous l'imaginez, c'est un processus lent et inefficace, tant pour le développement initial que pour la maintenance et l'ajout de nouvelles fonctionnalités.
Avec Julia, les packages peuvent être prototypés, développés et maintenus dans le même langage. Le cycle de développement s'en trouve considérablement raccourci.
Packages Julia pour le machine learning
Le registre général de Julia compte aujourd'hui plus de 7 400 packages. Certes, on est loin du volume disponible en Python (plus de 200 000), mais trouver le bon package pour un besoin donné peut malgré tout rester délicat.
Cette section présente les principaux packages dont vous aurez besoin pour analyser des données et construire des modèles de machine learning.
Si vous débutez en machine learning avec Julia, commencez par la boîte à outils MLJ. Ce package rassemble les bibliothèques de machine learning les plus populaires en un seul endroit, facilement accessible, pour vous éviter de longues recherches. MLJ prend actuellement en charge plus de 20 packages différents.
Voici une sélection de packages courants que vous rencontrerez dans vos projets de machine learning : de l'import, au nettoyage et à la visualisation des données, jusqu'à la modélisation :
- Notebook : Pluto, IJulia, Jupyter
- Gestion des packages/environnements : Pkg
- Import et manipulation des données : CSV, DataFrames
- Visualisation et sortie : Plots, StatsPlots, LaTeXStrings, Measures, Makie
- Statistiques et mathématiques : Random, Statistics, LinearAlgebra, StatsBase, Distributions, HypothesisTests, KernelDensity, Lasso, Combinatorics, SpecialFunctions, Roots
- Packages de machine learning :
- Modèles linéaires généralisés (régression linéaire, régression logistique, etc.) : GLM
- Deep learning : Flux, Knet
- Machines à vecteurs de support : LIBSVM
- Arbre de décision, forêt aléatoire, AdaBoost : DecisionTree
- K plus proches voisins : NearestNeighbors
- Clustering k-means : Clustering
- Analyse en composantes principales : MultivariateStats
Il existe aussi de nombreuses implémentations et wrappers pour des bibliothèques Python populaires comme Scikit-Learn et TensorFlow. Toutefois, vous n'avez pas nécessairement besoin de ces passerelles, au risque de perdre certains atouts majeurs de Julia (comme la vitesse et le multiple dispatch).
Bien démarrer avec Julia pour le machine learning
L'un des meilleurs moyens de débuter avec Julia est d'utiliser l'environnement de notebooks Pluto. Dans cette section, nous expliquons pourquoi Pluto est particulièrement utile au début de votre parcours en data science, lorsque vous apprenez encore à construire des projets de machine learning avec Julia. Nous partageons aussi des ressources clés pour approfondir Julia et le machine learning.
Pluto
Pluto est un environnement de notebook interactif, simple d'utilisation, avec une interface conviviale. Cette simplicité en fait un excellent choix pour bien démarrer avec Julia. Pluto propose en plus de nombreuses fonctionnalités qui facilitent la création de solutions de machine learning puissantes, presque sans effort :
Réactif
Lors de l'exécution d'une cellule, Pluto détermine aussi quelles autres cellules doivent être lancées. Ainsi, toutes les cellules dépendantes sont mises à jour avant l'évaluation courante.
Pluto sait exactement quelles cellules relancer en plus de la cellule active, ce qui évite d'avoir à tout réexécuter dès que vous modifiez quelque chose dans le notebook.
Pluto nettoie aussi l'ancien code ou le code supprimé et met à jour la sortie des cellules dépendantes. Si vous définissez une variable dans une cellule puis supprimez cette cellule, Pluto retire également la variable de son espace de noms. Les cellules dépendantes afficheront une erreur indiquant que la variable requise a été supprimée.
Interactif
La réactivité induit une interactivité automatique entre cellules. C'est idéal pour créer rapidement des graphiques ou objets interactifs, mis à jour automatiquement quand une variable change.
Autre atout : cette variable peut être un widget interactif intégré au notebook, comme un curseur ou un champ texte. Vous pouvez même concevoir vos propres widgets si vous connaissez JavaScript.
Réactivité et interactivité vous permettent de produire des rapports et tableaux de bord dynamiques basés sur vos modèles et analyses. La clé d'un projet de machine learning réussi, c'est la communication, et Pluto facilite la démonstration et l'explication de vos résultats.
Gestion automatique des packages
Pluto s'intègre parfaitement à Pkg pour gérer automatiquement les packages dans vos notebooks. Mieux encore, vous n'avez pas besoin d'installer les packages en dehors de Pluto. Toutes les informations nécessaires à l'exécution et à la reproduction du notebook sont stockées directement dans le fichier du notebook lui-même !
Vous pouvez donc partager votre notebook avec des collègues ou camarades, en étant certain que tous les bons packages nécessaires à son exécution l'accompagneront.
Gestion de versions
Tous les notebooks Pluto sont enregistrés sous forme de fichiers .jl exécutables. Si vous ouvrez un notebook dans un éditeur de texte, il aura un aspect différent de celui affiché dans le navigateur. Le fichier contient toutes les informations nécessaires : code, dépendances entre cellules, ordre d'exécution. En revanche, il ne contient pas les sorties. Tout cela rend la gestion de versions via Git et GitHub beaucoup plus simple.
Export et partage
Les notebooks Pluto peuvent être exportés en fichier .jl exécutable, en PDF statique ou en HTML statique. En exportant en HTML, la personne avec qui vous le partagez pourra télécharger et modifier le fichier brut du notebook, même sans Julia installé sur sa machine.
Pluto s'appuie pour cela sur Binder : une plateforme gratuite qui héberge des notebooks Pluto en ligne (et fonctionne aussi avec d'autres langages comme Python et R).
C'est l'étape finale d'un flux de travail en machine learning : vous menez l'analyse, vous construisez un rapport interactif dans le notebook pour présenter les résultats, puis vous partagez le notebook avec des profils techniques (qui peuvent reproduire et éditer l'analyse) comme non techniques.
Ressources pour apprendre Julia
Voici quelques ressources vivement recommandées pour apprendre le langage Julia et son usage en data science et machine learning :


 Matt Crabtree · 5 min

 Josef Waples · 8 min

 Mark Pedigo · 10 min





Qu'est-ce que Julia ?
Julia est un langage de programmation relativement récent, publié pour la première fois en 2012. Bien que Julia n'existe que depuis une dizaine d'années, sa croissance est rapide et il fait désormais partie du top 30 des langages de programmation selon l'index TIOBE d'octobre 2022.
La force de Julia, c'est d'avoir été conçu pour le calcul scientifique. Résultat : un langage à la fois simple d'utilisation et rapide, capable de traiter de gros volumes de données et des calculs complexes à des vitesses impressionnantes. Un slogan bien connu résume Julia ainsi : il "s'exécute comme C et se lit comme Python".
Julia est un langage compilé qui se lit comme un langage interprété. La plupart des langages compilés traditionnels (comme C ou C++) capables de résoudre des problèmes très intensifs en calcul doivent d'abord être compilés en code machine avant exécution.
À l'inverse, Julia atteint des performances similaires avec la simplicité d'un langage interprété (comme Python), sans compilation préalable. Julia utilise un compilateur Just-In-Time (JIT) qui compile à l'exécution.
Pourquoi choisir Julia pour le machine learning ?
Python domine depuis longtemps le paysage de la data science et du machine learning, et à juste titre. C'est un langage extrêmement puissant et flexible. Cependant, certains inconvénients de Python disparaissent avec Julia.
Par rapport à Julia, Python présente notamment :
Dans cette section, nous passons en revue plusieurs raisons qui font de Julia un excellent choix pour le machine learning.
Vous pouvez aussi explorer la montée en puissance du langage et voir s'il vaut la peine d'apprendre Julia en 2022 dans un autre article.
1. Simplicité et prise en main
Julia propose une syntaxe très accessible, proche de l'anglais. L'apprentissage est plus rapide : le code est souvent intuitif et facile à lire.
L'installation de Julia est également rapide et simple. Pas besoin d'installer des distributions spécifiques (comme Python avec Anaconda) ni de suivre des procédures d'installation complexes (comme avec C et C++).
Pour les praticiens du machine learning, moins vous avez de frictions côté programmation, plus vite vous pouvez vous concentrer sur l'essentiel : analyser les données et construire des modèles.
2. Vitesse
L'une des signatures de Julia, c'est sa vitesse. Comme indiqué plus haut, Julia est un langage compilé, ce qui apporte des gains substantiels face aux langages interprétés.
Julia appartient au "club du pétaflop" aux côtés de C, C++ et Fortran. Autrement dit, cet aréopage très restreint ne compte que quatre membres, et une seule condition d'entrée : atteindre un pétaflop (soit mille milliards d'opérations) par seconde en pic de performance.
En machine learning, traiter de très grands volumes de données est courant. Utiliser un langage rapide peut donc réduire fortement les temps d'entraînement et les coûts de mise en production.
3. Le code dévectorisé est rapide
Avec Julia, pas besoin de vectoriser le code pour gagner en performance. Les boucles et fonctions natives, donc du code dévectorisé, sont déjà rapides. La vectorisation peut apporter un léger surcroît de vitesse, mais elle n'est pas nécessaire.
Écrire et utiliser du code dévectorisé vous fera gagner du temps lors de la construction de modèles, car vous n'aurez pas à refactoriser pour optimiser la vitesse.
4. Réutilisation du code et multiple dispatch
Julia utilise le duck typing pour "deviner" le type approprié d'une fonction. En clair : si ça marche comme un canard et que ça cancane comme un canard, c'est probablement un canard. Tout objet qui respecte les spécifications implicites d'une fonction est accepté : pas besoin de le préciser explicitement.
Le duck typing n'est toutefois pas toujours idéal pour les cas particuliers : c'est là qu'intervient le multiple dispatch. Vous pouvez définir plusieurs variantes spécialisées d'une fonction et, selon les conditions, Julia choisira au moment de l'exécution l'option la plus adaptée.
Le multiple dispatch est précieux en machine learning : vous n'avez pas à anticiper tous les types possibles autorisés à passer à une fonction. Les packages restent très flexibles, tout en pouvant partager code et types entre différentes bibliothèques.
Prenez le format de date : de nombreux écosystèmes proposent leurs propres formats date et date/heure. Par exemple, Python a le type datetime natif et Pandas le format datetime64[ns]. En Julia, un format unique basé sur les dates, issu du module Dates intégré, est partagé entre tous les packages.
5. Gestion de packages intégrée
Julia gère automatiquement les packages avec Pkg. Pkg pour Julia, c'est l'équivalent de Pip pour Python, en plus abouti. Les environnements sont gérés via deux fichiers : Project.toml et Manifest.toml. Ils indiquent les packages utilisés par le projet et leurs versions. Inutile de définir des environnements externes : le dossier qui contient vos fichiers Julia (avec les fichiers Project et Manifest) fait office d'environnement.
Cette gestion intégrée et simplifiée facilite le partage et la reproductibilité de vos projets et analyses de machine learning.
6. Le problème des deux langages
Saviez-vous que seuls 20 à 30 % des packages Python sont réellement écrits en Python ?
Cette dépendance à d'autres langages s'explique par la nécessité, pour créer des packages performants, de s'appuyer sur des langages bas niveau comme C et C++.
En calcul scientifique, on utilise souvent deux langages : un langage simple pour prototyper (comme Python) afin d'obtenir rapidement une première version, puis un langage rapide (comme C++) dans lequel on réécrit tout le code pour la version finale.
Vous l'imaginez, c'est un processus lent et inefficace, tant pour le développement initial que pour la maintenance et l'ajout de nouvelles fonctionnalités.
Avec Julia, les packages peuvent être prototypés, développés et maintenus dans le même langage. Le cycle de développement s'en trouve considérablement raccourci.
Packages Julia pour le machine learning
Le registre général de Julia compte aujourd'hui plus de 7 400 packages. Certes, on est loin du volume disponible en Python (plus de 200 000), mais trouver le bon package pour un besoin donné peut malgré tout rester délicat.
Cette section présente les principaux packages dont vous aurez besoin pour analyser des données et construire des modèles de machine learning.
Si vous débutez en machine learning avec Julia, commencez par la boîte à outils MLJ. Ce package rassemble les bibliothèques de machine learning les plus populaires en un seul endroit, facilement accessible, pour vous éviter de longues recherches. MLJ prend actuellement en charge plus de 20 packages différents.
Voici une sélection de packages courants que vous rencontrerez dans vos projets de machine learning : de l'import, au nettoyage et à la visualisation des données, jusqu'à la modélisation :
Il existe aussi de nombreuses implémentations et wrappers pour des bibliothèques Python populaires comme Scikit-Learn et TensorFlow. Toutefois, vous n'avez pas nécessairement besoin de ces passerelles, au risque de perdre certains atouts majeurs de Julia (comme la vitesse et le multiple dispatch).
Bien démarrer avec Julia pour le machine learning
L'un des meilleurs moyens de débuter avec Julia est d'utiliser l'environnement de notebooks Pluto. Dans cette section, nous expliquons pourquoi Pluto est particulièrement utile au début de votre parcours en data science, lorsque vous apprenez encore à construire des projets de machine learning avec Julia. Nous partageons aussi des ressources clés pour approfondir Julia et le machine learning.
Pluto
Pluto est un environnement de notebook interactif, simple d'utilisation, avec une interface conviviale. Cette simplicité en fait un excellent choix pour bien démarrer avec Julia. Pluto propose en plus de nombreuses fonctionnalités qui facilitent la création de solutions de machine learning puissantes, presque sans effort :
Réactif
Lors de l'exécution d'une cellule, Pluto détermine aussi quelles autres cellules doivent être lancées. Ainsi, toutes les cellules dépendantes sont mises à jour avant l'évaluation courante.
Pluto sait exactement quelles cellules relancer en plus de la cellule active, ce qui évite d'avoir à tout réexécuter dès que vous modifiez quelque chose dans le notebook.
Pluto nettoie aussi l'ancien code ou le code supprimé et met à jour la sortie des cellules dépendantes. Si vous définissez une variable dans une cellule puis supprimez cette cellule, Pluto retire également la variable de son espace de noms. Les cellules dépendantes afficheront une erreur indiquant que la variable requise a été supprimée.
Interactif
La réactivité induit une interactivité automatique entre cellules. C'est idéal pour créer rapidement des graphiques ou objets interactifs, mis à jour automatiquement quand une variable change.
Autre atout : cette variable peut être un widget interactif intégré au notebook, comme un curseur ou un champ texte. Vous pouvez même concevoir vos propres widgets si vous connaissez JavaScript.
Réactivité et interactivité vous permettent de produire des rapports et tableaux de bord dynamiques basés sur vos modèles et analyses. La clé d'un projet de machine learning réussi, c'est la communication, et Pluto facilite la démonstration et l'explication de vos résultats.
Gestion automatique des packages
Pluto s'intègre parfaitement à Pkg pour gérer automatiquement les packages dans vos notebooks. Mieux encore, vous n'avez pas besoin d'installer les packages en dehors de Pluto. Toutes les informations nécessaires à l'exécution et à la reproduction du notebook sont stockées directement dans le fichier du notebook lui-même !
Vous pouvez donc partager votre notebook avec des collègues ou camarades, en étant certain que tous les bons packages nécessaires à son exécution l'accompagneront.
Gestion de versions
Tous les notebooks Pluto sont enregistrés sous forme de fichiers .jl exécutables. Si vous ouvrez un notebook dans un éditeur de texte, il aura un aspect différent de celui affiché dans le navigateur. Le fichier contient toutes les informations nécessaires : code, dépendances entre cellules, ordre d'exécution. En revanche, il ne contient pas les sorties. Tout cela rend la gestion de versions via Git et GitHub beaucoup plus simple.
Export et partage
Les notebooks Pluto peuvent être exportés en fichier .jl exécutable, en PDF statique ou en HTML statique. En exportant en HTML, la personne avec qui vous le partagez pourra télécharger et modifier le fichier brut du notebook, même sans Julia installé sur sa machine.
Pluto s'appuie pour cela sur Binder : une plateforme gratuite qui héberge des notebooks Pluto en ligne (et fonctionne aussi avec d'autres langages comme Python et R).
C'est l'étape finale d'un flux de travail en machine learning : vous menez l'analyse, vous construisez un rapport interactif dans le notebook pour présenter les résultats, puis vous partagez le notebook avec des profils techniques (qui peuvent reproduire et éditer l'analyse) comme non techniques.
Ressources pour apprendre Julia
Voici quelques ressources vivement recommandées pour apprendre le langage Julia et son usage en data science et machine learning :