Julia là gì?
Julia là một ngôn ngữ lập trình tương đối mới, lần đầu phát hành vào năm 2012. Dù mới chỉ xuất hiện khoảng mười năm, Julia đã phát triển nhanh chóng và hiện nằm trong top 30 ngôn ngữ lập trình theo chỉ số TIOBE tháng 10/2022.
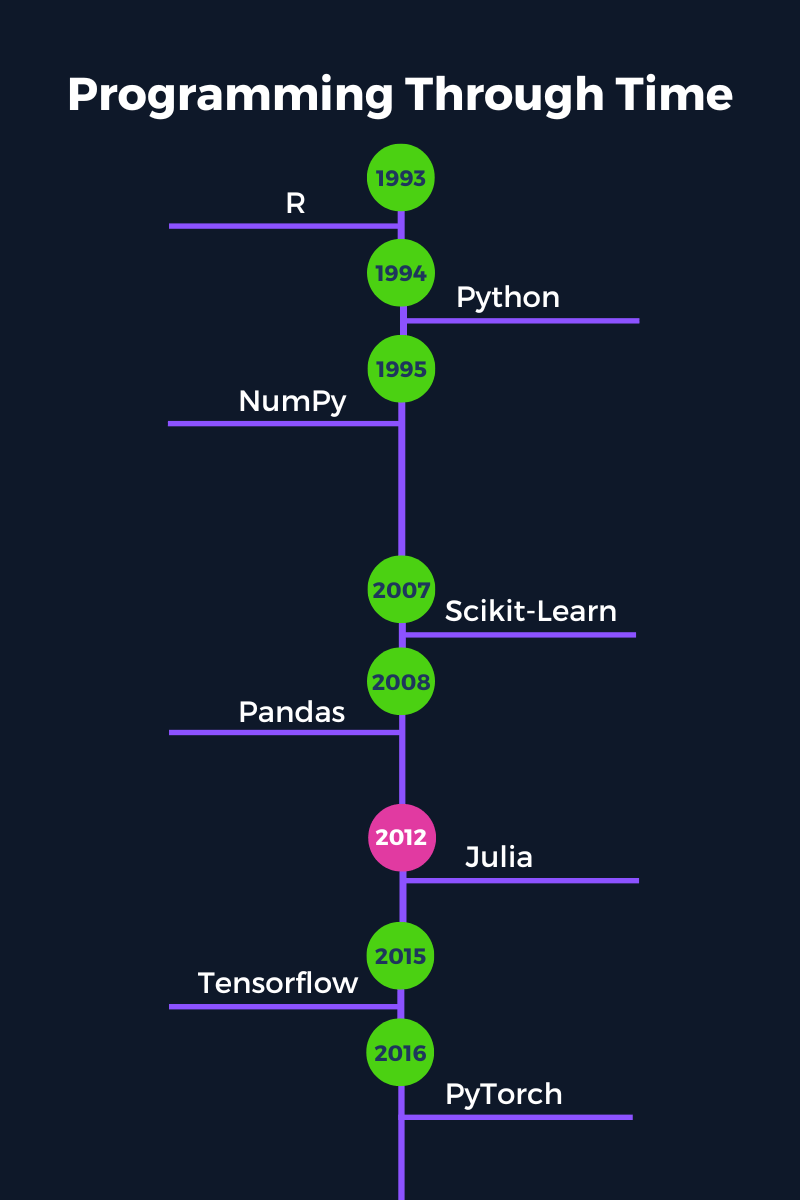
Một điểm nổi bật của Julia là được xây dựng cho tính toán khoa học. Điều này có nghĩa Julia vừa dễ dùng, vừa nhanh, đồng thời có khả năng xử lý lượng dữ liệu lớn và các phép tính phức tạp với tốc độ vượt trội. Khẩu hiệu nổi tiếng của Julia là "chạy như C nhưng đọc như Python."
Julia là ngôn ngữ biên dịch nhưng có cú pháp dễ đọc như ngôn ngữ thông dịch. Hầu hết các ngôn ngữ biên dịch truyền thống khác (như C hoặc C++) có thể giải quyết các bài toán tính toán nặng đều phải được biên dịch sang định dạng máy có thể đọc trước khi thực thi.
Ngược lại, Julia đạt được hiệu năng tương đương với sự đơn giản của ngôn ngữ thông dịch (như Python) mà không cần biên dịch trước khi chạy. Thay vào đó, Julia sử dụng bộ biên dịch Just-In-Time (JIT) để biên dịch khi chạy.
Tại sao chọn Julia cho Machine Learning?
Python đã thống trị lĩnh vực khoa học dữ liệu và machine learning trong thời gian dài, và có lý do chính đáng: đó là một ngôn ngữ cực kỳ mạnh mẽ và linh hoạt. Tuy nhiên, một số hạn chế của Python lại không phải là vấn đề trong Julia.
Một vài điểm hạn chế của Python so với Julia gồm:
- Python là ngôn ngữ thông dịch chậm hơn và có ít lựa chọn để cải thiện tốc độ. Điều này có thể khiến các dự án machine learning dữ liệu lớn kém hiệu quả hơn so với dùng Julia.
- Python sử dụng single dispatch, gây hạn chế đáng kể về các kiểu có thể dùng và chia sẻ giữa các hàm và thư viện.
- Tính toán song song và threading không được tích hợp sẵn trong thiết kế ngôn ngữ Python. Dù có thư viện hỗ trợ threading ở mức nào đó, nhưng không tối ưu.
Trong phần này, chúng ta sẽ điểm qua một số lý do khiến Julia là lựa chọn tuyệt vời cho machine learning.
Bạn có thể tìm hiểu thêm về sự trỗi dậy của ngôn ngữ này và liệu có nên học Julia vào năm 2022 trong một bài viết riêng.
1. Đơn giản & Dễ sử dụng
Julia có cú pháp rất thân thiện, gần với tiếng Anh. Điều này giúp việc học và làm quen nhanh hơn vì mã thường直 quan và dễ hiểu.
Julia cũng cài đặt nhanh chóng, dễ dàng để bắt đầu ngay. Không cần cài các bản phân phối đặc biệt (như Python với Anaconda) hay theo quy trình cài đặt rườm rà (như C và C++).
Với người làm machine learning, loại bỏ càng sớm ma sát trong khâu lập trình, bạn càng nhanh bắt tay vào việc mình làm tốt nhất: phân tích dữ liệu và xây dựng mô hình.
2. Tốc độ
Một trong những dấu ấn lớn nhất của Julia là tốc độ. Như đã đề cập, Julia là ngôn ngữ biên dịch, mang lại cải thiện đáng kể về tốc độ so với các ngôn ngữ thông dịch.
Julia thuộc "câu lạc bộ petaflop" cùng với C, C++ và Fortran. Đúng vậy; câu lạc bộ độc quyền này chỉ có bốn thành viên và điều kiện gia nhập duy nhất: đạt tốc độ một petaflop (tức là một nghìn nghìn tỷ phép toán) mỗi giây ở hiệu năng đỉnh.
Gặp dữ liệu lớn trong machine learning là chuyện thường, nên dùng ngôn ngữ nhanh có thể cải thiện đáng kể thời gian huấn luyện và giảm chi phí khi triển khai mô hình vào sản xuất.
3. Mã không vector hóa vẫn nhanh
Trong Julia, không cần vector hóa mã để tăng hiệu năng. Viết mã không vector hóa dưới dạng vòng lặp và hàm nội tại vốn đã nhanh. Dù vector hóa có thể mang lại chút cải thiện tốc độ trong Julia, nhưng không bắt buộc.
Việc viết và dùng mã không vector hóa giúp bạn tiết kiệm nhiều thời gian khi xây dựng mô hình machine learning vì không phải tái cấu trúc mã chỉ để tăng tốc.
4. Tái sử dụng mã & Multiple Dispatch
Julia dùng duck-typing để "đoán" kiểu phù hợp cho một hàm. Nghĩa là: nếu nó đi như vịt, kêu như vịt, thì có lẽ là vịt. Vì vậy, bất kỳ đối tượng nào đáp ứng đặc tả ngầm của hàm đều được hỗ trợ - không cần chỉ định tường minh.
Tuy nhiên, duck-typing không phải lúc nào cũng phù hợp cho các trường hợp đặc biệt, và đó là lúc multiple dispatch phát huy tác dụng. Với multiple dispatch, bạn có thể định nghĩa nhiều trường hợp đặc biệt cho một hàm, và tùy điều kiện thỏa mãn, hàm sẽ chọn phương án thích hợp nhất khi chạy.
Multiple dispatch hữu ích trong machine learning vì bạn không phải nghĩ đến mọi kiểu có thể được phép truyền vào hàm. Thay vào đó, các gói trong Julia vừa giữ được tính linh hoạt cao, vừa có thể chia sẻ mã và kiểu dữ liệu giữa các gói khác nhau.
Xem xét định dạng ngày tháng: có nhiều gói dùng định dạng ngày và ngày/giờ tùy biến. Chẳng hạn, Python có định dạng datetime tích hợp sẵn và định dạng datetime64[ns] của Pandas. Trong Julia, chỉ có một định dạng dựa trên ngày dùng chung cho tất cả gói từ module dates tích hợp.
5. Quản lý gói tích hợp sẵn
Các gói được quản lý tự động trong Julia với Pkg. Pkg đối với Julia như Pip đối với Python, nhưng tốt hơn. Môi trường trong Julia được quản lý qua hai tệp: Project.toml và Manifest.toml. Các tệp này cho Julia biết những gói nào được dùng trong dự án và phiên bản của chúng. Thay vì định nghĩa môi trường đặc biệt ở bên ngoài, vị trí thư mục chứa các tệp Julia (có Project và Manifest) chính là môi trường.
Cách quản lý gói tích hợp, đơn giản này giúp dễ dàng chia sẻ và tái lập các dự án và phân tích machine learning của bạn.
6. Bài toán hai ngôn ngữ
Bạn có biết chỉ 20–30% các gói Python thực sự được viết bằng Python?
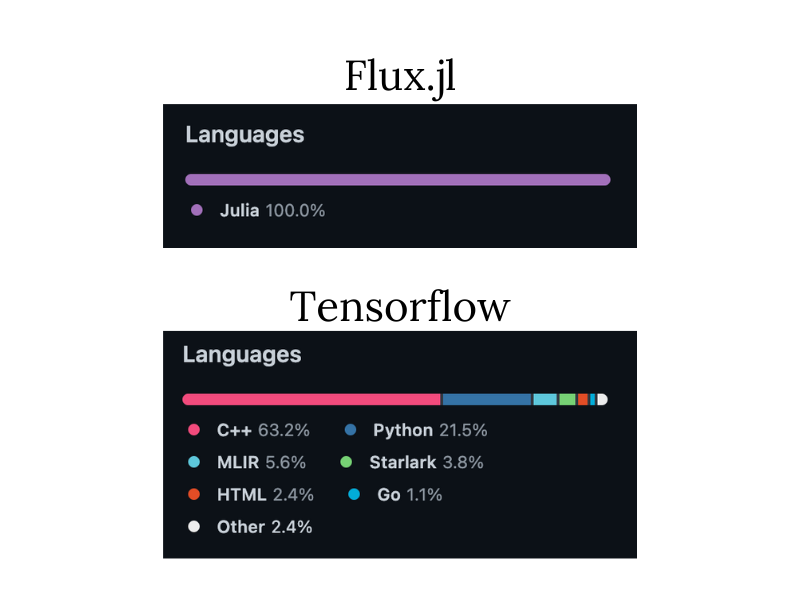
Sự phụ thuộc vào các ngôn ngữ khác là vì để phát triển các gói hiệu quả, chúng phải được xây dựng bằng ngôn ngữ cấp thấp như C và C++.
Trong tính toán khoa học, phát triển giải pháp và gói thường liên quan đến hai ngôn ngữ: ngôn ngữ dễ dùng để tạo bản mẫu (như Python) nhằm triển khai nhanh giải pháp ban đầu, rồi ngôn ngữ nhanh (như C++) để viết lại toàn bộ mã cho phiên bản cuối cùng.
Như bạn có thể hình dung, đây là quy trình chậm và kém hiệu quả, không chỉ ở giai đoạn phát triển ban đầu mà cả bảo trì dài hạn và bổ sung tính năng mới.
Ngược lại, các gói trong Julia có thể được tạo mẫu, phát triển và bảo trì ngay bằng Julia. Kết quả là rút ngắn đáng kể toàn bộ vòng đời phát triển.
Các gói Julia cho Machine Learning
Hiện Julia có hơn 7.400 gói trong registry chung. Dù con số này còn xa so với số lượng gói khổng lồ của Python (hơn 200.000), việc tìm đúng gói để giải quyết một vấn đề cụ thể vẫn có thể là thách thức.
Phần này sẽ khám phá các gói chính bạn cần để phân tích dữ liệu và xây dựng mô hình machine learning.
Tuy nhiên, nếu bạn mới bắt đầu với machine learning trong Julia, hãy thử bộ công cụ gói trước: MLJ. Gói này được xây dựng nhằm tập hợp các gói machine learning phổ biến nhất vào một nơi dễ truy cập, giúp bạn tiết kiệm thời gian tìm gói phù hợp cho dự án. Hiện MLJ hỗ trợ hơn 20 gói machine learning khác nhau.
Dưới đây là danh sách một số gói thường gặp trong các dự án machine learning - từ nhập, làm sạch, trực quan hóa dữ liệu cho đến xây dựng mô hình:
- Notebook: Pluto, IJulia, Jupyter
- Quản lý gói/môi trường: Pkg
- Nhập và xử lý dữ liệu: CSV, DataFrames
- Vẽ biểu đồ và xuất kết quả: Plots, StatsPlots, LaTeXStrings, Measures, Makie
- Thống kê và Toán học: Random, Statistics, LinearAlgebra, StatsBase, Distributions, HypothesisTests, KernelDensity, Lasso, Combinatorics, SpecialFunctions, Roots
- Các gói machine learning riêng lẻ:
- Mô hình tuyến tính tổng quát (ví dụ: hồi quy tuyến tính, hồi quy logistic): GLM
- Học sâu: Flux, Knet
- Máy vector hỗ trợ: LIBSVM
- Cây quyết định, rừng ngẫu nhiên, AdaBoost: DecisionTree
- K-láng giềng gần nhất: NearestNeighbors
- Phân cụm K-means: Clustering
- Phân tích thành phần chính: MultivariateStats
Cũng có nhiều bản triển khai và wrapper cho các gói Python phổ biến như Scikit-Learn và Tensorflow. Tuy nhiên, bạn không nhất thiết phải dùng các gói này, vì có thể đánh mất nhiều lợi thế mạnh mẽ của Julia (như tốc độ và multiple dispatch).
Bắt đầu với Julia cho Machine Learning
Một trong những cách tốt nhất để bắt đầu với Julia là dùng môi trường notebook Pluto. Phần này sẽ bàn về lợi ích của việc dùng Pluto, đặc biệt ở giai đoạn đầu hành trình khoa học dữ liệu khi bạn còn đang học cách xây dựng dự án machine learning với Julia. Chúng tôi cũng đề cập đến một số tài nguyên tốt nhất để tìm hiểu thêm về Julia và machine learning.
Pluto
Pluto là môi trường Notebook tương tác, dễ dùng với giao diện thân thiện. Sự đơn giản này khiến Pluto rất phù hợp cho người mới bắt đầu với Julia. Pluto cũng có nhiều tính năng bổ sung cho phép bạn xây dựng các giải pháp machine learning hấp dẫn gần như không tốn công:
Tính phản ứng
Khi đánh giá một ô, Pluto cũng sẽ xét xem những ô nào khác cần chạy. Tính năng này đảm bảo các ô phụ thuộc được cập nhật trước khi ô hiện tại được đánh giá.
Một điểm hay của Pluto là đủ thông minh để biết chính xác những ô nào cần chạy thêm ngoài ô hiện tại, nhờ đó bạn không gặp tình trạng phải cập nhật mọi ô khi thay đổi một chỗ trong notebook.
Pluto cũng dọn dẹp mã cũ hoặc đã xóa và cập nhật đầu ra của mọi ô phụ thuộc để phản ánh thao tác này. Nếu bạn định nghĩa một biến trong một ô rồi sau đó xóa ô đó, Pluto cũng sẽ xóa biến khỏi không gian tên. Ngoài ra, mọi ô mã phụ thuộc sẽ hiển thị thông báo lỗi cho biết biến cần dùng đã bị xóa.
Tính tương tác
Tính phản ứng tạo nên sự tương tác tự động giữa các ô. Điều này đặc biệt hữu ích để nhanh chóng tạo các biểu đồ hoặc đối tượng tương tác được cập nhật tự động khi một biến thay đổi.
Điều thú vị ở Pluto là biến đó có thể là một widget tương tác trong notebook, như thanh trượt hoặc ô nhập văn bản tích hợp sẵn. Nếu biết Javascript, bạn còn có thể tự thiết kế widget.
Tính phản ứng và tương tác cho phép bạn tạo báo cáo và bảng điều khiển động dựa trên mô hình machine learning và phân tích dữ liệu. Chìa khóa của một dự án machine learning thành công là khả năng truyền đạt, và Pluto giúp việc trình bày, giải thích dự án dễ dàng hơn nhiều.
Quản lý gói tự động
Pluto tích hợp mượt mà với Pkg để cho phép quản lý gói tự động ngay trong notebook. Không chỉ vậy, bạn thậm chí không cần cài gói bên ngoài Pluto. Mọi thông tin Pluto (và Julia) cần để chạy và tái lập notebook đều được lưu ngay trong chính notebook!
Điều này có nghĩa bạn có thể chia sẻ notebook với đồng nghiệp hoặc bạn học, và có thể yên tâm rằng tất cả gói cần thiết để notebook đó chạy sẽ đi kèm.
Kiểm soát phiên bản
Tất cả notebook Pluto được lưu dưới dạng tệp .jl có thể thực thi. Nếu mở notebook trong trình soạn thảo văn bản, nó sẽ trông hơi khác so với notebook trên trình duyệt. Tệp sẽ chứa mọi thông tin mà notebook cần, như mã, các phụ thuộc giữa ô, và thứ tự thực thi. Tuy nhiên, các tệp này không chứa đầu ra. Tất cả điều này giúp kiểm soát phiên bản bằng Git và GitHub dễ dàng hơn.
Xuất & Chia sẻ
Notebook Pluto có thể xuất thành tệp .jl thực thi, PDF tĩnh hoặc tệp HTML tĩnh. Nếu xuất HTML, người nhận còn có tùy chọn tải về và chỉnh sửa tệp notebook thô mà không cần cài Julia trên máy họ.
Pluto làm được điều này nhờ hợp tác với Binder - nền tảng miễn phí lưu trữ notebook Pluto trực tuyến (cũng hoạt động với các ngôn ngữ khác như Python và R).
Tính năng này là bước cuối cùng trong quy trình machine learning: đầu tiên bạn thực hiện phân tích, sau đó xây dựng báo cáo tương tác trong notebook để trình bày kết quả, và cuối cùng bạn có thể chia sẻ notebook với đồng nghiệp kỹ thuật (có thể tái lập và chỉnh sửa phân tích) cũng như với những người không chuyên kỹ thuật.
Tài nguyên học Julia
Dưới đây là một số tài nguyên được khuyến nghị cao để học về ngôn ngữ Julia và cách dùng nó trong khoa học dữ liệu và machine learning:


 Matt Crabtree · 10 min
Julia là gì?
Julia là một ngôn ngữ lập trình tương đối mới, lần đầu phát hành vào năm 2012. Dù mới chỉ xuất hiện khoảng mười năm, Julia đã phát triển nhanh chóng và hiện nằm trong top 30 ngôn ngữ lập trình theo chỉ số TIOBE tháng 10/2022.
Một điểm nổi bật của Julia là được xây dựng cho tính toán khoa học. Điều này có nghĩa Julia vừa dễ dùng, vừa nhanh, đồng thời có khả năng xử lý lượng dữ liệu lớn và các phép tính phức tạp với tốc độ vượt trội. Khẩu hiệu nổi tiếng của Julia là "chạy như C nhưng đọc như Python."
Julia là ngôn ngữ biên dịch nhưng có cú pháp dễ đọc như ngôn ngữ thông dịch. Hầu hết các ngôn ngữ biên dịch truyền thống khác (như C hoặc C++) có thể giải quyết các bài toán tính toán nặng đều phải được biên dịch sang định dạng máy có thể đọc trước khi thực thi.
Ngược lại, Julia đạt được hiệu năng tương đương với sự đơn giản của ngôn ngữ thông dịch (như Python) mà không cần biên dịch trước khi chạy. Thay vào đó, Julia sử dụng bộ biên dịch Just-In-Time (JIT) để biên dịch khi chạy.
Tại sao chọn Julia cho Machine Learning?
Python đã thống trị lĩnh vực khoa học dữ liệu và machine learning trong thời gian dài, và có lý do chính đáng: đó là một ngôn ngữ cực kỳ mạnh mẽ và linh hoạt. Tuy nhiên, một số hạn chế của Python lại không phải là vấn đề trong Julia.
Một vài điểm hạn chế của Python so với Julia gồm:
Trong phần này, chúng ta sẽ điểm qua một số lý do khiến Julia là lựa chọn tuyệt vời cho machine learning.
Bạn có thể tìm hiểu thêm về sự trỗi dậy của ngôn ngữ này và liệu có nên học Julia vào năm 2022 trong một bài viết riêng.
1. Đơn giản & Dễ sử dụng
Julia có cú pháp rất thân thiện, gần với tiếng Anh. Điều này giúp việc học và làm quen nhanh hơn vì mã thường直 quan và dễ hiểu.
Julia cũng cài đặt nhanh chóng, dễ dàng để bắt đầu ngay. Không cần cài các bản phân phối đặc biệt (như Python với Anaconda) hay theo quy trình cài đặt rườm rà (như C và C++).
Với người làm machine learning, loại bỏ càng sớm ma sát trong khâu lập trình, bạn càng nhanh bắt tay vào việc mình làm tốt nhất: phân tích dữ liệu và xây dựng mô hình.
2. Tốc độ
Một trong những dấu ấn lớn nhất của Julia là tốc độ. Như đã đề cập, Julia là ngôn ngữ biên dịch, mang lại cải thiện đáng kể về tốc độ so với các ngôn ngữ thông dịch.
Julia thuộc "câu lạc bộ petaflop" cùng với C, C++ và Fortran. Đúng vậy; câu lạc bộ độc quyền này chỉ có bốn thành viên và điều kiện gia nhập duy nhất: đạt tốc độ một petaflop (tức là một nghìn nghìn tỷ phép toán) mỗi giây ở hiệu năng đỉnh.
Gặp dữ liệu lớn trong machine learning là chuyện thường, nên dùng ngôn ngữ nhanh có thể cải thiện đáng kể thời gian huấn luyện và giảm chi phí khi triển khai mô hình vào sản xuất.
3. Mã không vector hóa vẫn nhanh
Trong Julia, không cần vector hóa mã để tăng hiệu năng. Viết mã không vector hóa dưới dạng vòng lặp và hàm nội tại vốn đã nhanh. Dù vector hóa có thể mang lại chút cải thiện tốc độ trong Julia, nhưng không bắt buộc.
Việc viết và dùng mã không vector hóa giúp bạn tiết kiệm nhiều thời gian khi xây dựng mô hình machine learning vì không phải tái cấu trúc mã chỉ để tăng tốc.
4. Tái sử dụng mã & Multiple Dispatch
Julia dùng duck-typing để "đoán" kiểu phù hợp cho một hàm. Nghĩa là: nếu nó đi như vịt, kêu như vịt, thì có lẽ là vịt. Vì vậy, bất kỳ đối tượng nào đáp ứng đặc tả ngầm của hàm đều được hỗ trợ - không cần chỉ định tường minh.
Tuy nhiên, duck-typing không phải lúc nào cũng phù hợp cho các trường hợp đặc biệt, và đó là lúc multiple dispatch phát huy tác dụng. Với multiple dispatch, bạn có thể định nghĩa nhiều trường hợp đặc biệt cho một hàm, và tùy điều kiện thỏa mãn, hàm sẽ chọn phương án thích hợp nhất khi chạy.
Multiple dispatch hữu ích trong machine learning vì bạn không phải nghĩ đến mọi kiểu có thể được phép truyền vào hàm. Thay vào đó, các gói trong Julia vừa giữ được tính linh hoạt cao, vừa có thể chia sẻ mã và kiểu dữ liệu giữa các gói khác nhau.
Xem xét định dạng ngày tháng: có nhiều gói dùng định dạng ngày và ngày/giờ tùy biến. Chẳng hạn, Python có định dạng datetime tích hợp sẵn và định dạng datetime64[ns] của Pandas. Trong Julia, chỉ có một định dạng dựa trên ngày dùng chung cho tất cả gói từ module dates tích hợp.
5. Quản lý gói tích hợp sẵn
Các gói được quản lý tự động trong Julia với Pkg. Pkg đối với Julia như Pip đối với Python, nhưng tốt hơn. Môi trường trong Julia được quản lý qua hai tệp: Project.toml và Manifest.toml. Các tệp này cho Julia biết những gói nào được dùng trong dự án và phiên bản của chúng. Thay vì định nghĩa môi trường đặc biệt ở bên ngoài, vị trí thư mục chứa các tệp Julia (có Project và Manifest) chính là môi trường.
Cách quản lý gói tích hợp, đơn giản này giúp dễ dàng chia sẻ và tái lập các dự án và phân tích machine learning của bạn.
6. Bài toán hai ngôn ngữ
Bạn có biết chỉ 20–30% các gói Python thực sự được viết bằng Python?
Sự phụ thuộc vào các ngôn ngữ khác là vì để phát triển các gói hiệu quả, chúng phải được xây dựng bằng ngôn ngữ cấp thấp như C và C++.
Trong tính toán khoa học, phát triển giải pháp và gói thường liên quan đến hai ngôn ngữ: ngôn ngữ dễ dùng để tạo bản mẫu (như Python) nhằm triển khai nhanh giải pháp ban đầu, rồi ngôn ngữ nhanh (như C++) để viết lại toàn bộ mã cho phiên bản cuối cùng.
Như bạn có thể hình dung, đây là quy trình chậm và kém hiệu quả, không chỉ ở giai đoạn phát triển ban đầu mà cả bảo trì dài hạn và bổ sung tính năng mới.
Ngược lại, các gói trong Julia có thể được tạo mẫu, phát triển và bảo trì ngay bằng Julia. Kết quả là rút ngắn đáng kể toàn bộ vòng đời phát triển.
Các gói Julia cho Machine Learning
Hiện Julia có hơn 7.400 gói trong registry chung. Dù con số này còn xa so với số lượng gói khổng lồ của Python (hơn 200.000), việc tìm đúng gói để giải quyết một vấn đề cụ thể vẫn có thể là thách thức.
Phần này sẽ khám phá các gói chính bạn cần để phân tích dữ liệu và xây dựng mô hình machine learning.
Tuy nhiên, nếu bạn mới bắt đầu với machine learning trong Julia, hãy thử bộ công cụ gói trước: MLJ. Gói này được xây dựng nhằm tập hợp các gói machine learning phổ biến nhất vào một nơi dễ truy cập, giúp bạn tiết kiệm thời gian tìm gói phù hợp cho dự án. Hiện MLJ hỗ trợ hơn 20 gói machine learning khác nhau.
Dưới đây là danh sách một số gói thường gặp trong các dự án machine learning - từ nhập, làm sạch, trực quan hóa dữ liệu cho đến xây dựng mô hình:
Cũng có nhiều bản triển khai và wrapper cho các gói Python phổ biến như Scikit-Learn và Tensorflow. Tuy nhiên, bạn không nhất thiết phải dùng các gói này, vì có thể đánh mất nhiều lợi thế mạnh mẽ của Julia (như tốc độ và multiple dispatch).
Bắt đầu với Julia cho Machine Learning
Một trong những cách tốt nhất để bắt đầu với Julia là dùng môi trường notebook Pluto. Phần này sẽ bàn về lợi ích của việc dùng Pluto, đặc biệt ở giai đoạn đầu hành trình khoa học dữ liệu khi bạn còn đang học cách xây dựng dự án machine learning với Julia. Chúng tôi cũng đề cập đến một số tài nguyên tốt nhất để tìm hiểu thêm về Julia và machine learning.
Pluto
Pluto là môi trường Notebook tương tác, dễ dùng với giao diện thân thiện. Sự đơn giản này khiến Pluto rất phù hợp cho người mới bắt đầu với Julia. Pluto cũng có nhiều tính năng bổ sung cho phép bạn xây dựng các giải pháp machine learning hấp dẫn gần như không tốn công:
Tính phản ứng
Khi đánh giá một ô, Pluto cũng sẽ xét xem những ô nào khác cần chạy. Tính năng này đảm bảo các ô phụ thuộc được cập nhật trước khi ô hiện tại được đánh giá.
Một điểm hay của Pluto là đủ thông minh để biết chính xác những ô nào cần chạy thêm ngoài ô hiện tại, nhờ đó bạn không gặp tình trạng phải cập nhật mọi ô khi thay đổi một chỗ trong notebook.
Pluto cũng dọn dẹp mã cũ hoặc đã xóa và cập nhật đầu ra của mọi ô phụ thuộc để phản ánh thao tác này. Nếu bạn định nghĩa một biến trong một ô rồi sau đó xóa ô đó, Pluto cũng sẽ xóa biến khỏi không gian tên. Ngoài ra, mọi ô mã phụ thuộc sẽ hiển thị thông báo lỗi cho biết biến cần dùng đã bị xóa.
Tính tương tác
Tính phản ứng tạo nên sự tương tác tự động giữa các ô. Điều này đặc biệt hữu ích để nhanh chóng tạo các biểu đồ hoặc đối tượng tương tác được cập nhật tự động khi một biến thay đổi.
Điều thú vị ở Pluto là biến đó có thể là một widget tương tác trong notebook, như thanh trượt hoặc ô nhập văn bản tích hợp sẵn. Nếu biết Javascript, bạn còn có thể tự thiết kế widget.
Tính phản ứng và tương tác cho phép bạn tạo báo cáo và bảng điều khiển động dựa trên mô hình machine learning và phân tích dữ liệu. Chìa khóa của một dự án machine learning thành công là khả năng truyền đạt, và Pluto giúp việc trình bày, giải thích dự án dễ dàng hơn nhiều.
Quản lý gói tự động
Pluto tích hợp mượt mà với Pkg để cho phép quản lý gói tự động ngay trong notebook. Không chỉ vậy, bạn thậm chí không cần cài gói bên ngoài Pluto. Mọi thông tin Pluto (và Julia) cần để chạy và tái lập notebook đều được lưu ngay trong chính notebook!
Điều này có nghĩa bạn có thể chia sẻ notebook với đồng nghiệp hoặc bạn học, và có thể yên tâm rằng tất cả gói cần thiết để notebook đó chạy sẽ đi kèm.
Kiểm soát phiên bản
Tất cả notebook Pluto được lưu dưới dạng tệp .jl có thể thực thi. Nếu mở notebook trong trình soạn thảo văn bản, nó sẽ trông hơi khác so với notebook trên trình duyệt. Tệp sẽ chứa mọi thông tin mà notebook cần, như mã, các phụ thuộc giữa ô, và thứ tự thực thi. Tuy nhiên, các tệp này không chứa đầu ra. Tất cả điều này giúp kiểm soát phiên bản bằng Git và GitHub dễ dàng hơn.
Xuất & Chia sẻ
Notebook Pluto có thể xuất thành tệp .jl thực thi, PDF tĩnh hoặc tệp HTML tĩnh. Nếu xuất HTML, người nhận còn có tùy chọn tải về và chỉnh sửa tệp notebook thô mà không cần cài Julia trên máy họ.
Pluto làm được điều này nhờ hợp tác với Binder - nền tảng miễn phí lưu trữ notebook Pluto trực tuyến (cũng hoạt động với các ngôn ngữ khác như Python và R).
Tính năng này là bước cuối cùng trong quy trình machine learning: đầu tiên bạn thực hiện phân tích, sau đó xây dựng báo cáo tương tác trong notebook để trình bày kết quả, và cuối cùng bạn có thể chia sẻ notebook với đồng nghiệp kỹ thuật (có thể tái lập và chỉnh sửa phân tích) cũng như với những người không chuyên kỹ thuật.
Tài nguyên học Julia
Dưới đây là một số tài nguyên được khuyến nghị cao để học về ngôn ngữ Julia và cách dùng nó trong khoa học dữ liệu và machine learning: