
Google AI 和 OpenAI 均以发布前沿 AI 技术著称。但随着ChatGPT 的推出,格局已经改变,引发了新一轮竞赛,大型科技公司如 Google 纷纷加速上线类似的 AI 模型。
在本文中,我们将了解 OpenAI 与 Google AI 的最新进展,以及未来的可能走向。此外,我们还将探讨 AI 的发展如何改变数据科学领域,以及我们如何借助它提升生产力。
OpenAI
OpenAI API 是一个平台,允许我们通过 API 访问最前沿的生成式模型。我们可以使用 DALLE-2 生成高质量图像,使用 GPT-3 进行文本与代码生成,并使用嵌入来处理其他语言相关任务。此外,它还支持结果审核、速率限制,以及在特定数据集上对模型进行微调。可通过我们的《GPT-3 入门指南》了解更多 GPT-3 相关内容。
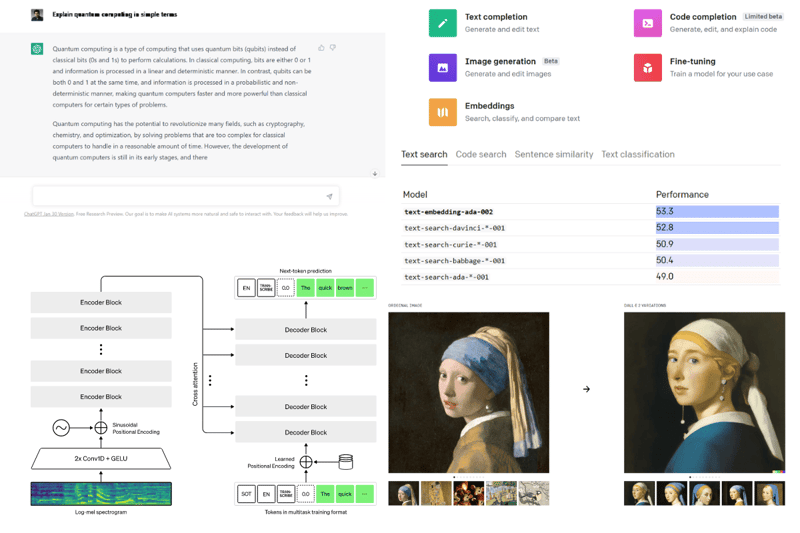
图片作者自制 | 来源 OpenAI
以上均为商业化产品,遵循按量付费模式,但 OpenAI 也会不时发布开源工具与模型,例如:
- Whisper:使用大规模弱监督的语音识别模型。
- OpenAI Baselines:强化学习算法的实现。
- Gym:用于开发与评估强化学习算法的工具包。
- GPT2:论文“Language Models are Unsupervised Multitask Learners”的代码与模型实现。
- DALL-E:用于 DALL·E 的离散 VAE 的 PyTorch 包。
这些 API、工具包与大型语言模型都很出色,但仍难以与ChatGPT 的成功相提并论。
ChatGPT 模型使用“基于人类反馈的强化学习”(RLHF)进行训练,类似于 InstructGPT(GPT-3 的更佳版本),但数据收集阶段略有不同。
它与前几代模型有何不同?该对话式 AI 能够追问、质疑错误前提、承认失误,并展现安全防护措施。
近日,OpenAI 的合作伙伴微软发布了改进版 ChatGPT。随着 OpenAI 的迭代式部署,我们看到了新一波能够理解我们需求并提供辅助的 AI 技术。
如果您完全是人工智能初学者,可参加零代码的 AI Fundamentals 课程。课程涵盖监督与无监督学习、深度学习等机器学习基础内容。
GPT-4
除 ChatGPT 外,大家也在期待 GPT-4——将成为最先进的大型语言模型。在 Greylock 播客中,OpenAI 首席执行官 Sam Altman 披露了少量 GPT-4 信息。他表示,Twitter 上关于 GPT-4 的传闻不实:它不会有 100 万亿参数,人们应当降低预期。他还表示:“我们会在认为它安全且可用时再发布 GPT-4”。
图片作者自制
我们可以对 GPT-4 有哪些期待?
- 模型规模不会比 GPT-3 大太多。
- 使用新的参数化(μP)来优化大型模型。
- 通过增加训练 token 数以达到最小损失,采用最优算力进行训练。
- 它将是纯文本模型。GPT-4 不会像 DALL-E 2 那样是多模态的。
- 可能利用稀疏性来降低计算成本。
- 与 ChatGPT 一样,它将在遵循人类意图与价值方面具备更强的对齐性。
通过阅读我们的《关于 GPT-4 的一切(迄今所知)》了解 GPT-1、GPT-2、GPT-3 与 GPT-4 的全部内容。
打造安全的通用人工智能(AGI)
在接受 StrictlyVC 采访时,Altman 谈到了我们距离 AGI(通用人工智能)的发展程度。
他说:“我们越接近,它就越难回答。因为我认为这将比人们想象的更模糊,也将是一个更渐进的过渡。”
他也澄清了有关 AGI 的传闻。在采访中他表示,OpenAI 并没有像人类一样学习的 AGI。
图片作者自制
OpenAI 正在正确的道路上开发安全的 AGI,但仍远非完美。人们谈论的 AGI 是一种能够理解语音、文本、图像和视频的多模态模型。它将是 ChatGPT、DALLE-2、Whisper、视频生成模型以及其他强化学习算法的组合。
多模态模型
要开发 AGI,OpenAI 需要在多模态模型上发力,不仅是文生图,还包括文生视频、音频转视频与音频。这意味着您将能够与一个声音自然、外观逼真的机器人对话。少数开发者已实现了雏形,比如AI 生成的 Twitch 主播人格。虽不完美,但已是一个开端。
在 StrictlyVC 节目中,Sam Altman 透露他们正在研发视频模型,我们可以合理推测它将是带有音频模型的文生视频,为其再添复杂一层。当前已有视频生成技术,开发者通过叠加由 Stable Diffusion 模型生成的帧来实现。
Google AI
Google AI 是谷歌生态系统的中枢,广泛用于 Google 地图、相册、应用和云服务。Google 一直站在 AI 工具与模型研发前沿。从 AutoML 到最先进的大型视觉与语言模型,多数产品都可在 Google Cloud 上获取。
它还发布了多种工具与最先进模型,改变了自然语言处理、语音处理与计算机视觉的格局。从 TensorFlow 到 BERT(Bidirectional Encoder Representations from Transformers),Google 为 AI 与机器学习的研究与开发开辟了新路径。
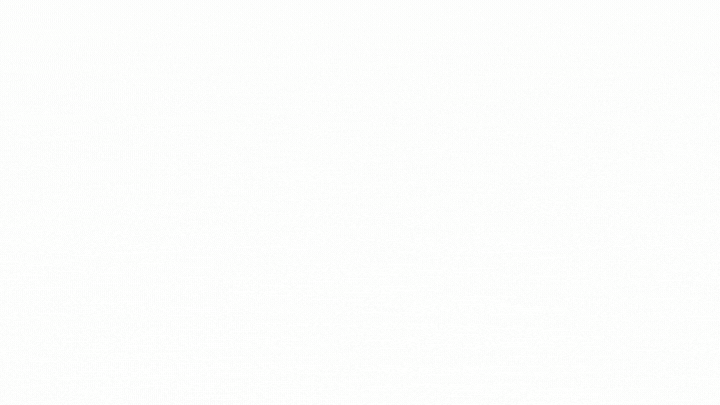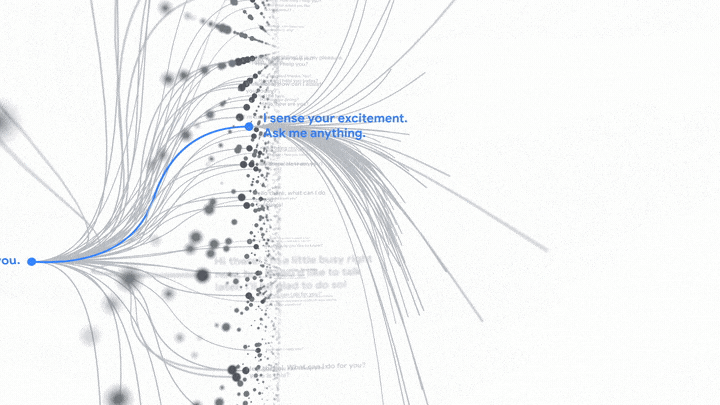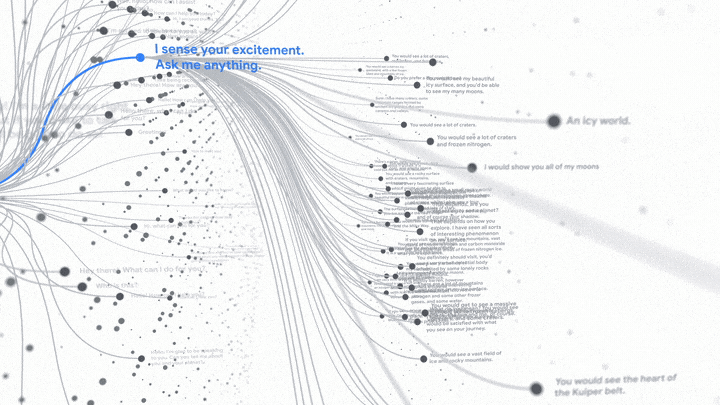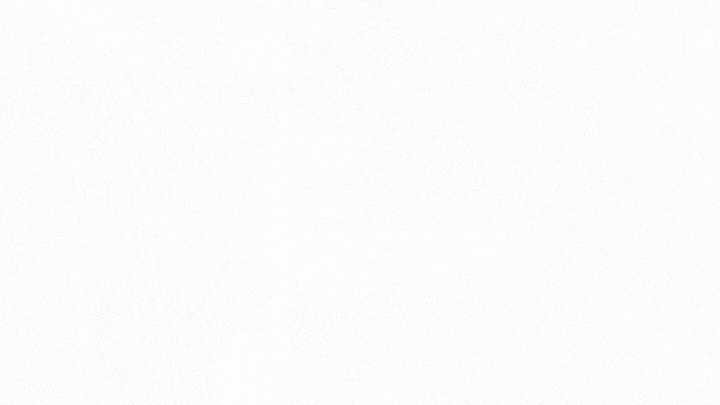
动图来自 LaMDA
2020 年,Google Research 推出 Meena,一种能理解上下文并学习作出合理回应的神经对话模型。此后,Google 发布了与 ChatGPT 类似的 LaMDA 模型。这是基于 transformer、并在对话上训练的突破性对话技术。
每年我们都会见到 Google 的新技术。未来,有望看到由 AI Bard、语言、视觉、生成式与多模态模型驱动的更先进的谷歌搜索引擎,使 AI 更加多用途。
Google AI Bard
ChatGPT 发布后,关于其是“Google 杀手”的传闻甚嚣尘上。微软与 OpenAI 的扩展合作让这种说法更具可能。微软已准备好凭借融入 OpenAI 的必应进军搜索业务,向 Google 发起挑战。
为此,Google 推出了自家的 ChatGPT 版本——Google AI Bard。欢迎在另一篇文章中查看我们对ChatGPT 与 Google Bard 的对比。

动图来自 Bard 与新 AI 功能
在近期的Google AI 更新中,Google 与 Alphabet 的首席执行官 Sundar Pichai 介绍了一项新的实验性对话式 AI 服务 Bard,由 LaMDA 提供支持。Google 宣布已向受信任的测试者开放,未来数周将向公众提供。
Bard 使用来自网络的信息提供高质量回答。与 ChatGPT 模型不同,Bard 是一种服务,将世界知识与能力、智能和创造力相结合。最初,Google 会以轻量版 LaMDA 上线,随后逐步引入更强大的语言模型。
语言、视觉与生成式模型
根据Google Research 近期报告,他们在语言技术、计算机视觉与生成式模型方面均有所突破。
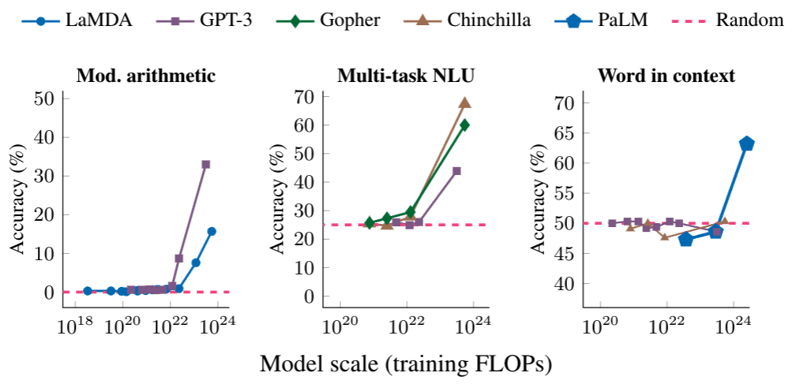
图片来自 Google AI
- 大型语言模型:Pathways Language Model(PaLM)与 LaMDA 展现出良好成果。未来可期待更强的语言模型,用于对话式 AI 及其他自然语言处理任务。
- 计算机视觉:MaxViT(多轴视觉 Transformer)、Pix2Seq(用于目标检测的语言建模框架),以及使用大运动帧插值的 2D 到 3D 成像研究进展。
- 图像生成:先进的拟真图像生成模型:Imagen(扩散模型)与 Parti(自回归 transformer 架构)。二者均以文本输入生成图像像素。
- 视频生成:去年,Google AI 研究了 Imagen Video 与 Phenaki。Imagen Video 使用级联扩散模型生成高分辨率视频,而 Phenaki 基于开放域文本描述生成可变长度视频。
通过参加我们的 Python 深度学习技能路径,开启您的深度学习(AI)职业生涯。该技能路径包含四门课程,助您将机器学习能力提升到新水平。
多模态模型
大多数机器学习模型只关注单一模态数据(文本分类、图像分割或语音识别)。但随着 DALL-E 2 与 Stable Diffusion 的出现,各家公司正转向多模态模型以实现最先进的效果。
Google AI 通过将数据输入模态特定的处理层,并在瓶颈层混合不同模态的特征,实现了多模态能力。结合多种模态还能提升单一模态任务的性能。

动图来自 Google AI
以下是 Google AI 在多模态模型上的一些最新研究进展:
- Locked-image Tuning(LiT)为现有的预训练图像模型加入语言理解能力。
- PaLI 能在 100 多种语言中执行多项任务,如视觉问答、图像描述、目标检测并翻译至其他语言、图像分类等。
- VDTTS:视觉驱动的文转语模型,接收文本与演员原始视频帧,生成与原视频在时序与情感上匹配的语音输出。
- Look and Talk 是一种多模态技术,利用视频与音频作为输入,使与 Google 助理的对话更自然。模型学习多种视觉与音频线索,更准确地判断人是否在与 Google 助理对话。
- 4D-Net 结合来自自动驾驶车辆的三维点云数据,并与其他传感数据融合,以更好地理解环境与物体,做出更优决策。
可以预见,未来这些模型将被纳入 Google 生态系统,以提升用户参与度并催生新产品。
AI 与数据科学
现代 AI 由数据科学、算法与数据工程驱动。要打造如 ChatGPT 和 LaMDA 这样的前沿技术,我们必须从基础做起:理解如何处理数据并应用各类自然语言处理与强化学习技术,学习深度学习算法、transformer 与模型优化。
通过完成 Python 数据科学家职业路径,开启您的数据科学之旅。它将教授成为专业数据科学家所需的关键技能。
图片作者自制
那么,直面大家最关心的问题:AI 会取代数据科学家、分析师或工程师吗?简单答案是“不会”。也许遥远的将来会发生变化,但即便如此,我们也会有不同的工作,更具创造性与决策性的工作。随着 AI 的发展,我们也会共同成长。
GitHub Copilot、DALL-E 2、ChatGPT 等前沿技术的宗旨是为我们提供助力,让我们更高效、更有生产力。
Andrej Karpathy(曾任特斯拉与 OpenAI 的 AI 负责人)表示:
“Copilot 大幅加速了我的编码,很难想象回到‘手动编码’。我仍在学习如何使用它,但它已经写出了我约 80% 的代码,准确率约 80%。我几乎不再真正写代码了,而是在提示与编辑。” - Twitter
这表明,许多懂技术的人都会用它来提升编程、逻辑、数据分析与决策能力。
数据科学家如何使用 AI?
- 在保护用户隐私的前提下生成真实世界数据。
- 编写优雅高效的代码。
- 进行产品原型设计。
- 通过提示实现更出色的数据分析。
- 使用自然语言生成复杂 SQL 查询。
- 为非技术相关方撰写更好的报告。
- 进行复杂的统计分析并给出解释。
- 学习新的编程语言、技能、框架与概念。
- 使用 AI 驱动的 AutoML 与模型优化工具,构建最先进的机器学习解决方案。
- 构建自动化脚本,节省时间并避免错误。
AI 进步的新时代
微软与 OpenAI 合作,将 ChatGPT 集成到新版必应搜索引擎,称其为“网页副驾”。随着这一宣布,争夺技术领先的新赛程已经开启。
微软计划将 ChatGPT 与其他 GPT 模型整合进其生态系统。这将改变一切——用户甚至无需离开应用,只需与机器人对话,就能完成搜索、添加内容、编辑内容并生成想法。

必应 Copilot 演示
在巴黎活动上,Google 推出了其 ChatGPT 版本——Bard,由轻量级 LaMDA 提供支持。Bard 与微软的网页副驾颇为相似,也集成在 Google 的搜索引擎中,提供类似功能。
AI 进步的负面影响
- 像 GPT 这样的大型语言模型未来可能被用于虚假信息运动——openai.com。其具有造成身心伤害的潜在风险。
- AI 生成内容往往经过 SEO 优化,且更难检测。学生与职场人士可能用其生成“原创”作品,却未真正学习或理解概念。阅读 OpenAI API 文档了解更多与教育相关的风险与机遇。
- 版权问题切实存在。这些模型训练于在线文本,其中部分受版权保护。不能以 AI 发展为由,挪用他人作品。
- AI 有时会给出事实错误的答案。若未来这些模型被用于执法等部门,可能引发巨大问题。
这些问题终将得到解决,我们也将看到规范 AI 使用的新法规落地。学校与内容平台已开始实施针对 AI 生成内容的政策。
那么,我们能做什么?我们可以开始学习这些新技术,并以合乎伦理的方式使用它们。您可以通过报名我们的 AI 学习内容,或加入 Machine Learning Scientist with Python 职业路径来开始。该路径将教授获得 AI 工程师岗位所需的核心机器学习技能。