数据分析往往高度依赖不可或缺的 pandas 库。它提供易用的数据结构和数据处理函数,能够高效处理表格型数据集。借助 pandas,用户可以轻松从多种来源(包括 CSV 文件、Excel 表格、SQL 数据库等)导入、清洗、转换并汇总数据。
如果您想学习如何使用 pandas 导入和清洗数据、计算统计量并创建可视化,请查看我们的Data Manipulation with pandas 课程。
在本教程中,我们将探索 pandas 库的最新版本,通过示例介绍这些新功能的用法。
期待已久的 pandas 2.0 更新终于到来
Pandas 2.0 于 2023 年 4 月 3 日发布,标志着三年的开发进程。该版本带来一系列新功能,如增强的扩展数组支持、对 PyArrow 的 DataFrame 支持以及非纳秒级 datetime 分辨率。同时,它也落实了一些弃用项,从而导致 API 发生变化。
作为对 Pandas 的一次重大更新,2.0 实施了 1.X 中的所有弃用项。1.5.3 的最新发行版大约有 150 条警告。如果您的代码在 1.X 中没有警告,那么应当可以与 2.0 兼容。
揭秘 pandas 2.0 的最新功能
让我们看看 pandas 2.0 有哪些新变化,并了解如何使用其中的一些改进功能。
性能提升:更快且更节省内存的操作
PyArrow 可以说是此次版本的标志性特性。
Pandas 最初使用 NumPy 的数据结构进行内存管理,但现在用户可以选择使用 PyArrow 作为底层内存格式。
PyArrow 是一个基于 Arrow 构建的 Python 库,提供使用 Arrow 内存结构处理大型数据集的接口,以及用于序列化、压缩、并与 Apache Spark、Apache Parquet 等其他数据处理系统集成的工具。
Arrow 是一种开源、与语言无关的列式内存数据格式。它由 C++ 编写,但与语言无关。
原始 NumPy 后端导致的低效内存使用是一个常见问题,这促使用户去探索 Spark、Dask、Ray 等替代的数据处理工具。通过采用 PyArrow 后端来降低内存消耗,Pandas 现在可以为用户提供更顺畅的体验,并让他们更高效地开展工作。
基准测试比较了在 NumPy 和 PyArrow 后端下进行均值与替换操作的表现,同时也对比了 Polars
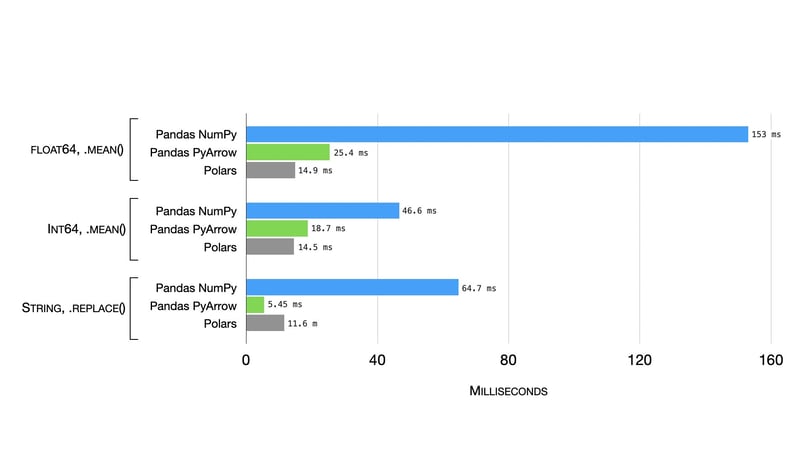
Polars 是一个基于 Rust 的 Python 数据处理库,提供与 pandas 类似的 DataFrame API,但在处理大型数据集方面具有更好的性能与可扩展性。想了解更多关于 Polars 库的信息,请查看官方网站。
以下是使用 PyArrow 作为后端读取 CSV 文件的代码片段:
pd.read_csv(my_file, dytpe_backend='pyarrow')
技术支持
如果您想学习在 pandas 中优化 Python 代码的高效技巧,请前往 DataCamp 查看Writing Efficient Code with pandas 课程。
可空数据类型现已可用
过去在 pandas 中处理缺失值颇具挑战,原因在于 NumPy 对某些数据类型不支持空值。例如,NumPy 的整数 dtype 不允许空值。当整数列中出现空值时,该列会自动转换为浮点 dtype,这并不理想。
Pandas 1.0 引入了可空 dtype,但使用起来需要付出一些额外努力。幸运的是,在最新版本中,将数据读入 DataFrame 时,您可以指定使用可空 dtype,使整个过程更加简单直接。
pd.read_csv(my_file, use_nullable_dtypes=True)
技术支持
写时复制(Copy-on-Write)性能优化
写时复制是 Pandas 采用的一种内存优化技术,用于在处理大型数据集时提升性能并减少内存使用。它使 Pandas 更加接近 Spark 的行为以及 Spark 中的惰性操作。惰性操作指的是不会立即执行、而是在触发某个动作时才开始计算的操作。之所以称为“惰性”,是因为它们会推迟执行,直到有必要计算并返回最终结果。
其基本思想是在创建 pandas 对象(如 DataFrame 或 Series)的副本时,先生成对原始数据的引用,只有在发生修改时才创建新的副本。
这种方式允许同一数据的多个副本共享同一块内存,直到引入更改为止,从而无需重复拷贝数据,显著降低内存使用,并提升性能。
索引对 NumPy 数值类型的支持
在 pandas 2.0 中,Index 功能扩展为包含 NumPy 的数值 dtype,例如 int8、int16、int32、uint8、uint16、uint32、uint64、float32 和 float64,而此前仅支持 int64、uint64 和 float64。
此更新使得可以在原本会生成 64 位索引的操作中创建更低位宽的索引,例如 32 位索引。
现在所有数值索引都表示为具有相关 dtype 的 Index。
在使用 pip 安装 pandas 时通过指定 extras,您可以安装一组额外的可选依赖。例如:
pip install "pandas[performance, aws]>=2.0.0"
技术支持
这将安装 performance 和 aws 可选依赖。pandas 的安装指南提供了可用 extras 的列表。其中包括:[all、performance、computation、fss、aws、gcp、excel、parquet、feather、hdf5、spss、postgresql、mysql、sql-other、html、xml、plot、output_formatting、clipboard、compression 和 test]。别忘了加上引号(“”)。
时间戳的非纳秒级分辨率
长期以来,pandas 存在一个限制:时间戳只能以纳秒级分辨率表示。这意味着无法表示 1677 年 9 月 21 日之前或 2264 年 4 月 11 日之后的日期。这个限制给分析跨越长时期的时间序列数据的研究者带来了困难。
然而,自 pandas 2.0 起,已支持秒、毫秒和微秒等其他分辨率。此增强将时间范围扩展至正负 2.9e11 年,覆盖了大多数用例。
日期时间解析格式的一致性
此前,pandas 中的 to_datetime() 会为每个元素独立推断格式。当用户期望格式一致时,这种行为可能导致问题,因为函数会在元素之间切换格式。
虽然这种做法适用于混合日期格式的情形,但也给许多用户带来了困扰。
在 pandas 2.0 中,解析过程已修改为使用由首个非 NA 值确定的一致格式。用户仍可显式指定 format,此时将按指定格式解析。
旧行为:
ser = pd.Series(['13-01-2000', '12-01-2000'])
pd.to_datetime(ser)
Out[2]:
0   2000-01-13
1   2000-12-01
dtype: datetime64[ns]
技术支持
新行为:
ser = pd.Series(['13-01-2000', '12-01-2000'])

pd.to_datetime(ser)
Out[43]:
0   2000-01-13
1   2000-01-12
dtype: datetime64[ns]
技术支持
示例摘自官方文档。
兼容性与迁移
向后不兼容的 API 变更,指的是库的 API 发生的修改,可能会破坏现有代码或集成。这些变更可能包括移除或重命名函数、类或参数,或改变其预期行为。请在文档中查看 pandas 2.0 的所有破坏性变更列表:backward incompatible API changes。
要更新 pandas 库,只需在终端或笔记本中运行以下命令:
pip install -U pandas
技术支持
社区与支持
查看 pandas 2.0 的完整发行说明
您也可以使用我们的pandas 数据科学速查表快速了解这款 Python 数据分析库的基础知识,包括代码示例。
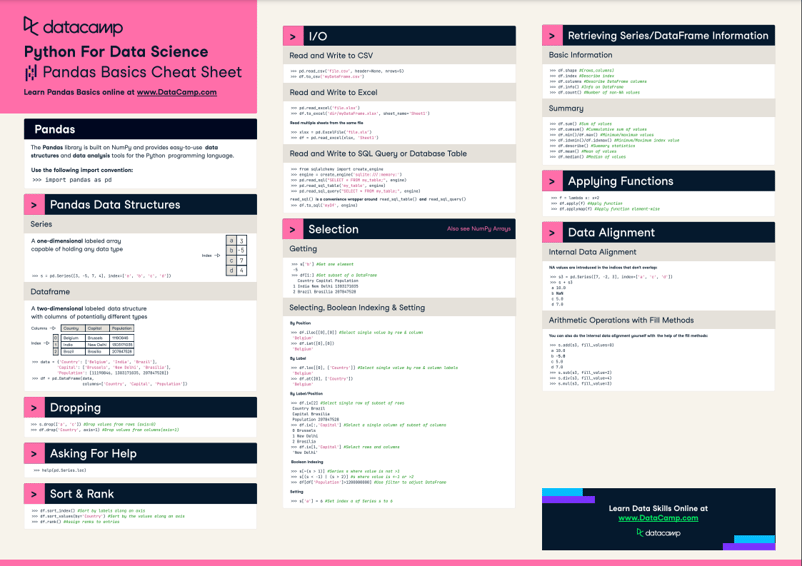
来自 DataCamp 的速查表。来源
pandas 是由庞大的贡献者群体和一个较小的维护团队共同开发的开源项目,由社区驱动。pandas 的领导层致力于建立一个积极、包容、开放的社区。如果您希望参与其中,请查看 pandas 的贡献者社区指南。
结语
Pandas 2.0 是这款广受欢迎的数据分析库的一次重要更新,带来了诸多新功能,例如借助 PyArrow 提升性能、可空数据类型、写时复制优化、索引对更多 NumPy 数值类型的支持,以及非纳秒级 datetime 分辨率。
借助此次更新,pandas 现已能够以更高的内存效率处理更大的数据集,为用户提供更顺畅的使用体验。
要利用这些新功能,用户只需运行 pip install -U pandas 命令更新 pandas 库。pandas 社区也在持续提供支持与资源,包括 DataCamp 上的课程,帮助用户提升数据分析技能。
以下是几篇优秀的教程,可助您精进数据分析能力。

数据分析往往高度依赖不可或缺的 pandas 库。它提供易用的数据结构和数据处理函数,能够高效处理表格型数据集。借助 pandas,用户可以轻松从多种来源(包括 CSV 文件、Excel 表格、SQL 数据库等)导入、清洗、转换并汇总数据。
如果您想学习如何使用 pandas 导入和清洗数据、计算统计量并创建可视化,请查看我们的Data Manipulation with pandas 课程。
在本教程中,我们将探索 pandas 库的最新版本,通过示例介绍这些新功能的用法。
期待已久的 pandas 2.0 更新终于到来
Pandas 2.0 于 2023 年 4 月 3 日发布,标志着三年的开发进程。该版本带来一系列新功能,如增强的扩展数组支持、对 PyArrow 的 DataFrame 支持以及非纳秒级 datetime 分辨率。同时,它也落实了一些弃用项,从而导致 API 发生变化。
作为对 Pandas 的一次重大更新,2.0 实施了 1.X 中的所有弃用项。1.5.3 的最新发行版大约有 150 条警告。如果您的代码在 1.X 中没有警告,那么应当可以与 2.0 兼容。
揭秘 pandas 2.0 的最新功能
让我们看看 pandas 2.0 有哪些新变化,并了解如何使用其中的一些改进功能。
性能提升:更快且更节省内存的操作
PyArrow 可以说是此次版本的标志性特性。
Pandas 最初使用 NumPy 的数据结构进行内存管理,但现在用户可以选择使用 PyArrow 作为底层内存格式。
PyArrow 是一个基于 Arrow 构建的 Python 库,提供使用 Arrow 内存结构处理大型数据集的接口,以及用于序列化、压缩、并与 Apache Spark、Apache Parquet 等其他数据处理系统集成的工具。
Arrow 是一种开源、与语言无关的列式内存数据格式。它由 C++ 编写,但与语言无关。
原始 NumPy 后端导致的低效内存使用是一个常见问题,这促使用户去探索 Spark、Dask、Ray 等替代的数据处理工具。通过采用 PyArrow 后端来降低内存消耗,Pandas 现在可以为用户提供更顺畅的体验,并让他们更高效地开展工作。
基准测试比较了在 NumPy 和 PyArrow 后端下进行均值与替换操作的表现,同时也对比了 Polars
Polars 是一个基于 Rust 的 Python 数据处理库,提供与 pandas 类似的 DataFrame API,但在处理大型数据集方面具有更好的性能与可扩展性。想了解更多关于 Polars 库的信息,请查看官方网站。
以下是使用 PyArrow 作为后端读取 CSV 文件的代码片段:
如果您想学习在 pandas 中优化 Python 代码的高效技巧,请前往 DataCamp 查看Writing Efficient Code with pandas 课程。
可空数据类型现已可用
过去在 pandas 中处理缺失值颇具挑战,原因在于 NumPy 对某些数据类型不支持空值。例如,NumPy 的整数 dtype 不允许空值。当整数列中出现空值时,该列会自动转换为浮点 dtype,这并不理想。
Pandas 1.0 引入了可空 dtype,但使用起来需要付出一些额外努力。幸运的是,在最新版本中,将数据读入 DataFrame 时,您可以指定使用可空 dtype,使整个过程更加简单直接。
写时复制(Copy-on-Write)性能优化
写时复制是 Pandas 采用的一种内存优化技术,用于在处理大型数据集时提升性能并减少内存使用。它使 Pandas 更加接近 Spark 的行为以及 Spark 中的惰性操作。惰性操作指的是不会立即执行、而是在触发某个动作时才开始计算的操作。之所以称为“惰性”,是因为它们会推迟执行,直到有必要计算并返回最终结果。
其基本思想是在创建 pandas 对象(如 DataFrame 或 Series)的副本时,先生成对原始数据的引用,只有在发生修改时才创建新的副本。
这种方式允许同一数据的多个副本共享同一块内存,直到引入更改为止,从而无需重复拷贝数据,显著降低内存使用,并提升性能。
索引对 NumPy 数值类型的支持
在 pandas 2.0 中,Index 功能扩展为包含 NumPy 的数值 dtype,例如 int8、int16、int32、uint8、uint16、uint32、uint64、float32 和 float64,而此前仅支持 int64、uint64 和 float64。
此更新使得可以在原本会生成 64 位索引的操作中创建更低位宽的索引,例如 32 位索引。
现在所有数值索引都表示为具有相关 dtype 的 Index。
安装 pip extras
在使用 pip 安装 pandas 时通过指定 extras,您可以安装一组额外的可选依赖。例如:
这将安装
performance和aws可选依赖。pandas 的安装指南提供了可用 extras 的列表。其中包括:[all、performance、computation、fss、aws、gcp、excel、parquet、feather、hdf5、spss、postgresql、mysql、sql-other、html、xml、plot、output_formatting、clipboard、compression和test]。别忘了加上引号(“”)。时间戳的非纳秒级分辨率
长期以来,pandas 存在一个限制:时间戳只能以纳秒级分辨率表示。这意味着无法表示 1677 年 9 月 21 日之前或 2264 年 4 月 11 日之后的日期。这个限制给分析跨越长时期的时间序列数据的研究者带来了困难。
然而,自 pandas 2.0 起,已支持秒、毫秒和微秒等其他分辨率。此增强将时间范围扩展至正负 2.9e11 年,覆盖了大多数用例。
日期时间解析格式的一致性
此前,pandas 中的
to_datetime()会为每个元素独立推断格式。当用户期望格式一致时,这种行为可能导致问题,因为函数会在元素之间切换格式。虽然这种做法适用于混合日期格式的情形,但也给许多用户带来了困扰。
在 pandas 2.0 中,解析过程已修改为使用由首个非 NA 值确定的一致格式。用户仍可显式指定 format,此时将按指定格式解析。
旧行为:
新行为:
示例摘自官方文档。
兼容性与迁移
向后不兼容的 API 变更,指的是库的 API 发生的修改,可能会破坏现有代码或集成。这些变更可能包括移除或重命名函数、类或参数,或改变其预期行为。请在文档中查看 pandas 2.0 的所有破坏性变更列表:backward incompatible API changes。
要更新 pandas 库,只需在终端或笔记本中运行以下命令:
社区与支持
查看 pandas 2.0 的完整发行说明
您也可以使用我们的pandas 数据科学速查表快速了解这款 Python 数据分析库的基础知识,包括代码示例。
来自 DataCamp 的速查表。来源
pandas 是由庞大的贡献者群体和一个较小的维护团队共同开发的开源项目,由社区驱动。pandas 的领导层致力于建立一个积极、包容、开放的社区。如果您希望参与其中,请查看 pandas 的贡献者社区指南。
结语
Pandas 2.0 是这款广受欢迎的数据分析库的一次重要更新,带来了诸多新功能,例如借助 PyArrow 提升性能、可空数据类型、写时复制优化、索引对更多 NumPy 数值类型的支持,以及非纳秒级 datetime 分辨率。
借助此次更新,pandas 现已能够以更高的内存效率处理更大的数据集,为用户提供更顺畅的使用体验。
要利用这些新功能,用户只需运行
pip install -U pandas命令更新 pandas 库。pandas 社区也在持续提供支持与资源,包括 DataCamp 上的课程,帮助用户提升数据分析技能。以下是几篇优秀的教程,可助您精进数据分析能力。