
除此之外,该模型还承诺带来一系列改进。我们逐条过一遍这些宣称的提升,并结合示例做些批判性观察。
更符合物理规律
据称 Sora 2 更能理解重量、平衡、物体恒存、因果关系等概念。如果有人投篮没进,球应该从篮筐上弹开—而不是像旧模型里那样神奇地瞬移进框。我们来分析这个示例:
大部分时段里,运动的物理效果相当逼真,但如果您看最后的几个画面(最后 0.5 秒),会发现滑手的双腿被拉伸成不可能、近乎变形的样子。
当猫从滑手的头上掉下时,坠落感觉失重且不自然。然后在结尾,猫又做了个不可能完成的旋转。
这段视频的另一个主要问题是,我们有音频连续性,但缺失视频连续性。听着场馆里话筒传出的播音,我们可以推断动作与时间是连续的,因为声音没有切断;但这段 10 秒的视频其实由三段显然发生在不同时间的镜头拼接而成。我很清楚,Sora 2 对基本的蒙太奇原则掌握不多。
能够模拟失败
另一个细微但很实用的升级是,Sora 2 现在能生成逼真的失误。旧模型大多呈现成功的动作—要么跳跃总能落地,要么总能进球。Sora 2 试图模拟失败,这比听起来更难。对 AI 而言,要“真实地出错”,往往需要对物理与人类行为有更深入的内部建模。
来看一个示例:
我其实挺喜欢这段视频,几乎让我相信这次摔倒是真的。唯一打破幻觉的是临近结尾处那种不可能的平衡。见仁见智,但我觉得这名男子本该更早就摔倒。
话说回来,能生成失误的能力潜力很大。最显而易见的场景是需要拍危险镜头的时候。也许可以用 AI 替代真人,避免复杂性并降低预算。
更好的连贯性
OpenAI 表示,Sora 2 能在多镜头中遵循复杂提示,同时保持同一角色、光线与整体世界状态的一致。所以如果您要求一个穿红夹克的男子进入建筑、走过走廊、从桌上拿起报纸,夹克应始终是红色,走廊应保持一致,不会突然出现两份报纸或三只手臂。
这是我为此功能找到的最相关示例:
这个示例在一段 10 秒的视频里塞进了足足六个镜头,颇为惊人。真正撑起连贯性的是声音—背景人声、焰火与对白的生成都令人印象深刻。我听不懂所说的语言,无法判断语义,但从声音效果上来说,是成立的。
不过,一旦仔细看画面,就会开始困惑。人物之间的距离变化过大—有时相隔很远,几秒后又突然牵起了手。镜头还越轴得有些随意,导致很难理解空间地理与人物位置。
尽管如此,面部一致性做到了完美,这点值得给模型加分。光线也保持一致,黑白调色在所有镜头里都站得住脚。
风格更灵活
OpenAI 声称,该模型可以在写实、电影化与动画风格(包括动漫)之间流畅切换,同时保持运动与身份一致性。这对想要风格化输出、又不想完全失去场景掌控的创作者很有用。
不得不说,在他们展示的所有内容中,这或许是我最喜欢的示例。它既有做得好的地方,也有不到位的地方,但就叙事而言,我认为这是个精心打磨的片段,主要因为它构建了有效的情感动态。
主角周围的世界是快乐的:人们在享受某种夜间节日,焰火点亮天空,弥漫着庆祝的氛围。但在这一切的正中央,两位主角似乎正在进行一场非常艰难的对话—感觉他们正处于一场不可逆转的分手边缘。
我听不懂语言,所以无法确定他们在说什么,但情感基调非常清晰。音乐选择得很好—略微欢快,贴合场景—而结尾处的特写,女性角色眼中倒映的焰火,更是点题之笔。
如果一定要挑刺,就是周围的人完全不动。但这也可能是有意为之—我们看到的是一个主观视角,在他们紧绷的情绪世界里,周遭仿佛短暂停滞,因为对他们而言,外部世界主观上已暂时消失。
我也推荐您看看我们关于 Sora 最强竞争对手之一、字节跳动 Seedance 2.0 的指南。
Sora:社交应用
与模型同时,OpenAI 还推出了一款名为 Sora 的新 iOS 应用,为视频生成体验加入完整的社交层。目前,这款应用是获取 Sora 2 使用权限的主要方式—而且迄今为止仅限受邀、且局限于美国与加拿大用户。
我猜 OpenAI 想观察当人们开始相互混剪内容、把自己插入场景,并把 AI 视频当作一种社交语言时会发生什么。它能否成为下一个 TikTok 是另一个问题(我认为概率为零),但机制本身很有意思。
Sora 社交应用如何运作
Sora 应用的核心是一个为可混剪 AI 视频而生的信息流平台。您可以刷看其他用户生成的短片,其中许多通过一种名为cameos 的系统包含真实人物的相貌(下文详述)。如果您想自己创作,可以从零编写新提示,或在对方允许的前提下,用某人的 cameo 混剪现有视频。
您可以像其他社交平台一样“点赞”、混剪、转发或关注用户。信息流是个性化的,但 OpenAI 表示他们并不以观看时长为优化目标,而是致力于最大化创作与灵感。他们还加入了健康使用控制,包括青少年的每日生成上限与通过 ChatGPT 实现的家长监管。
应用还包含一个自然语言控制的推荐系统,意味着您可以用纯英文引导您看到的内容(例如“show me funny videos with animals”或“less surreal stuff”)。
Cameo 功能
这大概是应用里最具新意的功能。Cameo 允许您录制一段一次性的视频与音频自我片段,模型随后据此生成一个全身形象—包括声音、外观与表情。您的 cameo 一旦验证并上传,您就能把自己插入任何场景,或允许朋友把您混剪进他们的作品。
OpenAI 的表述是,您始终掌控自己的相貌使用:
- 由您决定谁可以使用您的 cameo。
- 您可以撤销访问权限,或移除任何包含您的视频。
- 您可以查看所有出现过您相貌的视频(包括草稿)。
这是个聪明的系统,但也带来许多问题—关于同意、版权、审核以及如何扩展。OpenAI 称他们正在组建人工审核团队以处理如霸凌等边界问题,并对更年轻的用户实施更严格的权限。
为何突然抢滩 AI 生成媒体?
正如斯坦福最近的一份报告指出的,AI 其实并未真正颠覆太多行业—但有一个明确的例外:媒体。
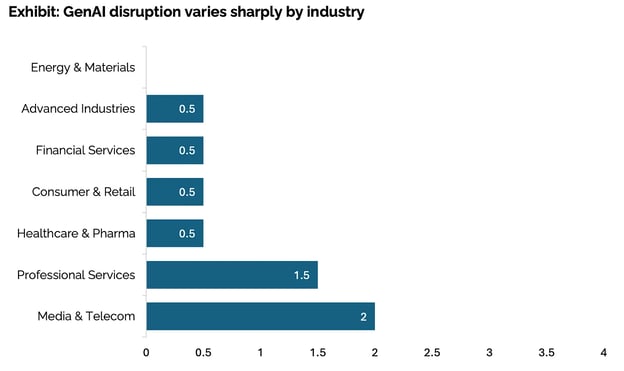
来源:State of AI in Business 2025 报告
我不认为这只是统计学上的噪点。我直接与广告制片人聊过,他们对这场转变非常认真。许多人正积极试验 AI,以降低制作成本、加快进度,并避免棚内拍摄带来的种种后勤麻烦。
公开层面也能看到同样的趋势。随便刷刷 LinkedIn,您就会看到创作者发布 AI 生成的短片、广告与概念预告。一个很好的例子是这支 Kalshi 广告—一家真实公司的真正广告—完全用 AI 制作:
这也是我认为 OpenAI、谷歌和 Meta 突然全力推进 AI 生成媒体的原因。如果说有一个领域是生成式 AI 已经证明有用、且人们正在积极投入时间与金钱的,那就是这里。因此各大实验室争相围绕视频构建平台、生态与社交层也就顺理成章。
就在上周,Meta 发布了Vibes,一个由 AI 生成视频构成的新短视频信息流,似乎正瞄准与 OpenAI 的 Sora 应用相同的空间。模式非常清晰:先抓住媒体与娱乐这个机会窗口,而技术尚不足以稳定颠覆医疗或金融等监管更严的行业。
简而言之,视频是垂手可得的“低垂果实”—所有人都想先摘到。
结论
虽然我希望保持批判性,但也值得肯定这些 AI 模型走了多远。别忘了在 2023 年初,我们能看到的最好成果还是威尔·史密斯吃意大利面的视频。而现在我们在谈的是原生音频、情感连贯,以及让您把自己丢进海盗船上的剑斗或由自家狗主持的超现实烹饪节目的完整社交混剪应用。
尽管如此,Sora 2 仍在空间一致性、基本剪辑逻辑与细微物理真实感方面存在问题。而 OpenAI 将权限锁在仅限受邀的 iOS 应用之后,这一决定也并不利于其在寻求专业级工具的专业用户中的口碑。这里有潜力,但也有摩擦。
可以肯定的是,AI 生成媒体仍将是值得关注的领域。
常见问题
如果我订阅了 ChatGPT Plus 或 Pro,如何获取 Sora 2 的访问权限?
许多在 X 和 Reddit 上、已订阅 OpenAI 的用户对分阶段开放表示不满,目前优先面向 Sora 1 的重度用户,随后才扩展到 Plus 和 Pro。若您是 Pro,请留意 ChatGPT 应用的推送通知或访问 sora.com 登录—权限很快应会解锁无限 720p/10 秒生成,Pro 则可解锁 1080p/20 秒的 “Sora 2 Pro” 模式。Plus 用户获得类似权益,但可能排队;免费层提供宽松但有限的试用。如果尚未收到邀请,系因需求过高—预计未来一周会分批放量,先从美国和加拿大开始,随后全球开放。
Sora 2 的生成限额与定价如何?
生成限额是热门话题,X 上有人吐槽 OpenAI 的“慷慨限额”表述含糊;免费用户会遇到冷却时间(如每 15 分钟一次),Plus 提供无限标准生成,Pro 则在不设上限的情况下提供更快、更高分辨率的输出。Reddit 讨论推测,算力成本让更长视频(超过 20 秒)保持在高阶档,但目前没有硬性付费墙—上线阶段免费,另有批量渲染等增值升级。请在仪表盘实时关注配额,因为他们会根据使用情况动态调整。
Sora 2 是否在美国和加拿大以外地区可用?
iOS 应用与完整访问已于 2025 年 9 月 30 日在美国/加拿大率先上线,但 OpenAI 计划快速全球扩展—有欧盟用户称已通过 ChatGPT Pro 获得测试访问,但下载应用可能需要 VPN 变通。请查看 OpenAI 帮助中心了解您所在国家/地区的状态;延迟主要源于数据隐私法规,但大多数地区应在数周内开放。
Sora 2 与 Veo 3 或 Runway 等竞品相比如何?
X 的讨论把它与谷歌的 Veo 3(时长更强)和 Runway(编辑工具更好)进行对比,但 Sora 2 在物理准确性、角色一致性与集成音频方面胜出—用户称其像一个为连贯故事服务的“世界模拟器”。Reddit 的分析认为,Veo 在 4K 上略占优势,但 Sora 的可控性(多镜头、风格)与社交应用让它更有趣、更易用。缺点?渲染更慢、目前上限 720p。总体而言它是写实性的 SOTA,但差距很小—建议亲自试用评判。

我是一名编辑和撰稿人,专注于 AI 博客、教程与新闻,确保内容契合成熟的内容策略并遵循 SEO 最佳实践。我编写过关于 Python、统计学、概率和数据可视化的数据科学课程。我的长篇小说曾获奖,业余时间从事影视剧本创作和电影导演。
人们原本说 2025 年将是 AI Agent 的一年,但只剩三个月时,我反而觉得这正在变成 AI 生成媒体的一年,先后发布了大热的 Veo 3、Nano Banana,而现在,Sora 2。
我本想像评测 Veo 3 那样做一篇完整的 Sora 2 评测,但即便我已订阅 ChatGPT Pro,也还没拿到使用权限。目前开放速度非常慢,重点似乎放在通过新社交媒体 Sora 应用的邀请码进入(稍后详述)。
这大概是想引导更多用户去那边,但我个人认为这从一开始就是个糟糕的决定,因为我猜多数人对用 Sora 生成视频更感兴趣,而不是去用这款社交应用。
OpenAI 要追上谷歌的 Veo 3 与 Nano Banana 组合还有很多路要走,而他们把权限与是否持有美国或加拿大的 iPhone 绑定在一起—哪怕是已经为 ChatGPT Pro 支付 200 美元的人—我认为从起步就走偏了。
话虽如此,我还是会全面梳理目前关于 Sora 2 的已知信息(既包括模型,也包括新的社交应用),而且—因为 Meta 上周也发布了Vibes,本质上是一个 AI 视频信息流—我还会讨论为何我认为 AI 公司突然全力押注媒体与娱乐类应用。
我们通过发送The Median(每周五的免费通讯,拆解本周关键新闻)来为读者带来 AI 前沿动态。订阅即可每周用几分钟保持敏锐:
Sora 2 是什么?
Sora 2 不只是一个新的视频模型—它也是 OpenAI 最新社交应用的名字。所以当人们现在谈起 Sora,可能指的是两件不同的事:
二者紧密相连,因为应用运行在 Sora 2 模型之上,但目的不同。模型是 OpenAI 打造通用视频与音频生成系统的尝试;应用则是在探索当您把这种能力包裹进短视频、可混剪的社交层后,会发生什么。
我们将在接下来的部分分别深入介绍。但先从主角开始:视频模型 Sora 2。
Sora 2:视频模型
我对 Sora 2 的第一印象是,OpenAI 团队终于攻克了原生音频输出—这一直是 Veo 3 的一大卖点。Sora 2 能在生成画面的同时直接生成对话、环境声与音效,无需后期拼接。