
机器学习推理简介
想象您已经训练了一个出色的机器学习模型,帮助业务团队通过给出相关推荐来吸引更多客户。最合乎逻辑的下一步,是将这个已训练模型接入公司的基础设施,让业务方可以用它来对新客户信息进行预测。使用此类现有模型的过程被称为推理。
机器学习推理至关重要,因为它让模型能够用于现实世界中的预测、分类或推荐等用例。
在本文结尾,您将更好地理解机器学习推理的工作方式、它与传统机器学习训练的区别,并对现有推理方法有一个总体认识,包括其优势、挑战以及一些真实应用。
机器学习推理 vs 训练
首先要牢记,机器学习推理与机器学习训练并不相同,这两个概念分别应用在任何机器学习项目的两个不同阶段。本节通过Cassie Kozyrkov的餐厅类比,直观地阐明二者差异。
她提到,做出一份好披萨(有价值的产品)需要一份菜谱(模型或公式),告诉我们如何用什么设备(算法)来处理食材(高质量数据)。
如果后厨没有端出食物,就谈不上服务。同样,如果顾客始终不认可出品,后厨(数据科学团队)也就谈不上价值。
为了良好的客户体验和更高的投资回报,两个团队需要协同合作。
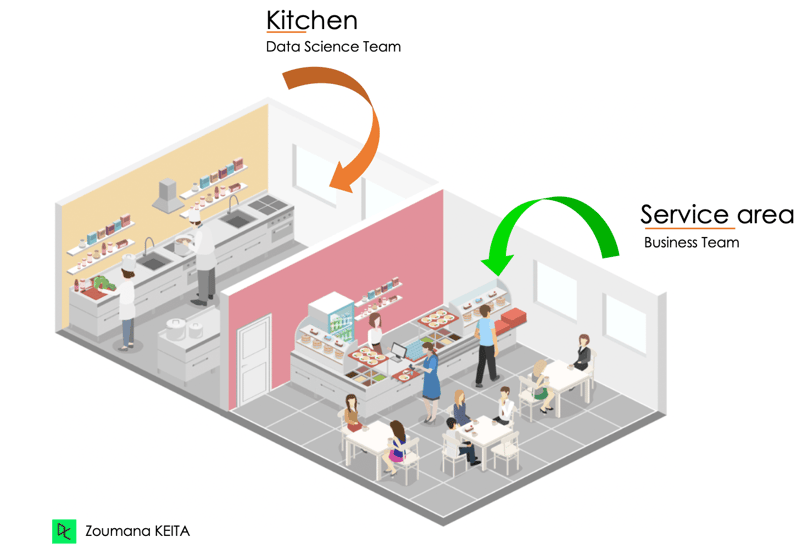
后厨(数据科学团队)与服务区(业务团队)
机器学习训练
训练一个机器学习模型需要使用训练集和验证集。训练数据用于开发模型,验证数据用于微调模型参数,使其尽可能稳健。这意味着在训练阶段结束时,模型应能以更少的错误预测新数据。我们可以将这一阶段视为“后厨端”。
阅读我们的综合指南What is Machine Learning,您将了解什么是机器学习、它与 AI 和深度学习的区别,以及为何它是数据科学中最令人兴奋的领域之一。
机器学习推理
就像菜品只有在可以上桌时才能被端给顾客一样,机器学习模型也需要先完成训练和验证,才能用于做出预测。机器学习推理与餐厅的这一情境类似。两者都需要用心,才能获得更好、更准确的结果,从而提升客户与业务满意度。
理解差异的重要性
了解机器学习推理与训练的区别非常关键,因为这有助于在模型部署到生产环境后,更好地为训练与推理分配计算资源。
模型在生产环境中的表现通常会有所下降。正确理解二者差异,有助于采用恰当的模型工业化策略,并在时间维度上持续维护。
在推理与训练之间做选择的关键考量
使用一个推理模型,还是训练一个全新模型,取决于问题类型、最终目标以及现有资源。
关键考量包括但不限于上市时间、资源约束或开发成本、模型性能以及团队专业能力。
- 上市时间。在选择训练还是使用现有模型时,评估可用时间非常重要。有时,使用预训练模型所需时间更少,且可能为业务团队带来竞争优势。
- 资源约束或开发成本。根据用例不同,训练一个模型可能需要大量数据与训练资源。而多数情况下,使用推理模型所需资源更少,从而更易在较短时间内获得更好的表现。
- 模型性能。训练机器学习模型是一个迭代过程,并不总能保证模型足够稳健。相较自研模型,使用推理模型可能带来更好的性能。当下,模型可解释性与偏差缓解至关重要,推理模型也可能需要更新以纳入这些能力。
- 团队专业能力。构建稳健的机器学习模型需要在模型训练与工业化方面具备深厚专长。这类能力未必现成具备,因此依赖推理模型可能是更优的替代方案。
机器学习中的贝叶斯推理
贝叶斯推理是一种机器学习技术,利用贝叶斯定理基于新证据更新先验知识,从而使算法能够进行预测。
但什么是贝叶斯定理?
它描述了在事件B已经发生的前提下,事件A的概率。其公式如下:
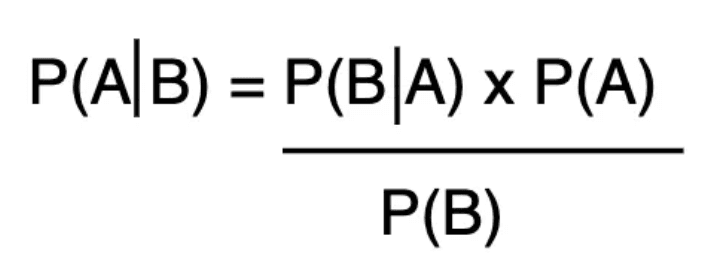
贝叶斯定理
P(A):先验 → 在不了解其他事件的情况下,事件 A 发生的概率。
P(B):归一化常数,用于计算后验事件B。
P(A|B):后验 → 在事件 B 发生的前提下,事件A发生的概率。
P(B|A):似然 → 若A发生,事件B发生的概率。
基于上述信息,让我们探讨贝叶斯推理的优势及其在现实生活中的一些应用。
通过我们的使用 Scikit-learn 的朴素贝叶斯分类教程,您将学习如何用 Python 的 Scikit-learn 包构建并评估朴素贝叶斯分类器。
贝叶斯推理的优势
贝叶斯推理具备多方面优势,包括但不限于:
- 灵活性。贝叶斯推理既可应用于线性也可应用于非线性模型,并适用于回归、分类、聚类、自然语言处理等多种机器学习问题。
- 更直观。利用新数据将先验更新为后验的过程,类似于人类依据新信息更新信念的方式,更加直观。例如,若某人先验认为明天会下雪,查看天气信息后会据此调整这一信念。
- 可解释。模型预测可能取值所对应的概率分布易于理解,这有助于决策者根据自身的风险容忍度进行决策。
贝叶斯推理在机器学习中的应用
以下是贝叶斯推理在机器学习中的一些真实应用:
- 信用卡欺诈检测。贝叶斯推理可用于识别欺诈行为。流程从基于历史数据对交易为欺诈的概率的先验开始;随后,随着新数据(如交易金额或客户购买历史)出现,使用贝叶斯定理更新先验以获得交易的后验概率,从而判断其是否为欺诈。
- 医学诊断。在医学诊断中,利用贝叶斯定理分析以往病例数据,估计患者患某种疾病的可能性。贝叶斯方法可以考虑多种影响因素,并生成比二元结果更具可解释性的概率性估计。
- 图像处理。贝叶斯推理在图像处理中有多种应用。例如,可以结合马尔可夫链蒙特卡洛方法与贝叶斯定理来去除图像噪声。
- 语音处理。在非参数层级神经网络中,使用贝叶斯非参数聚类(BNC)来执行语音与情感识别。该过程在类似任务上优于其他先进模型。
机器学习中的因果推断
因果推断是 AI 与机器学习中用于理解属性之间因果关系的统计方法。
例如,在市场营销中,决策者可能想了解哪一项活动带来的转化率最高。使用因果推断有助于识别转化率与营销活动之间的因果关系,从而最大化转化。
我们的 R 语言统计推断课程能帮助您掌握理解、解释与调优统计与机器学习模型所需的核心统计推断技能。
因果推断在机器学习中的重要性
因果推断在机器学习中重要的原因有很多,包括高效预测与公平性。下面简要看看这两点。
- 高效预测。在许多机器学习用例中,仅做相关性分析并不够,因为相关性并不必然意味着因果性。因果推断能帮助机器学习工程师识别变量之间的潜在因果关系,从而带来更准确的预测。
- 公平性。使用因果推断的机器学习可以帮助识别数据中偏差的根源。这有助于决策者采取适当行动以缓解偏差问题,从而开发出更好的机器学习模型。
在机器学习中实施因果推断的挑战
与其他机器学习技术一样,在机器学习中实施因果推断也有其挑战,但不限于以下几点:
- 大规模高质量数据。做出有效的因果推断需要大量高质量数据。然而,现实世界数据往往杂乱无章,找到完美的方法来消除错误并不容易。
- 可解释性。用于估计因果性的相关方法通常较为复杂,需要强大的统计专长以及被研究领域的高级领域知识,才能更好地解释结果。
- 混杂变量。这类变量同时与自变量和因变量相关。它们会偏倚自变量的真实因果效应,从而使准确估计因果效应变得困难。
结论
本文介绍了什么是机器学习推理、它与机器学习训练的区别,以及在二者之间做选择时需要考虑的一些关键建议。除强调贝叶斯与因果推断外,还阐述了它们在机器学习中的重要性与挑战。
务必要牢记,若要让任何机器学习模型在现实中发挥作用,推理是必不可少的。唯有通过推理,模型才能被集成进现有应用,被企业与不同利益相关方使用,从而带来更好的业务影响。
机器学习推理常见问答
什么是机器学习中的推理?
这是指使用已经训练并部署到生产环境的模型,对新的真实世界数据进行预测的过程。
机器学习推理需要哪些条件?
机器学习推理需要以下要素:已训练模型、计算资源、部署基础设施、监控工具以及真实世界数据。
推理有哪些类型?
推理主要有三种类型:溯因、演绎和归纳。
模型推理涉及哪些步骤?
模型推理一般包括以下步骤:(1)加载已训练模型,(2)对输入数据进行预处理以供模型使用,(3)将输入数据馈送给模型,(4)对模型预测结果进行后处理,(5)按期望格式返回结果。
构建机器学习推理框架的最佳实践有哪些?
构建可靠稳健的机器学习推理框架的最佳实践包括:(1)考虑框架的可扩展性,以支持多模型与多工作流;(2)便于与现有或未来系统及组件集成;(3)确保工作流能处理高吞吐量负载;(4)提供安全的资源访问;(5)纳入监控与日志能力;(6)建立清晰且持续更新的文档;(7)集成反馈回路。