
One week. 700+ courses for $0. No credit card needed.
Start Now

Luyện tập và Lộ trình tiến trình của bạn.
Tiếp tục với GoogleBằng cách tiếp tục, bạn chấp nhận Điều khoản sử dụng, Chính sách quyền riêng tư và việc dữ liệu của bạn được lưu trữ tại Hoa Kỳ.
Hãy tưởng tượng bạn đã huấn luyện được một mô hình machine learning tuyệt vời để giúp đội kinh doanh thu hút thêm khách hàng bằng cách đưa ra các gợi ý phù hợp. Bước tiếp theo hợp lý nhất là tích hợp mô hình đã huấn luyện vào hạ tầng của công ty để bộ phận kinh doanh có thể dùng mô hình đó dự đoán dựa trên thông tin của khách hàng mới. Quá trình sử dụng một mô hình đã có như vậy được gọi là suy luận (inference).
Suy luận trong machine learning rất quan trọng vì nó cho phép sử dụng mô hình cho các trường hợp thực tế như dự đoán, phân loại hoặc gợi ý.
Cuối bài viết này, bạn sẽ hiểu rõ hơn cách thức hoạt động của suy luận trong machine learning, cách nó khác với quá trình huấn luyện truyền thống, cùng cái nhìn tổng quan về các phương pháp suy luận hiện có, lợi ích, thách thức và một số ứng dụng trong đời sống.
Điều đầu tiên cần ghi nhớ là suy luận trong machine learning và huấn luyện trong machine learning không giống nhau, và mỗi khái niệm được áp dụng ở hai giai đoạn khác nhau của bất kỳ dự án machine learning nào. Phần này cung cấp một cách giải thích trực quan để làm rõ sự khác biệt thông qua phép ẩn dụ nhà hàng của Cassie Kozyrkov.
Bà đề cập rằng để làm ra một chiếc pizza ngon (một sản phẩm có giá trị) cần có công thức (mô hình hay công thức) cho biết cách chuẩn bị nguyên liệu (dữ liệu chất lượng) với các dụng cụ nào (thuật toán).
Sẽ không có dịch vụ nếu không có món ăn nào từ bếp đưa ra. Đồng thời, căn bếp (Đội Khoa học Dữ liệu) cũng sẽ không có giá trị nếu khách liên tục không hài lòng với món ăn.
Để mang lại trải nghiệm khách hàng tốt và hoàn vốn đầu tư cao hơn, cả hai đội cần phối hợp với nhau.
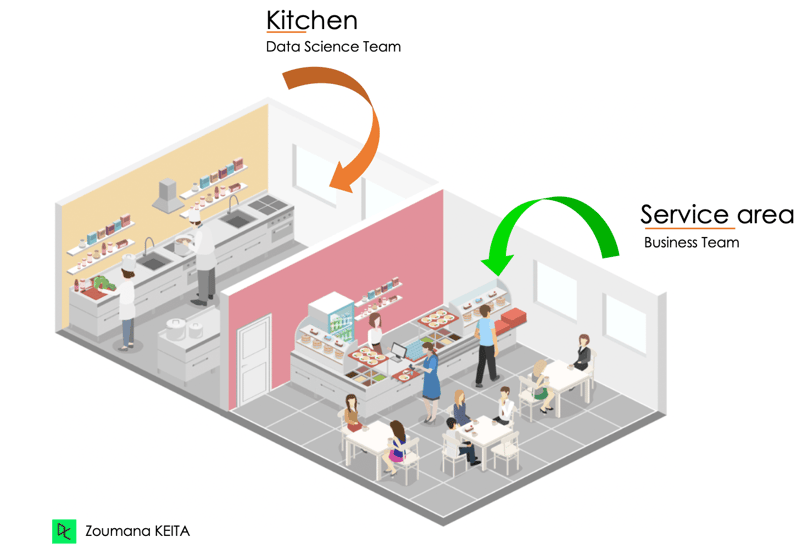
Nhà bếp (Đội Khoa học Dữ liệu) & Khu vực phục vụ (Đội Kinh doanh)
Huấn luyện một mô hình machine learning cần sử dụng dữ liệu huấn luyện và dữ liệu kiểm định. Dữ liệu huấn luyện dùng để xây dựng mô hình, trong khi dữ liệu kiểm định dùng để tinh chỉnh các tham số của mô hình và giúp mô hình vững vàng nhất có thể. Điều này có nghĩa là đến cuối giai đoạn huấn luyện, mô hình phải có khả năng dự đoán dữ liệu mới với ít sai số hơn. Ta có thể coi giai đoạn này là phía nhà bếp.
Từ hướng dẫn tổng quan Machine Learning là gì của chúng tôi, bạn sẽ học được machine learning là gì, nó khác AI và deep learning như thế nào, và vì sao đây là một trong những lĩnh vực thú vị nhất của khoa học dữ liệu.
Món ăn chỉ có thể phục vụ khi đã sẵn sàng để dùng, cũng như mô hình machine learning cần được huấn luyện và kiểm định trước khi có thể dùng để dự đoán. Suy luận trong machine learning tương tự kịch bản ở nhà hàng. Cả hai đều cần được chú ý để có kết quả tốt và chính xác hơn, từ đó làm hài lòng khách hàng và doanh nghiệp.
Biết được sự khác nhau giữa suy luận và huấn luyện trong machine learning là rất quan trọng, vì nó giúp phân bổ tốt hơn tài nguyên tính toán cho cả hai giai đoạn khi triển khai vào môi trường sản xuất.
Hiệu năng mô hình thường giảm trong môi trường sản xuất. Hiểu đúng sự khác biệt có thể giúp áp dụng các chiến lược công nghiệp hóa mô hình phù hợp và duy trì chúng theo thời gian.
Việc sử dụng một mô hình suy luận hay huấn luyện một mô hình hoàn toàn mới phụ thuộc vào loại bài toán, mục tiêu cuối cùng và nguồn lực sẵn có.
Các yếu tố then chốt bao gồm nhưng không giới hạn ở thời gian ra thị trường, ràng buộc tài nguyên hoặc chi phí phát triển, hiệu năng mô hình và chuyên môn của đội ngũ.
Suy luận Bayes là một kỹ thuật trong machine learning cho phép thuật toán đưa ra dự đoán bằng cách cập nhật hiểu biết ban đầu dựa trên bằng chứng mới theo định lý Bayes.
Vậy định lý Bayes là gì?
Định lý mô tả xác suất của biến cố A khi biết rằng một biến cố khác, B, đã xảy ra. Công thức như dưới đây:
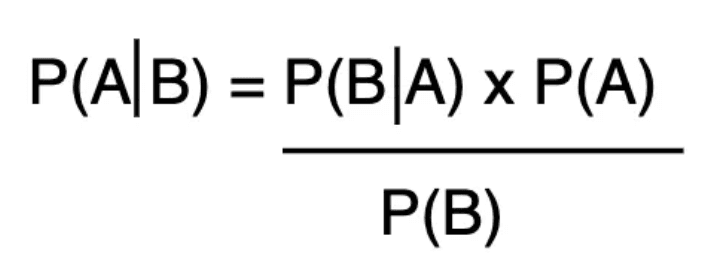
Định lý Bayes
P(A): tiên nghiệm → xác suất biến cố A xảy ra khi chưa có thông tin về các biến cố khác.
P(B): hằng số chuẩn hóa cho phép tính xác suất hậu nghiệm của biến cố B.
P(A|B): hậu nghiệm → xác suất biến cố A xảy ra khi biết B xảy ra.
P(B|A): khả dĩ → xác suất biến cố B xảy ra nếu A xảy ra.
Với thông tin này, hãy cùng khám phá các ưu điểm của suy luận Bayes và một số ứng dụng trong thực tế.
Từ Hướng dẫn Phân loại Naive Bayes bằng Scikit-learn, bạn sẽ học cách xây dựng và đánh giá bộ phân loại Naive Bayes bằng gói Scikit-learn của Python.
Suy luận Bayes có nhiều ưu điểm, bao gồm nhưng không giới hạn ở:
Dưới đây là một số ứng dụng thực tế của suy luận Bayes trong machine learning:
Suy luận nhân quả là một phương pháp thống kê được dùng trong AI và machine learning để hiểu mối quan hệ nhân - quả giữa các thuộc tính.
Ví dụ, trong marketing, người ra quyết định có thể muốn hiểu chiến dịch nào tạo ra tỷ lệ chuyển đổi cao nhất. Sử dụng suy luận nhân quả có thể giúp xác định mối quan hệ nhân quả giữa tỷ lệ chuyển đổi và chiến dịch marketing để tối đa hóa chuyển đổi.
Khóa học Suy luận thống kê với R của chúng tôi có thể giúp bạn làm quen với bộ kỹ năng cốt lõi trong suy luận thống kê, cần thiết để hiểu, diễn giải và tinh chỉnh các mô hình thống kê và machine learning.
Suy luận nhân quả quan trọng trong machine learning vì nhiều lý do, bao gồm dự đoán hiệu quả và tính công bằng. Hãy điểm nhanh từng yếu tố.
Giống các kỹ thuật khác trong machine learning, việc triển khai suy luận nhân quả có những thách thức riêng, bao gồm nhưng không giới hạn ở các điểm dưới đây:
Bài viết này đã đề cập suy luận trong machine learning là gì, cách nó khác với huấn luyện machine learning, và một số khuyến nghị then chốt khi lựa chọn giữa hai hướng tiếp cận. Bên cạnh việc nhấn mạnh suy luận Bayes và suy luận nhân quả, bài viết cũng nêu bật tầm quan trọng và các thách thức của chúng trong machine learning.
Cần ghi nhớ rằng suy luận là điều bắt buộc để bất kỳ mô hình machine learning nào trở nên hữu ích trong thực tế. Chỉ thông qua suy luận, mô hình mới có thể được tích hợp vào các ứng dụng hiện có và được doanh nghiệp cùng các bên liên quan sử dụng nhằm tạo tác động kinh doanh tốt hơn.
Đó là quá trình sử dụng một mô hình đã được huấn luyện và triển khai trong môi trường sản xuất để dự đoán trên dữ liệu thực tế mới.
Suy luận trong Machine Learning cần các yếu tố sau: mô hình đã huấn luyện, tài nguyên tính toán, hạ tầng triển khai, công cụ giám sát và dữ liệu thực tế.
Có ba loại suy luận chính: abductive (suy diễn lùi), deductive (diễn dịch), và inductive (quy nạp).
Suy luận của mô hình gồm các bước: (1) nạp mô hình đã huấn luyện, (2) tiền xử lý dữ liệu đầu vào để mô hình sử dụng, (3) đưa dữ liệu đầu vào vào mô hình, (4) hậu xử lý dự đoán của mô hình, và (5) trả về kết quả theo định dạng mong đợi.
Xây dựng một khung suy luận machine learning đáng tin cậy và vững vàng bao gồm các thực hành tốt sau: (1) cân nhắc khả năng mở rộng của khung để hỗ trợ nhiều mô hình và quy trình làm việc, (2) dễ tích hợp với các hệ thống và thành phần hiện có hoặc trong tương lai, (3) đảm bảo quy trình có thể xử lý tải thông lượng cao, (4) cung cấp truy cập tài nguyên an toàn, (5) bao gồm khả năng giám sát và ghi log, (6) thiết lập tài liệu rõ ràng và luôn được cập nhật, (7) tích hợp vòng phản hồi.

blog
 Matt Crabtree• 10 phút