

什么是朴素贝叶斯分类器?
朴素贝叶斯是一种基于贝叶斯定理的统计分类技术。它是最简单的监督学习算法之一。朴素贝叶斯分类器快速、准确且可靠,在大型数据集上具有很高的准确率和速度。
朴素贝叶斯分类器假设某一类别中某个特征的影响独立于其他特征。例如,判断一位贷款申请人是否值得放贷,可能取决于其收入、既往贷款与交易记录、年龄与所在地。即便这些特征彼此相关,模型仍将它们视为相互独立。这个假设简化了计算,因此被称为“朴素”。该假设称为类条件独立。
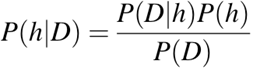
-
P(h):假设h为真的概率(与数据无关),称为h的先验概率。 -
P(D):数据出现的概率(与假设无关),称为先验概率。 -
P(h|D):在给定数据D的条件下假设h的概率,称为后验概率。 -
P(D|h):在假设h为真时数据d出现的概率,也称为后验概率。
朴素贝叶斯分类工作流
进行分类时,第一步是理解问题并识别潜在的特征和标签。特征是会影响标签结果的特性或属性。比如在贷款发放的场景中,银行经理会关注客户的职业、收入、年龄、所在地、历史贷款记录、交易记录和信用评分。这些特性称为特征,帮助模型对客户进行分类。
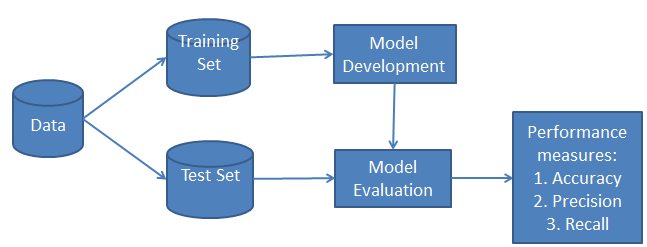
分类包含两个阶段:学习阶段和评估阶段。在学习阶段,分类器在给定数据集上训练模型;在评估阶段,测试分类器的性能。性能通常根据准确率、错误率、精确率和召回率等指标进行评估。
朴素贝叶斯分类器如何工作?
我们通过一个例子来理解朴素贝叶斯的工作原理。给定天气状况与是否进行体育活动的示例,您需要计算进行体育活动的概率。现在,需要根据天气状况来判断球员是否会参加运动。
方法一(单一特征的情况)
朴素贝叶斯分类器按以下步骤计算事件的概率:
- 步骤 1:计算给定类别标签的先验概率
- 步骤 2:针对每个类别,计算与各属性相关的似然概率
- 步骤 3:将这些数值代入贝叶斯公式,计算后验概率
- 步骤 4:比较各类别的概率,输入样本归入概率更高的类别
为简化先验与后验概率的计算,您可以使用频数表和似然表这两类表格。它们都有助于计算先验和后验概率。频数表包含所有特征的标签出现次数。有两张似然表:似然表 1 显示标签的先验概率,似然表 2 显示后验概率。
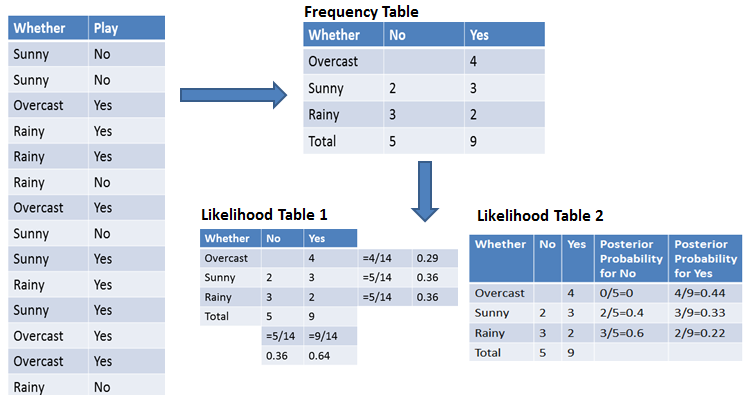
现在,假设您要计算当天气为阴(overcast)时进行比赛的概率。
进行比赛的概率:
P(Yes | Overcast) = P(Overcast | Yes) × P(Yes) / P(Overcast)
步骤 1:计算先验概率
- P(Overcast) = 4/14 = 0.29
- P(Yes) = 9/14 = 0.64
步骤 2:计算后验概率
- P(Overcast | Yes) = 4/9 = 0.44
步骤 3:应用贝叶斯公式
将先验与后验概率代入第一条公式。
P(Yes | Overcast) = 0.44 × 0.64 / 0.29 = 0.98
类似地,您可以计算不进行比赛的概率:
不进行比赛的概率:
P(No | Overcast) = P(Overcast | No) × P(No) / P(Overcast)
步骤 1:计算先验概率
- P(Overcast) = 4/14 = 0.29
- P(No) = 5/14 = 0.36
步骤 2:计算似然
- P(Overcast | No) = 0/5 = 0
步骤 3:应用贝叶斯公式
将先验与似然概率代入公式,得到后验概率。
P(No | Overcast) = 0 × 0.36 / 0.29 = 0
“Yes” 类的概率更高。因此可以判断,如果天气为阴,球员将会参加运动。
方法二(多特征的情况)
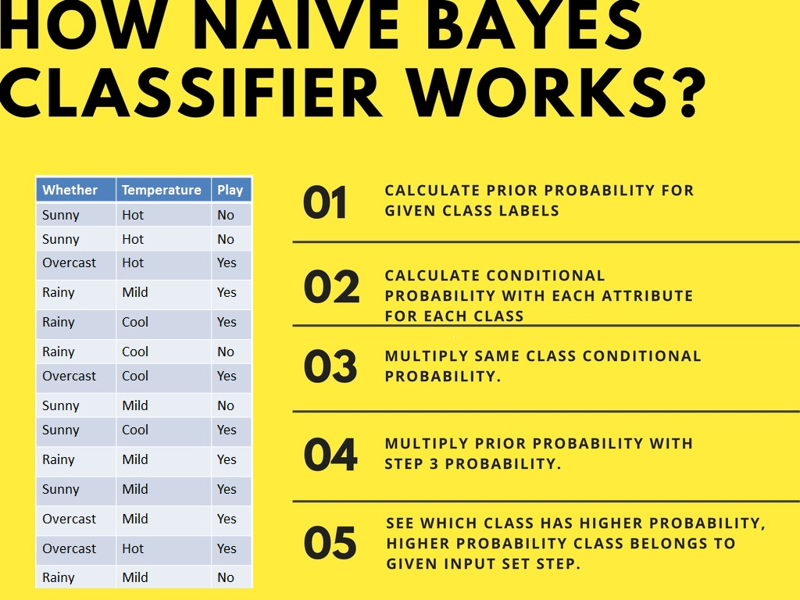
现在,假设您要计算当天气为阴且气温适中(mild)时进行比赛的概率。
进行比赛的概率:
P(Play = Yes | Weather = Overcast, Temp = Mild) = P(Weather = Overcast, Temp = Mild | Play = Yes) × P(Play = Yes)
基于朴素贝叶斯的独立性假设:
P(Weather = Overcast, Temp = Mild | Play = Yes) = P(Overcast | Yes) × P(Mild | Yes)
步骤 1:计算先验概率
- P(Yes) = 9/14 = 0.64
步骤 2:计算似然
- P(Overcast | Yes) = 4/9 = 0.44
- P(Mild | Yes) = 4/9 = 0.44
步骤 3:计算联合似然
P(Weather = Overcast, Temp = Mild | Play = Yes) = 0.44 × 0.44 = 0.1936
步骤 4:应用贝叶斯公式
P(Play = Yes | Weather = Overcast, Temp = Mild) = 0.1936 × 0.64 = 0.124
类似地,您可以计算不进行比赛的概率:
不进行比赛的概率:
P(Play = No | Weather = Overcast, Temp = Mild) = P(Weather = Overcast, Temp = Mild | Play = No) × P(Play = No)
基于朴素贝叶斯的独立性假设:
P(Weather = Overcast, Temp = Mild | Play = No) = P(Overcast | No) × P(Mild | No)
步骤 1:计算先验概率
- P(No) = 5/14 = 0.36
步骤 2:计算似然
- P(Overcast | No) = 0/5 = 0
- P(Mild | No) = 2/5 = 0.4
步骤 3:计算联合似然
P(Weather = Overcast, Temp = Mild | Play = No) = 0 × 0.4 = 0
步骤 4:应用贝叶斯公式
P(Play = No | Weather = Overcast, Temp = Mild) = 0 × 0.36 = 0
“Yes” 类的概率更高(0.124 对 0),因此当天气为阴且气温适中时,球员将会参加运动。
在 Scikit-learn 中构建分类器
使用合成数据集的朴素贝叶斯分类器
在第一个示例中,我们将使用 scikit-learn 生成合成数据,并训练与评估高斯朴素贝叶斯算法。
生成数据集
Scikit-learn 为我们提供了一个机器学习生态,方便生成数据集并评估各种机器学习算法。
在这里,我们使用 make_classification() 函数创建一个包含 6 个特征、3 个类别、800 个样本的数据集。
from sklearn.datasets import make_classification
X, y = make_classification(
n_features=6,
n_classes=3,
n_samples=800,
n_informative=2,
random_state=1,
n_clusters_per_class=1,
)我们将使用 matplotlib.pyplot 的 scatter() 函数来可视化数据集。
import matplotlib.pyplot as plt
plt.scatter(X[:, 0], X[:, 1], c=y, marker="*");可以看到,这里有三种目标标签,我们将训练一个多分类模型。
训练/测试集划分
在开始训练之前,需要将数据集划分为训练集与测试集,用于模型评估。
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.33, random_state=125
)构建与训练模型
构建一个通用的高斯朴素贝叶斯模型,并在训练数据集上进行训练。随后,将一个随机测试样本输入模型获取预测值。
from sklearn.naive_bayes import GaussianNB
# Build a Gaussian Classifier
model = GaussianNB()
# Model training
model.fit(X_train, y_train)
# Predict Output
predicted = model.predict([X_test[6]])
print("Actual Value:", y_test[6])
print("Predicted Value:", predicted[0])实际值与预测值一致。
Actual Value: 0
Predicted Value: 0模型评估
我们将在未见过的测试数据集上评估模型。首先对测试数据集进行预测,并据此计算准确率和 F1 分数。
from sklearn.metrics import (
accuracy_score,
confusion_matrix,
ConfusionMatrixDisplay,
f1_score,
)
y_pred = model.predict(X_test)
accuray = accuracy_score(y_pred, y_test)
f1 = f1_score(y_pred, y_test, average="weighted")
print("Accuracy:", accuray)
print("F1 Score:", f1)使用默认超参数,我们的模型表现相当不错。
Accuracy: 0.8484848484848485
F1 Score: 0.8491119695890328为可视化混淆矩阵,我们将使用 confusion_matrix 计算真阳性与真阴性,并用 ConfusionMatrixDisplay 搭配标签展示混淆矩阵。
labels = [0,1,2]
cm = confusion_matrix(y_test, y_pred, labels=labels)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=labels)
disp.plot();我们的模型表现良好,进一步可通过特征缩放、预处理、交叉验证和超参数优化来提升性能。
使用贷款数据集的朴素贝叶斯分类器
接下来我们在真实数据集上训练朴素贝叶斯分类器。除预处理与数据探索外,其余步骤将基本重复。
数据加载
本例中,我们将通过 pandas 的 read_csv 函数从 DataLab 加载贷款数据。
import pandas as pd
df = pd.read_csv('loan_data.csv')
df.head()数据探索
为更好理解数据集,我们将使用 .info()。
-
数据集包含 14 列与 9578 行。
-
除
purpose外,其余列类型为浮点或整数。 -
我们的目标列为
not.fully.paid。
df.info()RangeIndex: 9578 entries, 0 to 9577
Data columns (total 14 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 credit.policy 9578 non-null int64
1 purpose 9578 non-null object
2 int.rate 9578 non-null float64
3 installment 9578 non-null float64
4 log.annual.inc 9578 non-null float64
5 dti 9578 non-null float64
6 fico 9578 non-null int64
7 days.with.cr.line 9578 non-null float64
8 revol.bal 9578 non-null int64
9 revol.util 9578 non-null float64
10 inq.last.6mths 9578 non-null int64
11 delinq.2yrs 9578 non-null int64
12 pub.rec 9578 non-null int64
13 not.fully.paid 9578 non-null int64
dtypes: float64(6), int64(7), object(1)
memory usage: 1.0+ MB在本例中,我们将构建模型来预测哪些客户未足额还款。让我们使用 seaborn 的 countplot 探索 purpose 与目标列。
import seaborn as sns
import matplotlib.pyplot as plt
sns.countplot(data=df,x='purpose',hue='not.fully.paid')
plt.xticks(rotation=45, ha='right');我们的数据集存在类别不平衡,这会影响模型表现。您可以查看 重采样不平衡数据集 教程,实践如何处理不平衡数据。
数据处理
我们将使用 pandas 的 get_dummies() 函数把 purpose 列从分类型转换为整数哑变量。
pre_df = pd.get_dummies(df,columns=['purpose'],drop_first=True)
pre_df.head()随后定义特征(X)与目标(y)变量,并将数据集划分为训练集与测试集。
from sklearn.model_selection import train_test_split
X = pre_df.drop('not.fully.paid', axis=1)
y = pre_df['not.fully.paid']
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.33, random_state=125
)构建与训练模型
模型构建与训练非常简单。我们将在训练数据集上使用默认超参数训练模型。
from sklearn.naive_bayes import GaussianNB
model = GaussianNB()
model.fit(X_train, y_train);模型评估
我们将使用准确率与 F1 分数评估模型表现。可以看到高斯朴素贝叶斯算法的结果相当不错。
from sklearn.metrics import (
accuracy_score,
confusion_matrix,
ConfusionMatrixDisplay,
f1_score,
classification_report,
)
y_pred = model.predict(X_test)
accuray = accuracy_score(y_pred, y_test)
f1 = f1_score(y_pred, y_test, average="weighted")
print("Accuracy:", accuray)
print("F1 Score:", f1)Accuracy: 0.8206263840556786
F1 Score: 0.8686606980013266由于数据不平衡,可以看到混淆矩阵呈现出不同的信息:在少数类目标“未足额还款”上,误标更多。
labels = ["Fully Paid", "Not fully Paid"]
cm = confusion_matrix(y_test, y_pred)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=labels)
disp.plot();如果您在训练或评估过程中遇到问题,可以查看基于 Scikit-learn 的朴素贝叶斯分类教程DataLab 工作簿。其中包含数据集、源代码与输出结果。
零概率问题
假设数据集中不存在任何“高风险贷款”的样本;在这种情况下,后验概率将为零,模型将无法作出预测。这个问题称为“零概率问题”,因为某一类别的出现次数为零。
解决方案是拉普拉斯校正(Laplacian correction)或拉普拉斯平滑。拉普拉斯校正是一种平滑技术。在此您可以假设数据集足够大,给每个类别都增加一行样本不会对概率估计造成实质影响。这样可以避免概率值为零的问题。
例如:设某“高风险贷款”类别在数据库中共有 1000 个训练样本。在该数据库中,收入列中“低收入”为 0 个样本,“中等收入”为 990 个样本,“高收入”为 10 个样本。未经拉普拉斯校正时,这些事件的概率分别为 0、0.990(990/1000)和 0.010(10/1000)。
现在对给定数据集应用拉普拉斯校正。为每个收入取值组合各增加 1 个样本。此时这些事件的概率为:
朴素贝叶斯的优点
- 不仅方法简单,而且预测快速且准确。
- 朴素贝叶斯的计算成本很低。
- 能够高效处理大型数据集。
- 与连续响应变量相比,在离散响应变量情况下表现更好。
- 可用于多分类问题。
- 在文本分析问题中也有良好表现。
- 当独立性假设成立时,朴素贝叶斯分类器往往优于逻辑回归等其他模型。
朴素贝叶斯的缺点
- 特征独立性的假设。在实际中几乎不可能完全获得相互独立的预测变量集。
- 若某个类别在训练集中没有样本,会导致后验概率为零,此时模型无法进行预测。这被称为零概率/零频率问题。
结论
恭喜您读完本教程!
在本教程中,您学习了朴素贝叶斯算法、其工作原理、朴素假设、相关问题、实现方法,以及它的优缺点。过程中,您还学习了在 scikit-learn 中针对二分类与多项分类进行模型构建与评估。
朴素贝叶斯是最简洁且强大的算法之一。尽管近年来机器学习取得了巨大进步,它依然证明了自身价值,已在从文本分析到推荐引擎的诸多应用中成功落地。
如果您想进一步学习 Python 中的 scikit-learn,请参加我们的 使用 scikit-learn 的监督学习 课程,并查看 Scikit-Learn 教程:棒球分析(第一部分)。
假设您是一名产品经理,想要将客户评价划分为正面和负面两类。或者作为一名信贷经理,您希望识别哪些贷款申请人是安全的或高风险的?又或者作为一名医疗分析师,您希望预测哪些患者可能患上糖尿病。以上示例都有一个共同的问题:对评论、贷款申请人和患者进行分类。
朴素贝叶斯是一种最直接且快速的分类算法,适合处理大规模数据。朴素贝叶斯分类器已成功应用于垃圾邮件过滤、文本分类、情感分析和推荐系统等领域。它基于贝叶斯概率定理来预测未知类别。
在本教程中,您将学习以下内容:
若想自己轻松运行本教程中的所有示例代码,您可以免费创建一个 DataLab 工作簿,其中已预装 Python 并包含所有代码示例。想进一步练习 scikit-learn,请查看我们的 使用 Scikit-learn 的监督学习课程!