

课程
AWS 概念
2 小时
53.3K
实践并学习路径你的进步。
使用 Google 继续众所周知,全球生成的数据量正在飙升。根据 Statista 的研究,2010 年全球新创建的数据总量约为 2 ZB(泽字节),预计到 2025 年将达到 181 ZB。如果您不确定泽字节有多大,可以这样理解:1 个泽字节等于 10 亿个 TB(太字节),足以把有史以来的每部电影、每首歌曲和每本书保存很多遍。
数据量暴增,也就意味着对可靠、可扩展且具性价比的存储方案的需求水涨船高。Amazon S3 正是为此而生。
Amazon S3(S3 为 Simple Storage Service 的缩写)是 Amazon Web Services 的旗舰对象存储服务。它提供几乎无限的存储容量、高耐久性,以及灵活(但相对复杂)的定价。在本文中,您将了解什么是 S3、它如何工作、其关键功能,以及为什么它成为各种规模企业的首选方案。如果您想更全面地了解这一领域,不妨学习我们这两门信息量很足的课程:Understanding Cloud Computing 和 AWS Concepts。
Amazon S3 是一项全托管的对象存储服务,最早由 AWS 于 2006 年推出。其设计目标是从网络上的任意位置存储、处理和检索任意规模的数据,使其成为多种现代数据驱动应用的关键组成部分。以下是 S3 的核心组件:
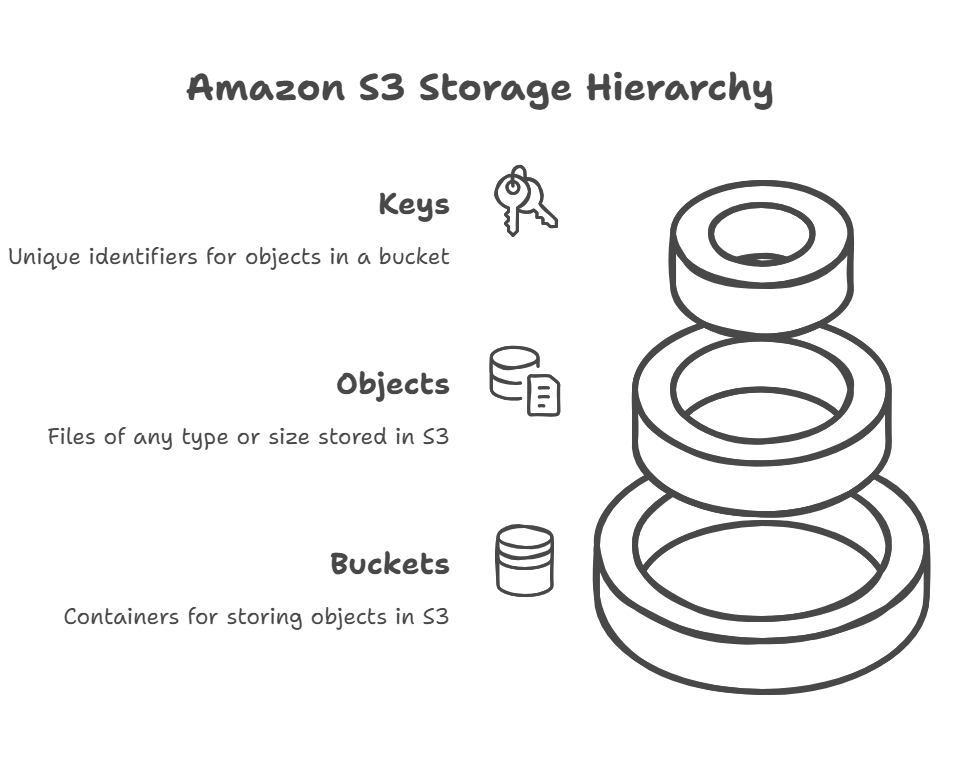
Amazon S3 核心组件。来源:Napkin AI 制图
下面按不分先后顺序来看这些关键特性:
借助 AWS S3,您可以在任何时间存储任意规模的数据和处理任意规模的请求。无论是存储几 GB 还是 PB 级数据、搭建网站还是存放机器学习数据,S3 的弹性都能为您提供安全、可扩展且易用的存储方案。
Amazon S3 会在多个位置保存您的数据副本,使您几乎不可能丢失信息。凭借这种设计,服务实现了 99.999999999% 的耐久性(Amazon 称为“11 个 9”),从而最大限度降低数据丢失风险。S3 还提供稳健的服务级协议(SLA),以确保您在需要时可以访问数据。
安全性始终是重中之重。使用 S3,您将获得:
Amazon S3 专为快速传输海量数据而设计,非常适合承载重负载的应用程序。高吞吐与低延迟的访问令其成为数据密集型应用的理想之选。您还可以通过优化读写方式、在上传时将大文件拆分为更小的分段、并行发送多个请求来进一步提升性能。
得益于其按需付费模式,您仅需为所使用的存储、请求与数据传输付费。收费取决于对象大小、在当月存储对象的时长以及所选存储类别。这种灵活性使企业能够按需扩缩,避免高额的前期基础设施投入。您可以使用 AWS 定价计算器进行成本估算。
Amazon S3 提供不同的存储类别,以匹配您数据的访问模式与成本需求:
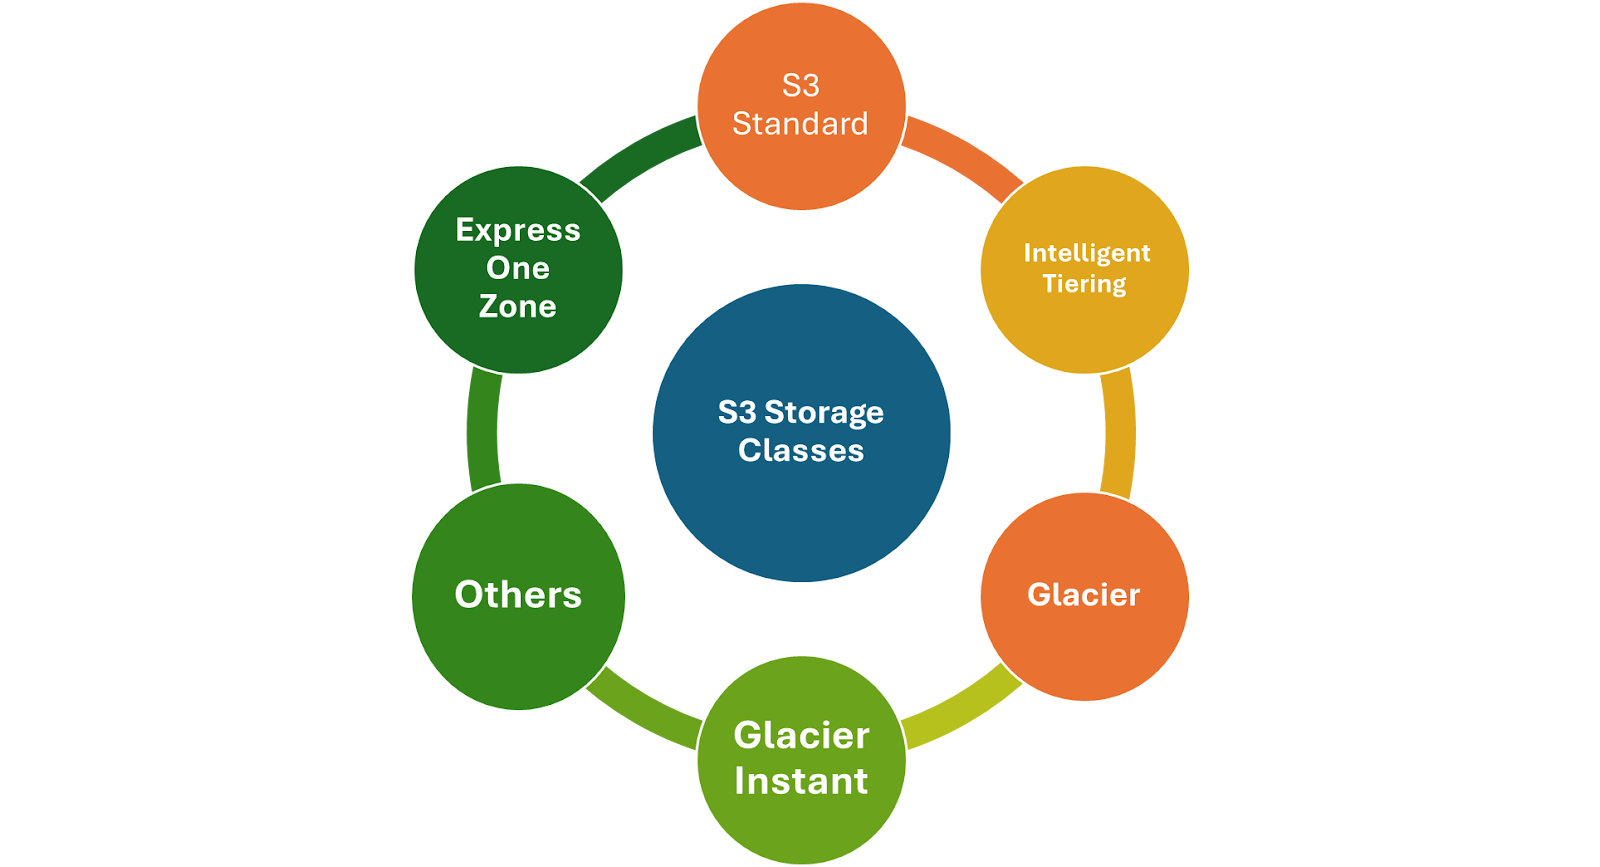
Amazon S3 存储类别:来源:作者制图
S3 Standard 是一种可靠的高性能存储选项,非常适合需要频繁访问的文件。它提供快速响应并能处理海量数据,适用于从云应用、动态网站到移动游戏和大数据分析的各种场景。
Amazon S3 Intelligent-Tiering 的独特之处在于,当您的数据访问模式发生变化时,它会自动降低存储成本,同时不牺牲性能,也无需您额外操作。它会持续监控您的数据使用情况,并在访问需求变化时将数据转移到最具成本效益的层级。
该单可用区存储类别专注于速度,为经常检索的数据和对延迟敏感的应用提供个位数毫秒级的访问。与 S3 Standard 相比,数据访问速度可提升至 10 倍,请求成本最高可降低 50%。
S3 Glacier 存储类别专为最低成本的数据归档而设计,提供高性能、灵活的检索选项以及几乎无限的可扩展性——并具备 99.999999999%(11 个 9)的耐久性。您可以根据需求和预算选择归档数据的访问速度。
S3 Glacier Instant Retrieval 是一种面向极少访问但仍需毫秒级取回的数据的归档存储类别。比如,如果您每三个月才查看一次数据,与 S3 Standard-Infrequent Access(S3 Standard-IA)相比,存储成本可节省高达 68%。在更低成本下,您仍可获得与 S3 Standard 或 S3 Standard-IA 相同的高吞吐与毫秒级访问体验。
如果追求绝对的最低成本,S3 Glacier Deep Archive 提供长期归档与数字保存,但通常需要数小时才能检索到您的数据。
Amazon S3 还提供运行于 AWS Dedicated Local Zones 的存储类别。这些区域是由 AWS 管理、但专为您或您的社区部署的特殊 AWS 基础设施,并可位于您选择的特定数据中心。这有助于满足监管要求,因为数据可以留存在您需要的地点。
此外,Outposts 上的 S3 提供一个名为 “OUTPOSTS” 的存储类别。它使用标准的 S3 API,并通过在您的 Outposts 上的多台设备与服务器之间保存副本来确保数据安全。
您可以设置生命周期策略来决定文件随时间推移的处理方式。比如,当数据变旧时,这些规则可以自动将对象转移到更便宜的存储类别,或在不再需要时直接删除。这样可以节省成本,让更昂贵的存储类别仅存放高优先级或高频访问的数据。
下面更详细地探讨 S3 的工作原理。
S3 基于分布式架构,在同一 AWS 区域内将您的数据复制到多个可用区(AZ)。这种架构可以防止某个可用区出现问题时导致数据丢失或不可用。正如这篇 ByteByteGo 博文所强调的,它也是 S3 能在全球范围内可靠存储数以百万亿计的对象的基础。归根结底,S3 的架构确保无论单个数据中心发生什么情况,您都能随时访问到您的文件。
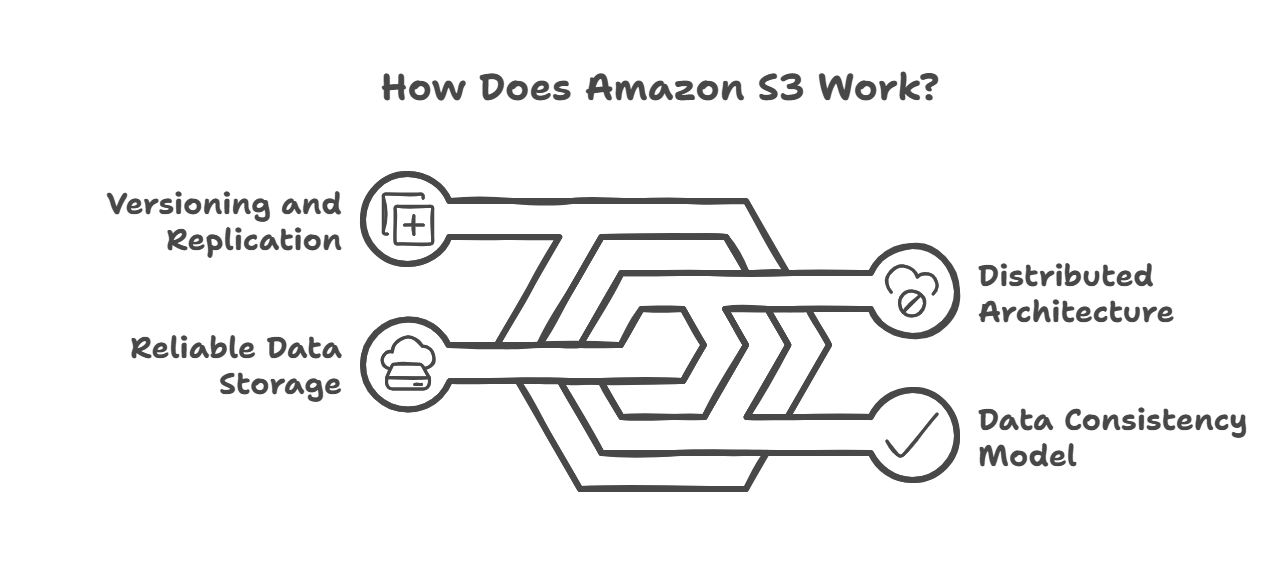
Amazon S3 如何工作?来源:Napkin AI 制图
借助强一致的读写(read-after-write)模型,一旦您在 S3 中上传或更新文件,便可立即访问到最新版本。这同样适用于删除和覆盖操作,因此无需等待或执行额外步骤来确保始终使用最新数据。
您还可以设置复制,将文件自动复制到同一区域的另一个存储桶(同区域复制,SRR)或不同区域的存储桶(跨区域复制,CRR),以增强保护并帮助满足监管要求。
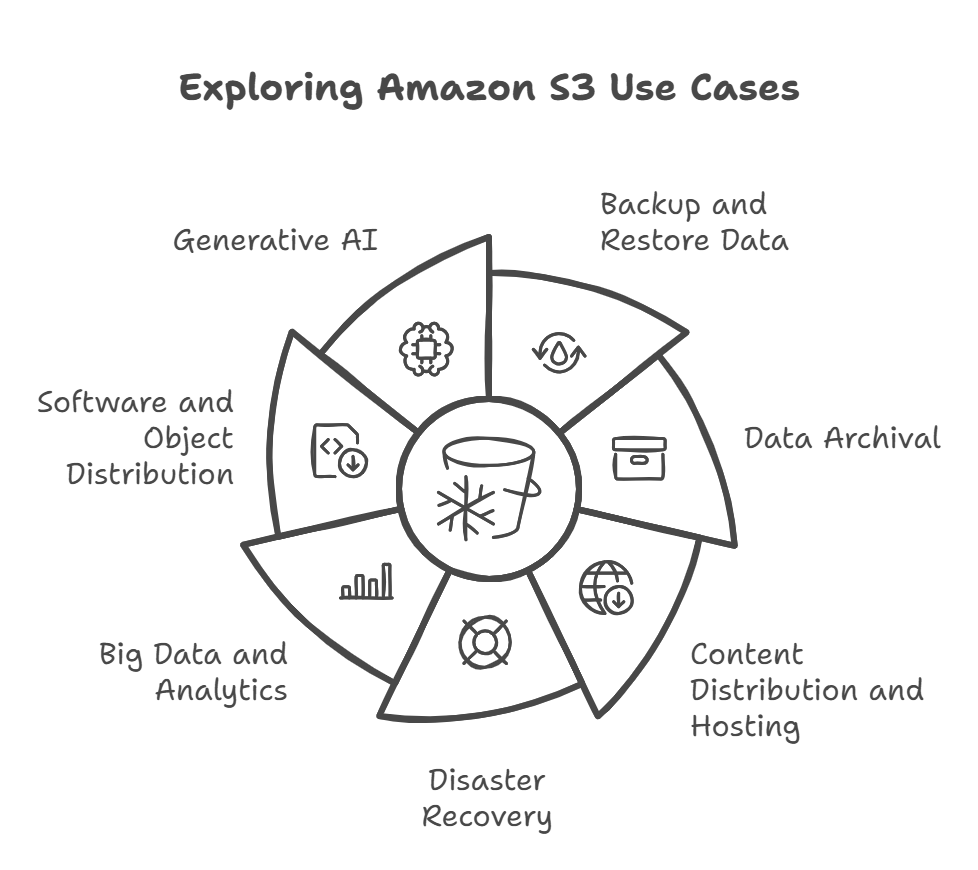
Amazon S3 的使用场景。来源:Napkin AI 制图
S3 Object Lambda 让您无需额外的服务器、代理或重复数据副本,就能为不同应用定制数据格式。其方式是使用 AWS Lambda 在从 S3 请求数据时自动进行修改。
其工作方式如下:
上手也很简单:
借助 S3 Object Lambda,您无需额外存储或复杂配置即可实时定制数据,从而让应用更高效、更灵活。
通过 Amazon S3 事件通知,您可以在 S3 存储桶中发生特定事件时,为 Lambda、SQS 或 SNS 等服务发送警报。要进行配置,只需添加通知配置,指定您要跟踪的事件以及通知的目标位置。该配置保存在存储桶的通知子资源中,并可通过 Amazon S3 API 轻松管理。
S3 Storage Lens、存储类别分析与清单报告等工具可帮助您了解存储使用与成本。S3 Storage Lens 提供组织范围的可视性,分析存储用量与趋势,并给出切实可行的数据安全与成本优化建议。它是首个为云存储提供跨多个账户统一视图的分析解决方案。
S3 Inventory(清单)会生成每日或每周的对象跟踪与管理报告,包含存储类别、加密和复制状态等元数据。这些报告有助于优化大数据工作流、安全审计与合规。
S3 存储类别分析通过跟踪访问模式,帮助您判断是否应将数据转移到更经济的存储类别。您可以使用 S3 Intelligent-Tiering(根据使用模式自动在访问层间转移数据)或 S3 生命周期规则来自动化这一过程。
安全与合规同样不容忽视:
借助 AWS 身份与访问管理(IAM)、存储桶策略、访问控制列表(ACL)以及访问点,您可以决定谁能访问您的数据,以及其可执行的操作。这在大型组织或共享环境中尤为实用。
Amazon S3 支持诸如 PCI DSS、HIPAA、FedRAMP 等主要合规标准,非常适合对数据安全与监管合规有严格要求的行业。
对于静态数据,您可以使用 AWS 托管密钥或客户托管密钥进行加密(SSE-S3、SSE-KMS)。对于传输中的数据,S3 通过 SSL/TLS 加密确保文件传输安全。遵循启用版本控制、使用 MFA-Delete 等最佳实践还能进一步增强数据保护策略。
凭借这些特性,Amazon S3 为各类规模的企业提供了安全、合规且灵活的存储方案。
Amazon S3 是当前功能强大且可靠的云存储解决方案之一。它具有良好的可扩展性与安全性,并配备丰富特性,既适合构建大型应用,也适合打造数据湖或备份重要文件。其灵活性与成本效益使其成为各种规模企业的理想选择。
随着 AWS 持续演进 S3 存储,新的功能与集成将进一步简化数据管理。例如,我们可以预见更多由 AI 驱动的数据洞察、更深入地与容器与无服务器技术集成,以及更多自动化合规的功能。如果您希望更深入学习 AWS 与云计算,欢迎查看 DataCamp 上的以下资源来提升技能:
在 DataCamp 上学习 AWS
课程
课程
实践并学习路径你的进步。
使用 Google 继续