另外,别错过我们的 Keras 速查表,通过代码示例展示用 Python 构建神经网络需要经历的六个步骤!
人工神经网络简介
在更深入地了解 Keras 以及如何用它在 Python 中开始深度学习之前,您需要先对神经网络有所了解。正如上一节简要提到的,神经网络汲取了生物学的灵感,“神经网络”一词也可用于指代神经元。人脑就是这样一种由众多神经元构成的神经网络的典型例子。
众所周知,大脑能够执行相当复杂的计算,这正是人工神经网络的灵感来源。整个网络是一个强大的建模工具。
感知机
最简单的神经网络是“感知机”,它在最简单的形式下仅由一个神经元构成。与拥有树突和轴突的生物神经元类似,单个人工神经元是一个简单的树状结构,具有多个输入节点和一个与每个输入节点相连的输出节点。下面是两者的直观对比:
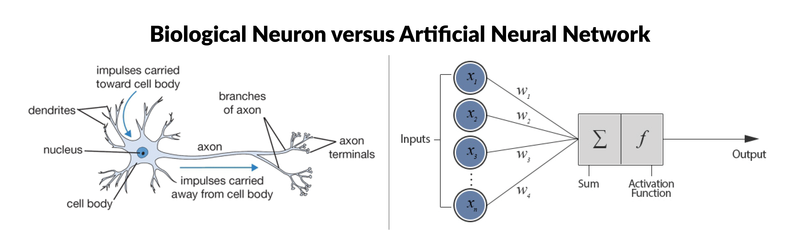
从图中可以看到,人工神经元包含六个组成部分。从左到右分别是:
- 输入节点。每个输入节点都关联一个数值,可以是任何实数。请记住,实数覆盖完整数轴:可以是正数或负数、整数或小数。
- 连接。与每个输入节点相连的边也带有一个权重,同样可以是任何实数。
- 接下来,将所有输入节点的数值与连接的权重汇总:它们作为加权求和的输入:\(y = f(\sum_{i=1}^{D} w_i*x_i)\),或换一种表述,\(y = f(w_1*x_1 + w_2*x_2 + ... w_D*x_D)\)。
- 该结果将作为传递或激活函数的输入。在最简单但也最平凡的情况下,传递函数就是恒等函数,\(f(x)=x\) 或 \(y=x\)。此时,\(x\) 即为输入节点与连接权重的加权和。然而,正如生物神经元只有在超过某个阈值时才会“触发”,人工神经元也只有当输入之和超过某一阈值(比如 0)时才会激活。这是恒等函数无法体现的!一种直观的方式是设计如下系统:
\(f(x) = 0\) 当 \(x<0\)
\(f(x) = 0.5\) 当 \(x=0\)
\(f(x) = 1\) 当 \(x>0\)
- 当然,您可以想象,这样的输出不会是一条平滑曲线:它是一个不连续函数。由于这会给数学处理带来问题,常用连续的变体——S 型函数(sigmoid)。您可能熟悉的一个例子是逻辑函数。使用它会得到更加平滑的结果!
- 最终得到输出节点,它与加权和经由某个函数(例如 sigmoid)的结果相关。请注意,sigmoid 是一种产生“S”形曲线的数学函数;后文会进一步介绍。
- 最后,感知机还可能包含一个附加参数,称为偏置。您可以将其视为与一个永久设为 1 的额外输入节点相关联的权重。偏置非常关键,因为它允许您将激活函数向左或向右平移,从而可能决定学习能否成功。
需要注意的是,该模型的逻辑结果是,感知机只能处理数值数据。这意味着您应将任何名义型数据转换为数值格式。
既然您已经知道感知机的工作依赖阈值,那么将其用于分类并不遥远:感知机可以设定,任何高于某一阈值的输出表示样本属于某一类,而低于阈值则属于另一类。输出等于阈值的直线便是两类之间的分界线。
多层感知机
由多个感知机构成的网络即多层感知机,这也是本教程将在 Keras 的帮助下用 Python 实现的!多层感知机也称为“前馈神经网络”。顾名思义,它比单一感知机更复杂,由多层神经元构成。层数通常在两到三层,但理论上没有上限!
各层的作用与上文中提到的生物神经元非常相似:一层的输出作为下一层的输入。
层之间可以区分为输入层、隐藏层和输出层。多层感知机通常是全连接的。这意味着某一层中的每个感知机都与下一层中的每个感知机相连。尽管全连接并非硬性要求,但这通常是默认情况。
请注意,单一感知机只能表示线性可分的分类边界,而多层感知机克服了这一限制,也能表示更复杂的决策边界。
用 Keras 在 Python 中预测葡萄酒类型
在本教程中,您将使用 UCI 机器学习库中的葡萄酒质量数据集。理想情况下,深度学习应该在更大的数据集上进行,但出于教程目的,这里使用一个较小的数据集。主要目的是帮助您上手该库,并熟悉神经网络的工作机制。
您可能已经接触过这个数据集,因为它是入门机器学习问题时最常用的数据集之一。在这里,它将帮助您用 Keras 在 Python 中开始深度学习之旅。
现在就开始吧!
理解数据
不过在加载数据之前,先检验一下自己对葡萄酒(当然是与数据集相关的)了解多少。大多数人都知道,通常有两种非常受欢迎的葡萄酒类型:红葡萄酒和白葡萄酒。
(当然还有很多其他类型,但为简单起见,也基于我对葡萄酒所知有限,暂且只谈这两类。如果让资深爱好者失望了,抱歉 :))。
知道这些只是第一步,如果您想分析这份数据,还需要再多了解一点。
首先,查看数据说明文档,了解包含了哪些变量。这通常是理解数据的第一步。访问此页面查看说明,或继续阅读以更好地认识数据。
该数据包含与葡萄牙“Vinho Verde”葡萄酒的红、白两个品种相关的两个数据集。正如说明中所述,数据集中仅包含理化与感官变量。数据说明文件列出了 12 个变量。对于像我一样并不精通化学的朋友,以下是每个变量的简要说明:
- 固定酸度:酸是葡萄酒的重要属性,对口感影响很大。通常总酸度分为两类:挥发酸和不挥发(固定)酸。葡萄酒中的固定酸包括酒石酸、苹果酸、柠檬酸和丁二酸。该变量在数据集中以 g(\(tartaric acid\))/\(dm^3\) 表示。
- 挥发酸度:挥发酸度本质上是葡萄酒转化为醋的过程。在美国,法定挥发酸度上限是红葡萄酒 1.2 g/L、白葡萄酒 1.1 g/L。在数据集中,以 g(\(acetic acid\))/\(dm^3\) 表示。
- 柠檬酸是葡萄酒中的固定酸之一。在两个数据集中均以 g/\(dm^3\) 表示。
- 残糖通常指发酵自然停止或被人为停止后残留的糖分。在
red 与 white 数据中以 g/\(dm^3\) 表示。
- 氯化物会显著影响葡萄酒的咸味。此处以 g(\(sodium chloride\))/\(dm^3\) 表示。
- 游离二氧化硫:加入葡萄酒的二氧化硫中,失活的部分称为结合态,仍具有活性的部分称为游离态。酿酒师总是试图让游离二氧化硫的比例尽可能高。该变量以 mg/\(dm^3\) 表示。
- 总二氧化硫是结合态与游离态二氧化硫(SO2)之和。此处以 mg/\(dm^3\) 表示。不同地区对葡萄酒中硫含量有法定限制:欧盟规定红葡萄酒最高 160mg/L,白葡萄酒与桃红约 210mg/L,甜酒可达 400mg/L。美国为 350mg/L,澳大利亚为 250mg/L。
- 密度一般用于衡量糖分转化为酒精的程度。这里以 g/\(cm^3\) 表示。
- pH(氢离子浓度)是表征溶液酸碱度的数值标度。pH 小于 7 的为酸性,大于 7 的为碱性。pH 为 7 的纯水为中性。大多数葡萄酒的 pH 在 2.9 到 3.9 之间,因此呈酸性。
- 硫酸盐之于葡萄酒,正如面筋之于食品。您可能听说过亚硫酸盐会引发头痛。它们在全球酿酒中十分常见且被认为是必要的。本变量以 g(\(potassium sulphate\))/\(dm^3\) 表示。
- 酒精:葡萄酒是含酒精的饮料,不同葡萄酒的酒精含量不同。数据集中自然会包含该变量,并以体积分数 % 表示。
- 质量:葡萄酒专家对酒的质量从 0(极差)到 10(极优)进行评分。最终分数是至少三位专家评价的中位数。
以上是上手前需要了解的一些基础信息。如果您是真正的葡萄酒鉴赏家,这些想必早已烂熟于心!
现在,是时候获取数据了!
加载数据
这一步可以用 Python 的数据处理库 Pandas 轻松完成。遵循常见的导入约定,将其以 pd 作为别名导入。
接着,使用 read_csv() 函数读取存储数据的 CSV 文件。此外,使用 sep 参数指定分隔符为分号,而非常规逗号。
在下方的 DataCamp Light 模块中试试吧:
# Import pandas
import pandas as pd

# Read in white wine data
white = ___________("http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-white.csv", sep=';')

# Read in red wine data
red = ___________("http://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv", sep=';')
太棒了!是不是很简单?
您可能已经做过很多次了,但它始终是开始工作的关键一步。现在,您已经完全准备好探索、处理并建模数据!
数据探索
手握数据,了解这些葡萄酒就变得轻而易举!您可能首先会想对两个 DataFrame 有个快速概览:
# Print info on white wine
_____(white.____())

# Print info on red wine
_____(red.____())
现在是检查导入是否成功的时刻:再次确认数据是否包含了 UCI 机器学习库数据说明文件中承诺的所有变量。除了变量数量,也要检查导入质量:数据类型是否正确?所有行是否都导入了?是否存在需要在数据清洗时考虑的空值?
您可能还希望用不止 info() 来查看数据:
# First rows of `red`
red.____()

# Last rows of `white`
white.____()

# Take a sample of 5 rows of `red`
red.______(5)

# Describe `white`
white.________()

# Double check for null values in `red`
pd.isnull(red)
快速回顾这些 pandas 函数:head()、tail() 与 sample() 能在无额外负担的情况下为您提供快速数据检查。
接着,describe() 提供数据的汇总统计,帮助您评估数据质量。您会看到有些变量的 min 与 max 差异很大。这是后续要处理的内容,但此刻先有此意识即可。
最后,您借助 isnull() 再次检查了 red 中是否存在空值。当在阅读 info() 的结果后仍存疑时,这个函数总是很有用。
提示:也检查一下白葡萄酒数据是否包含空值。您可以使用上方 DataCamp Light 模块的 IPython shell 来完成。
既然您已经检查了数据导入是否成功与正确,是时候更深入地了解了。
数据可视化
一种做法是查看数据集中某些变量的分布,并绘制散点图观察可能的相关性。当然,如果这是您的项目,您完全可以做得更深入更系统。
酒精含量
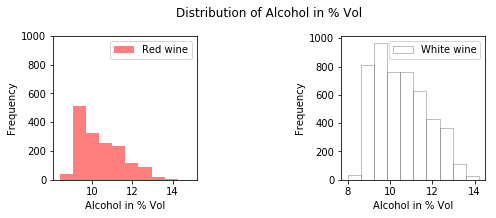
首先看起来就很有意思的变量是 alcohol。在查看葡萄酒数据集时,它大概会首先吸引您的注意。您可以使用任意数据可视化库绘制分布,此处教程使用 matplotlib 快速绘图:
import matplotlib.pyplot as plt

fig, ax = plt.subplots(1, 2)

ax[0].hist(red.alcohol, 10, facecolor='red', alpha=0.5, label="Red wine")
ax[1].hist(white.alcohol, 10, facecolor='white', ec="black", lw=0.5, alpha=0.5, label="White wine")

fig.subplots_adjust(left=0, right=1, bottom=0, top=0.5, hspace=0.05, wspace=1)
ax[0].set_ylim([0, 1000])
ax[0].set_xlabel("Alcohol in % Vol")
ax[0].set_ylabel("Frequency")
ax[1].set_xlabel("Alcohol in % Vol")
ax[1].set_ylabel("Frequency")
#ax[0].legend(loc='best')
#ax[1].legend(loc='best')
fig.suptitle("Distribution of Alcohol in % Vol")

plt.show()
如下图所示,红、白葡萄酒的酒精含量大体相同:大约在 9% 左右。当然,也有相当数量的观测落在 10% 或 11%。
注意,您也可以使用 numpy 包中的 histogram() 函数来计算 white 与 red 的直方图以进行复核,如下:
import numpy as np
print(np.histogram(red.alcohol, bins=[7,8,9,10,11,12,13,14,15]))
print(np.histogram(white.alcohol, bins=[7,8,9,10,11,12,13,14,15]))
如果您对 matplotlib 教程感兴趣,务必查看 DataCamp 的 Matplotlib 初学者教程,以及 三维体数据可视化教程,后者展示了如何使用 Matplotlib 的事件处理 API。
硫酸盐
接下来,我关心的一件事是硫酸盐与葡萄酒质量之间的关系。正如您上文所读,硫酸盐可能会使人头痛,我想知道这是否会影响葡萄酒的质量。更进一步,我常听说女性尤其不想喝葡萄酒,正是因为会头痛。也许这影响了红葡萄酒的评分?
来看看吧。
import matplotlib.pyplot as plt

fig, ax = plt.subplots(1, 2, figsize=(8, 4))

ax[0].scatter(red['quality'], red["sulphates"], color="red")
ax[1].scatter(white['quality'], white['sulphates'], color="white", edgecolors="black", lw=0.5)

ax[0].set_title("Red Wine")
ax[1].set_title("White Wine")
ax[0].set_xlabel("Quality")
ax[1].set_xlabel("Quality")
ax[0].set_ylabel("Sulphates")
ax[1].set_ylabel("Sulphates")
ax[0].set_xlim([0,10])
ax[1].set_xlim([0,10])
ax[0].set_ylim([0,2.5])
ax[1].set_ylim([0,2.5])
fig.subplots_adjust(wspace=0.5)
fig.suptitle("Wine Quality by Amount of Sulphates")

plt.show()
如下图所示,红葡萄酒的硫酸盐含量似乎高于白葡萄酒;白葡萄酒中高于 1 g/\(dm^3\) 的情况更少。对白葡萄酒而言,似乎只有少数样本略高于 1 g/\(dm^3\),而红葡萄酒明显更多。这或许能解释“红酒容易引发头痛”的常见说法,但质量方面呢?
您可以清楚地看到,有白葡萄酒在硫酸盐含量相对较低的情况下也获得了 9 分,但除此之外,此时很难对数据作出准确解读。
当然,还要考虑到观测数差异也可能影响图形及其解读。

酸度
除硫酸盐外,酸度是实现高品质葡萄酒的重要且关键的特性之一。优秀的葡萄酒常在酸度、单宁、酒精与甜度之间达到平衡。进一步查阅可知,当挥发酸度在 0.2 到 0.4 g/L 之间时,不会影响葡萄酒质量;但在较高水平时,挥发酸会带来刺激性、似醋的口感。极高的挥发酸度意味着葡萄酒存在严重缺陷。
让我们用数据来检验,绘制酒精含量与挥发酸度的散点图。数据点应按其评分或 quality 标签着色:
import matplotlib.pyplot as plt
import numpy as np

np.random.seed(570)

redlabels = np.unique(red['quality'])
whitelabels = np.unique(white['quality'])

import matplotlib.pyplot as plt
fig, ax = plt.subplots(1, 2, figsize=(8, 4))
redcolors = np.random.rand(6,4)
whitecolors = np.append(redcolors, np.random.rand(1,4), axis=0)

for i in range(len(redcolors)):
    redy = red['alcohol'][red.quality == redlabels[i]]
    redx = red['volatile acidity'][red.quality == redlabels[i]]
    ax[0].scatter(redx, redy, c=redcolors[i])
for i in range(len(whitecolors)):
    whitey = white['alcohol'][white.quality == whitelabels[i]]
    whitex = white['volatile acidity'][white.quality == whitelabels[i]]
    ax[1].scatter(whitex, whitey, c=whitecolors[i])

ax[0].set_title("Red Wine")
ax[1].set_title("White Wine")
ax[0].set_xlim([0,1.7])
ax[1].set_xlim([0,1.7])
ax[0].set_ylim([5,15.5])
ax[1].set_ylim([5,15.5])
ax[0].set_xlabel("Volatile Acidity")
ax[0].set_ylabel("Alcohol")
ax[1].set_xlabel("Volatile Acidity")
ax[1].set_ylabel("Alcohol")
#ax[0].legend(redlabels, loc='best', bbox_to_anchor=(1.3, 1))
ax[1].legend(whitelabels, loc='best', bbox_to_anchor=(1.3, 1))
#fig.suptitle("Alcohol - Volatile Acidity")
fig.subplots_adjust(top=0.85, wspace=0.7)

plt.show()
请注意,此图的颜色是借助 NumPy 的 random 模块随机生成的。您可以通过向 redcolors 或 whitecolors 变量传入列表来更改。请确保两者一致(白葡萄酒数据的 quality 唯一值比红葡萄酒多一个,除外),否则图例将无法对应!
在这里查看完整图表:
在上图中,您看到前文提到的水平尤其适用于白葡萄酒:大多数标签为 8 的葡萄酒,其挥发酸度在 0.5 或以下,但是否影响质量仍难定论,因为所有数据点都密集分布在图的一侧。
这只是一次快速的数据探索。如果您想在自己的项目中深入开展这一步,建议阅读 DataCamp 的数据探索文章,如 Python 探索性数据分析 和 Python 数据剖析 教程,它们将带您了解 EDA 的基础。
小结:探索性数据分析
信息量可能有些大,不妨简单回顾一下 EDA 中与后续教程相关的重要发现:
- 数据集中某些变量的数值差异很大。您将在下一节处理中解决。
- 这是理想情况:数据集中不存在空值。
- 数据集中大多数葡萄酒的酒精含量约为 9%。
- 红葡萄酒的硫酸盐似乎多于白葡萄酒,后者在 1 g/\(dm^3\) 以上的更少。
- 多数葡萄酒的挥发酸度在 0.5 及以下。目前尚无法直接关联到葡萄酒质量。
到目前为止,您分别查看了白葡萄酒与红葡萄酒数据。在近距离观察某些变量时,两者似乎有所不同;而在另外一些情况下,两者又相当相似。您觉得是否可以基于变量将样本分类为白葡萄酒或红葡萄酒?
只有一个办法找出答案:对数据进行预处理并建模,看看会发生什么!
数据预处理
既然已探索了数据,现在就根据得到的洞见采取行动吧!让我们预处理数据,以便开始构建您自己的神经网络!
# Add `type` column to `red` with value 1
___['type'] = 1

# Add `type` column to `white` with value 0
_____['type'] = 0

# Append `white` to `red`
wines = red.______(white, ignore_index=True)
此处将 ignore_index 设为 True,是因为在将 white 追加到 red 后,您不想保留 white 的索引标签:希望索引能从 red 的末尾连续延伸,而不是因合并两个数据集而出现重复索引。
插曲:相关系数矩阵
现在您已有完整数据集,重新做个快速探索是个好主意;您已经分别查看过两个数据集,此时或许可以得到更扎实的洞见。
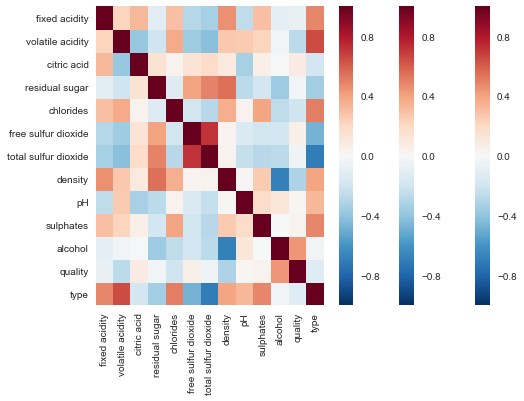
由于图形有时不易解读,绘制相关矩阵也是不错的选择。它能更快速地给出变量之间的相关性:
import seaborn as sns
corr = wines.corr()
sns.heatmap(corr,
            xticklabels=corr.columns.values,
            yticklabels=corr.columns.values)
sns.plt.show()
不出所料,有些变量确实相关,比如 density 与 residual sugar。volatile acidity 与 type 的相关性也比单看两个数据集时预想的更强;另外,free sulfur dioxide 与 total sulfur dioxide 的相关性也在意料之中。
很有意思!
训练集与测试集
数据不平衡通常指分类问题中各类别样本数量不均。大多数分类数据集并不会恰好做到各类样本数相等,但小的差异往往影响不大。因此,您需要确保训练集中同时包含两类葡萄酒,而且两类样本数量大致相当,以免在预测中偏向某一类。
在本例中似乎存在不平衡,但暂且按现状进行。之后您可以评估模型,如果表现欠佳,再通过欠采样或过采样来弥补观测数差异。
现在,从 sklearn.model_selection 导入 train_test_split,并将数据与目标标签分别赋给 X 与 y。您会看到需要将目标标签数组展平,才能将 X 与 y 作为 train_test_split() 的输入。开始动手吧,在下方 DataCamp Light 模块中试试!
# Import `train_test_split` from `sklearn.model_selection`
from sklearn.model_selection import train_test_split

# Specify the data
X=wines.ix[:,0:11]

# Specify the target labels and flatten the array
y=np.ravel(wines.type)

# Split the data up in train and test sets
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.33, random_state=42)
您已经离第一个神经网络很近了,但还有一件事需要处理!还记得在查看 white 与 red 数据集的汇总时发现了什么吗?
没错,有些数值差异很大。在这里进行标准化是合理的。
数据标准化
标准化是处理数值差异过大的方法之一。scikit-learn 提供了快速便捷的标准化方式:从 sklearn.preprocessing 导入 StandardScaler,即可对训练集与测试集进行缩放!
from sklearn.preprocessing import StandardScaler
scaler = StandardScaler().fit(X_train)
X_train = scaler.transform(X_train)
X_test = scaler.transform(X_test)技术支持
现在数据已预处理,可以进入“正题”:构建用于分类葡萄酒的神经网络。
数据建模
在开始建模之前,回到最初的问题:能否通过挥发酸度或硫酸盐等化学性质预测一款葡萄酒是红的还是白的?
由于只有两类,即白与红,您将进行二分类。顾名思义,“二元”即 0 或 1、是或否。由于神经网络只能处理数值,您已经将红编码为 1,将白编码为 0。
在这种问题上表现良好的网络是多层感知机。正如教程开头所述,此类神经网络通常为全连接。这意味着,您将构建一个由全连接层构成的相对简单的堆叠来解决问题。至于激活函数,为了熟悉 Keras 与神经网络,最常用且合适的选择之一是 ReLU。
那么如何开始构建多层感知机?快速入门的方式是使用 Keras 的 Sequential 模型:它是线性堆叠的层。您可以通过向构造函数传入层实例列表来轻松创建模型,也可以先运行 model = Sequential(),再逐层添加。
接下来,不妨回想一下多层感知机的结构:输入层、若干隐藏层与输出层。在构建模型时,务必确保第一层明确输入形状。模型需要知道期望的输入形状,因此您会在层的文档与示例中看到 input_shape、input_dim、input_length 或 batch_size 等参数。
在本例中,您将使用 Dense 层,即全连接层。Dense 层实现以下操作:output = activation(dot(input, kernel) + bias)。注意,没有激活函数的话,Dense 层只包含两个线性操作:点积与加法。
在第一层中,activation 参数取值为 relu。另外,您也看到定义了 input_shape。这是您刚才看到的操作的 input:模型接收形状为 (12,) 或 (*, 12) 的输入数组。最后,您会看到第一层在 Dense() 的 units 参数中取值 12,即输出空间的维度,实际是 12 个隐藏单元。这意味着模型将输出形状为 (*, 12) 的数组:这就是输出空间的维度。如果现在还没完全理解,别担心,后文还有更多说明!
units 实际上对应上述公式中的 kernel,即该层创建的权重矩阵,由赋予所有输入节点的权重构成。请注意,下例中未包含偏置,因为没有显式加入 use_bias 参数并将其设为 TRUE(这也是可选项)。
中间层同样使用 relu 激活函数。该层的输出形状为 (*,8)。
网络以一个大小为 1 的 Dense 层结尾。最后一层使用 sigmoid 激活函数,使输出成为概率;也就是说,得到介于 0 与 1 之间的分数,表示样本为目标“1”的可能性,即葡萄酒为红的可能性。
# Import `Sequential` from `keras.models`
from keras.models import Sequential

# Import `Dense` from `keras.layers`
from keras.layers import Dense

# Initialize the constructor
model = Sequential()

# Add an input layer
model.add(Dense(12, activation='relu', input_shape=(11,)))

# Add one hidden layer
model.add(Dense(8, activation='relu'))

# Add an output layer
model.add(Dense(1, activation='sigmoid'))
总之,构建模型的两个核心架构决策是:使用多少层,以及每层选择多少“隐藏单元”。
此处,您为模型的第一层选择了 12 个隐藏单元:如前所述,这是输出空间的维度。换言之,您在设定网络在学习表示时的自由度。如果允许更多隐藏单元,网络将能学习到更复杂的表示,但计算代价更高,也更容易过拟合。
请记住,过拟合发生在模型过于复杂时:它会拟合到随机误差或噪声,而非需要刻画的潜在关系。换言之,就是把训练数据“学得过好”!
注意,当可用训练数据较少时,宜使用较小的网络,隐藏层非常少(通常只有一层,就像上例)。
若想查看刚创建的模型信息,可以使用属性 output_shape 或 summary() 函数等。下面列出了一些最基础的调用。
运行它们看看会返回什么,以及它们对模型的说明:
# Model output shape
model.___________

# Model summary
model.__________

# Model config
model.get_config()

# List all weight tensors
model.get_weights()
编译与拟合
接下来编译模型并将其拟合到数据:同样使用 compile() 与 fit() 完成此事。
model.compile(loss='binary_crossentropy',
              optimizer='adam',
              metrics=['accuracy'])

model.fit(X_train, y_train,epochs=20, batch_size=1, verbose=1)技术支持
在编译时,您使用 adam 优化器与 binary_crossentropy 损失函数。此外,通过向 metrics 传入 ['accuracy'],可在训练期间监控准确率。
optimizer 与 loss 是编译模型所需的两个参数。常用的优化算法包括随机梯度下降(SGD)、ADAM 与 RMSprop。根据所选算法,您需要调节某些参数,如学习率或动量。损失函数的选择取决于任务:例如回归问题通常使用均方误差(MSE)。如本例所示,您在“红或白”的二分类问题中使用 binary_crossentropy。对于多分类问题,则使用 categorical_crossentropy。
之后,您可以以 1 的 batch 大小,训练模型 20 个 epoch(对 X_train 与 y_train 的全量样本迭代 20 次)。您也可以设置 verbose 参数。设为 1 表示显示进度条日志。
换言之,您需要在指定的 epoch 数上训练模型,即对训练集进行若干次完整遍历,随后在验证集上测试。上面的 batch 大小定义了每次传播通过网络的样本数。这样做还能优化效率,避免一次性将过多输入模式加载到内存中。
预测数值
让我们开始使用模型!您可以用它对测试集的标签进行预测。只需调用 predict(),并传入测试集以预测标签。本例将结果保存在 y_pred 中:
y_pred = model.predict(X_test)技术支持
在评估模型之前,您可以先快速对准确率有个直观了解,看看 y_pred 与 y_test 的对比:
y_pred[:5]技术支持
array([[0],
       [1],
       [0],
       [0],
       [0]], dtype=int32)技术支持
y_test[:5]技术支持
array([0, 1, 0, 0, 0])技术支持
看起来这些值对得上,但没有“硬指标”,一切都是空谈。
评估模型
现在,您已经构建了模型,并将其用于预测未见过的数据,是时候评估其性能了。您可以直观比较预测与实际测试标签(y_test),也可以使用多种指标来衡量实际表现。本例将使用 evaluate()。传入测试数据与测试标签,若需要可将 verbose 设为 1,这样会显示更多日志。
score = model.evaluate(X_test, y_test,verbose=1)

print(score)技术支持
[0.025217213829228164, 0.99487179487179489]技术支持
score 是一个列表,包含损失与准确率的组合。本例中两者都非常好,但请记得数据有些不平衡:白葡萄酒样本多于红葡萄酒样本。准确率可能只是在反映类别分布,因为模型可能会大量预测为 white,毕竟这类样本极为常见!
在重新组织数据之前,先尝试不同的评估指标通常是个好主意。为此,您可以像在拆分训练/测试集时那样,依赖 scikit-learn(以 sklearn 导入)。
本例将尝试一些基础的分类评估技术,例如:
- 混淆矩阵:将预测分解为表格,显示正确预测与各种错误类型。理想情况下,仅对角线有数字,代表所有预测都正确!
- 精确率(Precision):衡量分类器的“准确性”。越高越好。
- 召回率(Recall):衡量分类器的“完整性”。越高越好。
- F1 分数:精确率与召回率的加权平均。
- Kappa(Cohen’s kappa):按类别不平衡进行归一化的分类准确率。
from sklearn.metrics import confusion_matrix, precision_score, recall_score, f1_score, cohen_kappa_score
confusion_matrix(y_test, y_pred)技术支持
array([[1585,    3],
       [   8,  549]])技术支持
precision_score(y_test, y_pred)技术支持
0.994565217391技术支持
recall_score(y_test, y_pred)技术支持
0.98563734290843807技术支持
f1_score(y_test,y_pred)技术支持
0.99008115419296661技术支持
cohen_kappa_score(y_test, y_pred)技术支持
0.98662321692498967技术支持
这些分数都非常好!尽管白葡萄酒样本显著更多,您依然构建了一个相当准确的模型。
干得漂亮!
更多实验
您已成功构建了第一个模型,但还可以做得更多。不妨尝试以下调整,看看效果如何?正如上文所述,两个关键的架构决策涉及层数与隐藏节点数。这些都是很好的起点:
- 您使用了 1 个隐藏层。试试改为 2 或 3 个隐藏层;
- 使用更多或更少隐藏单元的层;
- 将
quality 列作为目标标签,其余数据(包括已编码的 type 列!)作为输入数据。您现在将面对一个多分类问题!
此外,为什么不尝试更换激活函数呢?把 relu 换成 tanh,看看会有什么不同!
预测葡萄酒质量
您的分类模型在首次运行就表现出色!
但除了更上一层楼、尝试比多层感知机更复杂的结构之外,还有很多事情可以做。为什么不尝试构建一个预测葡萄酒质量的神经网络呢?
在这里,教程假设 quality 是一个连续变量:任务不再是二分类,而是序数回归。这是一种用于预测有序变量的回归:quality 的取值位于一个任意刻度上,不同 quality 值之间的相对顺序是有意义的。在该刻度上,从“很差”到“很棒”的 0-10 质量刻度就是一个例子。
请注意,您也可以将此类问题视为分类问题,把质量标签当作固定类别标签。
无论如何,这种设置意味着在本教程第二部分中,目标标签将是 red 与 white DataFrame 中的 quality 列。这需要做一些额外预处理。
数据预处理
由于 quality 变量成为目标类别,您需要将质量标签与其余数据分离。将 wines.quality 放入变量 y,并将除 quality 列外的葡萄酒数据放入变量 x。
接下来,您就可以将数据划分为训练集和测试集,不过本例不采用这种方式(当然也可以!)。在本教程的第二部分,您将使用 K 折验证,需要将数据分为 K 个子集。通常 K 取 4 或 5。然后实例化相同的模型,分别在每个子集上进行训练,并在剩余子集上评估。模型的验证分数即为 K 次验证分数的平均值。
稍后您将看到如何实现。现在先像之前那样使用 StandardScaler 确保数据在拟合模型前处于良好状态。
# Isolate target labels
y = wines.________

# Isolate data
X = wines.drop('quality', axis=_)
请记得,由于 red、white(因此 wines)数据中某些数值差异较大,您也需要再次进行缩放。
在下方 DataCamp Light 模块中试一试吧。所有必要的库都已为您加载!
# Scale the data with `StandardScaler`
X = ________________.fit_transform(X)
现在您又回到了之前的节点——可以再次开始构建神经网络了!
设计神经网络架构
既然再次完成了预处理,是时候再构建一个多层感知机模型了。尽管这一次用于回归任务,架构看起来仍然很相似,使用两个 Dense 层即可。
别忘了第一层是输入层。您需要向其传入输入数据的形状。在此例中,您将使用 input_dim 向 Dense 层传递输入数据的维度。
# Import `Sequential` from `keras.models`
from keras.models import Sequential

# Import `Dense` from `keras.layers`
from keras.layers import Dense

# Initialize the model
model = Sequential()

# Add input layer
model.add(Dense(64, input_dim=12, activation='relu'))

# Add output layer
model.add(Dense(1))
再次注意,您定义的第一层是输入层。该层需要知道数据的输入维度。在本例中,您传入的输入维度为 12(别忘了还包括教程第一部分中生成的 Type 列!)。您再次使用 relu 激活函数,且同样未包含偏置。隐藏单元数为 64。
您的网络以一个单元的 Dense(1) 结尾,且未包含激活。这是标量回归的典型设置,即尝试预测一个连续数值。
编译模型并拟合数据
有了模型,您就可以再次编译并拟合数据。但等等。是不是需要前面提到的 K 折验证划分?没错。
import numpy as np
from sklearn.model_selection import StratifiedKFold

seed = 7
np.random.seed(seed)

kfold = StratifiedKFold(n_splits=5, shuffle=True, random_state=seed)
for train, test in kfold.split(X, Y):
    model = Sequential()
    model.add(Dense(64, input_dim=12, activation='relu'))
    model.add(Dense(1))
    model.compile(optimizer='rmsprop', loss='mse', metrics=['mae'])
    model.fit(X[train], Y[train], epochs=10, verbose=1)技术支持
使用 compile() 函数编译模型,然后用 fit() 将数据拟合到模型。编译模型时,再次确保至少定义 optimizer 与 loss。本例可使用常见的优化算法 rsmprop,损失函数 mse 则是回归问题的典型选择。
额外的 metrics 参数用于衡量模型性能。对于回归问题,常用指标是平均绝对误差(MAE)。下一节会进一步介绍。
向 fit() 传入训练数据与标签,设定运行的 epoch 数、batch 大小,并可将 verbose 设为 1 以获得更多日志,因为训练可能需要一些时间。
评估模型
与之前一样,您也应评估模型。除了在上述代码中加入 y_pred = model.predict(X[test]) 外,使用 sklearn 的一些评估指标(就像教程第一部分那样)也是个好主意。
您可以使用均方误差(MSE)与平均绝对误差(MAE)。前者又称“均方偏差”(MSD),测量误差或偏差平方的平均值。换言之,它量化估计量与被估计对象之间的差异。这样,您可以进一步了解估计量的质量:它总是非负,越接近 0 越好。
后者 MAE 指标衡量预测与真实结果的接近程度。
将以下代码添加到上一段代码中,注意缩进:
mse_value, mae_value = model.evaluate(X[test], Y[test], verbose=0)

print(mse_value)
0.522478731072
print(mae_value)
0.561965950103技术支持
注意,除了 MSE 与 MAE,您还可以使用 R2 分数(回归评分函数)。该分数的最佳值是 1.0,但也可能为负!
from sklearn.metrics import r2_score

r2_score(Y[test], y_pred)
0.3125092543技术支持
乍看之下,这些数值不太理想,对吧?好消息是,您现在可以尝试优化代码,从而获得更好的结果。
这正是下一节、也是最后一节的内容!
模型微调
微调模型可能会是您的常态,因为并非所有问题都像教程第一部分那样直截了当。正如上文所述,您很可能会调整两个关键决策:使用多少层,以及每层选择多少“隐藏单元”。
在开始阶段,这确实是一段探索之旅。
添加层
如果在模型中再添加一层,会发生什么?比如这样:
model = Sequential()
model.add(Dense(64, input_dim=12, activation='relu'))
model.add(Dense(64, activation='relu'))
model.add(Dense(1))技术支持
隐藏单元
也试试在架构中增加隐藏单元数量,对比评估结果,例如:
model = Sequential()
model.add(Dense(128, input_dim=12, activation='relu'))
model.add(Dense(1))技术支持
再次提醒,一般而言,由于数据量并不大,过拟合可能且很可能会更严重。这就是为什么您应该使用较小的网络。
更多实验:优化器参数
除了添加层与调整隐藏单元,您还可以尝试调整传给 compile() 的优化算法的(部分)参数。到目前为止,您一直向 optimizer 参数传入字符串,如 rmsprop。
但并不总是非此不可!
例如,尝试从 keras.models 导入 RMSprop 并调整学习率 lr。您也可以更改 RMSprop() 其他参数的默认值,但不建议这么做。更多信息见此处。
from keras.optimizers import RMSprop
rmsprop = RMSprop(lr=0.0001)
model.compile(optimizer=rmsprop, loss='mse', metrics=['mae'])技术支持
也可以尝试其他优化算法,例如随机梯度下降(SGD)。您是否注意到差异?
from keras.optimizers import SGD, RMSprop
sgd=SGD(lr=0.1)
model.compile(optimizer=sgd, loss='mse', metrics=['mae'])技术支持
继续深入!
本教程只是您使用 Python 与 Keras 开启深度学习之旅的起点。还有很多内容值得学习,不妨参加 DataCamp 的 Deep Learning in Python 课程?与此同时,如果还没有阅读,务必查看 Keras 文档。您将会发现更多示例、各函数与参数的说明、更多层类型等。在学习如何用 Python 构建神经网络时,它无疑是不可或缺的资源!如果您更愿意读一本系统讲解深度学习(及其在 Keras 中的应用)基础与实践的书,强烈推荐 François Chollet 的 Deep Learning in Python。


到现在为止,您可能已经了解了机器学习——计算机科学的一个分支,研究能自主学习的算法的设计。今天,您将聚焦于深度学习,这是机器学习的一个子领域,指一组受大脑结构与功能启发的算法,通常被称为人工神经网络(ANN)。深度学习是数据科学中最炙手可热的领域之一,在机器人、图像识别与人工智能(AI)等方面有众多案例并取得了惊人的成果。
用于开发与评估深度学习模型的 Python 库中,Keras 功能强大且易于使用;它封装了高效的数值计算库 Theano 与 TensorFlow。其优势在于,您可以以一种简单有趣的方式开始学习神经网络。
本篇面向初学者的 Keras 教程将带您了解 Python 深度学习基础: