docker pull 命令本身不难理解,但底层发生的一切,哪怕是经验老道的专家也未必都清楚。
每位开发者都应该了解它。您几乎每天都会拉取镜像,但一旦出问题,往往很难定位原因。可能是无缘无故地认证失败、被速率限制拦下,或者线上跑着错误的镜像版本。每次失败都要花时间去修复,而这些本不该发生。
弄清 docker pull 的实际工作机制,能让您掌控全局。您会知道镜像从哪里来、如何拉取,以及如何在问题影响生产前进行排查。
本文将解释镜像拉取的底层原理、镜像仓库的作用,以及如何在本地开发与生产环境中拉取镜像。
如果您完全是 Docker 新手,强烈建议先学习我们的 Introduction to Docker 课程,它将覆盖理解本文所需的基础知识。
docker pull 的底层工作原理
本节将介绍 docker pull 的工作机制,消除对幕后流程的困惑。
执行 docker pull 时发生了什么
基本语法很简单:
docker pull python:3.14.2-bookworm技术支持
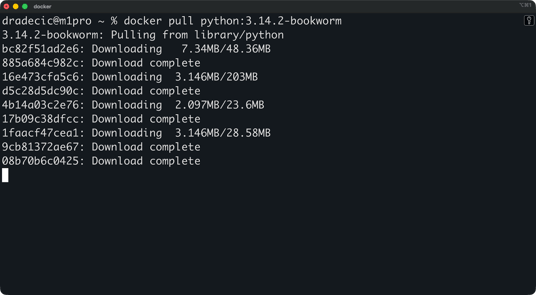
该命令默认与 Docker Hub 通信,下载 Python 镜像并存储在本机。但背后还有更多细节。
流程如下:
当您未指定版本时,Docker 会默认使用 :latest 标签。直接运行 docker pull python,得到的就是 python:latest。这看似方便,却存在风险。:latest 并不意味着“最新稳定版”,而是“镜像维护者标记为 latest 的那个版本”。它可能在不同时间的拉取之间发生变化,从而在毫无预警的情况下破坏您的构建。
镜像层与内容可寻址存储
Docker 镜像由多层构建而成。
每一层都代表相对于上一层的更改。在构建镜像时,Dockerfile 中的每条 RUN、COPY 或 ADD 指令都会创建一个新层。最终镜像是按顺序叠加这些层的结果。
例如,看看上文所用 Python 3.14 镜像 背后的命令——内容相当丰富。
内容可寻址存储 是实现这一切的关键。每一层都会基于其内容生成唯一哈希。如果两个镜像共享相同的基础层(如 ubuntu:24.04),Docker 只会存储一次。当您拉取一个使用相同基础层的新镜像时,Docker 会跳过已存在的层。
这样能显著减少带宽与存储消耗。拉取十个不同标签的 Python 镜像时,Docker 会重用它们之间的公共层,您只需下载实际不同的部分。
docker pull 与 docker image pull
这两个命令在功能上完全一致。它们都会从镜像仓库拉取镜像并存储到本地。
不同之处在于组织方式。Docker 在 CLI 重构中引入了 docker image 命令组以提升直观性。与其把 docker pull、docker rmi、docker images 分散开,不如把镜像相关的命令统一到 docker image pull、docker image rm、docker image ls 之下。
使用您更习惯的即可。docker pull 更短,也更常见于文档中;docker image pull 更明确,适合在需要清晰性的脚本中使用。建议团队内部统一风格。
Docker 镜像引用详解
一个镜像引用最多包含五个部分:HOST/NAMESPACE/REPOSITORY:TAG@DIGEST。
各部分含义如下:
-
HOST:镜像仓库地址(如 docker.io、gcr.io、quay.io)。若省略,Docker 默认使用 Docker Hub。
-
NAMESPACE:通常为您的用户名或组织名(例如官方镜像使用 library,私有镜像则可能是 mycompany)。
-
REPOSITORY:镜像名称本身(如 python、nginx、redis)。
-
TAG:版本标识(如 3.14.2-bookworm, latest)。若省略,默认使用 :latest。
-
DIGEST:镜像清单的 SHA256 哈希(如 @sha256:abc123...)。它是不可变的——标签会变,摘要不会。
最常见的拉取形式如下:
docker pull python:3.14.2-bookworm技术支持
其在幕后会扩展为 docker.io/library/python:3.14.2-bookworm。
对于私有仓库,您需要使用完整引用:
docker pull myregistry.example.com/myteam/myimage技术支持
使用精确引用(具体标签或摘要)可以保证部署的可复现性。今天和下个月都拉取 python:3.14.2-bookworm,得到的都是同一镜像;而拉取 python:latest 两次,很可能并不相同。
Docker 镜像仓库与镜像来源
镜像仓库用于存储与分发镜像——您执行的每一次 docker pull 都是从这里获取。
Docker Hub 作为默认镜像仓库
除非另有指定,否则所有 docker pull 命令默认使用 Docker Hub。
运行 docker pull python:3.14.2-bookworm 时,Docker 会自动将其解析为 docker.io/library/python:3.14.2-bookworm。对于公共镜像,无需登录——Docker Hub 会匿名提供,但未认证用户会受到速率限制。
Docker Hub 上的镜像分为两类:官方镜像 和 社区镜像。
-
官方镜像 由经过验证的发布者提供,并由 Docker 或软件厂商自行维护。它们位于 library 命名空间下(Docker 会对用户隐藏)。当您拉取 python、nginx 或 redis 时,拿到的是遵循 Docker 最佳实践、注重安全且定期更新的官方镜像。
-
社区镜像 则是其他所有镜像。任何人都可以在 Docker Hub 上以其用户名或组织名发布镜像。拉取 johndoe/python-custom,您就在信任 johndoe 能妥善维护该镜像。有些社区镜像质量上乘且维护良好,另一些则多年未更新并含有已知漏洞。
信任在这里至关重要。官方镜像会定期打安全补丁并有清晰的文档;而使用社区镜像时,您需要自行核实维护者及其安全性。
私有与自建镜像仓库
大多数公司不希望其容器镜像存放在公共 Docker Hub 上。
私有仓库才是主流选择。您可以决定谁能拉取镜像、控制保留策略,并将私有代码保留在自身基础设施内。这对于合规、安全以及团队间的访问管理都至关重要。
常见的私有镜像仓库解决方案包括:
- Harbor:开源仓库,内置安全扫描与访问控制
- JFrog Artifactory:企业级方案,同时支持 Docker 镜像与其他制品类型
- 云端仓库:AWS ECR、Google Container Registry(GCR)、Azure Container Registry(ACR)
当然,使用自建仓库时,镜像引用也会随之变化。不再是 python:3.14.2-bookworm,而需要指定完整路径:
docker pull myregistry.company.com/team/python:3.14.2-bookworm技术支持
仓库主机名在前,然后是命名空间(通常是团队或项目名),接着是仓库与标签。当 Docker 识别到自定义主机名时,不会再默认访问 Docker Hub,而是直接前往您的私有仓库。
身份验证、速率限制与访问控制
无论推送还是拉取镜像,身份验证都同样重要,尤其是在触发速率限制或访问私有仓库时。
登录与凭据管理
您可以使用 docker login 命令与镜像仓库进行认证:
docker login技术支持
随后系统会提示输入 Docker Hub 的用户名和密码。对于私有仓库,只需指定主机名:
docker login myregistry.company.com技术支持
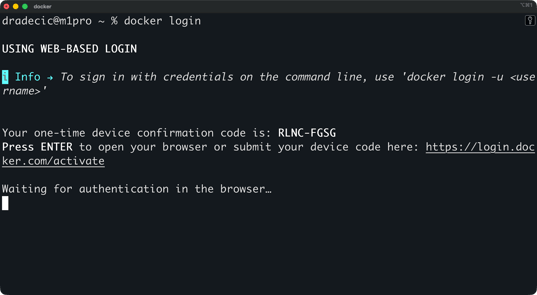
登录后,Docker 会在本地存储您的凭据。Linux 上位于 ~/.docker/config.json;在 macOS 上,Docker 会使用系统钥匙串以提升安全性。
问题在于该配置文件默认以 base64 编码保存凭据,这并非加密。任何能访问您主目录的人都可以解码。作为缓解,您可以改用凭据助手——Docker 支持使用操作系统原生的钥匙串来安全存储密码。
以下是一些凭据管理最佳实践:
Docker Hub 速率限制
Docker Hub 会限制您在特定时间窗口内可拉取的镜像数量。
匿名用户(未登录)每个 IP 每 6 小时可拉取 100 次。已认证的免费用户每 6 小时可拉取 200 次。付费套餐可获得更高或无限额度,取决于级别。
当您运行 CI/CD 流水线、在开发过程中频繁拉取镜像,或在多个用户共享同一 IP 的环境中工作时,这些限制就会变得重要。一旦触及限制,您的拉取会失败,直到时间窗口重置。
您可以检查当前的速率限制状态:
TOKEN=$(curl "<https://auth.docker.io/token?service=registry.docker.io&scope=repository:ratelimitpreview/test:pull>" | jq -r .token)
curl --head -H "Authorization: Bearer $TOKEN" <https://registry-1.docker.io/v2/ratelimitpreview/test/manifests/latest>技术支持
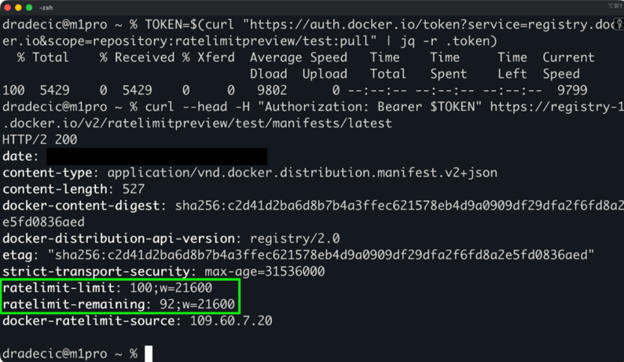
以下是一些提升速率限制的方法(对大多数开发者而言可能并非问题):
- 对拉取进行认证:登录即可获得更高限额,即便是免费账号
- 使用镜像仓库镜像站:设置透传缓存,将镜像缓存在本地
- 切换到私有仓库:自建仓库,完全避开 Docker Hub 的限制
- 本地缓存镜像:拉取一次,多次复用,避免重复拉取
最简单的解决办法就是登录,这能直接将您的限额翻倍。
高级镜像拉取选项
这些高级选项能提供精细化的控制,正是生产环境所需要的。
按摘要(digest)拉取镜像
摘要是基于镜像内容哈希的不可变标识符。
标签会变。有人用同一标签推送了新镜像,昨天的 python:3.14.2-bookworm 今天就可能指向不同的内容。摘要不会变——它是镜像清单的 SHA256 哈希。相同摘要总是代表完全相同的镜像。
按摘要拉取的方式如下:
docker pull python@sha256:6d58c1a9444bc2664f0fa20c43a592fcdb2698eb9a9c32257516538a2746c19a技术支持
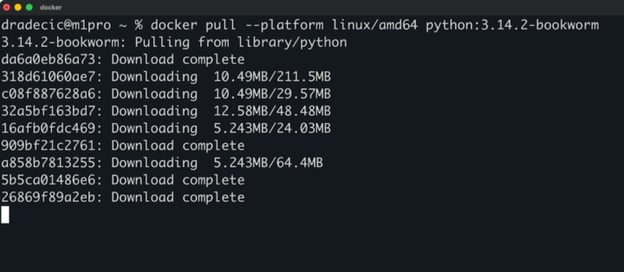
docker pull --platform linux/amd64 python:3.14.2-bookworm技术支持
这在 CI/CD 与生产中尤为重要。您针对某个特定镜像进行测试,也应部署完全相同的镜像。没有意外,也不会在不同环境间发生漂移。若部署依赖具体版本,请使用摘要而非标签。
多体系架构(multi-arch)镜像拉取
多架构镜像会在同一镜像引用下打包多个 CPU 架构的版本。
拉取 python:3.14.2-bookworm 时,Docker 会自动为您的系统选择正确的版本——x86 机器为 amd64,Apple Silicon 或 ARM 服务器为 arm64。仓库会自动提供正确架构的镜像,您无需额外操作。
但有时您需要特定架构。可使用 --platform 标志:
docker pull --platform linux/amd64 python:3.14.2-bookworm技术支持
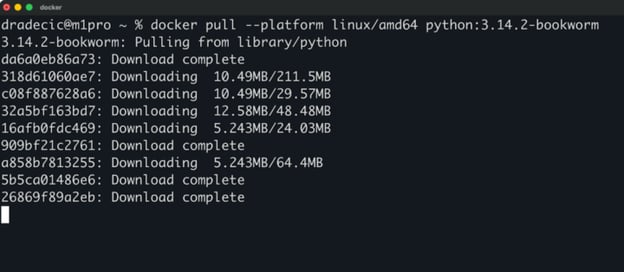
这对在 Apple Silicon 上开发但需测试将在生产运行的 amd64 版本,或在与构建机架构不同的目标架构上构建镜像时尤其有用。
拉取多个标签
使用 --all-tags 标志可以拉取某个仓库的所有标签:
docker pull --all-tags python技术支持
这会下载 Python 的所有标签——包含数十个版本、变体与架构。最终会占用数 GB 的空间。
除非确有需要,否则不要这样做。带宽有成本、存储很快就会被占满,而您很可能并不需要所有历史版本。请改为只拉取您实际使用的具体标签。
取消拉取
按下 Ctrl+C 或 CMD+C 可取消正在进行的拉取。
Docker 会停止下载新的层,但保留已完成的层。下次拉取相同镜像时,会从中断处继续,而不是从头开始。
当您不小心拉错镜像、在慢速网络上拉取耗时太长、或临时发现并不需要该镜像时,这很有用。取消后修正命令,再次拉取即可,不会浪费已完成的工作。
docker pull 的性能考量
现实网络存在带宽上限、代理与慢速连接等限制。这些都会拖慢镜像拉取速度,下面介绍一些应对办法。
优化拉取性能
Docker 默认会并发下载镜像层。
它不会逐层串行拉取,而是打开多个连接并行下载多个层。在高速网络下能明显加速;而在带宽受限的慢速网络下,提升不明显。
两种常见策略可进一步提升效率:
- 缓存会将已拉取的镜像存储在本地。拉取一次,反复使用。Docker 会在下载前检查本地是否已有对应层;若镜像未变化,拉取将瞬间完成。
- 预加载镜像指在非高峰时段或作为部署流程的一部分提前拉取。CI/CD 系统常在构建代理上缓存基础镜像,避免开发者每次构建都等待拉取。生产服务器亦可在部署时预热缓存,以免在流量高峰时再去拉取。
在代理后拉取镜像
企业网络常通过代理来进行安全、审计与访问控制。
Docker 需要知晓这些代理才能顺利拉取镜像。若未配置代理,拉取可能因连接超时或 DNS 错误而失败,因为 Docker 会尝试直接访问镜像仓库而非通过代理。
您需要在两个层面配置代理:Docker 客户端与 Docker 守护进程。客户端(即 docker 命令)会自动使用系统的 HTTP 代理设置;守护进程需要在 /etc/docker/daemon.json 或通过 systemd 服务文件进行显式配置。
排查常见拉取问题
当拉取失败时,可参考以下实用清单——问题总会发生,关键是先排查哪些点。
常见错误及诊断方法
认证失败 通常表现为 “unauthorized” 或 “access denied” 错误。
先用 docker login 检查是否已登录。如果已登录,可能是凭据过期或错误。先用 docker logout 登出,再重新登录。对于私有仓库,确认登录命令中使用了正确的主机名。
缺失的标签 会报 “manifest unknown” 或 “not found” 错误。
这表示该标签不存在。请仔细检查标签名(拼写错误很常见),并在仓库的网页界面核实实际存在的标签。还要注意,标签可能被删除,因此昨天可用的内容今天可能不可用了。
网络超时 表示 Docker 无法访问镜像仓库。
首先检查网络连接是否正常;然后验证是否能直接访问仓库——运行 ping registry-1.docker.io 或 curl -I <https://registry-1.docker.io>。若位于代理之后,请确保 Docker 已配置代理。若仓库为私有,请检查防火墙与 VPN 连接。
权限问题会在已认证的情况下仍然出现 “denied” 错误。
您已登录,但账号对该仓库没有拉取权限。请联系仓库所有者或镜像仓库管理员开通权限。对 Docker Hub 而言,这通常意味着镜像是私有的,而您的账号不在访问名单中。
DNS 与网络解析问题
DNS 失败会导致 Docker 无法找到镜像仓库服务器。
常见报错为 “no such host” 或 “temporary failure in name resolution”。实质是 Docker 无法将仓库主机名解析为 IP 地址,从而无法建立连接。
解决方法:用 nslookup registry-1.docker.io 或 dig registry-1.docker.io 检查 DNS 解析。如果失败,说明 DNS 服务器不可达或配置错误。可暂时切换到公共 DNS(如 8.8.8.8)验证问题是否解决。
在企业网络中,DNS 服务器可能只解析内部主机名。请确保私有仓库的主机名已在 DNS 服务器中配置,或在问题修复前临时将其加入 /etc/hosts。
编排与本地工作流中的 docker pull
下面进入实战场景——docker pull 在您日常工作中会如何发挥作用。
Kubernetes 中的镜像拉取
在部署 Pod 时,Kubernetes 会自动拉取镜像。
您在 Pod 规范中定义容器及其镜像引用,Kubernetes 会替您完成拉取。每个节点上的 kubelet 会检查本地是否已有该镜像;若没有,则在启动容器前从仓库拉取。
拉取策略用于控制何时拉取镜像:
在 Pod 规范中通过 imagePullPolicy 设置策略。开发环境中对 :latest 使用 Always 以获取更新;生产环境中对具体标签使用 IfNotPresent 以避免不必要的拉取。
imagePullSecrets 使 Kubernetes 能访问私有仓库。您可以用仓库凭据创建一个 Secret,并在 Pod 规范中引用它。否则,Kubernetes 只能拉取公共镜像。
Docker Compose 与本地开发
Compose 会在启动多服务应用时自动完成拉取。
运行 docker compose up 后,Compose 会检查每个服务的镜像;若缺失,会在启动容器前先拉取。无需为每个服务手动执行 docker pull,Compose 会替您处理。
这在开发中非常高效。您在 docker-compose.yml 中定义服务,执行一条命令,Compose 就会拉取所需的一切。首次 up 会因下载镜像而耗时更久,但如果镜像未更新,后续运行将非常迅速。
docker compose 与 docker compose pull
这是两个不同的命令,作用也不同。
docker compose up 用于启动服务。它会自动拉取缺失的镜像,但仅限于本地不存在的情况。若您本机已存在 python:3.14.2-bookworm,Compose 会直接使用而不检查是否有更新。
docker compose pull 会显式拉取 compose 文件中定义的所有镜像,无论本地是否已存在。它会检查仓库是否有更新,并在可用时下载新版本。
以下场景需要使用 docker compose pull:
-
您使用 :latest 标签并希望获取最新版本。先运行 docker compose pull 获取更新,再用 docker compose up 启动最新镜像。
-
调试时怀疑本地镜像已过期或损坏。先用 docker compose pull 拉取干净版本,再重启。
-
希望在实际启动服务前预加载镜像。在部署过程中运行 docker compose pull 进行缓存,随后 docker compose up 即可瞬间启动,无需等待下载。
关键区别在于 up 只拉取缺失的部分,而 pull 会不论本地已有与否都检查并更新。
结语
docker pull 命令看起来简单,但水面之下有很多机制可调。请记住以下最佳实践。
尽量使用明确的标签或摘要而非 :latest。对拉取进行认证以避免速率限制。在拉取镜像时关注带宽与存储,尤其是在 CI/CD 流水线中频繁拉取的场景。
将镜像拉取视作安全流程的一部分。若使用不受信任的来源或含有已知漏洞的过时镜像,每一次拉取都可能成为攻击向量。请核实来源、进行漏洞扫描,并保持基础镜像的更新。
Docker 镜像仓库与相关工具在不断演进。请及时关注仓库服务商的更新,以免出现破坏工作流的意外变化。
当您准备将 Docker 与容器化技能提升到专业水平时,欢迎查看我们的 Intermediate Docker 课程,或选择我们的完整学习路径 Containerization and Virtualization with Docker and Kubernetes 学习路线。


docker pull命令本身不难理解,但底层发生的一切,哪怕是经验老道的专家也未必都清楚。每位开发者都应该了解它。您几乎每天都会拉取镜像,但一旦出问题,往往很难定位原因。可能是无缘无故地认证失败、被速率限制拦下,或者线上跑着错误的镜像版本。每次失败都要花时间去修复,而这些本不该发生。
弄清
docker pull的实际工作机制,能让您掌控全局。您会知道镜像从哪里来、如何拉取,以及如何在问题影响生产前进行排查。本文将解释镜像拉取的底层原理、镜像仓库的作用,以及如何在本地开发与生产环境中拉取镜像。
如果您完全是 Docker 新手,强烈建议先学习我们的 Introduction to Docker 课程,它将覆盖理解本文所需的基础知识。
docker pull 的底层工作原理
本节将介绍
docker pull的工作机制,消除对幕后流程的困惑。执行 docker pull 时发生了什么
基本语法很简单:
该命令默认与 Docker Hub 通信,下载 Python 镜像并存储在本机。但背后还有更多细节。
流程如下:
您的 Docker 客户端向镜像仓库发送请求(若未指定则为 Docker Hub)
镜像仓库返回镜像清单(manifest),其中列出了构成该镜像的所有层
/var/lib/docker路径下;若使用 Docker Desktop,则存储在其管理的目录中(例如 macOS 的~Library/Containers/…,以及 Windows 的C:\Users\[Username]\AppData\...)。当您未指定版本时,Docker 会默认使用
:latest标签。直接运行docker pull python,得到的就是python:latest。这看似方便,却存在风险。:latest并不意味着“最新稳定版”,而是“镜像维护者标记为 latest 的那个版本”。它可能在不同时间的拉取之间发生变化,从而在毫无预警的情况下破坏您的构建。镜像层与内容可寻址存储
Docker 镜像由多层构建而成。
每一层都代表相对于上一层的更改。在构建镜像时,Dockerfile 中的每条
RUN、COPY或ADD指令都会创建一个新层。最终镜像是按顺序叠加这些层的结果。例如,看看上文所用 Python 3.14 镜像 背后的命令——内容相当丰富。
内容可寻址存储 是实现这一切的关键。每一层都会基于其内容生成唯一哈希。如果两个镜像共享相同的基础层(如
ubuntu:24.04),Docker 只会存储一次。当您拉取一个使用相同基础层的新镜像时,Docker 会跳过已存在的层。这样能显著减少带宽与存储消耗。拉取十个不同标签的 Python 镜像时,Docker 会重用它们之间的公共层,您只需下载实际不同的部分。
docker pull 与 docker image pull
这两个命令在功能上完全一致。它们都会从镜像仓库拉取镜像并存储到本地。
不同之处在于组织方式。Docker 在 CLI 重构中引入了
docker image命令组以提升直观性。与其把docker pull、docker rmi、docker images分散开,不如把镜像相关的命令统一到docker image pull、docker image rm、docker image ls之下。使用您更习惯的即可。
docker pull更短,也更常见于文档中;docker image pull更明确,适合在需要清晰性的脚本中使用。建议团队内部统一风格。Docker 镜像引用详解
一个镜像引用最多包含五个部分:
HOST/NAMESPACE/REPOSITORY:TAG@DIGEST。各部分含义如下:
HOST:镜像仓库地址(如
docker.io、gcr.io、quay.io)。若省略,Docker 默认使用 Docker Hub。NAMESPACE:通常为您的用户名或组织名(例如官方镜像使用
library,私有镜像则可能是mycompany)。REPOSITORY:镜像名称本身(如
python、nginx、redis)。TAG:版本标识(如
3.14.2-bookworm, latest)。若省略,默认使用:latest。DIGEST:镜像清单的 SHA256 哈希(如
@sha256:abc123...)。它是不可变的——标签会变,摘要不会。最常见的拉取形式如下:
其在幕后会扩展为
docker.io/library/python:3.14.2-bookworm。对于私有仓库,您需要使用完整引用:
使用精确引用(具体标签或摘要)可以保证部署的可复现性。今天和下个月都拉取
python:3.14.2-bookworm,得到的都是同一镜像;而拉取python:latest两次,很可能并不相同。Docker 镜像仓库与镜像来源
镜像仓库用于存储与分发镜像——您执行的每一次
docker pull都是从这里获取。Docker Hub 作为默认镜像仓库
除非另有指定,否则所有
docker pull命令默认使用 Docker Hub。运行
docker pull python:3.14.2-bookworm时,Docker 会自动将其解析为docker.io/library/python:3.14.2-bookworm。对于公共镜像,无需登录——Docker Hub 会匿名提供,但未认证用户会受到速率限制。Docker Hub 上的镜像分为两类:官方镜像 和 社区镜像。
官方镜像 由经过验证的发布者提供,并由 Docker 或软件厂商自行维护。它们位于
library命名空间下(Docker 会对用户隐藏)。当您拉取python、nginx或redis时,拿到的是遵循 Docker 最佳实践、注重安全且定期更新的官方镜像。社区镜像 则是其他所有镜像。任何人都可以在 Docker Hub 上以其用户名或组织名发布镜像。拉取
johndoe/python-custom,您就在信任 johndoe 能妥善维护该镜像。有些社区镜像质量上乘且维护良好,另一些则多年未更新并含有已知漏洞。信任在这里至关重要。官方镜像会定期打安全补丁并有清晰的文档;而使用社区镜像时,您需要自行核实维护者及其安全性。
私有与自建镜像仓库
大多数公司不希望其容器镜像存放在公共 Docker Hub 上。
私有仓库才是主流选择。您可以决定谁能拉取镜像、控制保留策略,并将私有代码保留在自身基础设施内。这对于合规、安全以及团队间的访问管理都至关重要。
常见的私有镜像仓库解决方案包括:
当然,使用自建仓库时,镜像引用也会随之变化。不再是
python:3.14.2-bookworm,而需要指定完整路径:仓库主机名在前,然后是命名空间(通常是团队或项目名),接着是仓库与标签。当 Docker 识别到自定义主机名时,不会再默认访问 Docker Hub,而是直接前往您的私有仓库。
身份验证、速率限制与访问控制
无论推送还是拉取镜像,身份验证都同样重要,尤其是在触发速率限制或访问私有仓库时。
登录与凭据管理
您可以使用
docker login命令与镜像仓库进行认证:随后系统会提示输入 Docker Hub 的用户名和密码。对于私有仓库,只需指定主机名:
登录后,Docker 会在本地存储您的凭据。Linux 上位于
~/.docker/config.json;在 macOS 上,Docker 会使用系统钥匙串以提升安全性。问题在于该配置文件默认以 base64 编码保存凭据,这并非加密。任何能访问您主目录的人都可以解码。作为缓解,您可以改用凭据助手——Docker 支持使用操作系统原生的钥匙串来安全存储密码。
以下是一些凭据管理最佳实践:
使用凭据助手(docker-credential-osxkeychain、docker-credential-wincred)
切勿将
config.json提交到版本控制尽可能使用访问令牌(access token)而非密码
定期轮换凭据,尤其是共享账号
Docker Hub 速率限制
Docker Hub 会限制您在特定时间窗口内可拉取的镜像数量。
匿名用户(未登录)每个 IP 每 6 小时可拉取 100 次。已认证的免费用户每 6 小时可拉取 200 次。付费套餐可获得更高或无限额度,取决于级别。
当您运行 CI/CD 流水线、在开发过程中频繁拉取镜像,或在多个用户共享同一 IP 的环境中工作时,这些限制就会变得重要。一旦触及限制,您的拉取会失败,直到时间窗口重置。
您可以检查当前的速率限制状态:
以下是一些提升速率限制的方法(对大多数开发者而言可能并非问题):
最简单的解决办法就是登录,这能直接将您的限额翻倍。
高级镜像拉取选项
这些高级选项能提供精细化的控制,正是生产环境所需要的。
按摘要(digest)拉取镜像
摘要是基于镜像内容哈希的不可变标识符。
标签会变。有人用同一标签推送了新镜像,昨天的 python:3.14.2-bookworm 今天就可能指向不同的内容。摘要不会变——它是镜像清单的 SHA256 哈希。相同摘要总是代表完全相同的镜像。
按摘要拉取的方式如下:
这在 CI/CD 与生产中尤为重要。您针对某个特定镜像进行测试,也应部署完全相同的镜像。没有意外,也不会在不同环境间发生漂移。若部署依赖具体版本,请使用摘要而非标签。
多体系架构(multi-arch)镜像拉取
多架构镜像会在同一镜像引用下打包多个 CPU 架构的版本。
拉取
python:3.14.2-bookworm时,Docker 会自动为您的系统选择正确的版本——x86 机器为 amd64,Apple Silicon 或 ARM 服务器为 arm64。仓库会自动提供正确架构的镜像,您无需额外操作。但有时您需要特定架构。可使用
--platform标志:这对在 Apple Silicon 上开发但需测试将在生产运行的 amd64 版本,或在与构建机架构不同的目标架构上构建镜像时尤其有用。
拉取多个标签
使用
--all-tags标志可以拉取某个仓库的所有标签:这会下载 Python 的所有标签——包含数十个版本、变体与架构。最终会占用数 GB 的空间。
除非确有需要,否则不要这样做。带宽有成本、存储很快就会被占满,而您很可能并不需要所有历史版本。请改为只拉取您实际使用的具体标签。
取消拉取
按下 Ctrl+C 或 CMD+C 可取消正在进行的拉取。
Docker 会停止下载新的层,但保留已完成的层。下次拉取相同镜像时,会从中断处继续,而不是从头开始。
当您不小心拉错镜像、在慢速网络上拉取耗时太长、或临时发现并不需要该镜像时,这很有用。取消后修正命令,再次拉取即可,不会浪费已完成的工作。
docker pull 的性能考量
现实网络存在带宽上限、代理与慢速连接等限制。这些都会拖慢镜像拉取速度,下面介绍一些应对办法。
优化拉取性能
Docker 默认会并发下载镜像层。
它不会逐层串行拉取,而是打开多个连接并行下载多个层。在高速网络下能明显加速;而在带宽受限的慢速网络下,提升不明显。
两种常见策略可进一步提升效率:
在代理后拉取镜像
企业网络常通过代理来进行安全、审计与访问控制。
Docker 需要知晓这些代理才能顺利拉取镜像。若未配置代理,拉取可能因连接超时或 DNS 错误而失败,因为 Docker 会尝试直接访问镜像仓库而非通过代理。
您需要在两个层面配置代理:Docker 客户端与 Docker 守护进程。客户端(即
docker命令)会自动使用系统的 HTTP 代理设置;守护进程需要在/etc/docker/daemon.json或通过 systemd 服务文件进行显式配置。排查常见拉取问题
当拉取失败时,可参考以下实用清单——问题总会发生,关键是先排查哪些点。
常见错误及诊断方法
认证失败 通常表现为 “unauthorized” 或 “access denied” 错误。
先用
docker login检查是否已登录。如果已登录,可能是凭据过期或错误。先用docker logout登出,再重新登录。对于私有仓库,确认登录命令中使用了正确的主机名。缺失的标签 会报 “manifest unknown” 或 “not found” 错误。
这表示该标签不存在。请仔细检查标签名(拼写错误很常见),并在仓库的网页界面核实实际存在的标签。还要注意,标签可能被删除,因此昨天可用的内容今天可能不可用了。
网络超时 表示 Docker 无法访问镜像仓库。
首先检查网络连接是否正常;然后验证是否能直接访问仓库——运行
ping registry-1.docker.io或curl -I <https://registry-1.docker.io>。若位于代理之后,请确保 Docker 已配置代理。若仓库为私有,请检查防火墙与 VPN 连接。权限问题会在已认证的情况下仍然出现 “denied” 错误。
您已登录,但账号对该仓库没有拉取权限。请联系仓库所有者或镜像仓库管理员开通权限。对 Docker Hub 而言,这通常意味着镜像是私有的,而您的账号不在访问名单中。
DNS 与网络解析问题
DNS 失败会导致 Docker 无法找到镜像仓库服务器。
常见报错为 “no such host” 或 “temporary failure in name resolution”。实质是 Docker 无法将仓库主机名解析为 IP 地址,从而无法建立连接。
解决方法:用
nslookup registry-1.docker.io或dig registry-1.docker.io检查 DNS 解析。如果失败,说明 DNS 服务器不可达或配置错误。可暂时切换到公共 DNS(如 8.8.8.8)验证问题是否解决。在企业网络中,DNS 服务器可能只解析内部主机名。请确保私有仓库的主机名已在 DNS 服务器中配置,或在问题修复前临时将其加入
/etc/hosts。编排与本地工作流中的 docker pull
下面进入实战场景——docker pull 在您日常工作中会如何发挥作用。
Kubernetes 中的镜像拉取
在部署 Pod 时,Kubernetes 会自动拉取镜像。
您在 Pod 规范中定义容器及其镜像引用,Kubernetes 会替您完成拉取。每个节点上的 kubelet 会检查本地是否已有该镜像;若没有,则在启动容器前从仓库拉取。
拉取策略用于控制何时拉取镜像:
Always:每次都拉取,即便本地已有IfNotPresent:仅在本地不存在时才拉取(带标签镜像的默认值)Never:从不拉取,若本地不存在则失败在 Pod 规范中通过
imagePullPolicy设置策略。开发环境中对:latest使用Always以获取更新;生产环境中对具体标签使用IfNotPresent以避免不必要的拉取。imagePullSecrets 使 Kubernetes 能访问私有仓库。您可以用仓库凭据创建一个 Secret,并在 Pod 规范中引用它。否则,Kubernetes 只能拉取公共镜像。
Docker Compose 与本地开发
Compose 会在启动多服务应用时自动完成拉取。
运行
docker compose up后,Compose 会检查每个服务的镜像;若缺失,会在启动容器前先拉取。无需为每个服务手动执行docker pull,Compose 会替您处理。这在开发中非常高效。您在
docker-compose.yml中定义服务,执行一条命令,Compose 就会拉取所需的一切。首次up会因下载镜像而耗时更久,但如果镜像未更新,后续运行将非常迅速。docker compose 与 docker compose pull
这是两个不同的命令,作用也不同。
docker compose up用于启动服务。它会自动拉取缺失的镜像,但仅限于本地不存在的情况。若您本机已存在python:3.14.2-bookworm,Compose 会直接使用而不检查是否有更新。docker compose pull会显式拉取 compose 文件中定义的所有镜像,无论本地是否已存在。它会检查仓库是否有更新,并在可用时下载新版本。以下场景需要使用
docker compose pull:您使用
:latest标签并希望获取最新版本。先运行docker compose pull获取更新,再用docker compose up启动最新镜像。调试时怀疑本地镜像已过期或损坏。先用
docker compose pull拉取干净版本,再重启。希望在实际启动服务前预加载镜像。在部署过程中运行
docker compose pull进行缓存,随后docker compose up即可瞬间启动,无需等待下载。关键区别在于 up 只拉取缺失的部分,而 pull 会不论本地已有与否都检查并更新。
结语
docker pull命令看起来简单,但水面之下有很多机制可调。请记住以下最佳实践。尽量使用明确的标签或摘要而非
:latest。对拉取进行认证以避免速率限制。在拉取镜像时关注带宽与存储,尤其是在 CI/CD 流水线中频繁拉取的场景。将镜像拉取视作安全流程的一部分。若使用不受信任的来源或含有已知漏洞的过时镜像,每一次拉取都可能成为攻击向量。请核实来源、进行漏洞扫描,并保持基础镜像的更新。
Docker 镜像仓库与相关工具在不断演进。请及时关注仓库服务商的更新,以免出现破坏工作流的意外变化。
当您准备将 Docker 与容器化技能提升到专业水平时,欢迎查看我们的 Intermediate Docker 课程,或选择我们的完整学习路径 Containerization and Virtualization with Docker and Kubernetes 学习路线。