直到最近,微调GPT-4o 还只能基于文本。如今,借助OpenAI 最新的微调 API,我们也可以用图像来定制 GPT-4o。这意味着我们可以让 GPT-4o 的能力更贴合我们的使用场景。
这一更新带来了新可能——想象一下,将 GPT-4o 微调用于更精准的视觉搜索、目标检测,甚至医学影像分析。
在本教程中,我将逐步讲解如何使用图像微调 GPT-4o。具体来说,我们会将模型微调为能够正确识别格鲁吉亚正教会的教堂。
GPT-4o 视觉微调定价
OpenAI 在 10 月 31 日之前每天提供 100 万个免费 token,用于基于图像微调 GPT-4o 模型,这是探索 GPT-4o 视觉微调能力的好机会。
10 月 31 日之后,训练费用将转为按量计费,费率为每百万 token 25 美元。此外,推理还将对每次输入(每百万 token 3.75 美元)和输出(每百万 token 15 美元)收取费用。
请注意,此信息截至 10 月 10 日有效,最新的价格与可用性请参阅OpenAI 的定价页面。
GPT-4o 的视觉识别挑战
让我们直接进入有趣的部分。我们究竟如何为 GPT-4o 进行视觉微调?
先来评估一下 GPT-4o 识别这座格鲁吉亚教堂的表现:
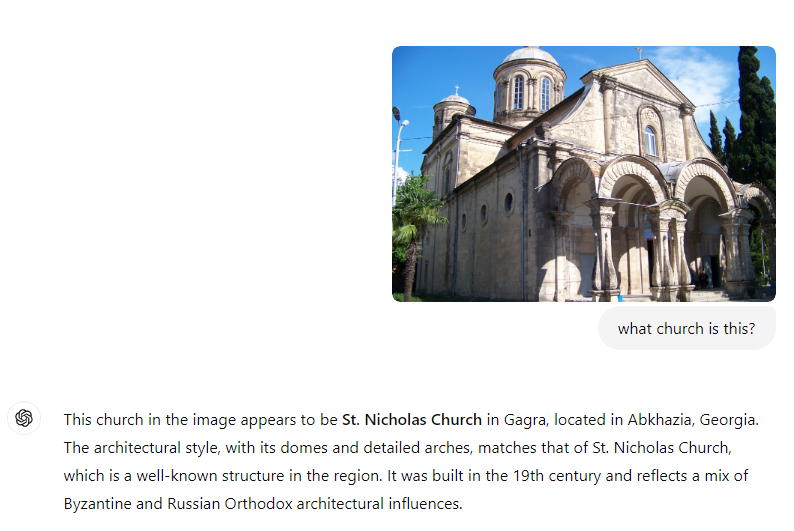
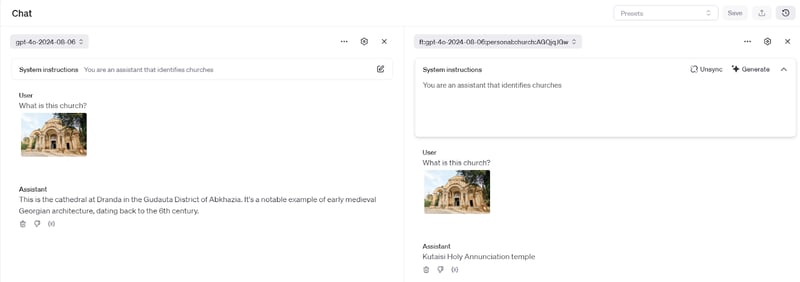
在提问后,模型认为图中的建筑是格鲁吉亚的圣尼古拉教堂,但实际上它是库塔伊西的“圣报喜”教堂(Kutaisi Holy Annunciation temple)。
显然,还有改进空间,这正是微调发挥作用的地方。
准备 JSONL 文件
要开始微调,我们首先需要准备训练数据集。根据官方文档,我们需要一个如下结构的 JSONL 文件:
{
  "messages": [
    {
      "role": "system",
      "content": "You are an assistant that identifies Georgian orthodox churches."
    },
    {
      "role": "user",
      "content": "What is this church called?"
    },
    {
      "role": "user",
      "content": [
        {
          "type": "image_url",
          "image_url": {
            "url": "https://upload.wikimedia.org/wikipedia/commons/e/e8/Khareba_church.jpg"
          }
        }
      ]
    },
    {
      "role": "assistant",
      "content": "Kutaisi Holy Annunciation temple"
    }
  ]
}

//second example

{
  "messages": [
    {
      "role": "system",
      "content": "You are an assistant that identifies Georgian orthodox churches."
    },
    {
      "role": "user",
      "content": "What is this church called?"
    },
    {
      "role": "user",
      "content": [
        {
          "type": "image_url",
          "image_url": {
            "url": "https://upload.wikimedia.org/wikipedia/en/a/af/Holy_Trinity_Cathedral_of_Tbilisi.jpg"
          }
        }
      ]
    },
    {
      "role": "assistant",
      "content": "Holy trinity cathedral"
    }
  ]
}

//other examples below
技术支持
为了便于阅读与节省篇幅,我这里只展示了两个条目的训练 JSONL 片段;其余训练样本应各自占用单独一行。
注意,运行微调至少需要 10 个示例。每一行代表一个独立的包含 messages 数组的 JSON 对象。
另外,JSONL 不支持注释,因此我在本指南中使用 // 添加了注释。请务必在训练前删除它们。
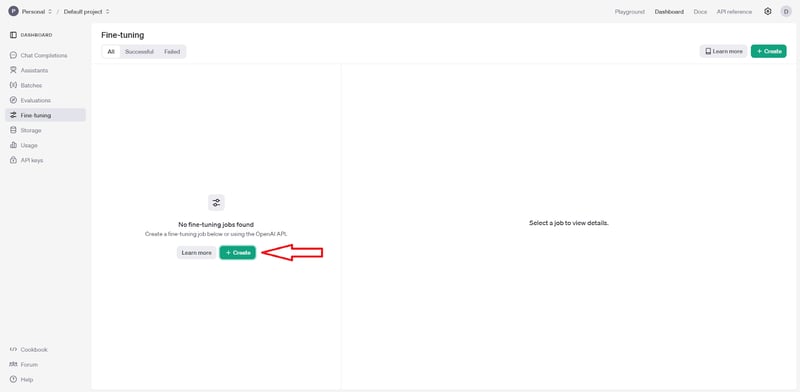
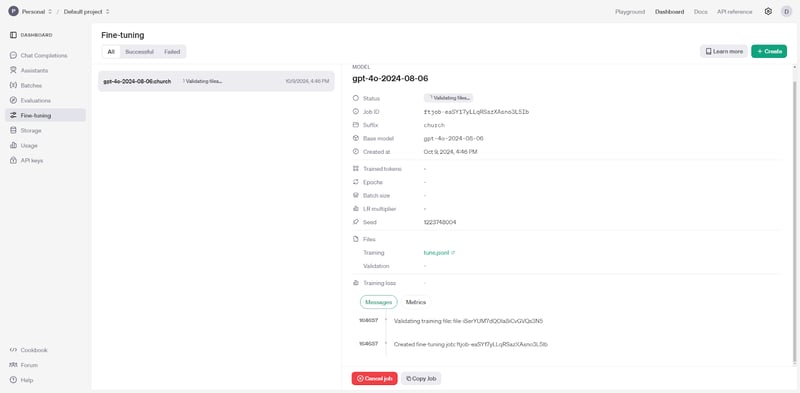
您可以使用诸如记事本之类的常规文本编辑器;如果示例很多,建议使用脚本自动生成该文件。准备好 JSONL 文件后,就可以开始微调流程了。



直到最近,微调GPT-4o 还只能基于文本。如今,借助OpenAI 最新的微调 API,我们也可以用图像来定制 GPT-4o。这意味着我们可以让 GPT-4o 的能力更贴合我们的使用场景。
这一更新带来了新可能——想象一下,将 GPT-4o 微调用于更精准的视觉搜索、目标检测,甚至医学影像分析。
在本教程中,我将逐步讲解如何使用图像微调 GPT-4o。具体来说,我们会将模型微调为能够正确识别格鲁吉亚正教会的教堂。
GPT-4o 视觉微调定价
OpenAI 在 10 月 31 日之前每天提供 100 万个免费 token,用于基于图像微调 GPT-4o 模型,这是探索 GPT-4o 视觉微调能力的好机会。
10 月 31 日之后,训练费用将转为按量计费,费率为每百万 token 25 美元。此外,推理还将对每次输入(每百万 token 3.75 美元)和输出(每百万 token 15 美元)收取费用。
请注意,此信息截至 10 月 10 日有效,最新的价格与可用性请参阅OpenAI 的定价页面。
GPT-4o 的视觉识别挑战
让我们直接进入有趣的部分。我们究竟如何为 GPT-4o 进行视觉微调?
先来评估一下 GPT-4o 识别这座格鲁吉亚教堂的表现:
在提问后,模型认为图中的建筑是格鲁吉亚的圣尼古拉教堂,但实际上它是库塔伊西的“圣报喜”教堂(Kutaisi Holy Annunciation temple)。
显然,还有改进空间,这正是微调发挥作用的地方。
准备 JSONL 文件
要开始微调,我们首先需要准备训练数据集。根据官方文档,我们需要一个如下结构的 JSONL 文件:
为了便于阅读与节省篇幅,我这里只展示了两个条目的训练 JSONL 片段;其余训练样本应各自占用单独一行。
注意,运行微调至少需要 10 个示例。每一行代表一个独立的包含
messages数组的 JSON 对象。另外,JSONL 不支持注释,因此我在本指南中使用
//添加了注释。请务必在训练前删除它们。您可以使用诸如记事本之类的常规文本编辑器;如果示例很多,建议使用脚本自动生成该文件。准备好 JSONL 文件后,就可以开始微调流程了。