
课程
Python 中的 LLM 入门
3 小时
36.6K
语言模型是一种机器学习算法,旨在根据前文片段预测句子中的下一个词。它基于 Transformers 架构,我们在Transformer 如何工作的文章中有深入讲解。
预训练语言模型(如 GPT,Generative Pre-trained Transformer)在海量文本数据上进行训练。这使得 LLM 能够掌握自然语言中词语使用及其排列的基本规律。
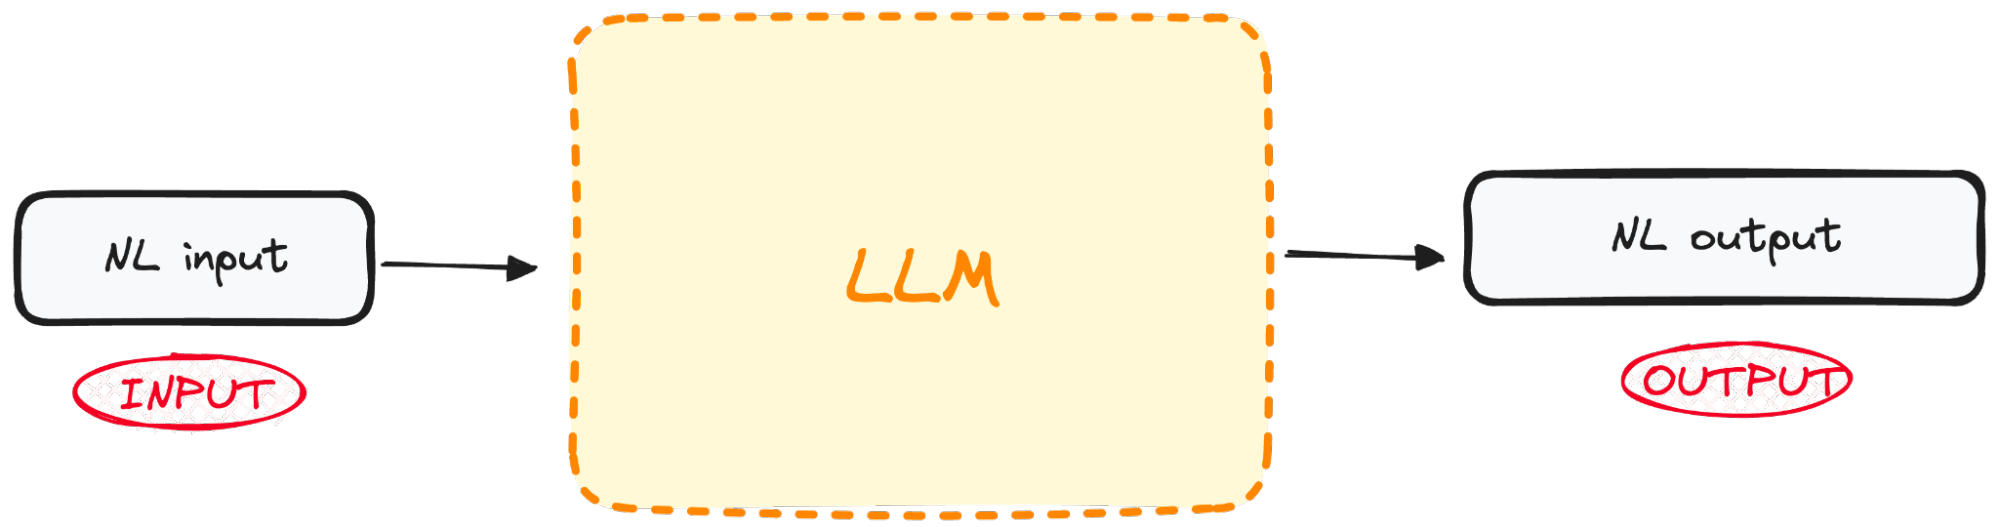
作者供图。LLM 的输入与输出。
最重要的一点是,这些模型不仅擅长理解自然语言,还能根据收到的输入生成类似人类的文本。
而其中最棒的是什么?
这些模型已经通过 API 向大众开放。如果您想学习如何利用 OpenAI 最强大的 LLM,可以参考这份关于OpenAI API的速查表。
微调是指在预训练模型的基础上,使用特定领域的数据集对其进行进一步训练的过程。
当今大多数 LLM 在整体表现上很出色,但在特定的任务型问题上可能表现不佳。微调带来显著优势,包括降低计算成本,以及无需从零构建即可利用最前沿的模型。
Transformers 提供了大量适用于不同任务的预训练模型。对这些模型进行微调,是提升其在特定任务(如情感分析、问答或文档摘要)上准确度的关键步骤。
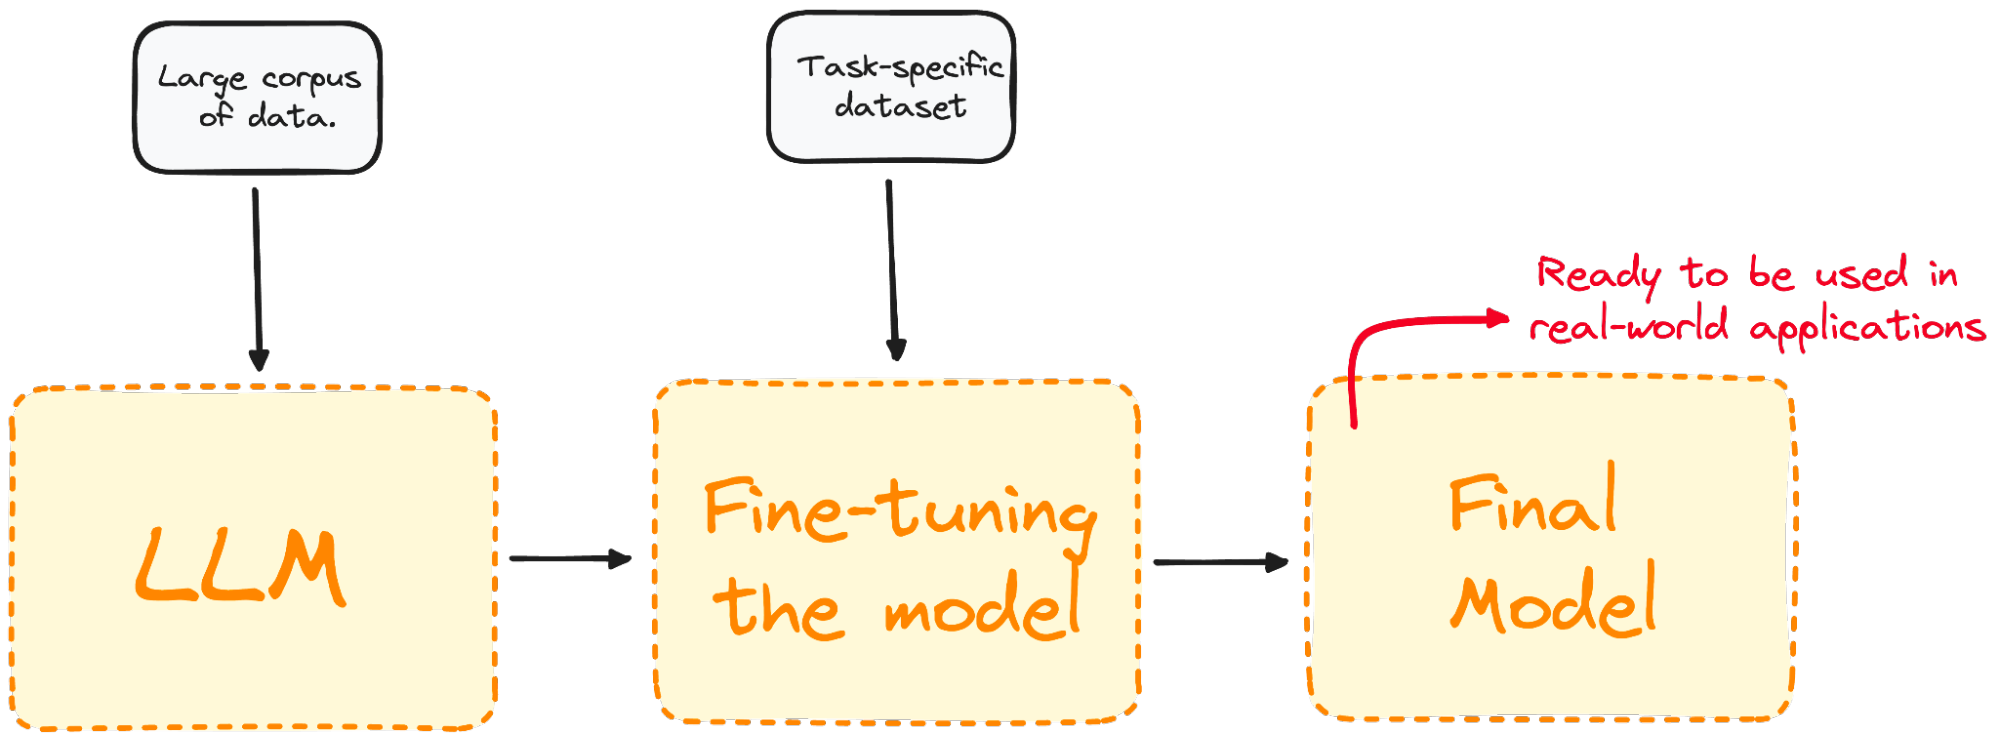
作者供图。微调过程可视化。
微调可使模型在特定任务上表现更佳,使其在真实世界应用中更高效、更通用。该过程对于将现有模型定制到特定任务或领域至关重要。
是否进行微调取决于您的目标,而目标通常会随具体领域或手头任务的不同而变化。
微调可有多种方法,主要取决于其关注点和具体目标。
最直接、最常见的微调方式。模型在与目标任务相关的标注数据集上进一步训练,例如文本分类或命名实体识别。
例如,对于情感分析,我们会用带有相应情感标签的文本样本数据集来训练模型。
在某些情况下,收集大型标注数据集并不现实。小样本学习尝试通过在输入提示的开头提供少量该任务的示例(或“shots”)来解决这一问题。这有助于模型在不进行大规模微调的情况下,获得更好的任务上下文。
尽管所有微调技术都可视为迁移学习的一种形式,但此类别专门旨在让模型执行与其最初训练任务不同的任务。核心思想是利用模型从大型通用数据集中获得的知识,并将其应用于更具体或相关的任务。
此类微调旨在让模型理解并生成特定领域或行业的文本。通过在来自目标领域的文本数据集上微调模型,以提升其对领域特定任务的理解与知识。
例如,要为医疗应用生成聊天机器人,模型将使用医疗记录进行训练,以使其语言理解能力适配医疗健康领域。
在线运行和编辑此教程中的代码
运行代码我们已经知道,微调是将预训练模型拿来,使用与您的任务相关的数据集进行训练以更新其参数的过程。那么,让我们通过微调一个真实的模型来举例说明这一概念。
假设我们在使用 GPT-2,但发现它在推断推文的情感方面表现不佳。
一个很自然的问题是:我们能做些什么来提升其表现吗?
我们可以通过微调来利用这一点:用包含推文及其对应情感的数据集,训练来自 Hugging Face 的预训练 GPT-2 模型,从而提升表现。以下是将模型用于序列分类微调的基础示例:
要微调模型,我们总是需要先选定一个预训练模型。在我们的案例中,我们将用 GPT-2 进行一些简单的微调。
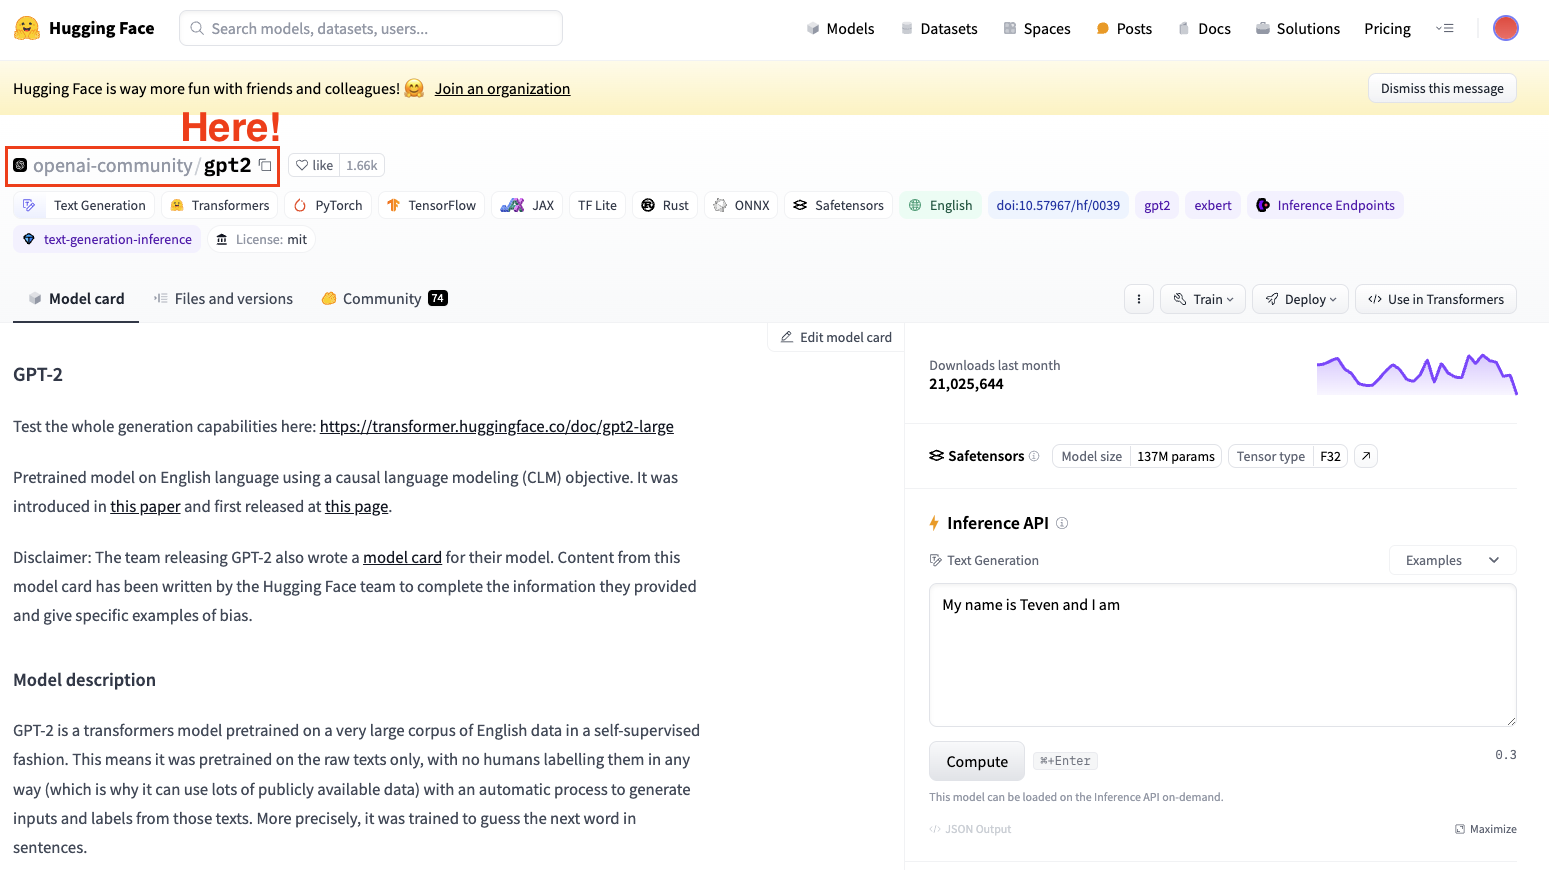
Hugging Face Datasets Hub 截图。选择 OpenAI 的 GPT2 模型。
务必记得选择与您的任务相适配的模型架构。
现在我们有了模型,需要一些高质量的数据来配合使用,这正是datasets库派上用场的地方。
在我的案例中,我将使用 Hugging Face 的 datasets 库导入一个数据集,其中包含按情感(Positive、Neutral 或 Negative)划分的推文。
from datasets import load_dataset

dataset = load_dataset("mteb/tweet_sentiment_extraction")
df = pd.DataFrame(dataset['train'])
如果我们查看刚刚下载的数据集,会发现它包含训练子集和测试子集。若将训练子集转换为数据框,其外观如下所示。
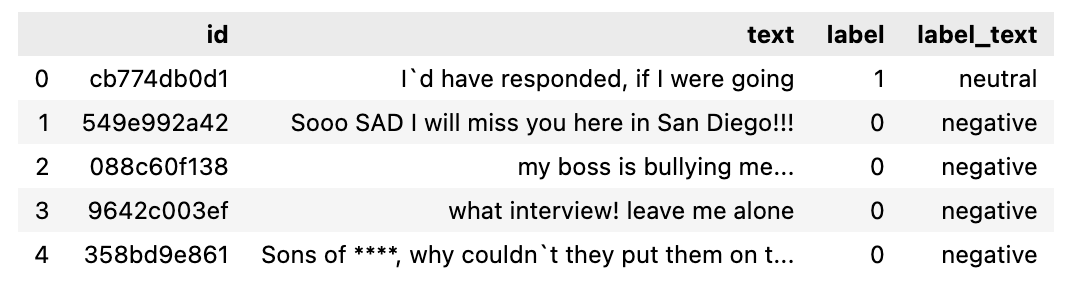
将要使用的数据集。
现在我们已经有了数据集,需要一个分词器来准备数据以供模型解析。
由于 LLM 以 token 为单位工作,我们需要分词器来处理数据集。要一步处理整个数据集,可使用 Datasets 的 map 方法将预处理函数应用于整个数据集。
因此,第二步就是加载预训练分词器并对数据集进行分词,以便用于微调。
from transformers import GPT2Tokenizer

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")

tokenizer = GPT2Tokenizer.from_pretrained("gpt2")
tokenizer.pad_token = tokenizer.eos_token
def tokenize_function(examples):
   return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)加分项:为降低处理需求,我们可以从完整数据集中创建较小的子集来微调模型。训练集用于微调模型,测试集用于评估模型。
small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))首先加载模型,并指定期望的标签数量。根据推文情感数据集的说明,您知道有三个标签:
from transformers import GPT2ForSequenceClassification

model = GPT2ForSequenceClassification.from_pretrained("gpt2", num_labels=3)Transformers 提供了针对训练优化的 Trainer 类。然而,该方法并未包含如何评估模型。因此,在开始训练之前,我们需要向 Trainer 传入一个函数来评估模型性能。
import evaluate

metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
   logits, labels = eval_pred
   predictions = np.argmax(logits, axis=-1)
return metric.compute(predictions=predictions, references=labels)最后一步是设置训练参数并启动训练过程。Transformers 库包含 Trainer 类,支持广泛的训练选项和功能,例如日志记录、梯度累积和混合精度。我们首先定义训练参数以及评估策略。一切就绪后,只需使用train()命令即可轻松训练模型。
from transformers import TrainingArguments, Trainer

training_args = TrainingArguments(
   output_dir="test_trainer",
   #evaluation_strategy="epoch",
   per_device_train_batch_size=1,  # Reduce batch size here
   per_device_eval_batch_size=1,    # Optionally, reduce for evaluation as well
   gradient_accumulation_steps=4
   )


trainer = Trainer(
   model=model,
   args=training_args,
   train_dataset=small_train_dataset,
   eval_dataset=small_eval_dataset,
   compute_metrics=compute_metrics,

)

trainer.train()
训练完成后,在验证集或测试集上评估模型性能。同样,Trainer 类已内置 evaluate 方法来完成此事。
import evaluate

trainer.evaluate()
以上是对任何 LLM 进行微调的最基本步骤。请记住,微调 LLM 对算力要求很高,您的本地电脑可能没有足够的能力完成。
您还可以按照这篇关于如何微调 GPT 3.5的教程,直接在 OpenAI 界面上学习微调更强大的 LLM。
为确保微调取得成功,请考虑以下最佳实践:
微调数据集的质量会显著影响模型表现。我们都熟悉这句话:
“Garbage In, Garbage Out”
因此,请务必确保数据干净、相关且规模足够。
微调通常是一个需要反复迭代的漫长过程。务必探索不同的学习率、批大小和训练轮数设置,以确定最适合您项目的方案。
精细的调整是确保模型高效学习、良好适应未见数据并避免过拟合陷阱的关键。
在训练过程中定期评估模型的进展,以跟踪其有效性并实施必要的调整。这包括在整个训练期间,使用独立的验证数据集评估模型性能。
这类评估对于判断模型是否胜任当前任务,以及是否可能对训练数据过拟合至关重要。基于验证阶段的结果,可以按需做出调整以优化性能。
微调有时会导致次优结果。请注意以下陷阱:
使用小数据集训练,或将训练轮数过度拉长,可能导致过拟合。其典型特征是模型在训练数据集上准确率很高,但无法泛化到新数据。
相反,训练不足或学习率过低会导致欠拟合,即模型无法充分学会任务。
在针对某一特定任务进行微调的过程中,模型可能会丢失其最初习得的广泛知识。这一问题被称为灾难性遗忘,会削弱模型在多种自然语言处理任务上的综合表现能力。
务必确保训练集与验证集相互独立且无重叠,否则会产生误导性地过高的性能指标。
RAG结合了检索式模型与生成式模型的优势。在 RAG 中,检索器组件会基于输入查询在大型数据库或知识库中搜索相关信息,然后生成式模型利用这些检索到的信息生成更准确、上下文更相关的回答。RAG 的关键优势包括:
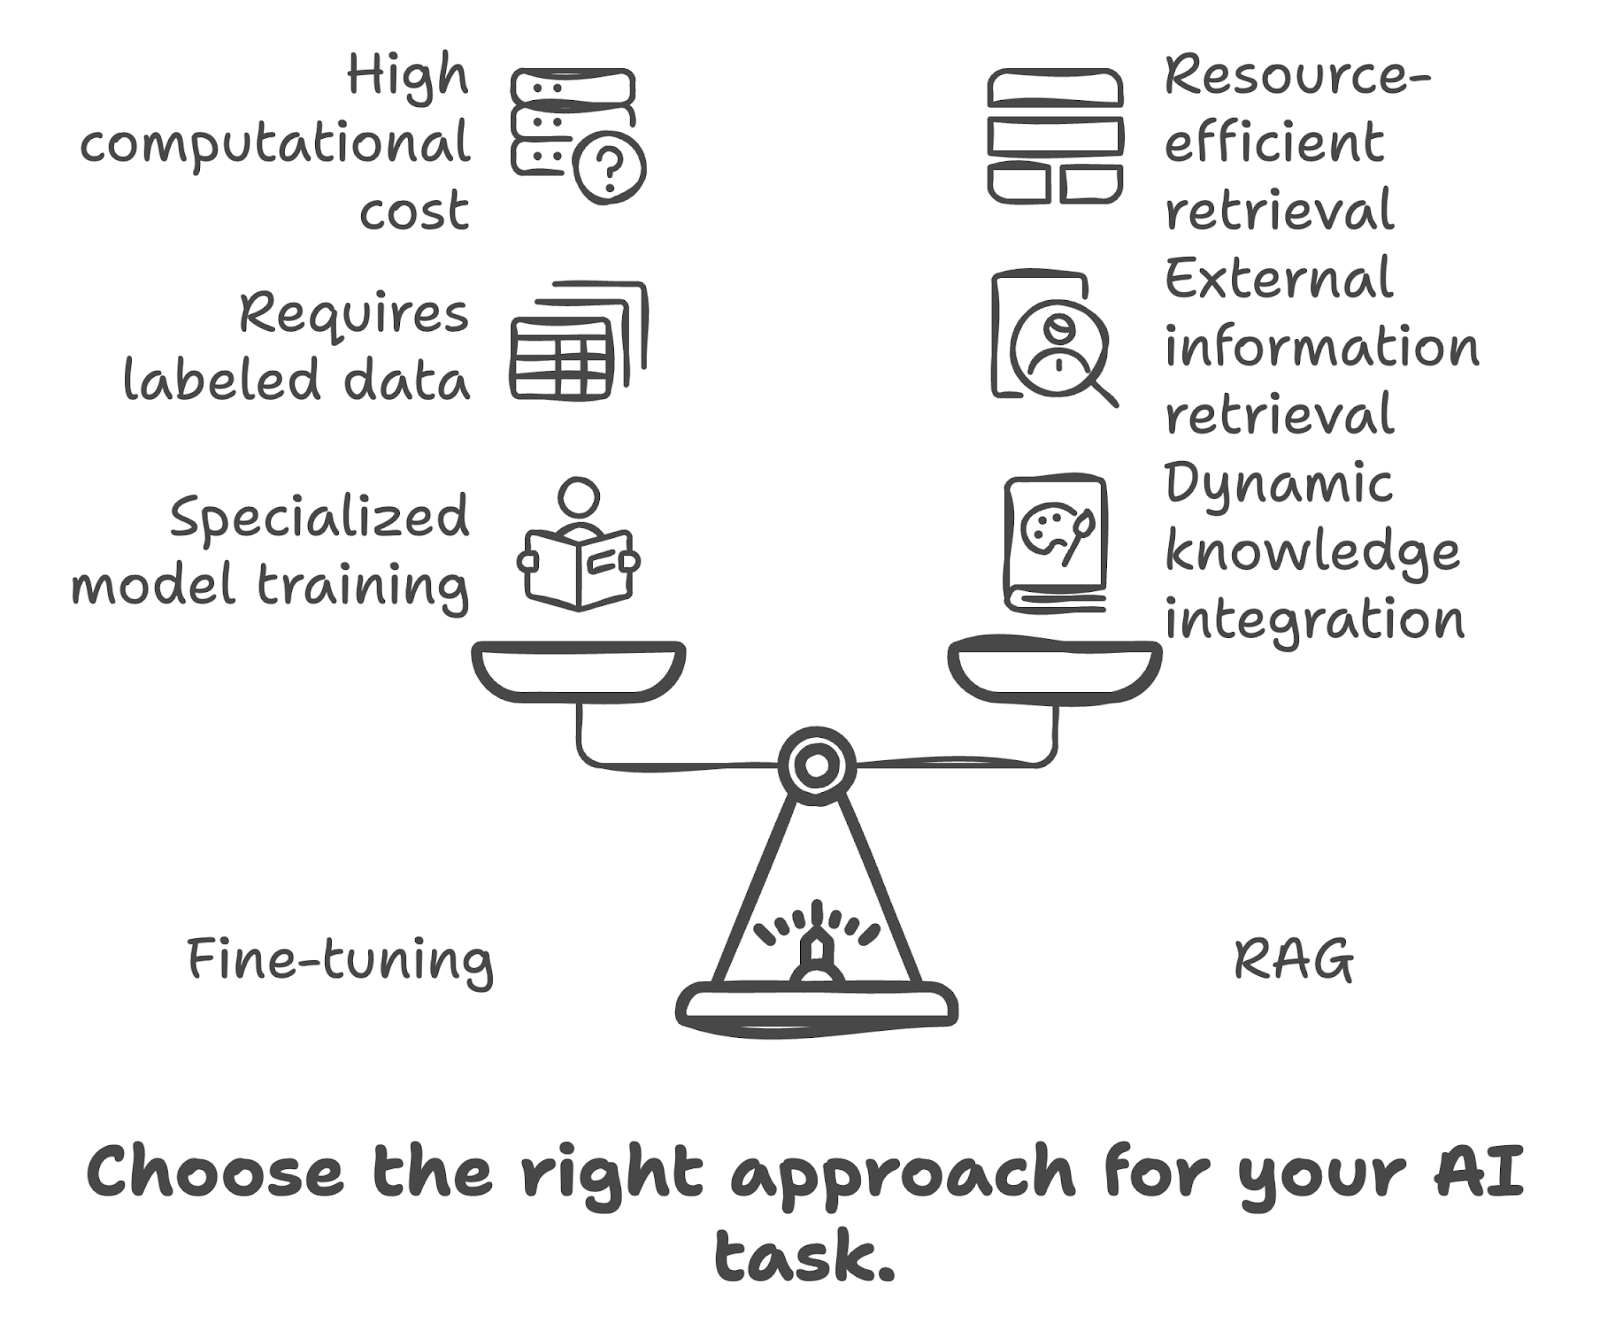
在决定使用微调还是 RAG时,请考虑以下因素:
踏上微调大型语言模型的旅程,将为 AI 应用开启无限可能。
通过理解并应用上述概念、实践与注意事项,您可以有效地将这些强大的模型适配到特定需求,在此过程中释放其全部潜力。
若要持续学习微调,我强烈建议您尝试更进阶的微调实践。您可以从 DataCamp 的LLM 概念课程开始,该课程涵盖许多关键训练方法与最新研究。其他值得关注的资源包括:
从今天开始开启您的 AI 之旅!
课程
课程
课程