Courses
使用 OpenAI API
3小时
172.6K
OpenAI 宣布了其最新的大型语言模型 GPT-4o,作为 GPT-4 Turbo 的继任者。继续阅读,了解它的能力、性能,以及您可能如何使用它。
GPT-4o 是 OpenAI 最新的 LLM。GPT-4o 中的字母“o”代表 "omni"——拉丁语意为“全部”——指的是该模型可以接受由文本、音频、图像和视频混合组成的提示。此前,ChatGPT 界面会针对不同内容类型使用不同的模型。
例如,通过语音模式与 ChatGPT 对话时,您的语音会先用 Whisper 转为文本,再用 GPT-4 Turbo 生成文字回应,最后用 TTS 将文字转为语音。
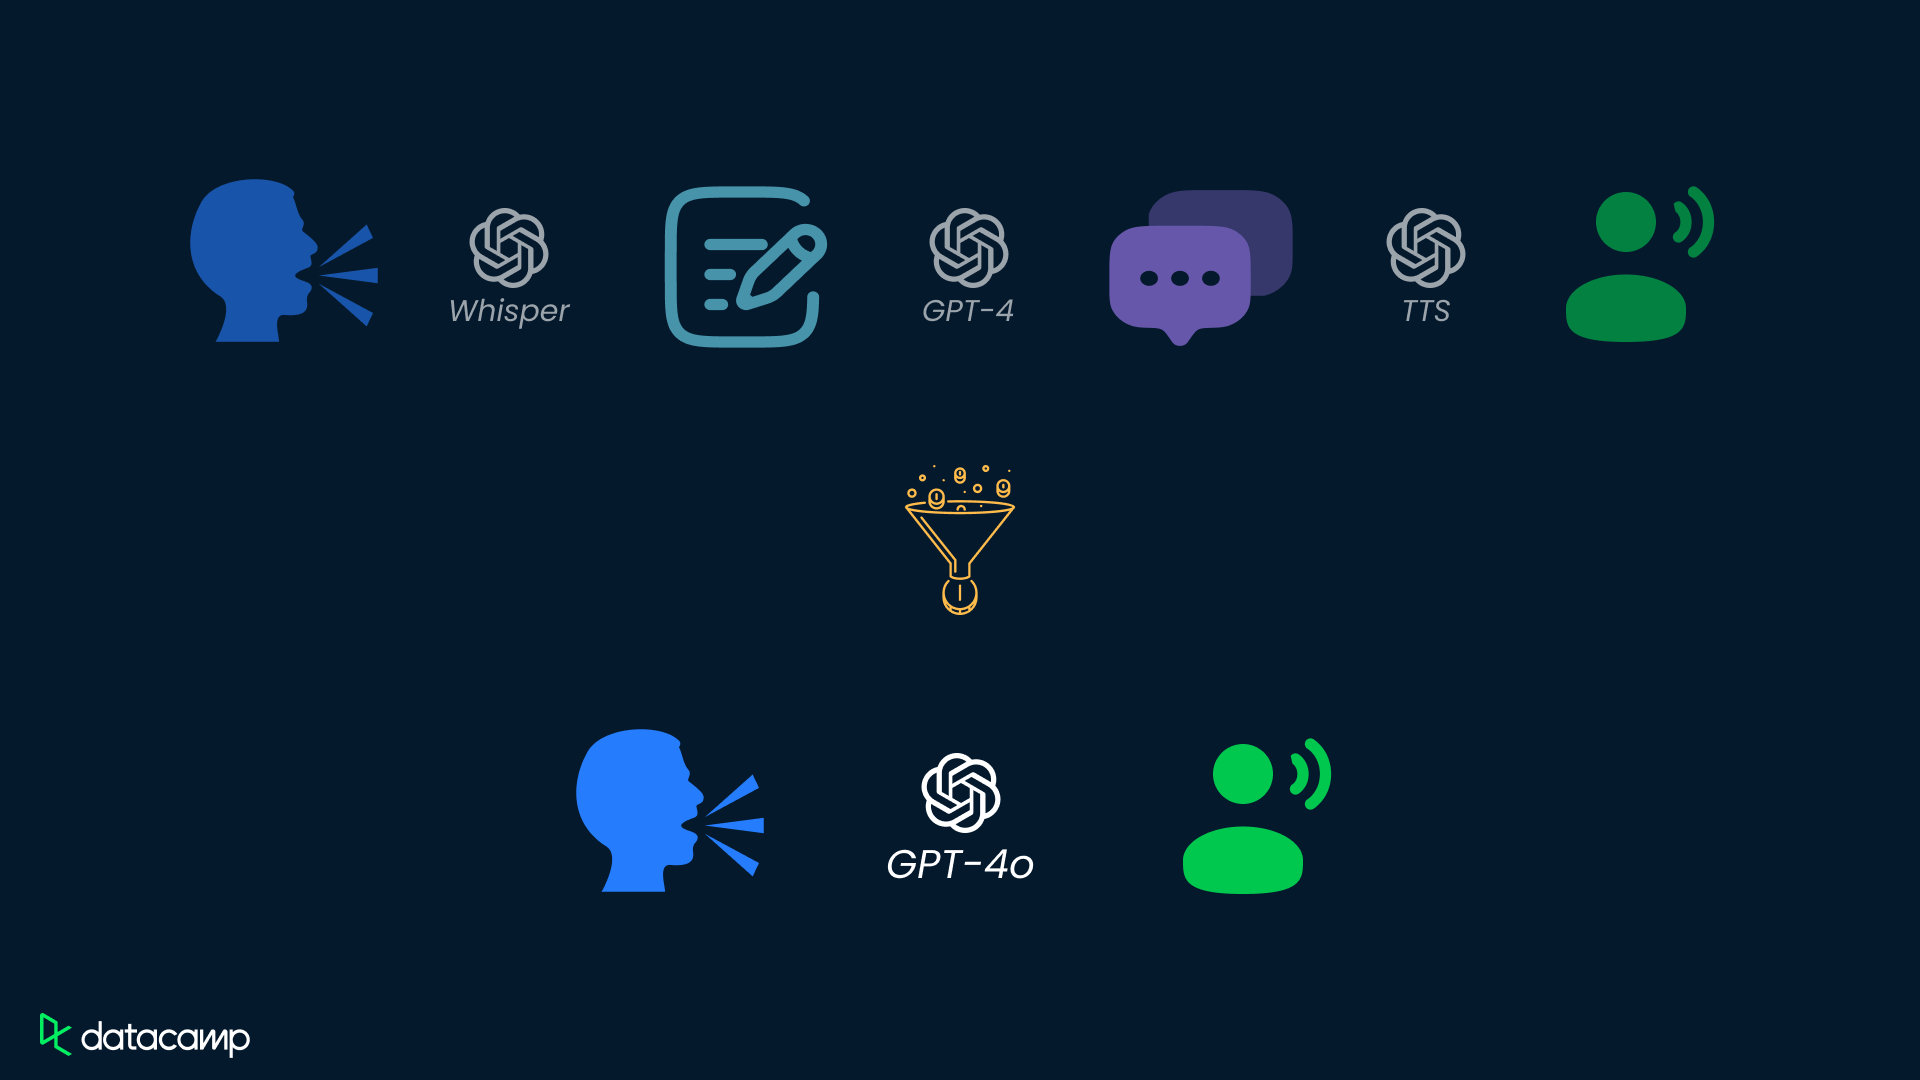
GPT-4 Turbo 与 GPT-4o 处理语音输入方式的对比
同样地,在 ChatGPT 中处理图像需要混合使用 GPT-4 Turbo 和 DALL-E 3。
将不同媒介统一到一个模型中,有望带来更高的速度与结果质量、更简洁的界面,以及全新的使用场景。
GPT-4o Mini 是 GPT-4o 的精简、加速版本,专注于速度与效率的任务。它通过一种称为蒸馏的过程从更大的 GPT-4o 模型派生而来。
虽然它保留了原模型的大部分多模态处理能力——文本、音频与图像——但 GPT-4o mini 针对需要更快响应的轻量级应用进行了优化。
对于需要经济高效方案来完成编码、调试和实时交互、且不需要动用 GPT-4o 全部算力的开发者而言,它尤其实用。
您可以在这篇关于GPT-4o mini的文章中阅读更多详情。
一体化模型的做法意味着 GPT-4o 克服了此前语音交互能力的多项限制。
在此前将 Whisper、GPT-4 Turbo 与 TTS 串联的系统中,推理引擎 GPT-4 只能接触到转写后的文字。这意味着语调、背景噪声、多位说话者的声音信息等都会被丢弃。因此,GPT-4 Turbo 难以用不同情绪或说话风格来表达回应。
如今,单一模型即可对文本和音频进行推理,这些丰富的音频信息便能被利用,以更多样的说话风格提供更高质量的回应。
在 OpenAI 提供的以下示例中,GPT-4o 给出了带有讽刺意味的输出。
LLM 工作流中的一步是将提示文本转换为 token(标记)。这是模型可理解的文本单位。
在英语中,一个 token 通常对应一个单词或标点,但有些单词也会被拆分为多个 token。平均而言,三个英文单词约占四个 token。
如果用更少的 token 表示语言,所需计算就更少,文本生成速度也会更快。
此外,由于 OpenAI 的 API 按输入与输出 token 计费,token 越少,对 API 用户的费用就越低。
GPT-4o 采用改进的分词模型,可减少每段文本所需的 token 数。这一改进在不使用拉丁字母的语言中尤为明显。
例如,印度语言的收益尤其显著:印地语、马拉地语、泰米尔语、泰卢固语与古吉拉特语的 token 数减少了 2.9 至 4.4 倍。阿拉伯语减少了 2 倍,而中文、日语、韩语、越南语等东亚语言减少了 1.4 至 1.7 倍。
在 OpenAI 现有的 ChatGPT 定价策略下,用户需付费才能访问最佳模型:GPT-4 Turbo 仅对 Plus 与企业付费计划开放。
这一点正在改变。OpenAI 承诺也会将 GPT-4o 提供给免费计划用户。Plus 用户可发送的消息数量将是免费用户的五倍。
将分阶段推出,红队(试图“搞崩”模型以发现问题的测试者)可立即获得访问权限,更多用户会逐步获得使用权。
虽然这不一定是 GPT-4o 独享的更新,OpenAI 也宣布发布 ChatGPT 桌面应用。结合上文提到的时延与多模态更新,以及应用的推出,我们与 ChatGPT 的协作方式很可能发生改变。比如,OpenAI 演示了使用语音与 ChatGPT 桌面应用的增强编码流程。向下滚动至用例部分即可查看该示例!
GPT-4o 的具体工作机制仍鲜见公开细节。OpenAI 在其公告中仅透露,GPT-4o 是一个在文本、视觉与音频输入上训练的单一神经网络。
这一新方法不同于此前为不同数据类型分别训练独立模型的技术路线。
不过,GPT-4o 并非首个采用多模态方法的模型。早在 2022 年,腾讯实验室就创建了 SkillNet,将 LLM 的 Transformer 特性与计算机视觉技术结合,以提升对汉字的识别能力。
2023 年,苏黎世联邦理工、麻省理工与斯坦福大学团队创建了 WhisBERT,是 BERT 系列大型语言模型的一个变体。虽然并非首创,GPT-4o 的雄心与能力却远超这些早期尝试。
与 GPT-4 Turbo 相比,GPT-4o 的架构变化有多大,可能取决于您问的是 OpenAI 的工程团队还是市场团队。4 月,LMSYS 的 Chatbot Arena(生成式 AI 排行榜)上出现了一位名为“im-also-a-good-gpt2-chatbot”的机器人,如今已被确认是 GPT-4o。
名称中的“gpt2”部分很重要。它并非指代 GPT-2(GPT-3.5 与 GPT-4 的前身),而是被广泛认为意味着 GPT 系列采用了全新的架构。
显然,OpenAI 的研究或工程团队有人认为,将文本、视觉与音频整合进单一模型,已足以在六年间第一次“升级版本号”。
另一方面,市场团队选择了较为保守的命名方式,沿用“GPT-4”的命名惯例。
OpenAI 发布了 GPT-4o 与多款高端模型的基准对比数据。
其中,真正值得对比的仅有三款:GPT-4 Turbo、Claude 3 Opus 与 Gemini Pro 1.5。过去数月,它们一直在争夺 LMSYS Chatbot Arena 排行榜的头名。
Llama 3 400B 未来或将成为竞争者,但尚未完成。因此,这里仅展示这三款模型与 GPT-4o 的结果。
共采用了六项基准测试:
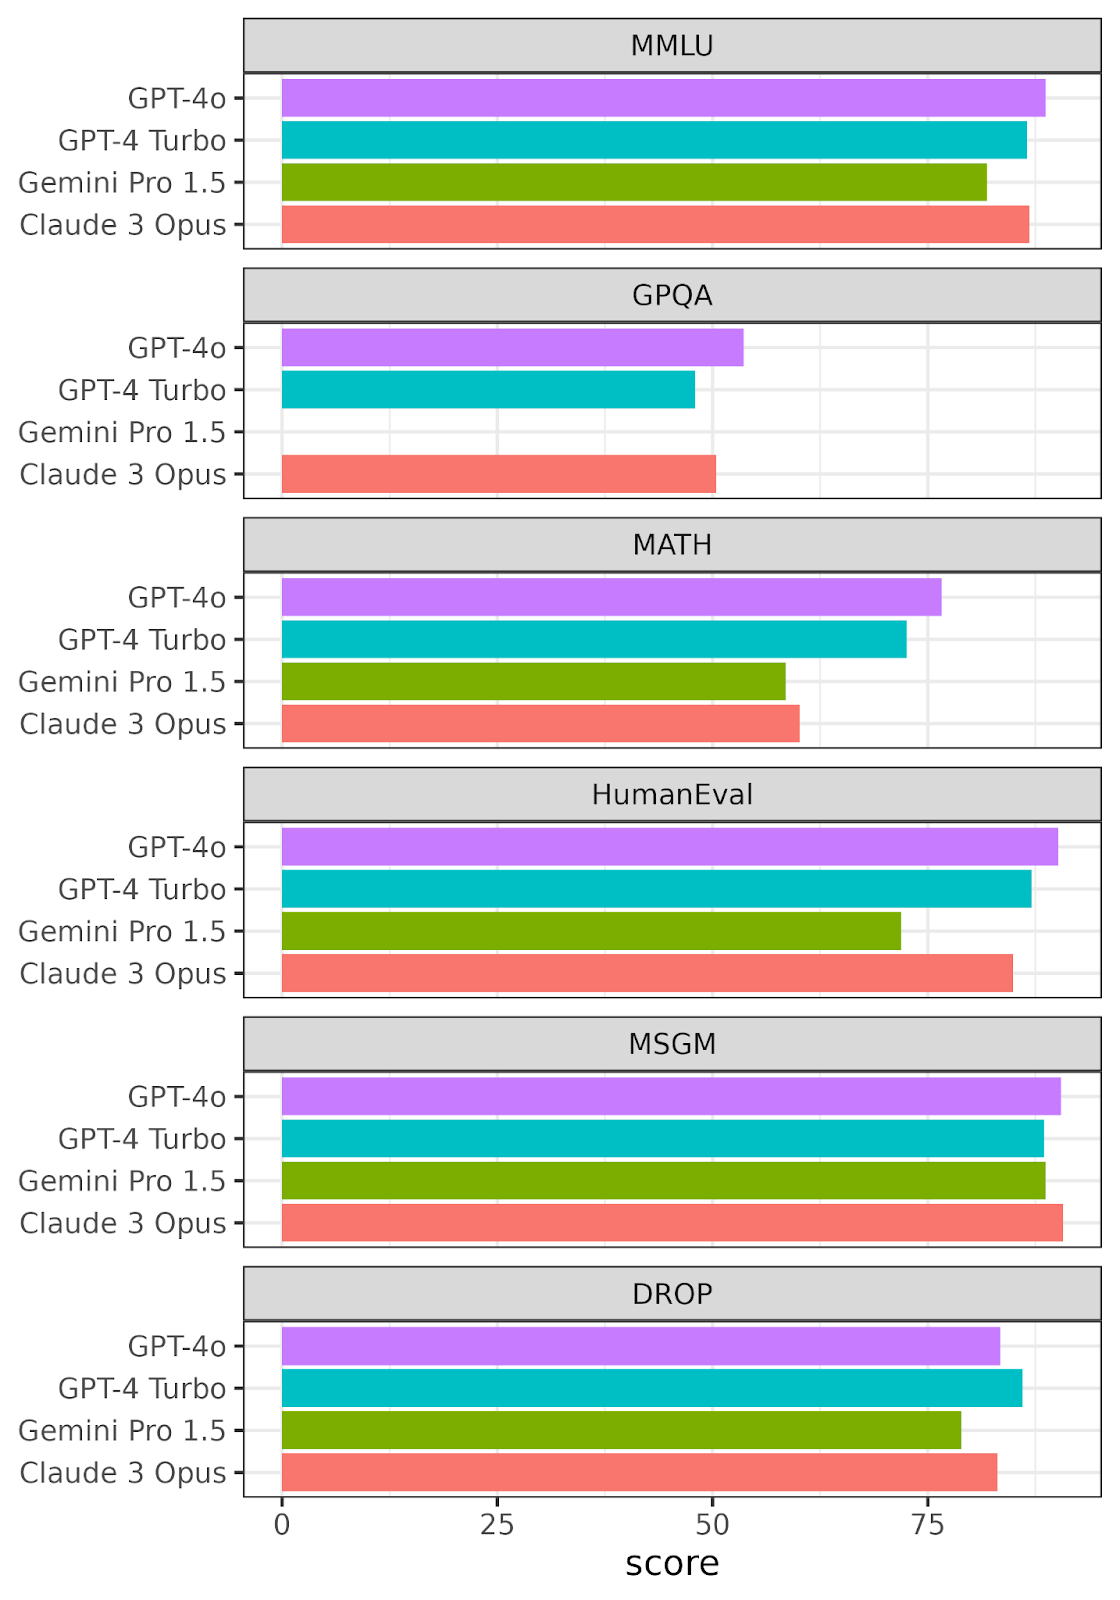
GPT-4o、GPT-4 Turbo、Gemini Pro 1.5 与 Claude 3 Opus 在六项 LLM 基准测试中的表现。各项分数范围为 0–100。图表依据 OpenAI 提供的数据重绘。Gemini Pro 1.5 在 GPQA 基准上无数据。
GPT-4o 在四项基准中获得最高分,但在 MSGM 上被 Claude 3 Opus 超越,在 DROP 上被 GPT-4 Turbo 超越。整体而言,表现令人瞩目,也为多模态训练的新路径带来希望。
若将 GPT-4o 与 GPT-4 Turbo 的数据细看,会发现性能提升仅有几个百分点。
这对间隔一年的迭代而言已相当可观,但远不及从 GPT-1 到 GPT-2、或 GPT-2 到 GPT-3 时那样的飞跃。
在文本推理上每年提升 10% 很可能成为新常态。低垂的果实已被摘尽,在文本推理上继续实现大跨越确实艰难。
另一方面,这些 LLM 基准并未衡量 AI 在多模态问题上的表现。这个概念还很新,我们尚无良好的方式评估模型在文本、音频与视觉三方面的综合能力。
总的来说,GPT-4o 的表现令人印象深刻,也为多模态训练的新方法带来希望。
近来的 GPT 模型及其衍生产品(如 GitHub Copilot)已能够提供代码辅助,包括编写代码、解释与修复错误。GPT-4o 的多模态能力带来了更多有趣机会。
在由 OpenAI CTO Mira Murati 主持的宣传视频中,两位 OpenAI 研究员 Mark Chen 与 Barret Zoph 演示了使用 GPT-4o 处理一些 Python 代码。
他们以文本形式将代码分享给 GPT,并通过语音交互请 GPT 解释代码。随后,在运行代码后,借助 GPT-4o 的视觉能力来解释绘图。
总体而言,相比将图表保存为图片再上传给 ChatGPT 并键入问题,直接展示屏幕并口述问题,或许是更简洁的工作流。
GPT-4o 能理解来自相机的视频输入并以语音描述场景,对视障人士而言可能是必备功能。本质上,这就像电视上的音频解说功能,只不过用于现实世界。
自公告发布后不久(可惜暂时还没有语音聊天),我便获得了 GPT-4o 的部分新功能访问权限,对它的许多输出印象深刻。响应似乎更快更稳定,对我请求的理解也优于以往。当然,并非完美。
以下是我与 ChatGPT-4o 的一些交互示例:
我首先使用语音聊天,询问它对分析我支持的足球队——利兹联——的表现有何想法。它给出了若干选项,并提供了示例 Python 代码:
import pandas as pd

# Sample data for Leeds United's match results
data = {
    'Match': ['Match1', 'Match2', 'Match3', 'Match4', 'Match5'],
    'Result': ['Win', 'Draw', 'Loss', 'Win', 'Win'],
    'Goals Scored': [2, 1, 0, 3, 2]
}

# Create a DataFrame
df = pd.DataFrame(data)

# Summarize match results
summary = df['Result'].value_counts()
total_goals = df['Goals Scored'].sum()
average_goals = df['Goals Scored'].mean()

# Display summary
print("Match Results Summary:")
print(summary)
print("\nTotal Goals Scored:", total_goals)
print("Average Goals Per Match:", round(average_goals, 2))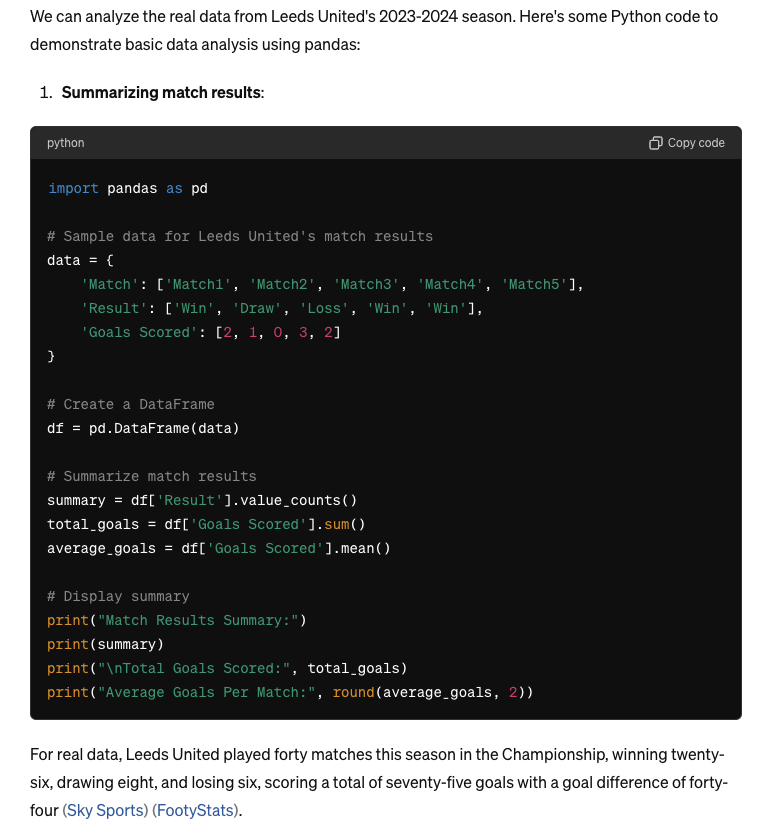
不过,当我进一步深入这一思路时,问题就出现了。我先要求它提供可用的真实数据——它上网搜索并找到了两个不错的来源,但统计数据却报错。利兹在常规赛踢了 46 场,进 81 球,净胜 38 球,而它的回答中称打了 40 场。
随后我让 ChatGPT 可视化对阵各队的进球数:
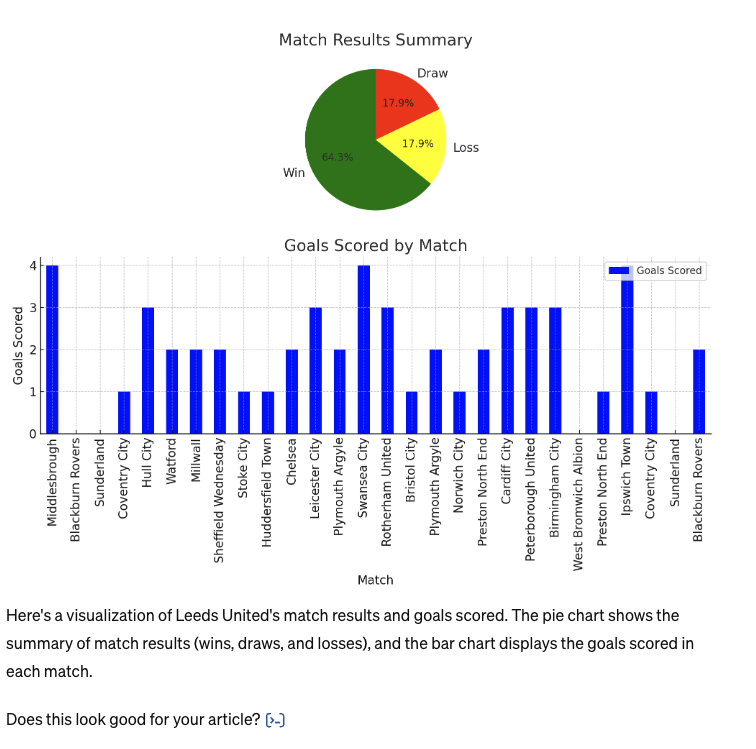
这次它同样只完成了一半。表面上看,图表如我所求生成出来了。但实际上,许多数据是编造且不准确的(球队重复出现、进球未统计、甚至包含与利兹不在同一联赛的球队)。
公平地说,如果我自己提供完整数据集,表现应该会更好;但我更希望它能直言需要数据,而不是自信地“编答案”。
接着,我让 GPT-4o 分析我其中一株植物的照片。我仍无法使用集成视觉功能,所以只能拍照并询问 ChatGPT 这是什么植物:
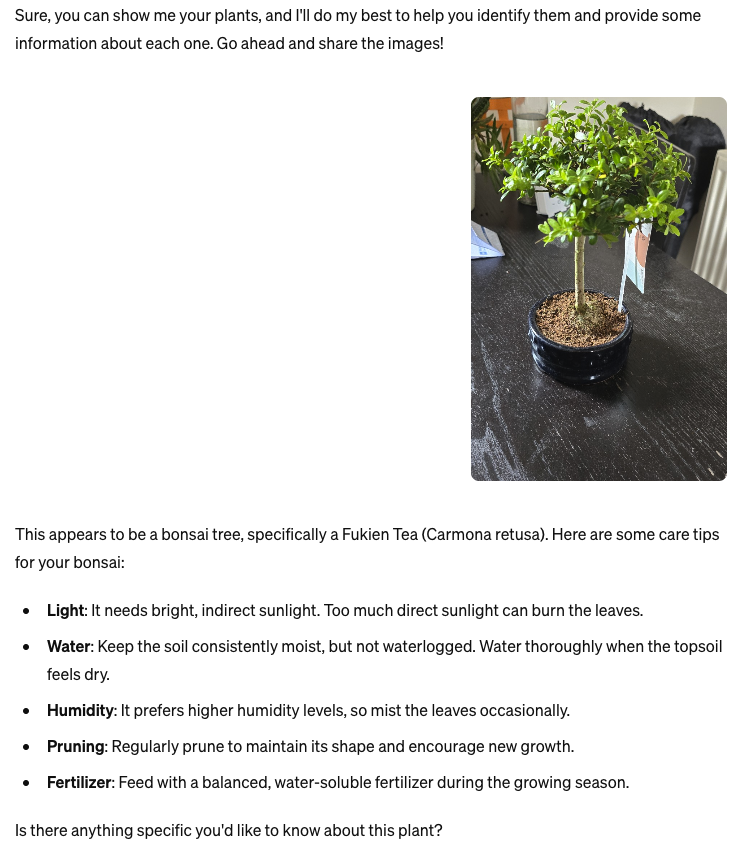
这次表现还不错,但并不完全准确。虽然确实是盆景,但其实是日本冬青(Ilex crenata),而非鸡蛋花榕(Carmona retusa)。不过二者外观颇为相似,这是可以理解的错误,而且我也很欣赏它提供的养护建议。
最后,我想测试新模型的图像能力。我先给它看了我的陆龟 Darwin 的照片,请它介绍一下我的这位“朋友”:
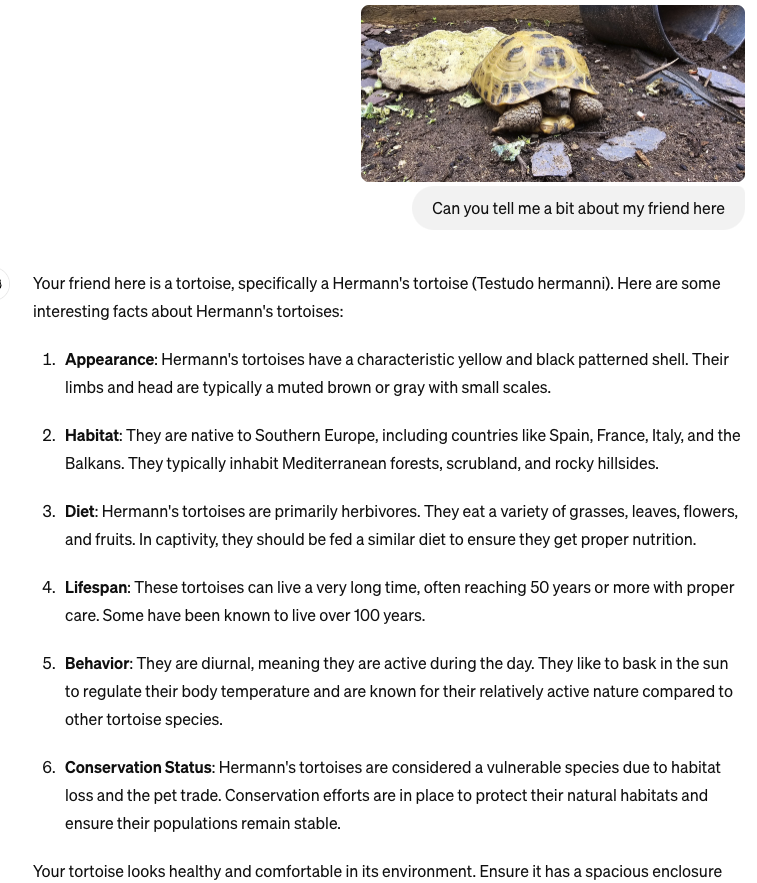
这次依然接近但不完美。Darwin 实际上是俄羅斯陆龟(Horsefield tortoise),而非赫曼陆龟(Hermann’s),不过两者确实很像。随后我让 ChatGPT-4o 以北斋风格重绘原图。结果如下:
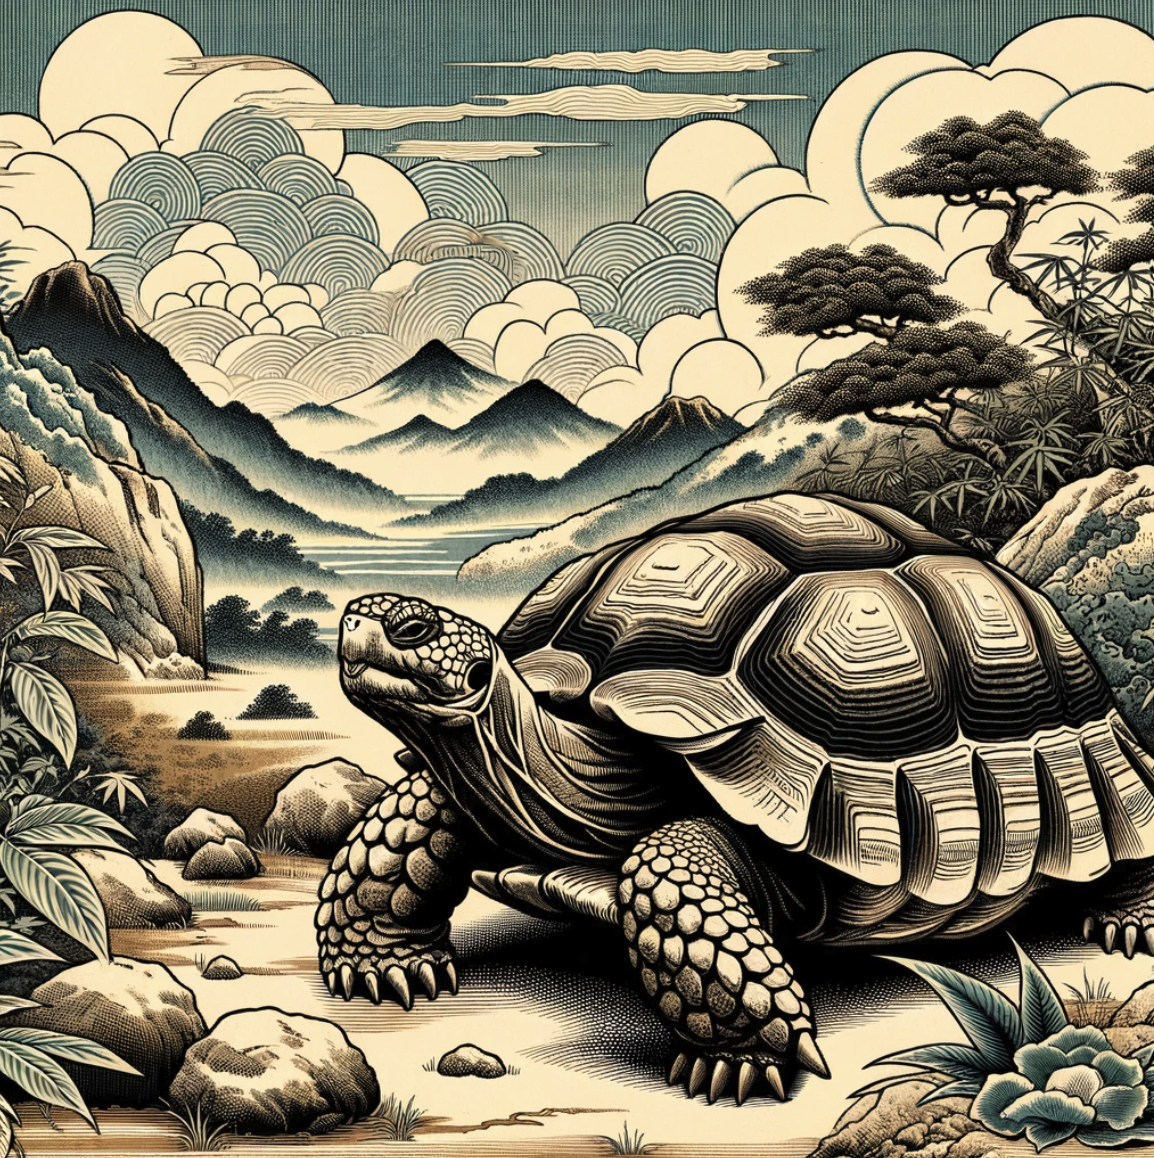
成品相当不错,尽管与原图相似度不高,但这也无可厚非。这一张生成也花了些时间。
总体而言,我对新模型的响应速度及其对我请求的理解力印象良好。它仍不完美,有时会自信地“幻觉”,但我已迫不及待想亲手体验改进后的语音与集成视觉功能。
关于生成式 AI 的监管仍处于早期阶段;目前仅有欧盟《人工智能法》这一较为显著的法律框架。因此,开发 AI 的公司需要自主决定何为“安全的 AI”。
OpenAI 制定了一个备战(preparedness)框架,用于判断新模型是否适合向公众发布。
该框架测试四个关注领域:
每个关注领域被评为“低”“中”“高”或“严重”,模型的总体评分取四类中最高等级。
OpenAI 承诺不会发布“严重”关注级别的模型,但这其实是较低的安全门槛:按照其定义,“严重”意味着足以颠覆人类文明。GPT-4o 轻松避开了这一等级,评为“中等”关注。
与所有生成式 AI 一样,模型并不总能按预期行为。计算机视觉并不完美,对图像或视频的解读不保证一定奏效。
同样,语音转写很少能做到 100% 准确,尤其在说话者口音较重或使用技术术语时。
OpenAI 提供了一段花絮视频,展示了 GPT-4o 未按预期工作的案例。
值得注意的是,在两种非英语语言之间的翻译是其失败案例之一。其他问题包括语气不当(居高临下)以及讲错语言。
立即学习,使用 OpenAI 构建 AI 工具!
Courses
Courses
Courses