सफल डेटा साइंस प्रोजेक्ट्स के लिए टीमों के बीच सहयोग आवश्यक है। सभी संबंधित स्टेकहोल्डर्स के साथ उचित तालमेल के बिना डेटा साइंस प्रोजेक्ट्स प्रभावशाली नहीं हो पाते। हालिया DataCamp वेबिनार में, Lucid Software में इंजीनियरिंग मैनेजर, इंटरनल इंजीनियरिंग, Brian Campbell ने डेटा साइंस प्रोजेक्ट्स पर क्रॉस‑टीम सहयोग के सर्वोत्तम तरीकों पर चर्चा की।
तीन प्रकार के सहयोगी
डेटा साइंटिस्ट्स को अपने प्रोजेक्ट्स से असर पैदा करने के लिए अन्य स्टेकहोल्डर्स के साथ काम करना होता है। उन्हें अपने संगठन के अन्य लोगों पर निर्भर रहना चाहिए ताकि वे जिन समस्याओं में रुचि रखते हैं, उनके पीछे का व्यावसायिक मूल्य और मेट्रिक्स बेहतर समझ सकें, जटिल डेटा वातावरण में नेविगेट कर सकें, और अपने मॉडलों को ग्राहकों तक डिप्लॉय कर सकें। वेबिनार में, Brian तीन प्रकार के सहयोगियों पर चर्चा करते हैं:
समस्या विशेषज्ञ
समस्या विशेषज्ञ वह सहयोगी होता है जो डेटा साइंस प्रोजेक्ट की नींव रखता है। उसका काम प्रोजेक्ट के लिए डोमेन विशेषज्ञता प्रदान करना और समस्या विवरण को परिभाषित करना है।
समस्या विशेषज्ञ इस बात को गहराई से समझते हैं कि डेटा साइंस प्रोजेक्ट से किन मेट्रिक्स पर असर पड़ेगा और वे व्यावसायिक परिणामों में कैसे बदलते हैं। वे यह भी जानते हैं कि किसी मॉडल को मूल्यवान बनाने के लिए कितनी सटीकता आवश्यक है। यह ज्ञान अहम है, क्योंकि कोई भी मॉडल पूरी तरह सटीक नहीं हो सकता। शुरुआत में ही यह समझना कि लक्ष्य क्या यथार्थवादी और मूल्यवान है, उद्देश्यों को परिभाषित करने और अपेक्षाएं तय करने के लिए जरूरी है।
डेटा विशेषज्ञ
किसी भी सफल डेटा साइंस प्रोजेक्ट की कुंजी डेटा है। कई संगठनों में जटिल डेटा परिदृश्य होते हैं, जिनके कारण यह जानना चुनौतीपूर्ण हो जाता है कि कौन‑सा डेटा उपलब्ध है और किसी समस्या को हल करने के लिए कौन‑सा डेटा आवश्यक है।
डेटा विशेषज्ञ इस बात के प्रभारी होते हैं कि किसी डोमेन में कौन‑सा डेटा उपलब्ध है, डेटा कैसे प्राप्त किया जाए, और विशिष्ट व्यावसायिक प्रश्नों के लिए कौन‑सा डेटा सबसे उपयुक्त है। कभी‑कभी वे स्वयं समस्या विशेषज्ञ भी हो सकते हैं, लेकिन आमतौर पर संगठन में डेटा इंजीनियरिंग भूमिकाओं में होते हैं।
इंप्लीमेंटेशन विशेषज्ञ
अंत में, इंप्लीमेंटेशन विशेषज्ञ इस बात को समझने के जिम्मेदार होते हैं कि इन मॉडलों को ग्राहकों तक कैसे डिप्लॉय किया जाए। वे बड़े पैमाने पर मॉडल डिप्लॉय करने के लिए आवश्यक इन्फ्रास्ट्रक्चर और संसाधनों के विशेषज्ञ होते हैं।
इन विशेषज्ञों के साथ सहयोग करते समय, उन्हें प्रोजेक्ट के बारे में काफी पहले बता देना महत्वपूर्ण है ताकि जब मॉडल डिप्लॉय करने के लिए तैयार हो, तो वे आवश्यक इन्फ्रास्ट्रक्चर सुनिश्चित करने के लिए समय निकाल सकें। यह जानना भी महत्वपूर्ण है कि कार्य का उपयोग कैसे होगा—उत्पाद में एक फीचर के रूप में, किसी API के हिस्से के रूप में, मौजूदा प्रक्रिया के साथ एकीकृत होकर, या बिलकुल नई प्रक्रिया की आवश्यकता के रूप में। प्रोजेक्ट के उपयोग से यह तय होगा कि किस इंप्लीमेंटेशन विशेषज्ञ के साथ सहयोग करना सबसे उपयुक्त रहेगा।
सहयोगियों के साथ प्रभावी ढंग से कैसे काम करें
टाइमलाइन सहयोग का एक अहम घटक है। ये प्रोजेक्ट में शामिल सभी लोगों को यह योजना बनाने देती हैं कि वे कब शामिल होंगे ताकि प्रोजेक्ट को पूरा करने में मदद मिल सके।
मान लें कि ग्राहक रिटेंशन मॉडल डिप्लॉय करने का एक प्रोजेक्ट प्रस्तावित है। यह मॉडल उन ग्राहकों की पहचान करेगा जो संगठन से सदस्यता खरीदना जारी नहीं रखने के जोखिम में हैं और उन्हें बने रहने के लिए प्रोत्साहित करने हेतु एक प्रमोशनल ईमेल भेजेगा।
इस प्रोजेक्ट में शुरुआत में ग्राहक रिटेंशन मेट्रिक्स और रुझानों को समझना, संबंधित डेटा एकत्र करना, डेटा की सफाई और विश्लेषण करना, वर्गीकरण मॉडल बनाना, उसे स्वचालित ईमेल सिस्टम में एकीकृत करना, और उसे लाइव करना शामिल होगा। ये सभी चरण कई सप्ताह ले सकते हैं और कई चरणों में पिछली अनुभाग में बताए गए तीनों स्टेकहोल्डर्स की मदद की आवश्यकता होगी।
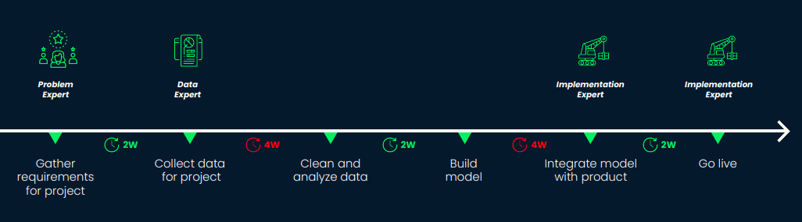
प्रारंभिक टाइमलाइन तय करने से सहयोगियों को यह रोडमैप बनाने में मदद मिलती है कि उन्हें प्रोजेक्ट में मदद करने के लिए कब उपलब्ध होना होगा। यदि देरी होती है, तो भागीदारों को तुरंत सूचित किया जाना चाहिए। यदि डेटा संग्रह चरण में देरी है, तो इंप्लीमेंटेशन विशेषज्ञों का एक माह पहले आ जाना उनके समय की बर्बादी होगी और भविष्य में उनके साथ सहयोग के अवसरों को नुकसान पहुंचाएगा।
डेटा साइंस प्रोजेक्ट मैनेजमेंट की सर्वोत्तम प्रथाओं के बारे में और जानने के लिए, अधिक विस्तृत उदाहरणों हेतु ऑन‑डिमांड वेबिनार देखें।

सफल डेटा साइंस प्रोजेक्ट्स के लिए टीमों के बीच सहयोग आवश्यक है। सभी संबंधित स्टेकहोल्डर्स के साथ उचित तालमेल के बिना डेटा साइंस प्रोजेक्ट्स प्रभावशाली नहीं हो पाते। हालिया DataCamp वेबिनार में, Lucid Software में इंजीनियरिंग मैनेजर, इंटरनल इंजीनियरिंग, Brian Campbell ने डेटा साइंस प्रोजेक्ट्स पर क्रॉस‑टीम सहयोग के सर्वोत्तम तरीकों पर चर्चा की।
तीन प्रकार के सहयोगी
डेटा साइंटिस्ट्स को अपने प्रोजेक्ट्स से असर पैदा करने के लिए अन्य स्टेकहोल्डर्स के साथ काम करना होता है। उन्हें अपने संगठन के अन्य लोगों पर निर्भर रहना चाहिए ताकि वे जिन समस्याओं में रुचि रखते हैं, उनके पीछे का व्यावसायिक मूल्य और मेट्रिक्स बेहतर समझ सकें, जटिल डेटा वातावरण में नेविगेट कर सकें, और अपने मॉडलों को ग्राहकों तक डिप्लॉय कर सकें। वेबिनार में, Brian तीन प्रकार के सहयोगियों पर चर्चा करते हैं:
समस्या विशेषज्ञ
समस्या विशेषज्ञ वह सहयोगी होता है जो डेटा साइंस प्रोजेक्ट की नींव रखता है। उसका काम प्रोजेक्ट के लिए डोमेन विशेषज्ञता प्रदान करना और समस्या विवरण को परिभाषित करना है।
समस्या विशेषज्ञ इस बात को गहराई से समझते हैं कि डेटा साइंस प्रोजेक्ट से किन मेट्रिक्स पर असर पड़ेगा और वे व्यावसायिक परिणामों में कैसे बदलते हैं। वे यह भी जानते हैं कि किसी मॉडल को मूल्यवान बनाने के लिए कितनी सटीकता आवश्यक है। यह ज्ञान अहम है, क्योंकि कोई भी मॉडल पूरी तरह सटीक नहीं हो सकता। शुरुआत में ही यह समझना कि लक्ष्य क्या यथार्थवादी और मूल्यवान है, उद्देश्यों को परिभाषित करने और अपेक्षाएं तय करने के लिए जरूरी है।
डेटा विशेषज्ञ
किसी भी सफल डेटा साइंस प्रोजेक्ट की कुंजी डेटा है। कई संगठनों में जटिल डेटा परिदृश्य होते हैं, जिनके कारण यह जानना चुनौतीपूर्ण हो जाता है कि कौन‑सा डेटा उपलब्ध है और किसी समस्या को हल करने के लिए कौन‑सा डेटा आवश्यक है।
डेटा विशेषज्ञ इस बात के प्रभारी होते हैं कि किसी डोमेन में कौन‑सा डेटा उपलब्ध है, डेटा कैसे प्राप्त किया जाए, और विशिष्ट व्यावसायिक प्रश्नों के लिए कौन‑सा डेटा सबसे उपयुक्त है। कभी‑कभी वे स्वयं समस्या विशेषज्ञ भी हो सकते हैं, लेकिन आमतौर पर संगठन में डेटा इंजीनियरिंग भूमिकाओं में होते हैं।
इंप्लीमेंटेशन विशेषज्ञ
अंत में, इंप्लीमेंटेशन विशेषज्ञ इस बात को समझने के जिम्मेदार होते हैं कि इन मॉडलों को ग्राहकों तक कैसे डिप्लॉय किया जाए। वे बड़े पैमाने पर मॉडल डिप्लॉय करने के लिए आवश्यक इन्फ्रास्ट्रक्चर और संसाधनों के विशेषज्ञ होते हैं।
इन विशेषज्ञों के साथ सहयोग करते समय, उन्हें प्रोजेक्ट के बारे में काफी पहले बता देना महत्वपूर्ण है ताकि जब मॉडल डिप्लॉय करने के लिए तैयार हो, तो वे आवश्यक इन्फ्रास्ट्रक्चर सुनिश्चित करने के लिए समय निकाल सकें। यह जानना भी महत्वपूर्ण है कि कार्य का उपयोग कैसे होगा—उत्पाद में एक फीचर के रूप में, किसी API के हिस्से के रूप में, मौजूदा प्रक्रिया के साथ एकीकृत होकर, या बिलकुल नई प्रक्रिया की आवश्यकता के रूप में। प्रोजेक्ट के उपयोग से यह तय होगा कि किस इंप्लीमेंटेशन विशेषज्ञ के साथ सहयोग करना सबसे उपयुक्त रहेगा।
सहयोगियों के साथ प्रभावी ढंग से कैसे काम करें
टाइमलाइन सहयोग का एक अहम घटक है। ये प्रोजेक्ट में शामिल सभी लोगों को यह योजना बनाने देती हैं कि वे कब शामिल होंगे ताकि प्रोजेक्ट को पूरा करने में मदद मिल सके।
मान लें कि ग्राहक रिटेंशन मॉडल डिप्लॉय करने का एक प्रोजेक्ट प्रस्तावित है। यह मॉडल उन ग्राहकों की पहचान करेगा जो संगठन से सदस्यता खरीदना जारी नहीं रखने के जोखिम में हैं और उन्हें बने रहने के लिए प्रोत्साहित करने हेतु एक प्रमोशनल ईमेल भेजेगा।
इस प्रोजेक्ट में शुरुआत में ग्राहक रिटेंशन मेट्रिक्स और रुझानों को समझना, संबंधित डेटा एकत्र करना, डेटा की सफाई और विश्लेषण करना, वर्गीकरण मॉडल बनाना, उसे स्वचालित ईमेल सिस्टम में एकीकृत करना, और उसे लाइव करना शामिल होगा। ये सभी चरण कई सप्ताह ले सकते हैं और कई चरणों में पिछली अनुभाग में बताए गए तीनों स्टेकहोल्डर्स की मदद की आवश्यकता होगी।
प्रारंभिक टाइमलाइन तय करने से सहयोगियों को यह रोडमैप बनाने में मदद मिलती है कि उन्हें प्रोजेक्ट में मदद करने के लिए कब उपलब्ध होना होगा। यदि देरी होती है, तो भागीदारों को तुरंत सूचित किया जाना चाहिए। यदि डेटा संग्रह चरण में देरी है, तो इंप्लीमेंटेशन विशेषज्ञों का एक माह पहले आ जाना उनके समय की बर्बादी होगी और भविष्य में उनके साथ सहयोग के अवसरों को नुकसान पहुंचाएगा।
डेटा साइंस प्रोजेक्ट मैनेजमेंट की सर्वोत्तम प्रथाओं के बारे में और जानने के लिए, अधिक विस्तृत उदाहरणों हेतु ऑन‑डिमांड वेबिनार देखें।